Lec 1 · 컴퓨터 구조 개론과 역사
정밀 정리 · 검증 2026-09-23 21:23
1개요
1.1computer architecture(컴퓨터 구조)를 application 과 physics 사이의 abstraction layer(추상화 계층) 설계로 정의하고, ISA·microarchitecture 가 이 과목의 초점임을 밝힌다.
1.2성능 향상은 technology scaling 과 architecture 개선의 합이었으나, Dennard scaling 종료로 power wall·ILP wall·memory wall 이 생겨 parallelism(병렬성) 활용이 핵심이 됐다.
1.3정량적 설계 원칙 5가지(parallelism, locality, common case, Amdahl's law, processor performance equation)를 복습한다.
1.4Antikythera 부터 Babbage, ENIAC, EDSAC, IBM 360 까지 역사를 훑으며 stored program, index register, 호환 ISA 의 등장 배경을 본다.
1.5과목 운영: 성적 비중, 출석 규정, 2인 이하 팀 프로젝트(4쪽 letter 논문), 영어 paper critique 6편.
2섹션별 정리 상황·문제 → 원인 → 해결
2.13:36–8:24강의 시작·수강생 배경 질문 (행정)
상황·문제학부 computer architecture 수강 여부를 chat 으로 묻고, 기억 속 가장 오래된 컴퓨터의 CPU core 수를 질문. 대부분 multi-core 를 당연하게 여긴다는 점을 짚음.
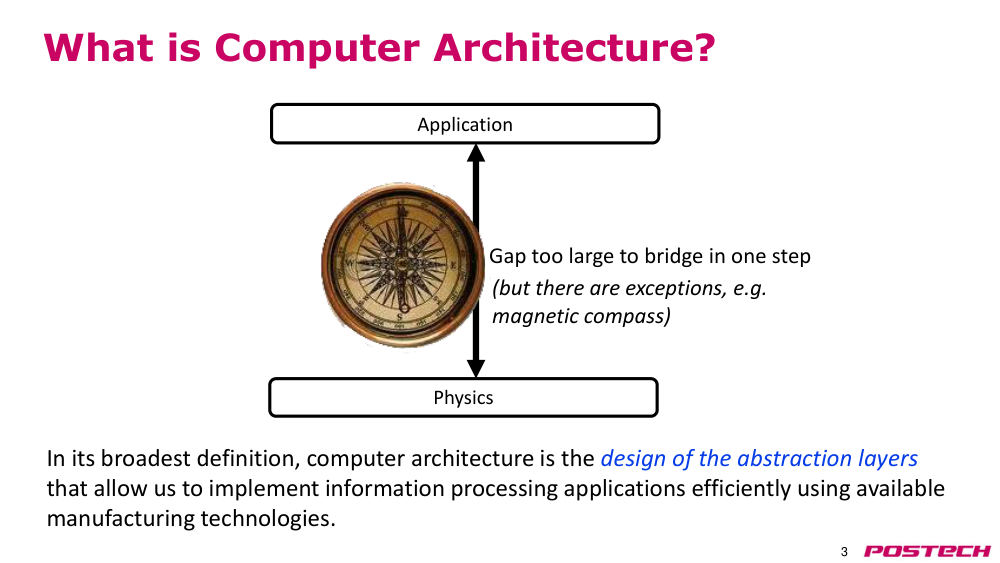
2.28:24–12:01computer architecture 란: abstraction layer(추상화 계층)
상황·문제application 과 physics 사이 간극이 커서 한 번에 연결할 수 없음 (예외: 자석 나침반).
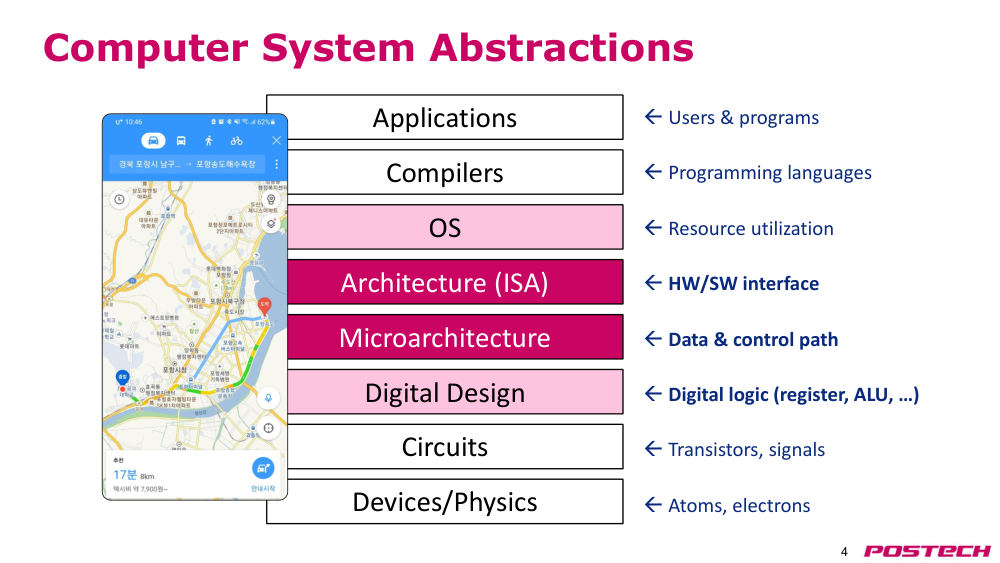
원인지도 앱처럼 유용한 application 은 device → circuit → digital design → microarchitecture → ISA → OS → compiler → application 의 여러 층을 거쳐야 동작.
해결computer architecture 는 이 abstraction layer 들을 설계하는 일. 이 과목은 ISA 와 microarchitecture 층에 집중하되 OS·digital design 층도 필요 시 다룸.
- ISA(instruction set architecture, 명령어 집합 구조) = HW/SW interface
- OS 는 software stack 최하위층으로 CPU 와 직접 대화
- 질문은 chat·microphone, 한국어로 해도 됨
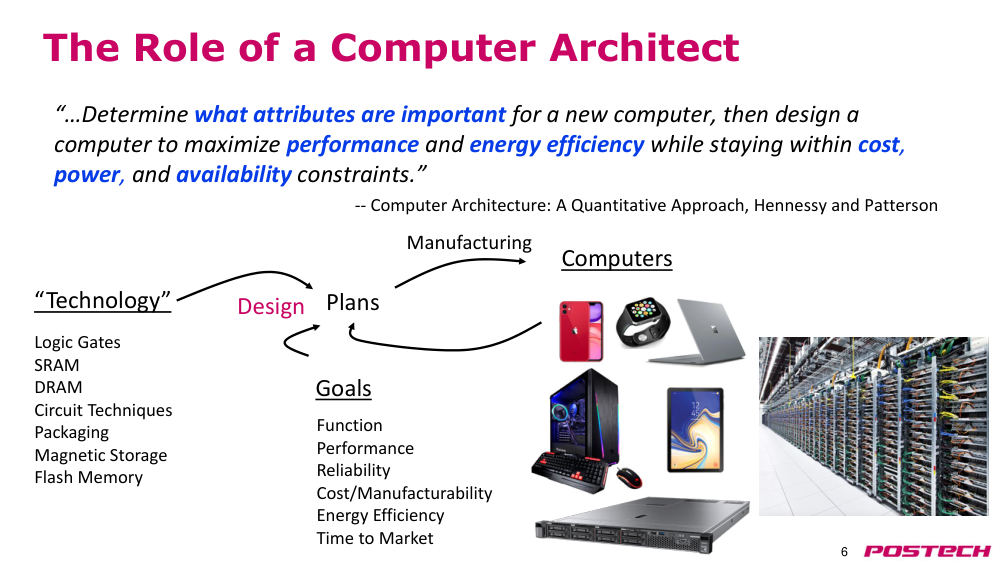
2.312:01–17:46컴퓨터 설계 요소와 computer architect 의 역할
상황·문제새 컴퓨터를 설계할 때 smartwatch 부터 data center 까지 target 에 따라 중요한 attribute(performance, energy, reliability, capacity)가 다름.
원인실제 구현물이라 power(배터리, 전기요금), dollar cost(칩 면적 = 제조 비용) 같은 constraint 를 벗어날 수 없음.
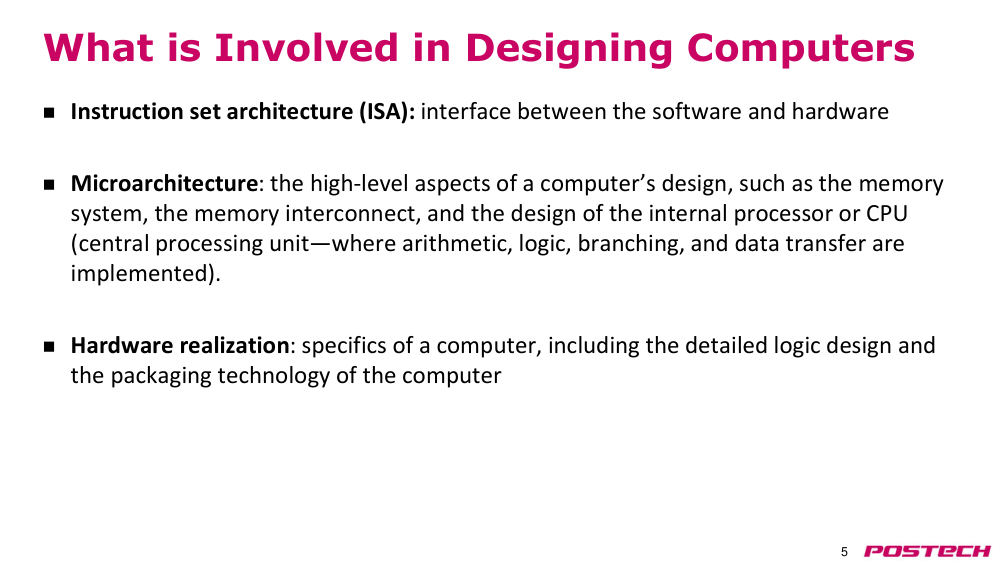
해결constraint 안에서 performance 와 energy efficiency 를 최대화하도록 ISA 와 microarchitecture 를 결정. ISA 는 호환성 때문에 거의 바꾸지 않고 microarchitecture 로 새 fabrication technology 를 활용.
- ISA: SW/HW interface, microarchitecture: adder·register file·cache 수준의 고수준 구현, hardware realization: circuit 설계·제조
- ISA 변경은 되돌리기 어려우므로 매우 신중해야 함
- 같은 ISA 에서 microarchitecture 쪽 자유도가 더 큼
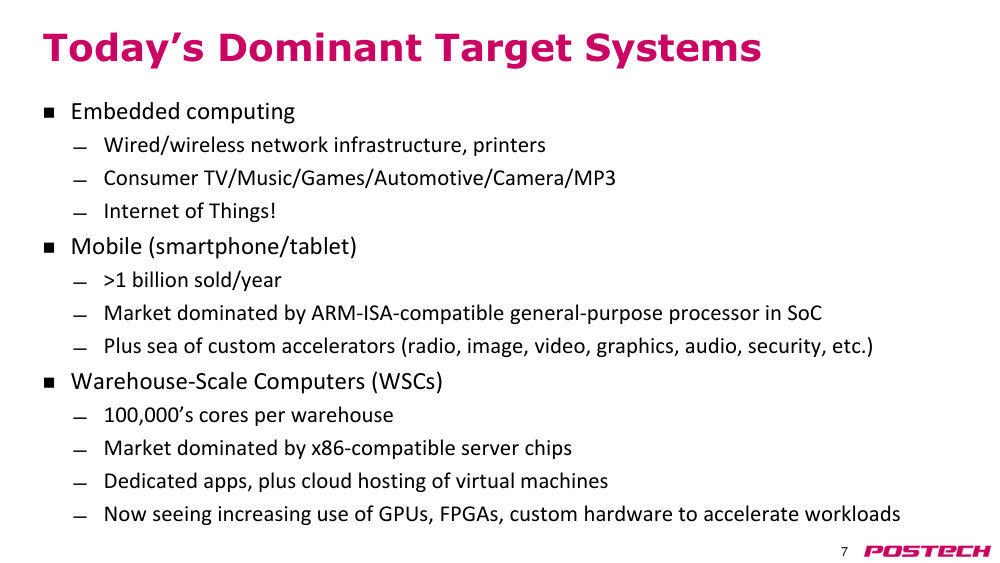
2.417:46–23:17오늘날 target system 과 von Neumann architecture
상황·문제주요 target 은 embedded/IoT, mobile, warehouse-scale computer(WSC, data center).
원인mobile 은 SoC 안의 ARM ISA 호환 application processor 가 지배. WSC 는 수십만 core 규모이며 Intel·AMD x86 server chip 이 지배하나 ARM·IBM POWER 가 도전 중.
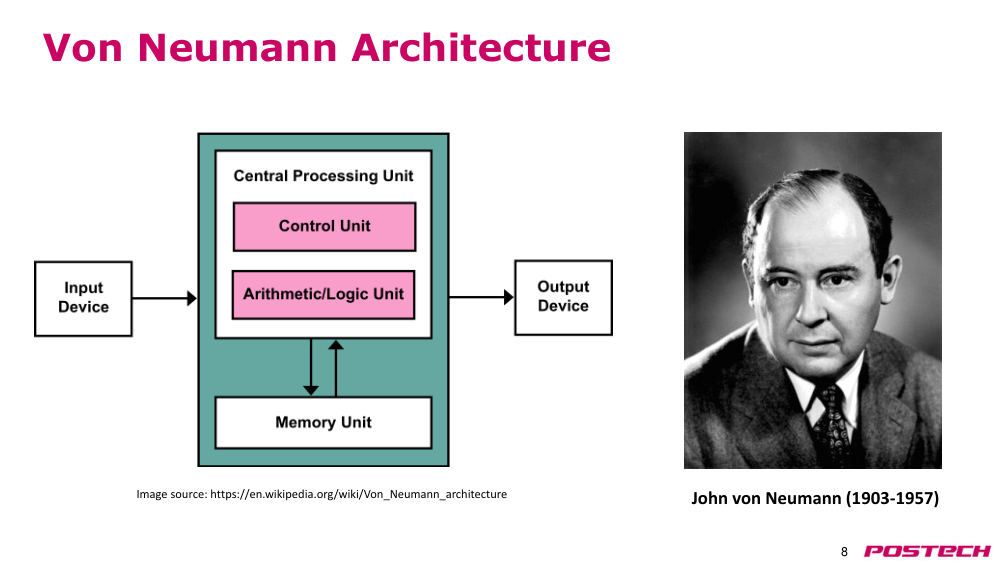
해결Amazon 은 자체 설계 ARM CPU 를 EC2 에서 제공하고, GPU·FPGA·Google TPU 같은 accelerator 사용이 늘고 있음. 이 모든 시스템은 von Neumann architecture 위에 있음.
- von Neumann: CPU(control unit + ALU = datapath) + program 과 data 를 함께 담는 memory + input/output device
- 오늘날 memory 는 주로 DRAM
- 향후 data center 용 고성능 RISC-V CPU 가능성 언급
2.4.r.1Von Neumann architecture — Wikipedia ↗ · 구성요소와 1945년 'First Draft of a Report on the EDVAC' 배경
2.523:17–28:51single-thread performance 추세와 Moore's law(무어의 법칙)
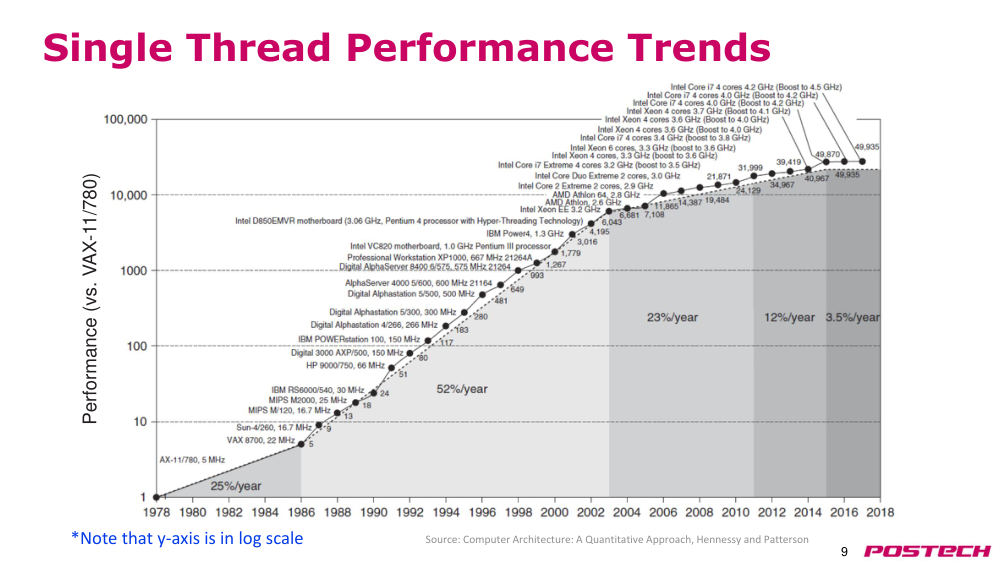
상황·문제single-thread performance 는 수십 년간 지수적으로 증가했으나 최근 크게 둔화됨 (그래프 y축은 log scale).
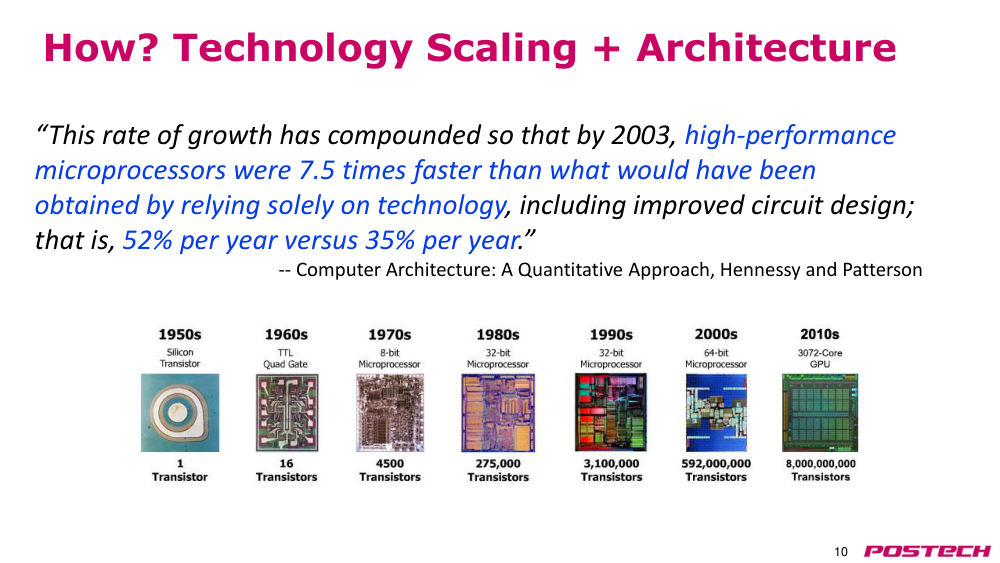
원인성장 요인은 technology scaling 과 architecture 개선 두 가지. H&P 에 따르면 2003년 architecture 기여로 technology 만 의존할 때보다 7.5배 빨랐음 (연 52% vs 35%).
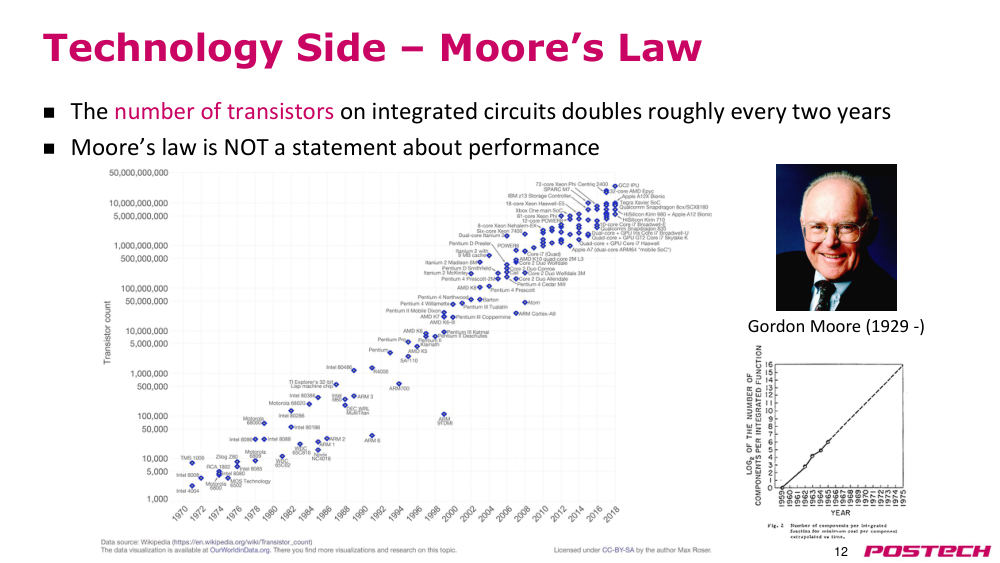
해결single-thread 한계 때문에 program 의 parallelism 을 활용해야 함. Moore's law 는 transistor 수가 약 2년마다 2배라는 관찰이지 performance 에 대한 진술이 아님.
- transistor 증가가 흔히 성능 향상으로 이어져 혼동이 생김
- transistor density 증가는 둔화됐지만 지금도 세대마다 계속됨
- Gordon Moore 는 적은 data point 로 이 예측을 함
2.628:51–35:58Dennard scaling(데나드 스케일링)과 그 종료
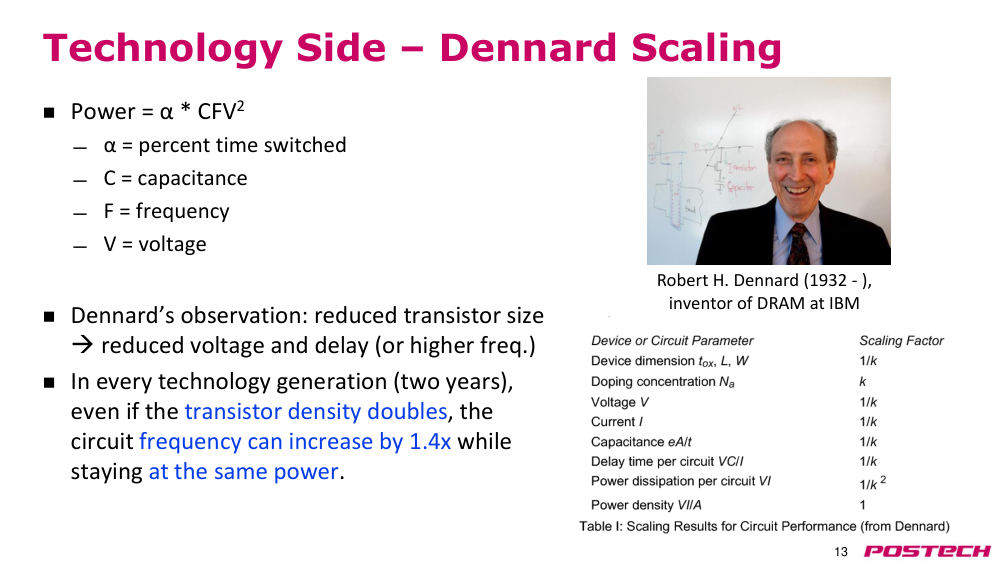
상황·문제performance 향상과 더 직접 관련된 것은 Dennard scaling. Power = α·C·F·V².
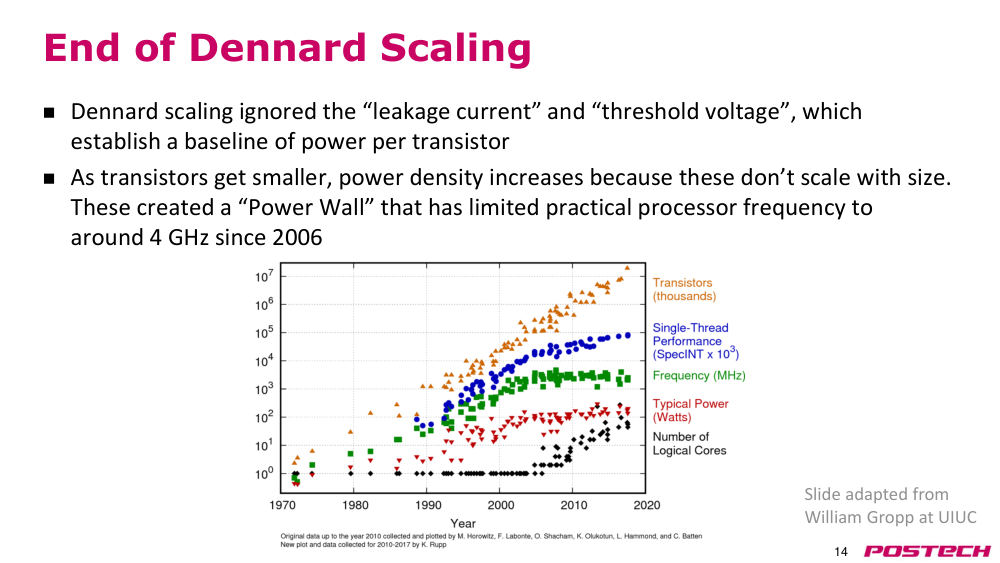
원인device 치수를 1/k 로 줄이면 V·C·delay 도 1/k, 회로당 power 는 1/k², 면적당 transistor 는 k² 배 → power density 일정. 그러나 leakage current 와 threshold voltage 가 비례해 줄지 않아 2000년대 초 종료.
해결2006년 이후 clock frequency 는 거의 정체, transistor 수만 증가 → core 수를 늘려 parallelism 활용. power 도 cooling 문제로 최고 성능 CPU·GPU 가 약 300~400 W 에서 제한.
- Robert H. Dennard 는 DRAM 발명자
- Dennard scaling 시대: 더 많고 빠른 transistor 를 같은 power 로
- slide: 세대마다 같은 power 에서 frequency 1.4배, 2006년 이후 약 4 GHz 에서 제한
2.6.r.1Dennard scaling — Wikipedia ↗ · 1974년 원 논문, 2005~2007년 붕괴 원인(leakage, threshold voltage)과 power wall
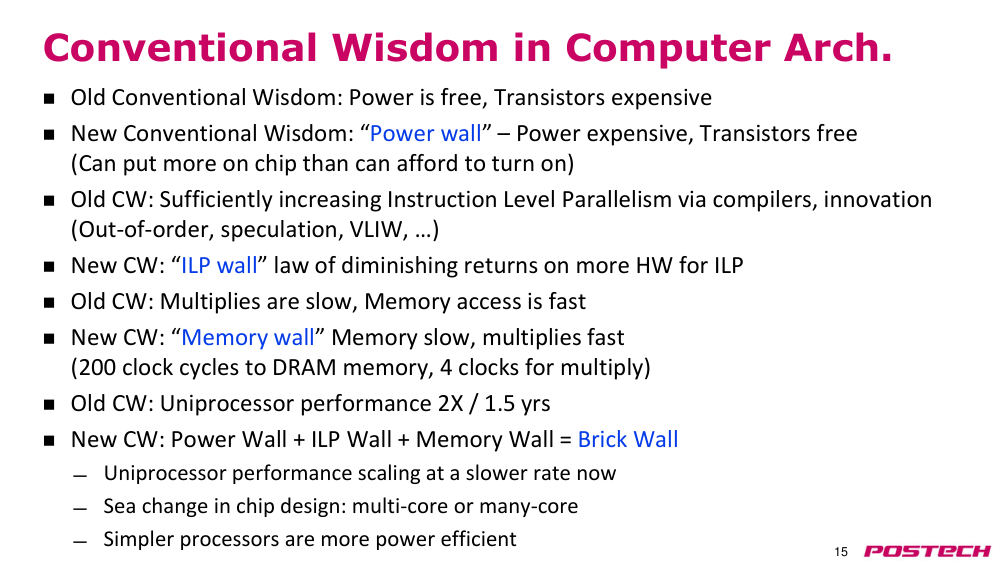
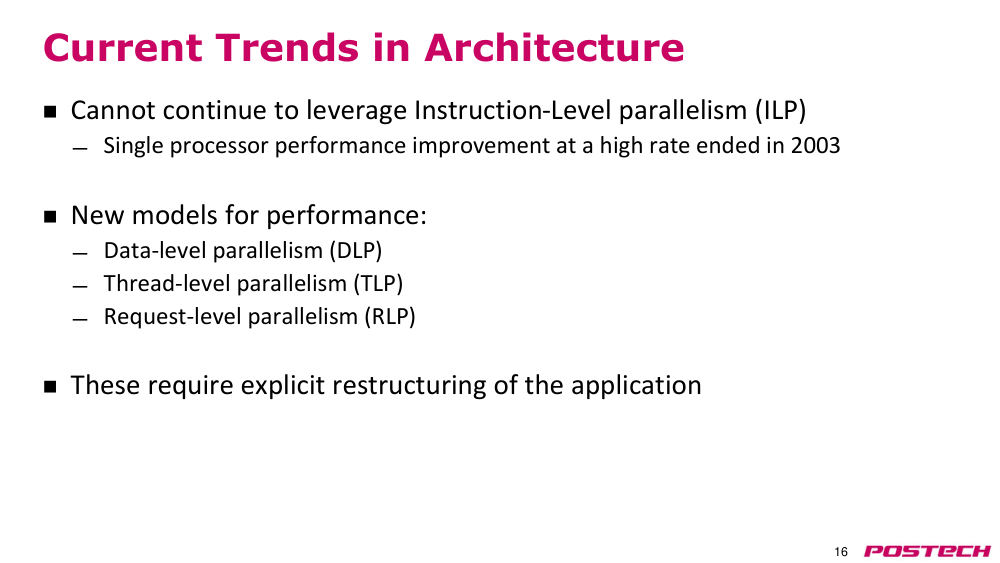
2.735:58–40:25conventional wisdom(통념)의 변화와 현재 추세
상황·문제과거 통념: power 는 공짜, transistor 가 귀함 / ILP 를 계속 늘릴 수 있음 / 계산은 느리고 memory 는 빠름 / uniprocessor 성능 빠르게 향상.
원인power wall(transistor 를 동시에 모두 켤 수 없음), ILP wall(ILP 투자 수익 체감), memory wall(memory access 가 계산보다 훨씬 비쌈).
해결ILP 대신 thread-level, data-level, request-level parallelism 을 활용. 이를 위해 application 을 명시적으로 재구성해야 함.
- 과거엔 같은 program 이 새 HW 에서 저절로 빨라졌음(ILP 는 거의 공짜)
- 이제 성능 향상은 application 재구성·parallelism 활용에서 옴
- CPU 내부 operand 계산은 싸고 main memory fetch 는 energy·시간이 큼
2.840:25–51:47과목 운영·프로젝트·paper critique 안내 (행정)
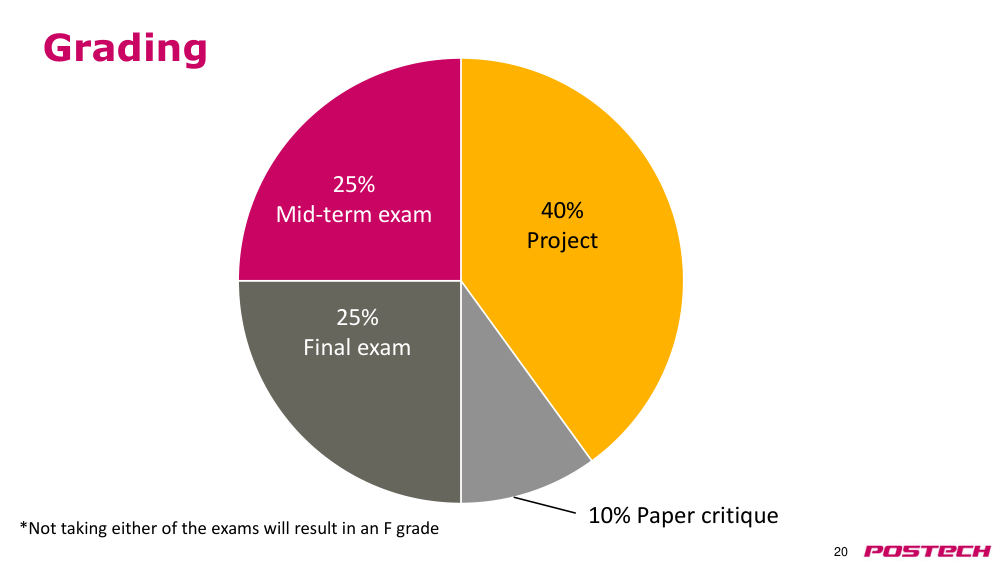
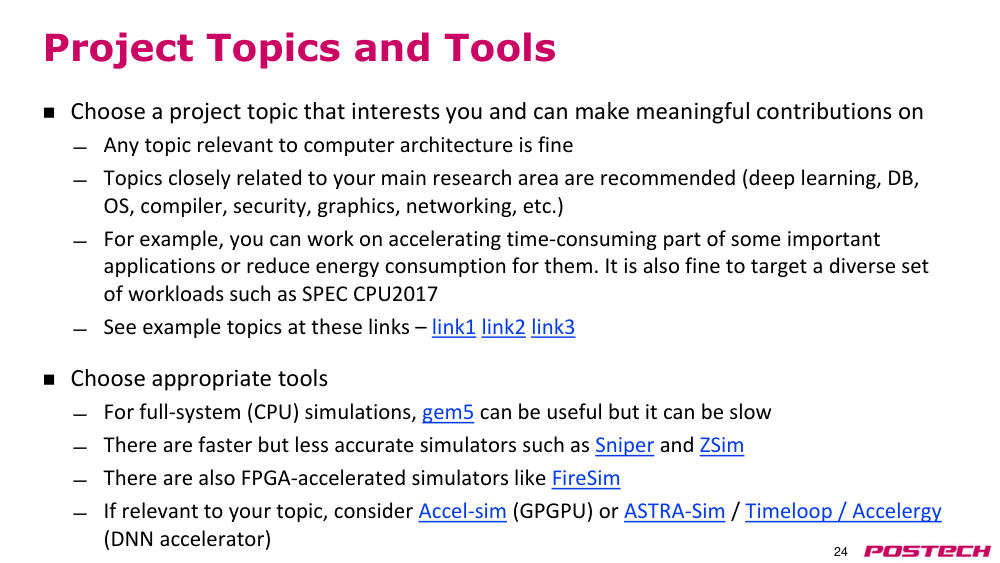
상황·문제PLMS·Zoom 수업, 교재 H&P 6판, 성적 중간 25 + 기말 25 + 프로젝트 40 + paper critique 10 (시험 미응시 F), 결석 7회 F. 2인 이하 팀 프로젝트로 4쪽 letter 논문 작성, 단순 변수 sweep 측정은 불인정. gem5 등 simulator 는 필요한 정확도에 맞게 선택. paper critique 6편은 영어로.
2.8.r.2Computer Architecture: A Quantitative Approach, 6th ed. — Elsevier ↗ · 교재 출판사 페이지 (목차·온라인 appendix 목록)
2.951:47–55:42computer architect 의 사고방식: 정량적 접근
상황·문제architecture 를 분석·비교·설계·평가할 때 감이 아니라 정량적 근거가 필요.
원인설계 시작부터 fabrication·출하까지 최소 2~3년이 걸려, 설계 시점 technology 가 아니라 출하 시점 technology 를 목표로 해야 함.
해결performance·cost·dependability·power/energy 를 정의·정량화해 비교하고, 미래 공정(예: 7nm → 5nm·3nm)의 transistor 수·허용 power 를 예측해 설계. HW/SW interface 는 신중히 설계.
- 정량적 설계 원칙 5가지: parallelism, locality, common case, Amdahl's law, processor performance equation
- interface 를 잘못 설계하면 software 가 비효율적으로 만들어짐
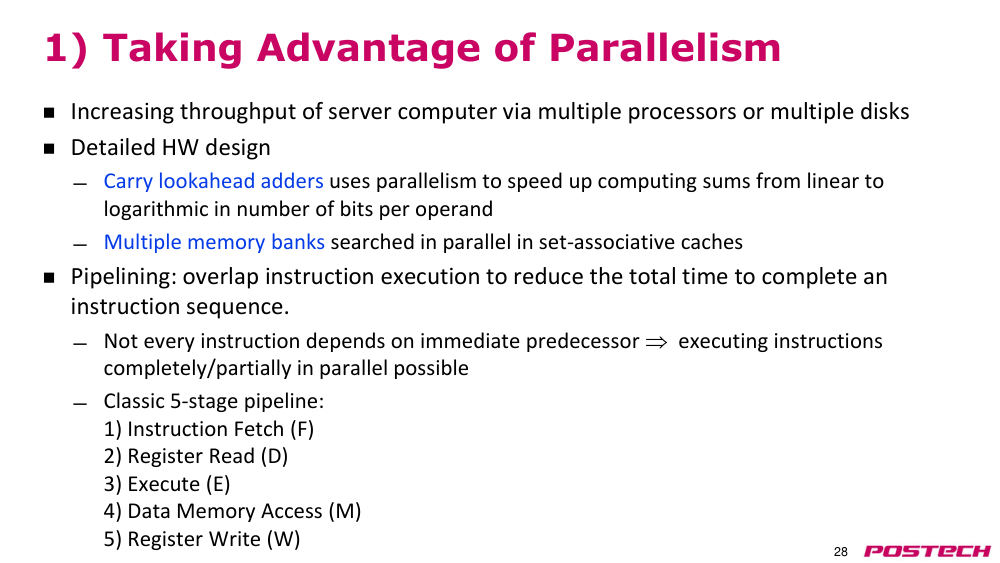
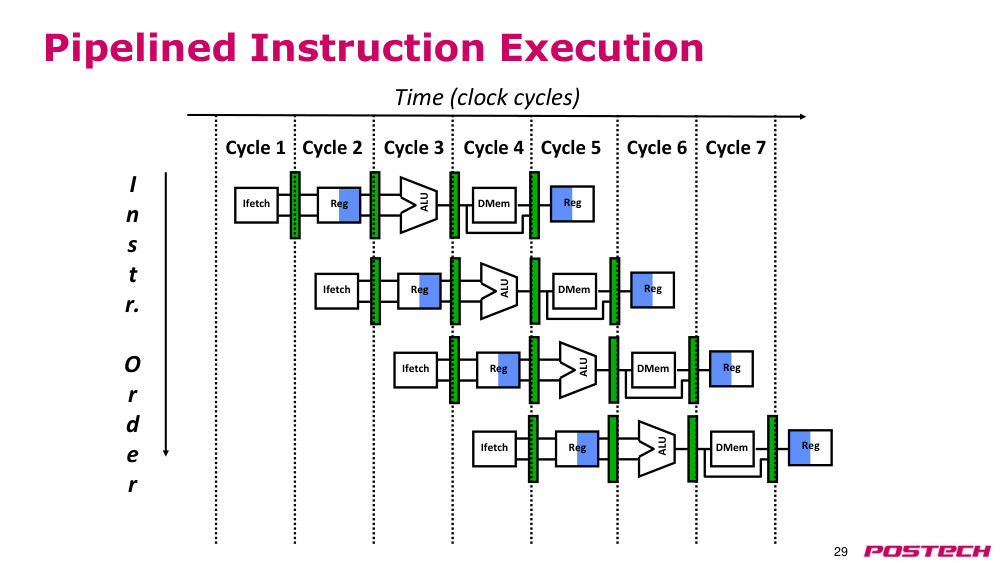
2.1055:42–59:08원칙 1: parallelism 활용과 pipelining
상황·문제single-thread 성능 한계로 parallelism 활용이 점점 중요해짐.
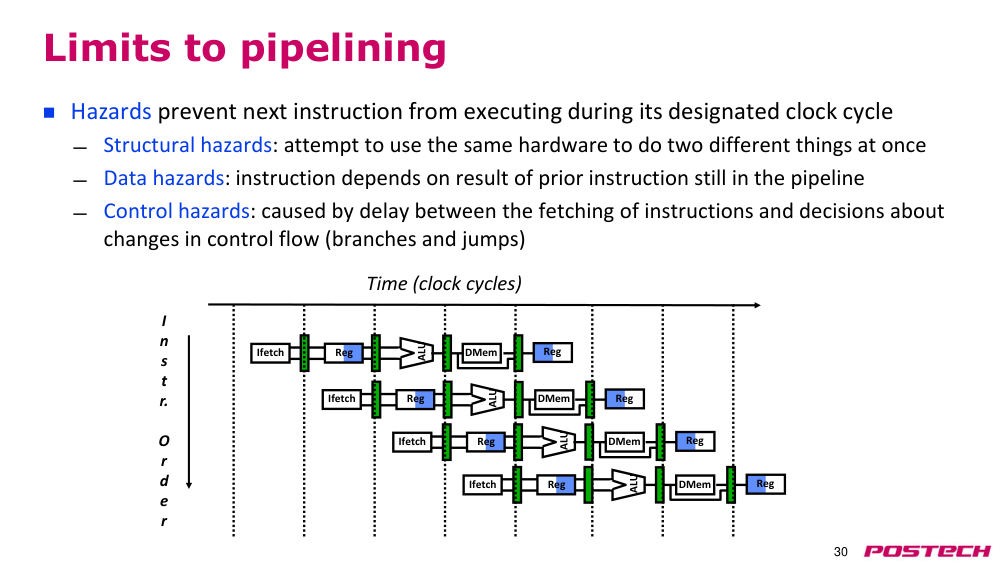
원인instruction 실행 단계들이 부분적으로 독립적이라 5-stage pipeline 에서 겹쳐 실행 가능. 단, hazard 가 parallelism 을 제한.
해결structural hazard 는 stall, data hazard 는 forwarding/bypassing 또는 stall, control hazard(branch·jump)는 prediction·speculation 과 잘못 추측 시 recovery.
- multiple processor·disk 로 throughput 향상, multiple memory bank 병렬 접근
- classic 5-stage: IF, ID, EX, MEM, WB
2.10.r.1Hazard (computer architecture) — Wikipedia ↗ · structural/data/control hazard 와 forwarding·stall·branch prediction
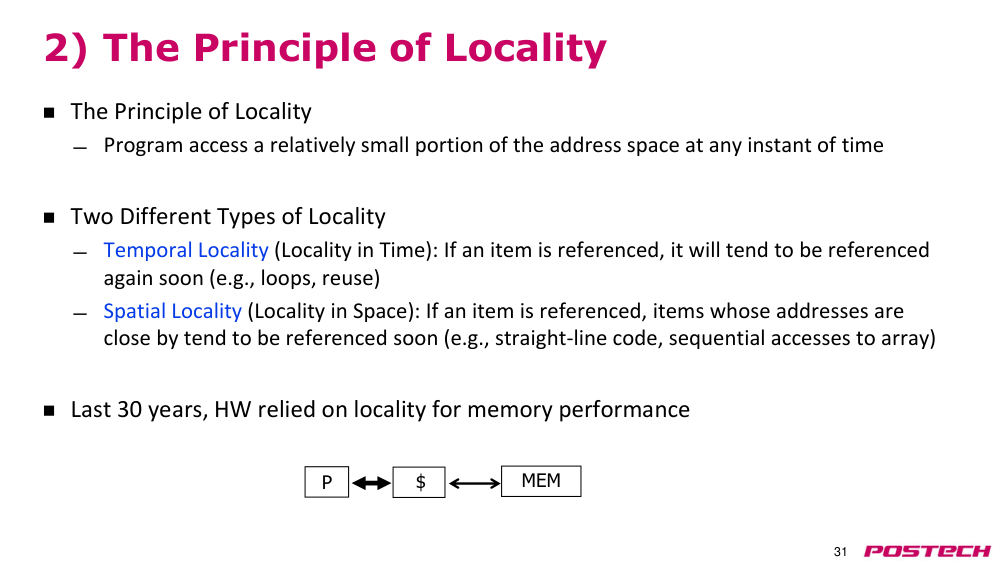
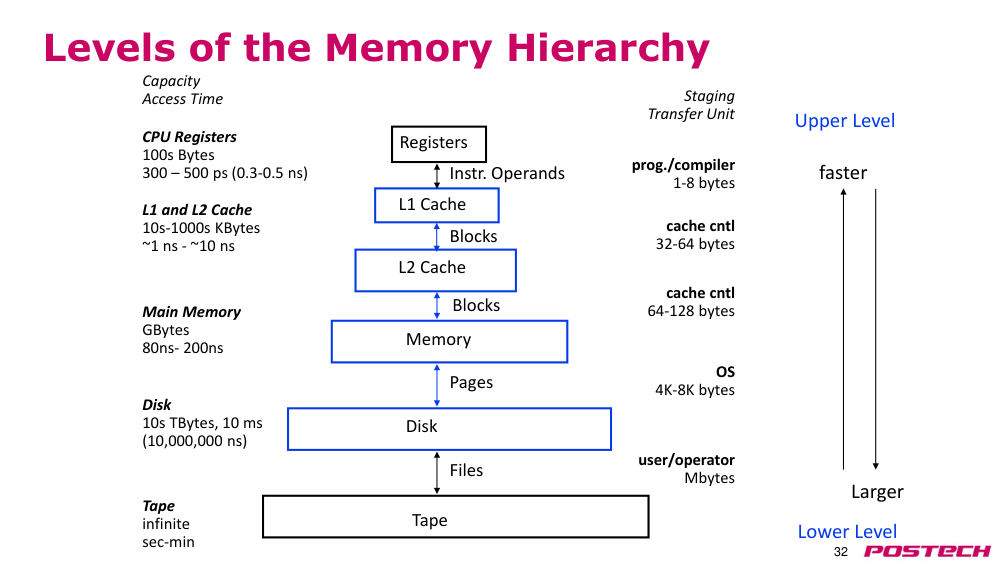
2.1159:08–1:02:37원칙 2: principle of locality(지역성)와 memory hierarchy
상황·문제memory hierarchy 는 위(register)로 갈수록 빠르지만 작고, 아래(disk, tape)로 갈수록 크지만 느림.
원인program 은 temporal locality(loop 에서 같은 변수 재사용)와 spatial locality(인접 instruction, 배열 순차 접근)를 보임.
해결자주 쓰는 data 를 상위 층에 두고 나머지는 하위 층에 두어 성능 최대화. 하위 층은 energy 면에서도 비효율적(disk/SSD 접근은 register·L1 보다 몇 자릿수 비쌈).
2.121:02:37–1:08:29원칙 3·4: common case 와 Amdahl's law(암달의 법칙)
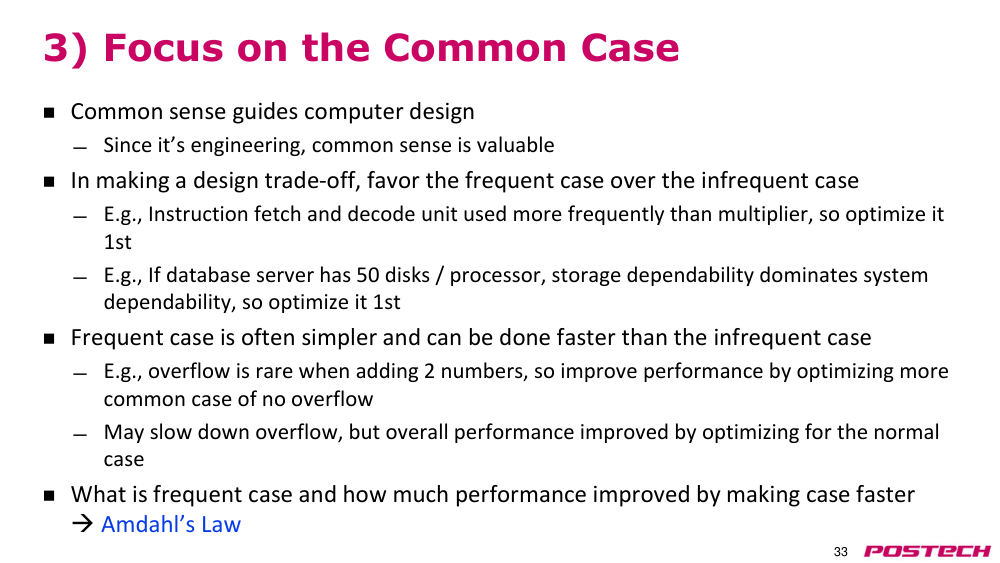
상황·문제trade-off 시 자주 일어나는 case 를 우선해야 함 (예: 덧셈의 overflow 는 드묾 → no-overflow 경로를 빠르게).
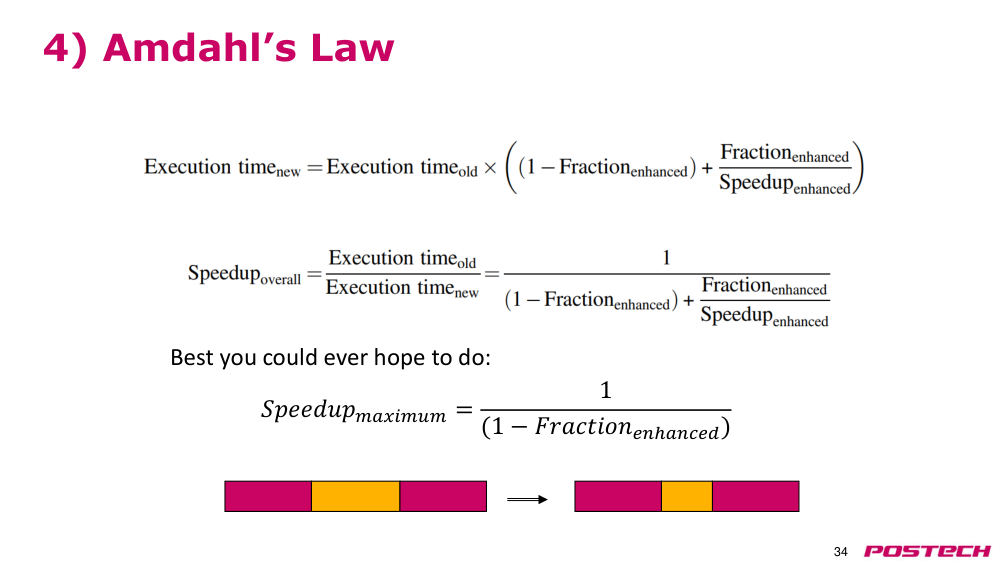
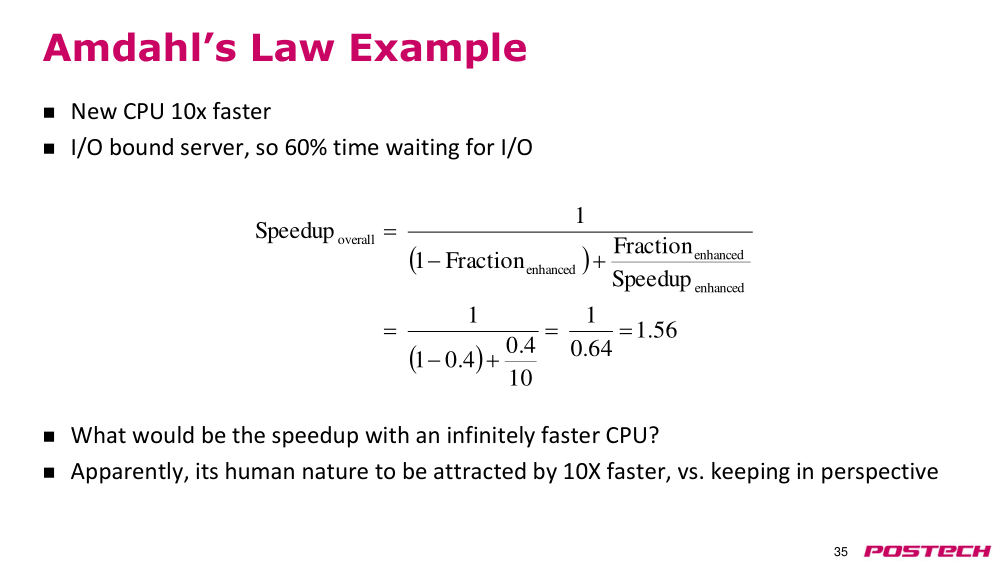
원인Amdahl's law: 개선되지 않는 부분 (1 − Fraction_enhanced) 이 전체 speedup 의 이론적 상한 1/(1 − Fraction_enhanced) 을 만듦.
해결개선 대상의 비중으로 end-to-end 효과를 따질 것. 10배 빠른 CPU 라도 60% 가 I/O 대기인 server 는 1.56배, CPU 가 무한히 빨라도 1/0.6 ≈ 1.67배.
- 논문의 100배 kernel 개선도 end-to-end 로는 훨씬 작을 수 있음
- GPGPU 초기의 100배 주장은 disk→CPU→GPU memory 복사와 결과 반환 시간을 무시
2.131:08:29–1:10:56원칙 5: processor performance equation
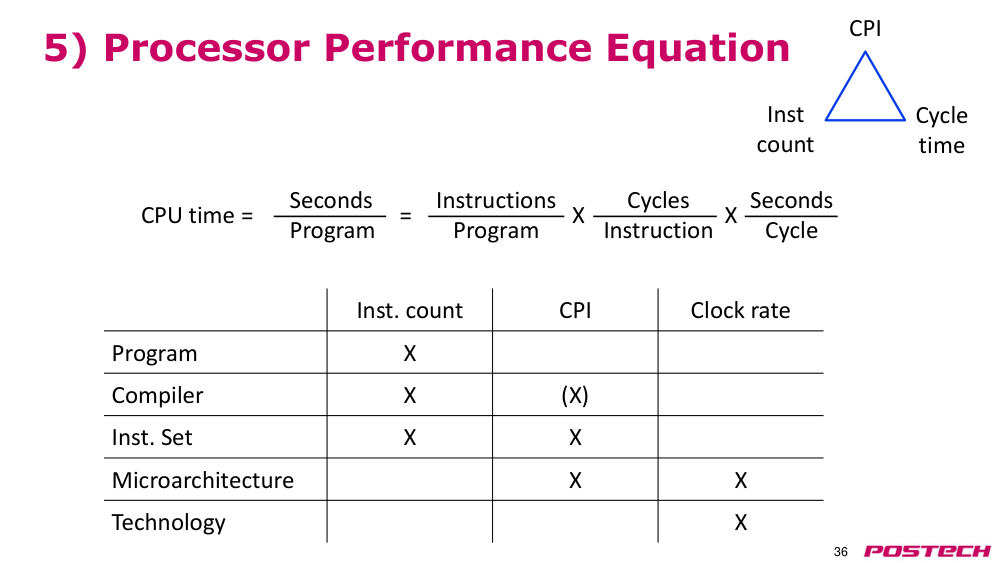
상황·문제궁극의 performance 척도는 runtime (seconds / program).
원인CPU time = instructions/program × cycles/instruction(CPI) × seconds/cycle 로 분해되며 각 항에 영향을 주는 층이 다름.
해결instruction count 는 compiler·ISA, CPI 는 주로 microarchitecture (compiler scheduling·ISA 도 영향), clock rate 는 microarchitecture·technology 가 결정 → SW 와 HW 전체의 상호작용.
2.141:10:56–1:14:26역사 1: 왜 역사를 보는가, analog → digital, Babbage
상황·문제역사는 반복되며, 새 아이디어가 이미 오래전에 나온 경우도 있어 architecture 연구에 역사 지식이 필요.
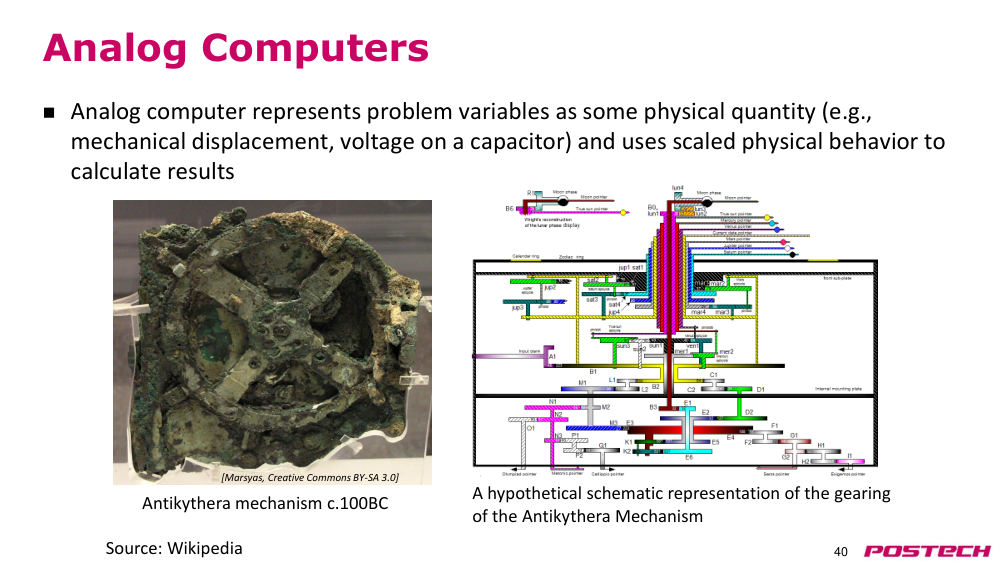
원인초기 computer 는 analog (예: Antikythera mechanism 은 sun·earth·moon 움직임 예측). digital 로 전환한 주된 이유는 noise 가 있어도 참값을 복원할 수 있다는 점.
해결Charles Babbage 의 Difference Engine(수동 crank)과 Analytical Engine(1837)은 이산값을 쓰는 초기 범용 digital computer.
- Analytical Engine: store(memory), mill(arithmetic unit), conditional branch·loop·exception, 초기 형태의 microcode
- input/output 은 punched card
2.151:14:26–1:20:29역사 2: 초기 programmable calculator 와 ENIAC
상황·문제20세기 전반엔 digital computing 이 비싸 analog 가 우세했으나 1930~40년대 programmable digital calculator 들이 만들어짐.
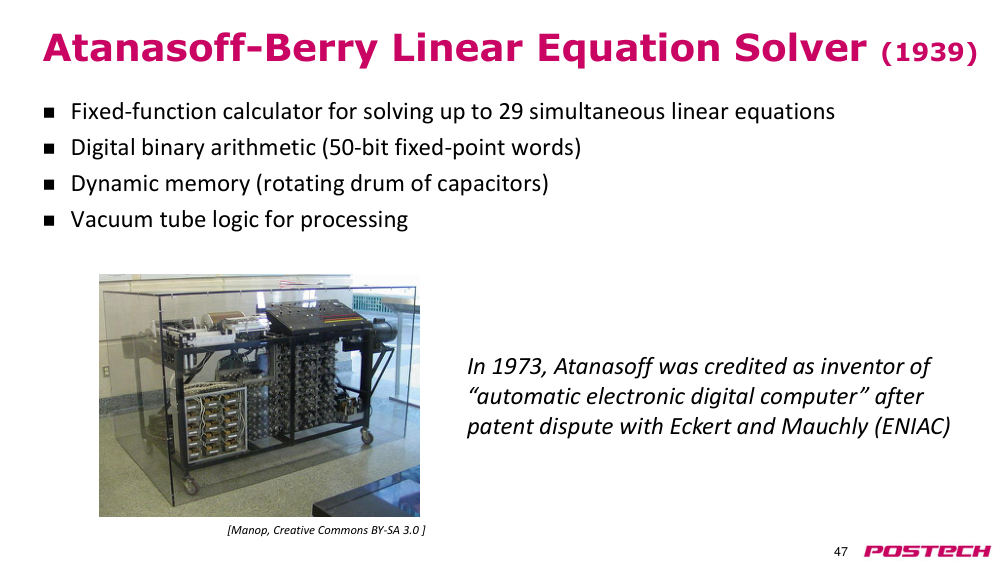
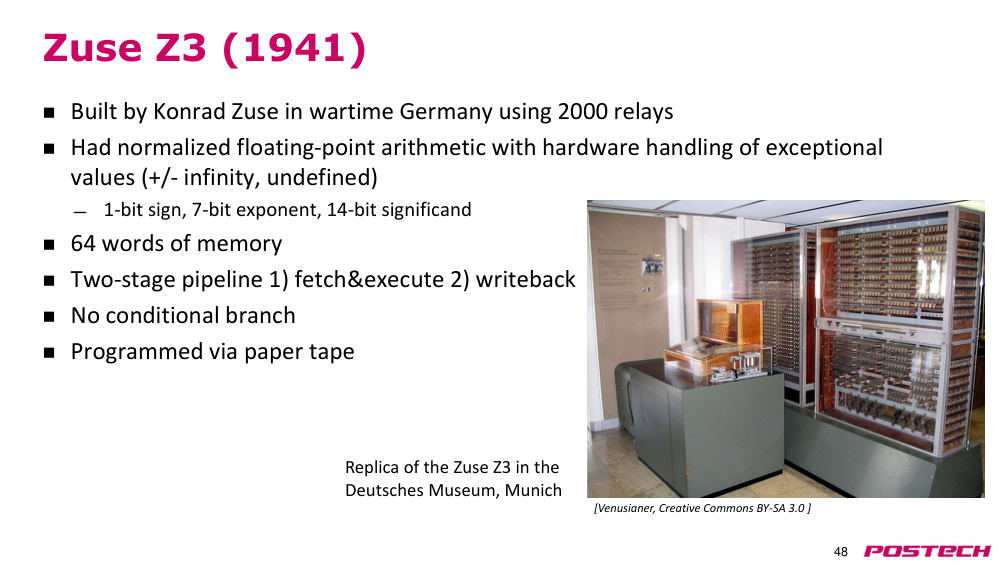
원인Atanasoff-Berry(50-bit fixed point, capacitor drum, vacuum tube), Zuse Z3(1941, normalized floating point, 2-stage pipeline, branch 없음), Harvard Mark I(1944, 기계식 5톤, paper tape 를 붙여 loop, branch 없음).
해결ENIAC 은 최초의 전자식 범용 computer (conditional branch 있음). 10자리 곱셈 2.8 ms 로 Mark I 대비 2,000배 빨랐지만 plugboard·switch 프로그래밍으로 I/O bound, vacuum tube 고장으로 최장 무고장 5일.
- Mark I: 72개 23자리 수, add 0.3 s, multiply 6 s, divide 15 s
- Z3 는 +/- infinity, undefined 같은 예외값을 HW 로 처리
2.161:20:29–1:27:09역사 3: stored program, delay line memory, 초기 ISA
상황·문제ENIAC 은 I/O bound 이고 프로그래밍이 어려움.
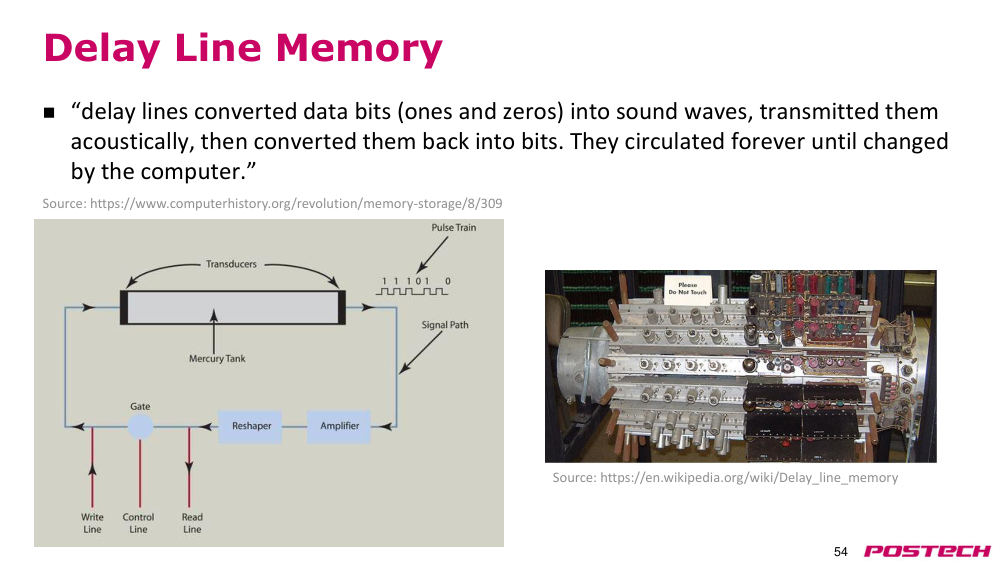
원인program 을 data 와 함께 memory 에 두는 stored program 개념(EDVAC)으로 기계 단순화와 성능 향상. memory 는 mercury delay line(음파 순환) → CRT 기반 Williams tube 로 발전.
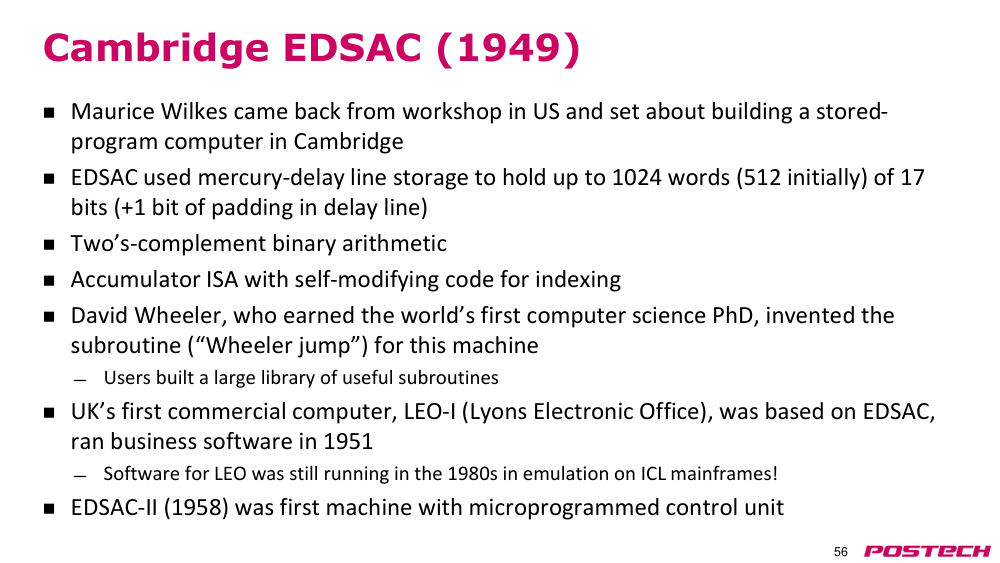
해결EDSAC: 17-bit word 최대 1024개, two's complement, index 는 self-modifying code 로 구현 → 이후 index register 추가 → general-purpose register 로 발전. accumulator 방식의 제약을 줄이려 stack architecture 도 등장.
- UNIVAC 은 아마도 최초의 성공한 상용 computer
- IBM 650: drum 기반 storage, digit-serial ALU, 약 2,000대 생산된 최초 대량생산 computer
2.171:27:09–1:31:48역사 4: IBM System/360 과 호환 ISA, 마무리
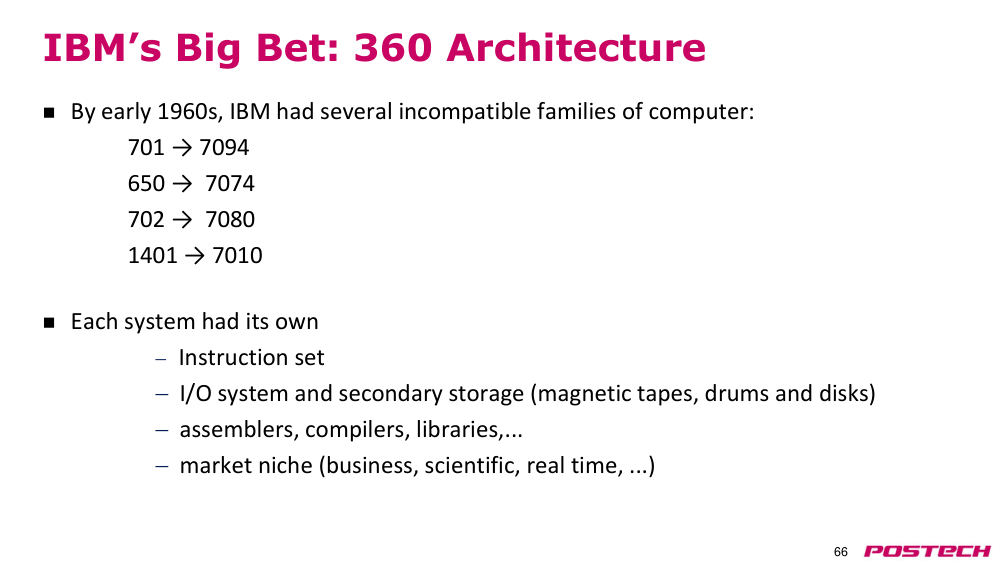
상황·문제1960년대 초 IBM 은 서로 호환되지 않는 여러 computer family 를 보유 (instruction set, I/O, assembler·compiler 모두 제각각).
원인호환이 안 되면 assembler·compiler·library 를 재사용할 수 없고, 프로그램 작성 시간까지 포함한 total performance 가 나빠짐.
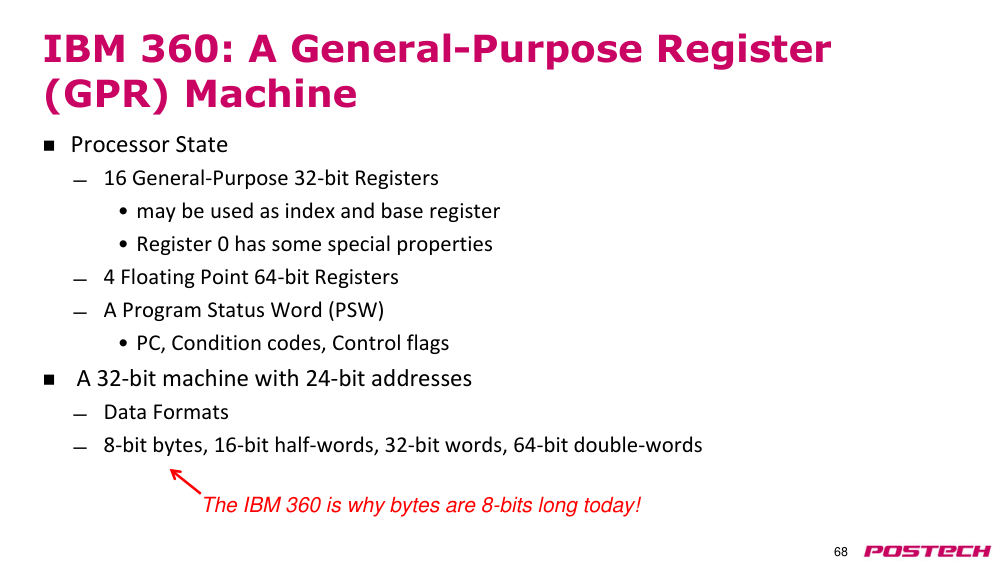
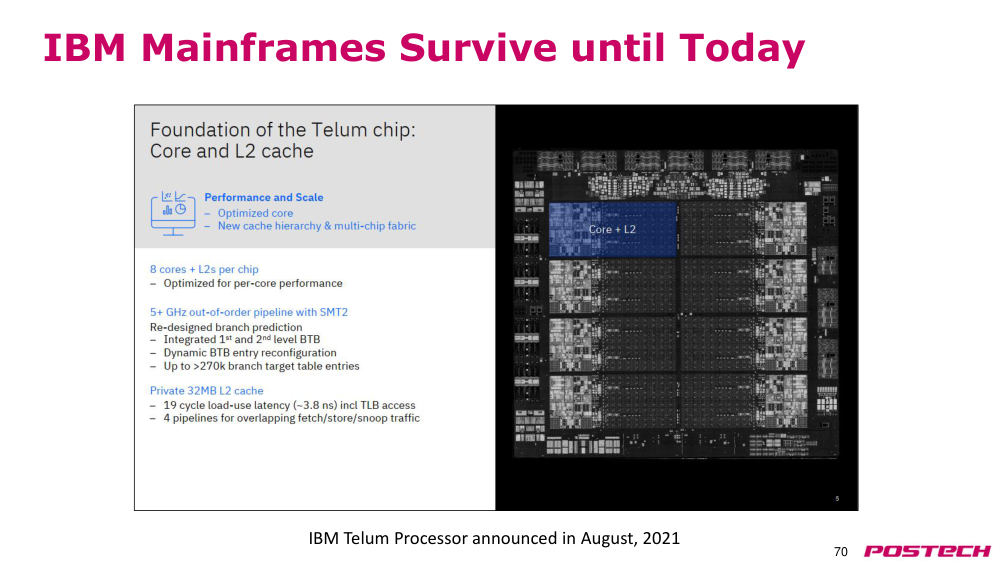
해결360 은 하나의 ISA 로 성능·용량이 다른 model(30~70)을 제공 = 최초의 portable HW/SW interface. 16개 32-bit GPR, 4개 64-bit FP register, PSW, 8-bit byte 정의. 호환성은 2021년 8월 발표된 Telum 까지 이어짐.
- 설계 전제: 수동 개입 최소화, downtime 감소, fault tolerance, 36-bit 보다 큰 floating point
- 다음 시간 전 CSED311 RISC-V slide 복습, 교재 1장·Appendix A, Hennessy·Patterson Turing Award 강연 시청
3핵심 개념
3.1ISA(instruction set architecture, 명령어 집합 구조)
SW 와 HW 사이 interface. instruction 모양과 기능을 정의하며 호환성 때문에 한 번 바꾸면 되돌리기 어렵다.
3.2microarchitecture(마이크로아키텍처)
ISA 를 HW 로 구현하는 고수준 설계(adder, register file, cache 등). 같은 ISA 에서 새 공정에 맞춰 자유롭게 바꿀 수 있다.
3.3Moore's law(무어의 법칙)
IC 의 transistor 수가 약 2년마다 2배. performance 에 대한 진술이 아니다.
3.4Dennard scaling(데나드 스케일링)
치수 1/k 축소 시 V·C·delay 1/k, power 1/k², 밀도 k² → power density 일정. leakage current·threshold voltage 때문에 2000년대 초 종료.
3.5power wall(전력 장벽) / ILP wall(ILP 장벽) / memory wall(메모리 장벽)
power 가 transistor 사용을 제한, ILP 투자 수익 체감, memory access 가 계산보다 훨씬 비쌈. 세 가지가 single-thread 성능 향상을 막는다.
3.6principle of locality(지역성 원리)
temporal: 참조된 항목은 곧 다시 참조. spatial: 인접 주소가 곧 참조. memory hierarchy 가 이를 이용한다.
3.7Amdahl's law(암달의 법칙)
Speedup = 1 / ((1−F) + F/S). 개선 안 되는 부분 때문에 상한은 1/(1−F).
3.8processor performance equation
CPU time = IC × CPI × clock cycle time. 각 항에 compiler, ISA, microarchitecture, technology 가 영향을 준다.
3.9stored program(내장 프로그램)
program 을 data 와 함께 memory 에 저장. ENIAC 의 I/O bound·프로그래밍 난이도를 해결했다 (EDVAC).
4스스로 확인
4.1Moore's law 는 무엇이 몇 년마다 2배가 된다는 관찰인가? 흔한 오해는?
답
IC 의 transistor 수가 약 2년마다 2배. performance 가 2배가 된다는 뜻이 아니다.
4.2Dennard scaling 에서 power density 가 일정하게 유지되는 이유와 종료 원인은?
답
회로당 power 는 1/k², 단위 면적당 transistor 는 k² 배라 상쇄된다. leakage current·threshold voltage 가 비례해 줄지 않아 종료됐다.
4.360% 가 I/O 대기인 server 에서 CPU 만 10배 빨라지면 전체 speedup 은? CPU 가 무한히 빨라지면?
답
1/(0.6 + 0.4/10) = 1/0.64 ≈ 1.56배. 무한히 빨라지면 1/0.6 ≈ 1.67배.
4.4CPI 에 영향을 주는 층은 무엇인가?
답
주로 microarchitecture. compiler(instruction scheduling)와 ISA 도 영향을 준다.
4.5EDSAC 은 index register 없이 배열을 어떻게 순회했나?
답
self-modifying code 로 program 안의 주소를 고쳤다. 이후 index register 를 거쳐 general-purpose register 로 발전했다.
4.6IBM 360 이 오늘날 computer 에 남긴 것 두 가지는?
답
여러 model 이 하나의 ISA 를 공유하는 호환 architecture, 그리고 8-bit byte.
5참고 자료
5.1Computer Architecture: A Quantitative Approach, 6th ed. — Elsevier ↗ · 과목 교재 (1장, Appendix A 읽기 과제)