이 자료를 쓰는 강의: 01 컴퓨터 구조 개론과 역사
Lec1 - Intro
한국어판 강의자료 · 72쪽
p.1CSED503 고급 컴퓨터 구조 – 강의 1
- 소개
- 김광선
- POSTECH 컴퓨터공학과
- 2021 가을학기
- 면책 조항: 많은 슬라이드는 UC Berkeley, MIT, UPenn, 위스콘신 대학교의 David Patterson, Krste Asanovic, Joe Devietti, Milo Martin, Amir Roth, Mark Hill, Guri Sohi, Jim Smith, Joel Emer, James Hoe, John Kubiatowicz, David Wood 등이 만든 자료를 바탕으로 수정함
p.2질문
- earliest memory에서 자주 사용했던 컴퓨터의 CPU 코어 수는 얼마였나요?
- 그때는 언제였나요?
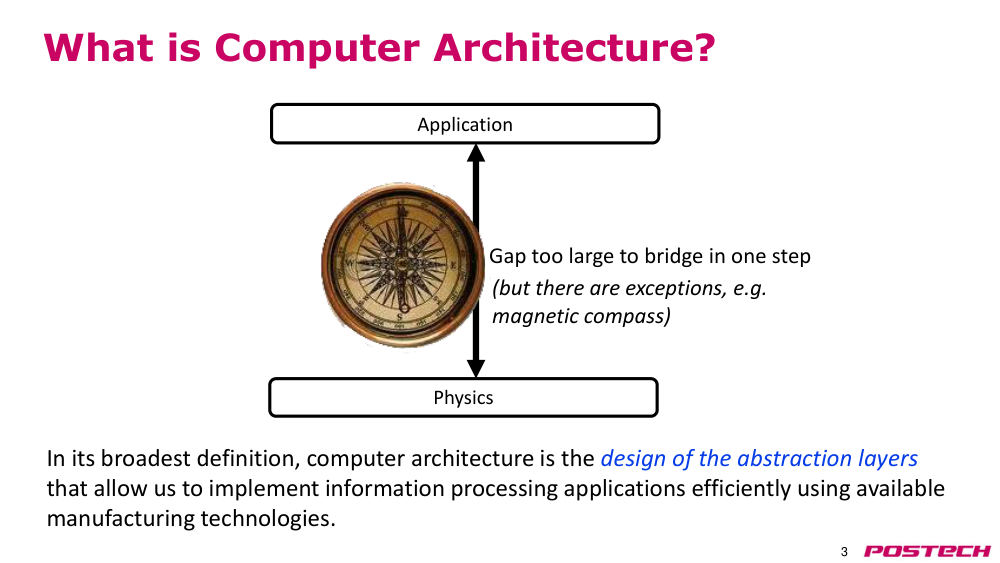
p.3컴퓨터 구조란 무엇인가?
- 응용 프로그램
- 물리학
- 한 번에 다리를 건널 수 없는 큰 간극
- 가장 광범위한 정의에서, 컴퓨터 구조는 정보 처리 응용을 효율적으로 구현하기 위해 사용 가능한 제조 기술을 활용할 수 있도록 하는 추상화 계층의 설계이다.
- (단, 예외도 있음, 예: 자석침)
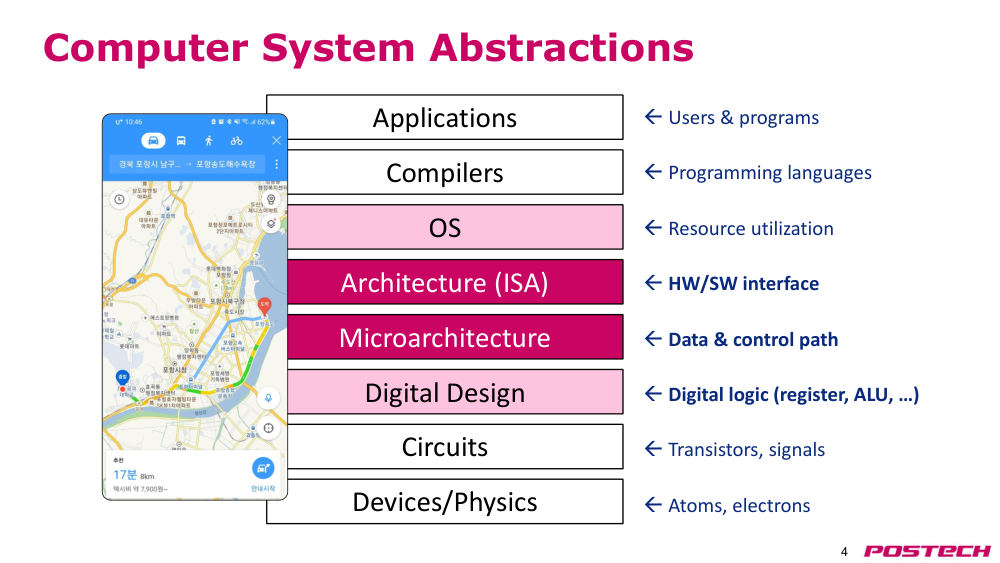
p.4컴퓨터 시스템 추상화
- 응용 프로그램
- 컴파일러
- 운영체제
- 컴퓨터 구조 (명령어 집합 아키텍처)
- microarchitecture(마이크로아키텍처)
- 디지털 설계
- 회로
- 장치/물리학
- 사용자 및 프로그램 ←
- 프로그래밍 언어 ←
- 자원 활용 ←
- 하드웨어/소프트웨어 인터페이스 ←
- 데이터 및 제어 경로 ←
- 디지털 논리 (레지스터, ALU 등) ←
- 트랜지스터, 신호 ←
- 원자, 전자 ←
p.5컴퓨터 설계에 포함되는 요소
- 명령어 집합 아키텍처 (ISA): 소프트웨어와 하드웨어 사이의 인터페이스
- microarchitecture(마이크로아키텍처): 컴퓨터 설계의 고수준 요소들, 예를 들어 메모리 시스템, 메모리 상호연결, 내부 프로세서 또는 CPU 설계 (산술, 논리, 분기, 데이터 전송이 구현되는 곳)
- hardware realization(하드웨어 구현): 컴퓨터의 구체적인 사항들, 포함 사항으로는 세부 논리 설계 및 컴퓨터의 패키징 기술
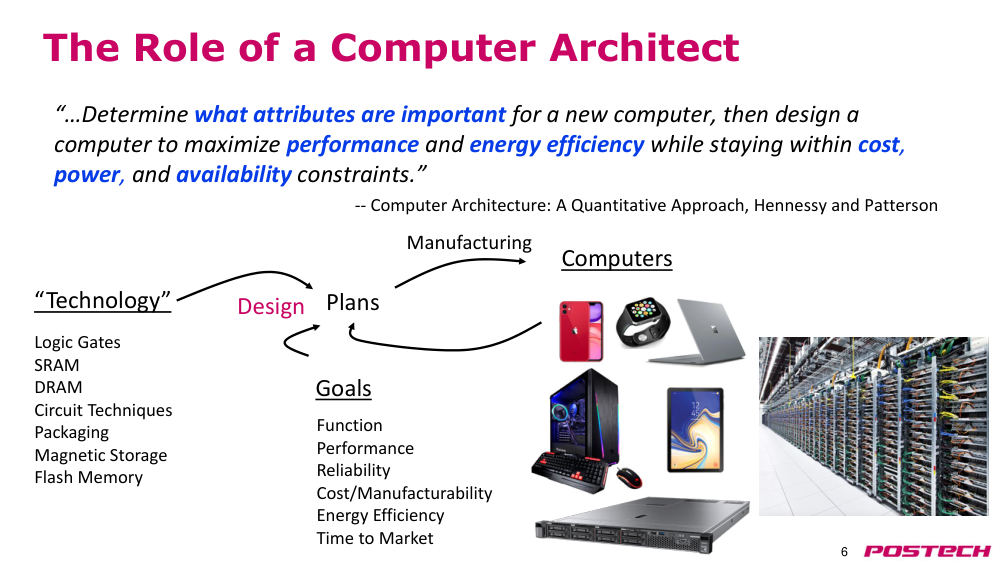
p.6컴퓨터 아키텍트의 역할
- 기술
- 목표
- 컴퓨터
- 계획
- 설계
- 제조
- 논리 게이트
- SRAM
- DRAM
- 회로 기술
- 패키징
- 자기 저장 장치
- 플래시 메모리
- 기능
- 성능
- reliability(신뢰성)
- Cost/Manufacturability(비용/제조 가능성)
- power efficiency(에너지 효율성)
- time to market(시장 진입 시간)
- “새로운 컴퓨터에 중요한 특성은 무엇인지 결정한 후, 비용, 전력, 가용성 제약 내에서 성능과 power efficiency(에너지 효율성)을 극대화할 수 있도록 컴퓨터를 설계한다.”
- -- Hennessy와 Patterson의 『컴퓨터 구조: 정량적 접근법』
p.7오늘날 주요 타겟 시스템
- 임베디드 컴퓨팅
- 와이어드/와이어리스 네트워크 인프라, 프린터
- 소비자 TV/음악/게임/자동차/카메라/MP3
- 사물인터넷! (IoT)
- 모바일(스마트폰/태블릿)
- >10억 대/년 판매
- 시장은 SoC 내 ARM-ISA 호환 일반 목적 프로세서로 주도됨
- 추가로 다양한 맞춤형 가속기(라디오, 이미지, 비디오, 그래픽, 오디오, 보안 등)가 존재함
- 창고 규모 컴퓨터(WSCs)
- 창고당 수십만 개의 코어
- 시장은 x86 호환 서버 칩으로 주도됨
- 전용 애플리케이션과 virtual machine (VM)(가상 머신)의 클라우드 호스팅
- 최근에는 작업 부하 가속을 위해 GPU, FPGA, 맞춤형 하드웨어 사용 증가 중
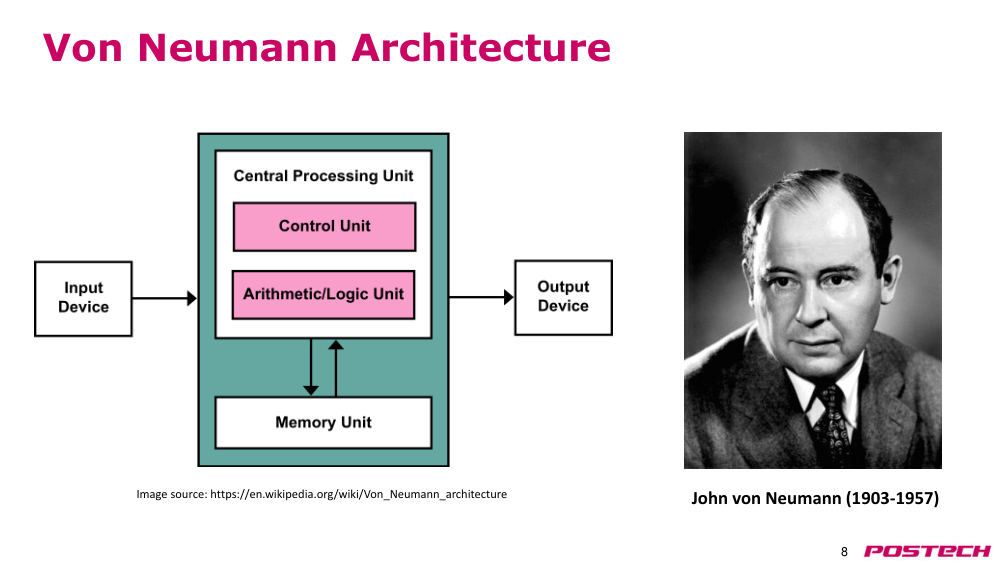
p.8Von Neumann architecture(폰 노이만 아키텍처)
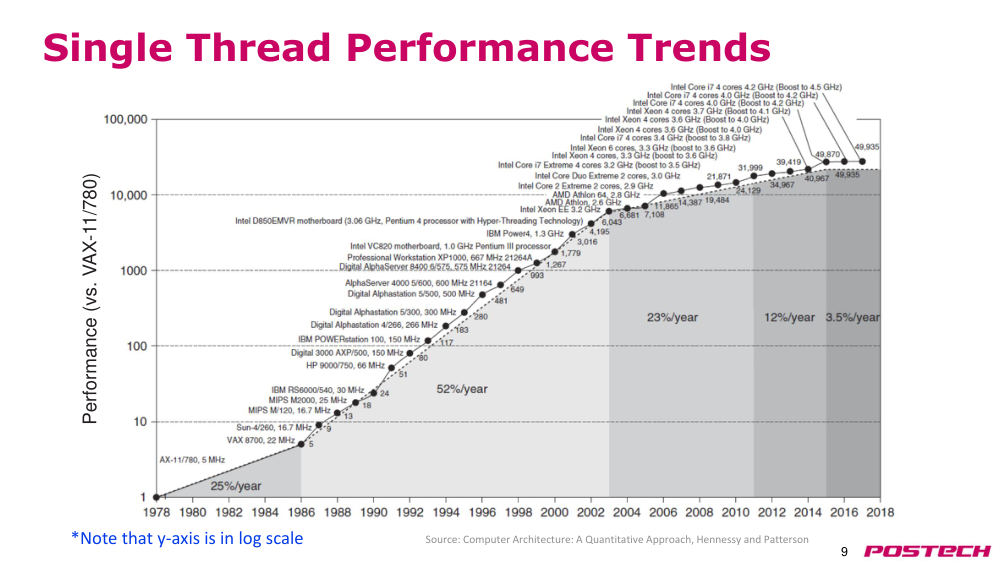
p.9single thread performance(단일 스레드 성능) 추세
- 성능 (VAX-11/780 기준)
- 참고: y축은 로그 스케일임
- 출처: Computer Architecture: A Quantitative Approach, Hennessy and Patterson
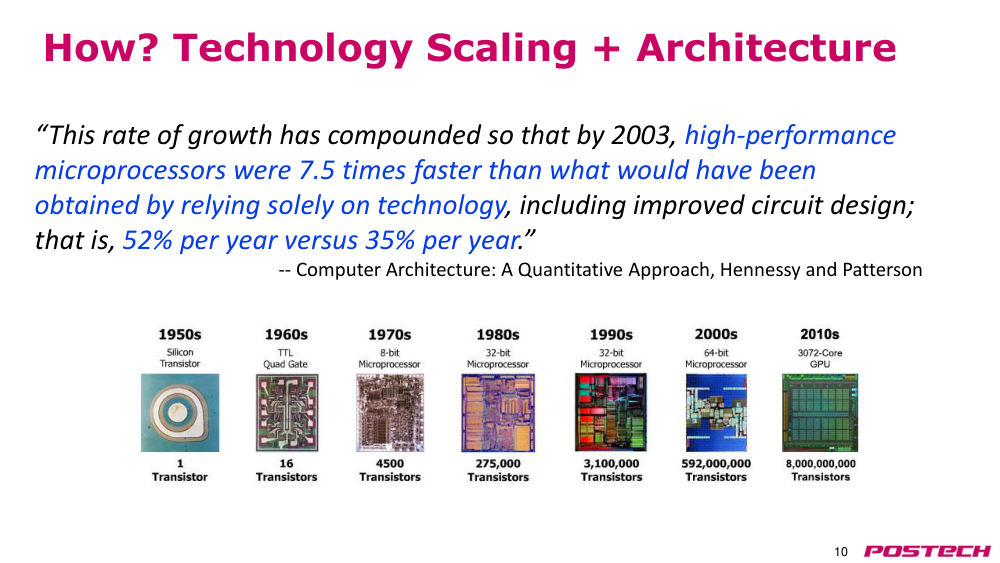
p.10어떻게? 기술 스케일링 + 아키텍처
- 이 성장률은 복리처럼 작용하여 2003년에는 고성능 마이크로프로세서가 순수 기술(회로 설계 개선 포함)에 의존할 경우보다 7.5배 빠르게 작동하고 있었다. 즉, 연간 52% 성장률 대비 35% 성장률을 기록했다.
- -- Computer Architecture: A Quantitative Approach, Hennessy and Patterson
p.11질문 – Moore's law(무어의 법칙)이란 무엇인가?
- (1) 는 통합 회로에서 약 (2) 년마다 두 배로 증가한다
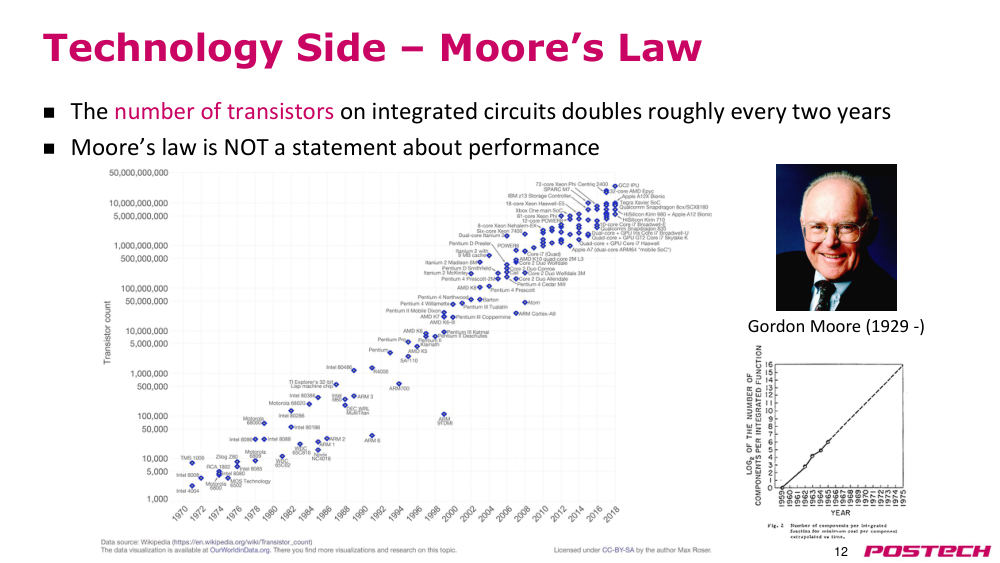
p.12기술 측면 – Moore's law(무어의 법칙)
- 통합 회로에 있는 트랜지스터 수는 약 2년마다 두 배로 증가한다
- Moore's law(무어의 법칙)은 성능에 대한 진술이 아니다
- Gordon Moore (1929 -)
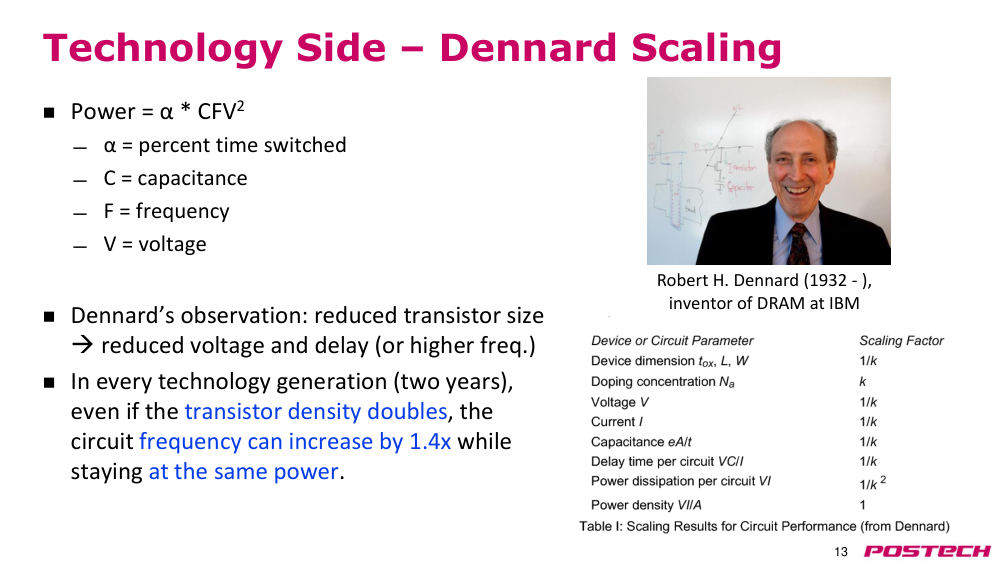
p.13기술 측면 – Dennard scaling(덴너드 스케일링)
- Power = α * CFV²
- α = 스위칭 비율
- C = 용량
- F = 주파수
- V = 전압
- 덴너드의 관찰: 트랜지스터 크기 감소 → 전압과 latency(지연 시간) 감소 (또는 주파수 증가)
- 모든 기술 세대(2년마다)에서, 트랜지스터 밀도가 두 배로 증가하더라도, 동일한 전력 수준에서 회로 주파수는 1.4배까지 증가할 수 있음.
- Robert H. Dennard (1932 - ), IBM에서 DRAM의 발명자
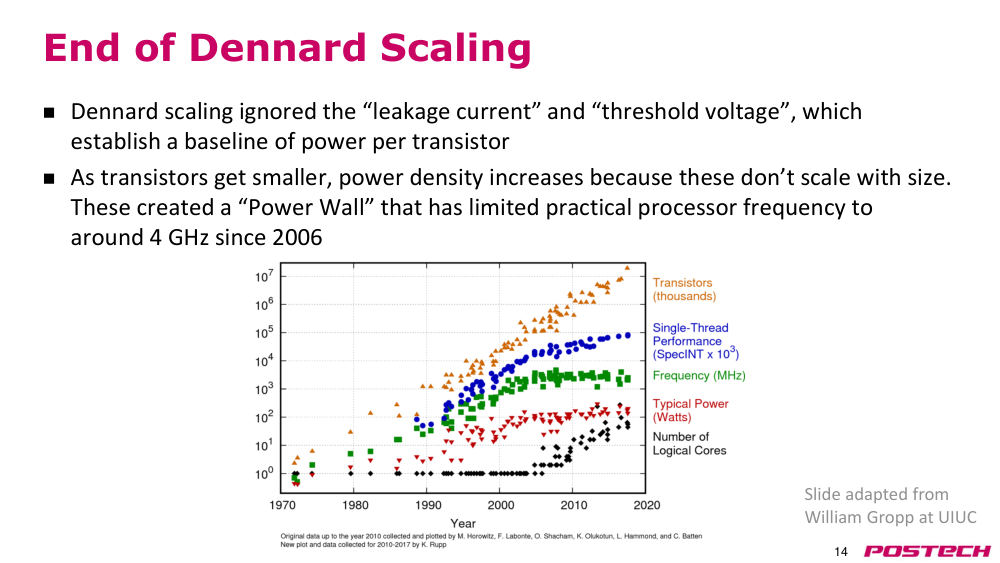
p.14Dennard scaling(덴너드 스케일링)의 종료
- Dennard scaling(덴너드 스케일링)은 '누설 전류'와 '임계 전압'을 무시함. 이는 트랜지스터당 기준 전력 수준을 결정함.
- 트랜지스터가 작아질수록 전력 밀도가 증가함. 이는 크기에 따라 스케일링되지 않기 때문임.
- 이로 인해 'power wall(파워 월)'이 발생하였으며, 2006년 이후 실용적인 프로세서 주파수는 약 4GHz로 제한됨.
- 슬라이드는 UIUC의 William Gropp에서 인용
p.15컴퓨터 아키텍처의 전통적 통념
- 구전통념: 전력은 무료, 트랜지스터는 비쌈
- 신통념: 'power wall(파워 월)' – 전력은 비쌈, 트랜지스터는 무료 (더 많은 트랜지스터를 칩에 넣을 수 있지만 켜는 데 부담)
- 구통념: 컴파일러와 혁신(out-of-order(비순차 실행), speculation(추측 실행), VLIW 등)을 통해 명령어 수준 병렬성(ILP)을 충분히 증가시킬 수 있음
- 신통념: 'ILP wall(ILP 월)' – 더 많은 하드웨어를 ILP에 투입해도 수익이 감소하는 법칙
- 구통념: 곱셈은 느리고, 메모리 접근은 빠름
- 신통념: 'memory wall(메모리 월)' – 메모리는 느리고, 곱셈은 빠름 (DRAM 메모리 접근에 200 clock cycle(클럭 사이클), 곱셈은 4 클럭)
- 구통념: 단일 프로세서 성능은 1.5년마다 2배 증가
- 신통념: power wall(파워 월) + ILP wall(ILP 월) + memory wall(메모리 월) = brick wall(브릭 월)
- 단일 프로세서 성능의 확장 속도가 이제 더 느려짐
- 칩 설계에 큰 변화: 멀티코어 또는 마니코어
- 간단한 프로세서가 더 에너지 효율적임
p.16아키텍처의 현재 추세
- 명령어 수준 병렬성(ILP)을 더 이상 활용할 수 없음
- 단일 프로세서 성능 향상이 2003년에 고점에 도달함
- 성능을 위한 새로운 모델:
- 데이터 수준 병렬성 (DLP)
- 스레드 수준 병렬성 (TLP)
- 요청 수준 병렬성 (RLP)
- 이러한 모델들은 애플리케이션의 명시적 재구성 필요
p.17오늘의 강의 일정
- 이 과목이 다루는 내용
- 과목 정보 (성적 평가, 정책 등)
- 컴퓨터 아키텍처의 기초
- 역사적 관점
p.18과목 정보
- 강사: 김광선 교수 (Prof. Gwangsun Kim)
- 연락처: g.kim@postech.ac.kr
- 사무실: 인공지능연구원(PIAI) #433
- 오피스 아워: 약속에 따라 (이메일로 요청)
- 홈페이지: https://sites.google.com/view/gkim
- 연구 관심사:
- • Domain-Specific accelerator (DSA)(도메인 특화 가속기) 및 Processing-in-Memory(메모리 내 처리)
- • emerging memory technology(신규 메모리 기술)을 활용한 메모리 시스템
- • interconnection networks(상호연결 네트워크)
- 이 과목은 주로 PLMS를 사용함
- 강의는 Zoom을 통해 진행되며, 녹화본은 PLMS를 통해 제공됨
p.19교재
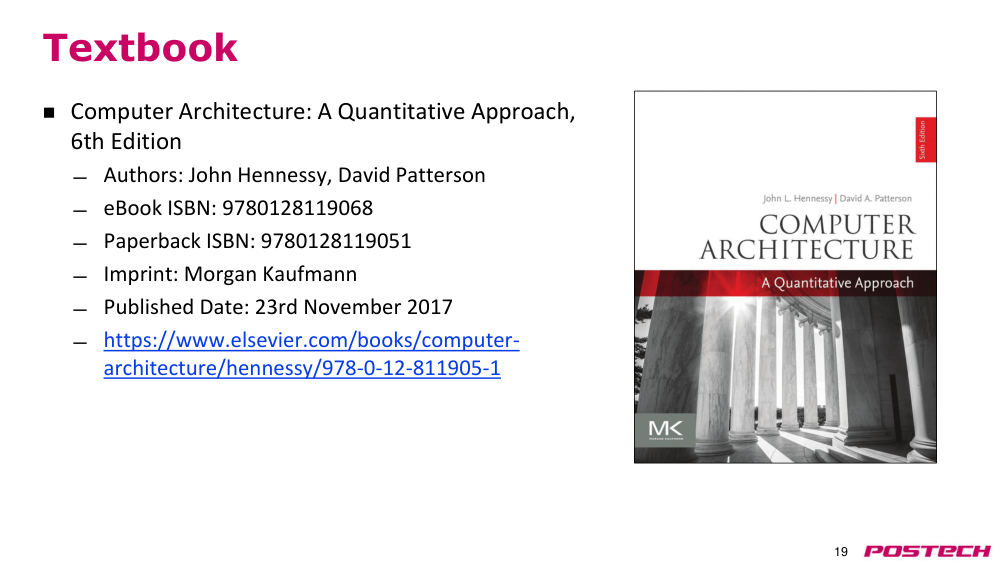
- Computer Architecture: A Quantitative Approach, 6th Edition
- 저자: John Hennessy, David Patterson
- eBook ISBN: 9780128119068
- 종이책 ISBN: 9780128119051
- 출판사: Morgan Kaufmann
- 발행일: 2017년 11월 23일
- https://www.elsevier.com/books/computer-architecture/hennessy/978-0-12-811905-1
p.20성적 평가 기준
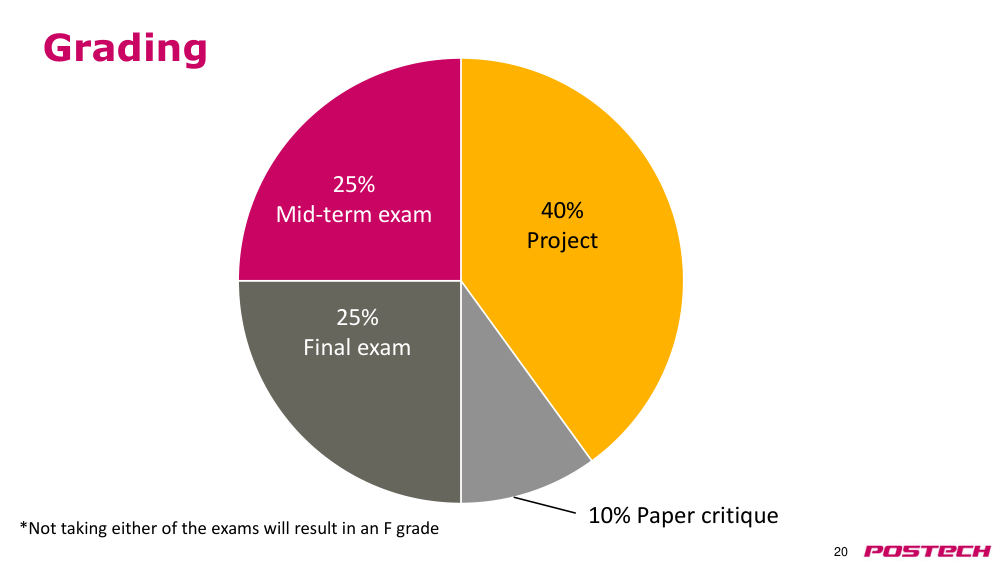
- 중간고사: 25%
- 기말고사: 25%
- 프로젝트: 40%
- 논문 비평: 10%
- 중간고사 또는 기말고사 중 하나를 응시하지 않을 경우 F 등급 처리
p.21출석
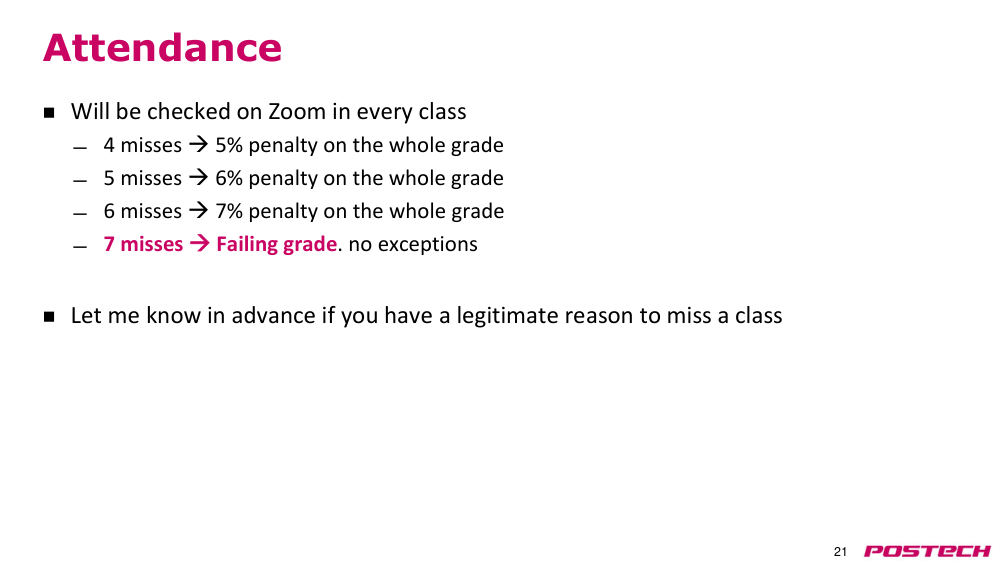
- 모든 수업에서 Zoom을 통해 출석을 확인합니다.
- 결석 4회: 전체 성적에 5% 감점
- 결석 5회: 전체 성적에 6% 감점
- 결석 6회: 전체 성적에 7% 감점
- 결석 7회: 불합격 처리 (예외 없음)
- 사전에 정당한 사유가 있는 경우 미리 알리기
p.22수업 일정 (예비)
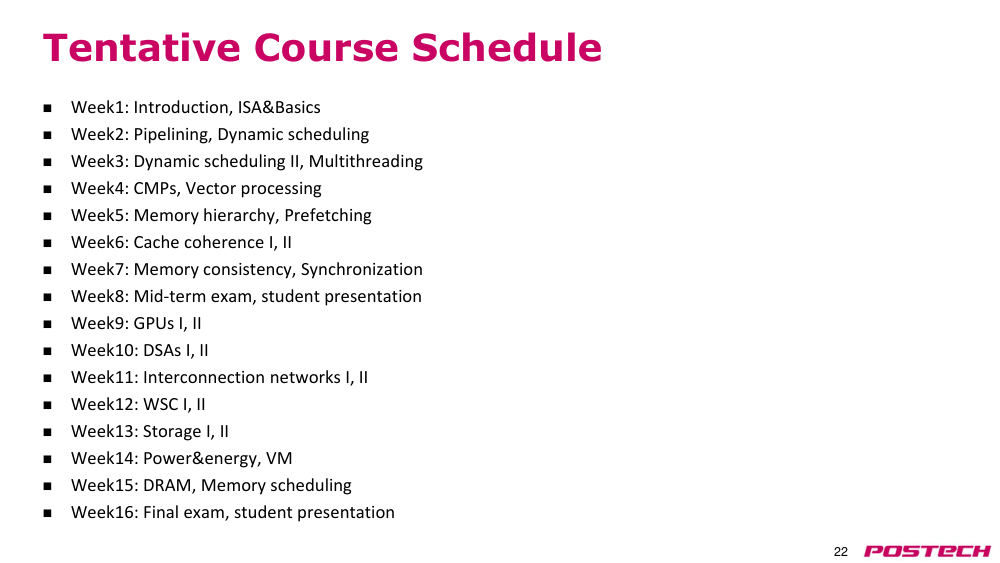
- 1주차: 소개, ISA 및 기초
- 2주차: pipelining(파이프라인), 동적 스케줄링
- 3주차: 동적 스케줄링 II, 멀티스레딩
- 4주차: CMP, 벡터 처리
- 5주차: 메모리 계층, 프리패치
- 6주차: cache coherence(캐시 일관성) I, II
- 7주차: memory consistency(메모리 일관성), synchronization(동기화)
- 8주차: 중간고사, 학생 발표
- 9주차: GPU I, II
- 10주차: DSA I, II
- 11주차: interconnection networks(상호연결 네트워크) I, II
- 12주차: Warehouse-Scale computers (WSCs)(창고 규모 컴퓨터) WSC I, II
- 13주차: 스토리지 I, II
- 14주차: 전력 및 에너지, virtual machine (VM)(가상 머신)
- 15주차: DRAM, 메모리 스케줄링
- 16주차: 기말고사, 학생 발표
p.23팀(또는 개인) 프로젝트
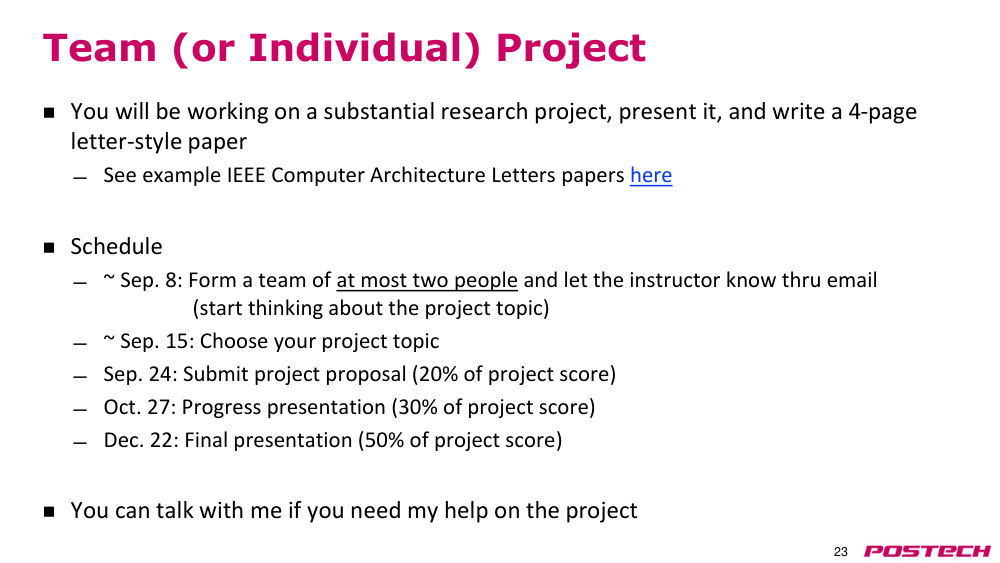
- 심층적인 연구 프로젝트를 수행하고, 발표하며, 4페이지 규모의 논문 형식의 보고서를 작성합니다.
- 예시: IEEE Computer Architecture Letters 논문 참조
- 일정:
- 9월 8일 이전: 최대 2명으로 팀 구성 후 강사에게 이메일로 알리기 (프로젝트 주제 고민 시작)
- 9월 15일 이전: 프로젝트 주제 선정
- 9월 24일: 프로젝트 제안서 제출 (프로젝트 점수의 20%)
- 10월 27일: 진행 상황 발표 (프로젝트 점수의 30%)
- 12월 22일: 최종 발표 (프로젝트 점수의 50%)
- 프로젝트 관련 도움이 필요할 경우 언제든지 상의 가능
p.24프로젝트 주제 및 도구
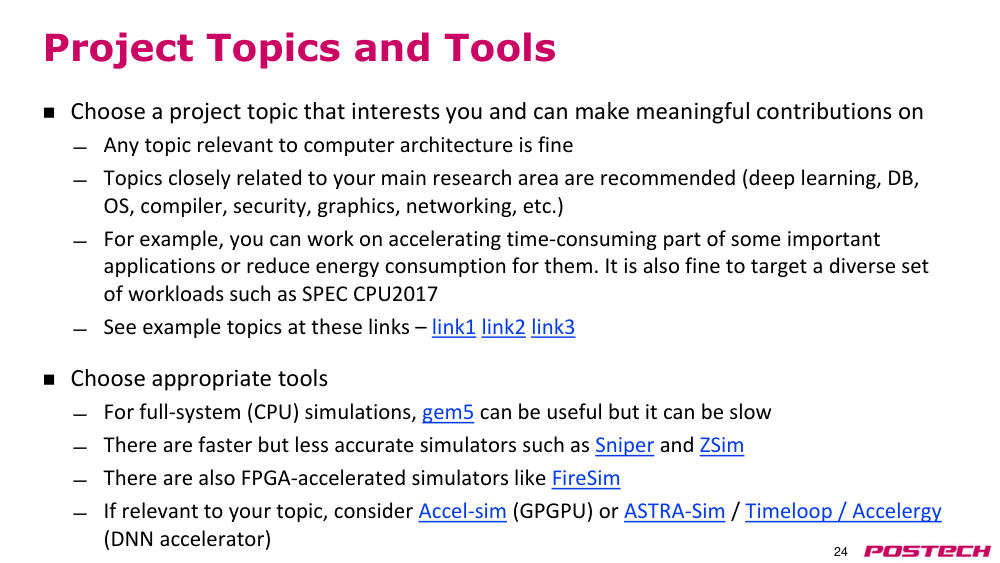
- 관심 있는 주제를 선택하고 의미 있는 기여를 할 수 있는 주제를 고르세요.
- 컴퓨터 아키텍처와 관련된 모든 주제는 가능합니다.
- 주요 연구 분야와 관련된 주제를 추천합니다 (딥러닝, 데이터베이스, 운영체제, 컴파일러, 보안, 그래픽스, 네트워킹 등).
- 예: 중요한 응용 프로그램의 시간 소모가 큰 부분을 가속화하거나, energy consumption(에너지 소비)를 줄이는 작업도 가능합니다.
- SPEC CPU2017과 같은 다양한 워크로드를 대상으로 하는 것도 좋습니다.
- 예시 주제: 링크1, 링크2, 링크3 참조
- 적절한 도구 선택:
- 전체 시스템(CPU) 시뮬레이션에는 gem5가 유용하지만 느릴 수 있습니다.
- 더 빠르지만 정확도가 낮은 시뮬레이터로는 Sniper, ZSim이 있습니다.
- FPGA 기반 가속 시뮬레이터로는 FireSim이 있습니다.
- 주제와 관련이 있다면, Accel-sim(GPGPU), ASTRA-Sim / Timeloop / Accelergy(DNN 가속기)도 고려하세요.
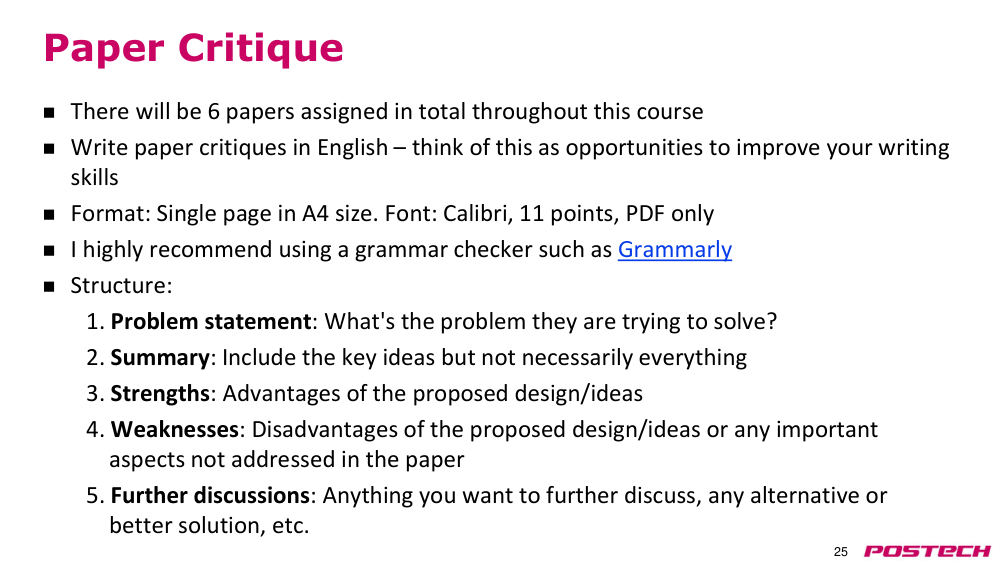
p.25논문 비평
- 이 과정 동안 총 6편의 논문이 지정될 예정입니다.
- 논문 비평은 영어로 작성하세요 – 이는 글쓰기 능력을 향상시킬 기회로 생각하시기 바랍니다.
- 형식: A4 사이즈 단일 페이지. 폰트: Calibri, 11포인트, PDF 형식만 허용합니다.
- Grammarly와 같은 문법 검사기를 사용하는 것을 매우 추천합니다.
- 구조:
- 1. 문제 제기: 그들이 해결하려는 문제는 무엇입니까?
- 2. 요약: 핵심 아이디어를 포함하되, 반드시 모든 내용을 담을 필요는 없습니다.
- 3. 강점: 제안된 설계/아이디어의 장점
- 4. 약점: 제안된 설계/아이디어의 단점 또는 논문에서 다루지 않은 중요한 측면
- 5. 추가 논의: 더 논의하고 싶은 사항, 대안적 또는 더 나은 해결책 등
p.26컴퓨터 아키텍처의 핵심 원칙
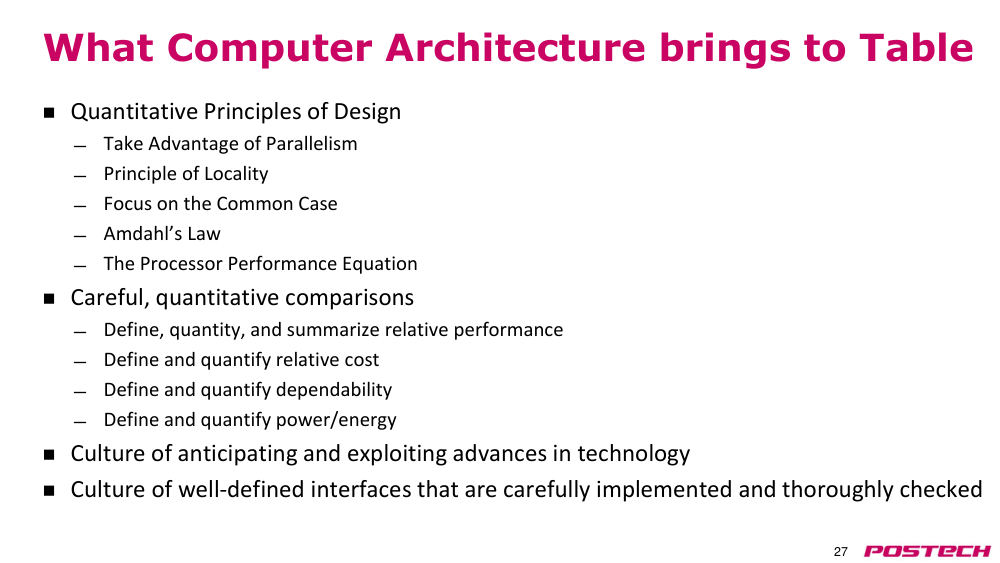
p.27컴퓨터 아키텍처가 제공하는 것
- quantitative principles of design(정량적 설계 원칙)
- 병렬성 활용
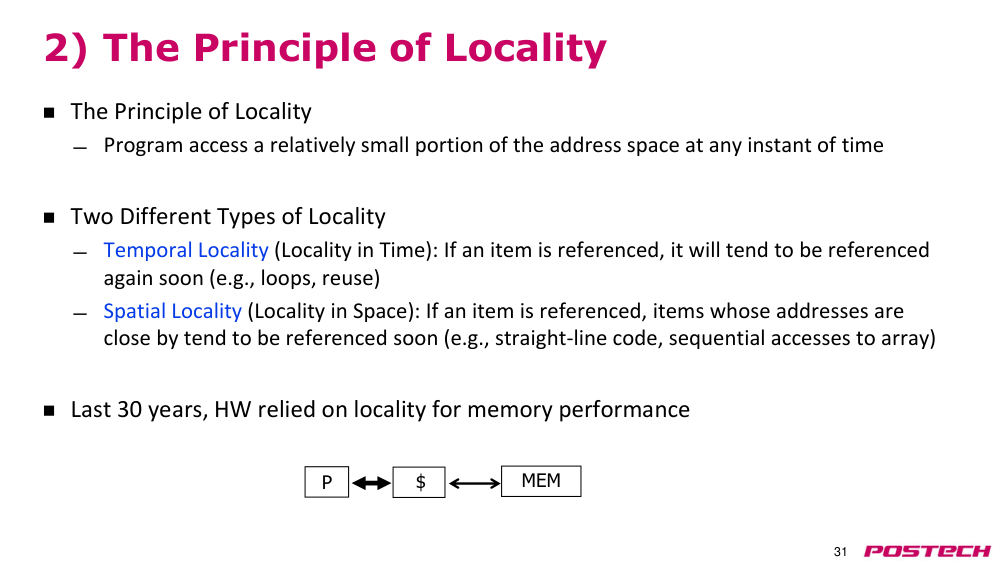
- principle of locality(국소성 원칙)
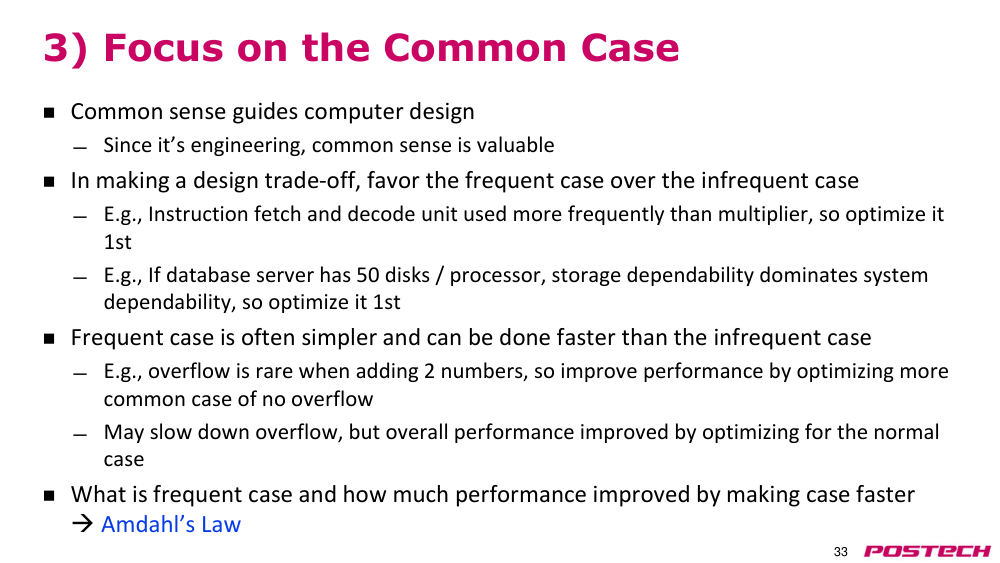
- focus on the common case(빈번한 경우에 집중)
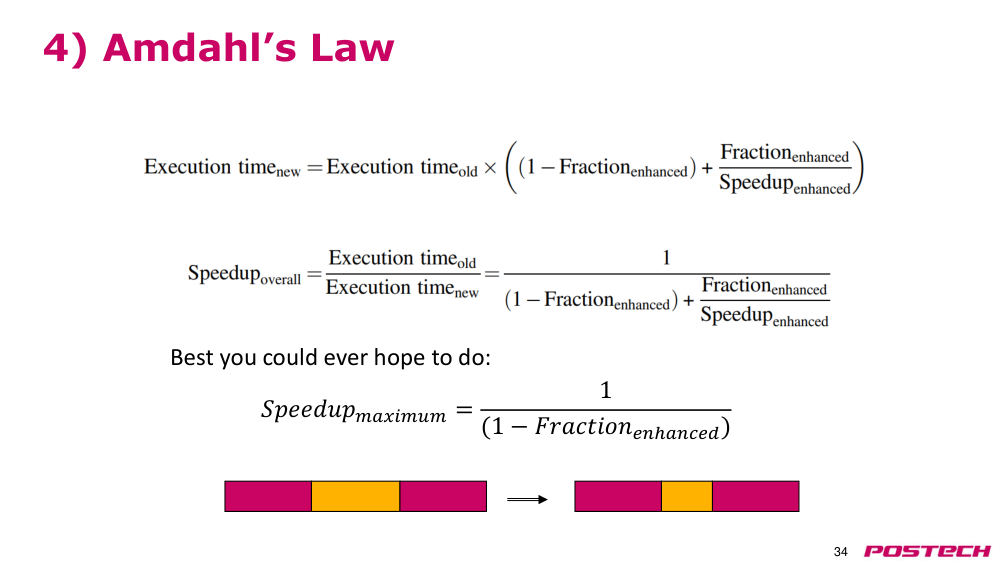
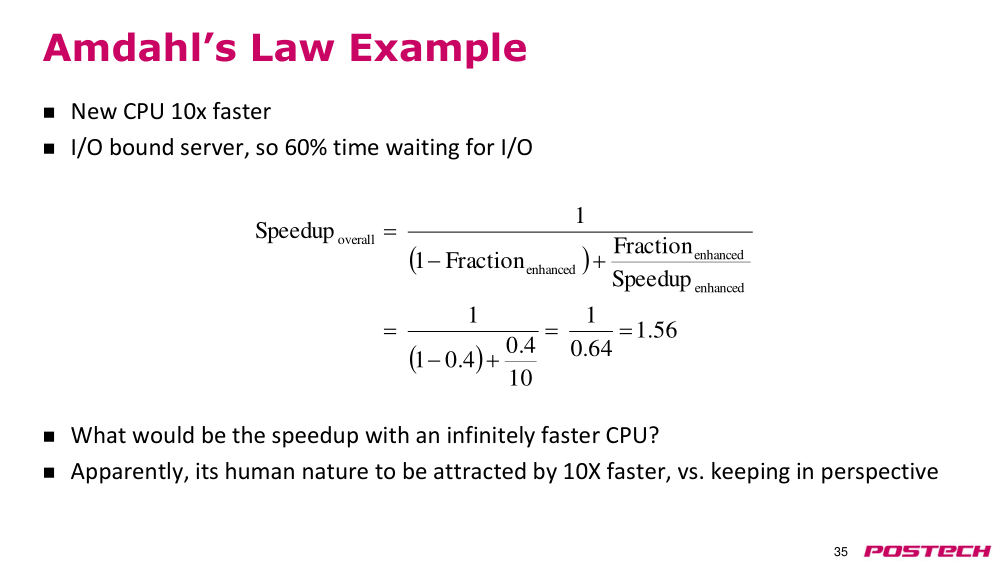
- Amdahl's law(암다울의 법칙)
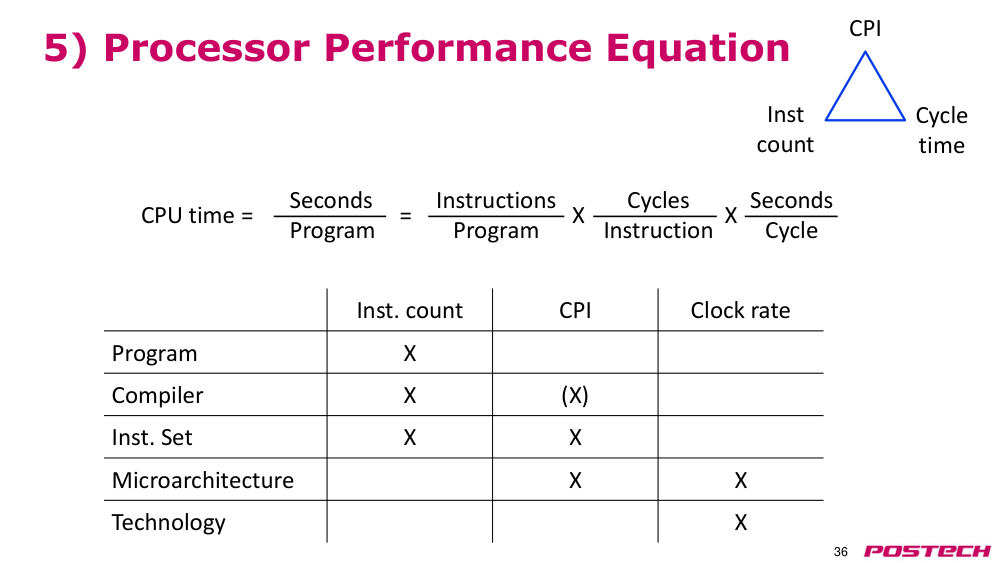
- processor performance equation(프로세서 성능 방정식)
- 신중하고 정량적인 비교
- 상대 성능을 정의, 측정, 요약하기
- 상대 비용을 정의하고 측정하기
- dependability(신뢰성)을 정의하고 측정하기
- power/energy(전력/에너지)를 정의하고 측정하기
- 기술 발전을 예측하고 활용하는 문화
- 정의된 인터페이스를 신중하게 구현하고 철저히 검증하는 문화
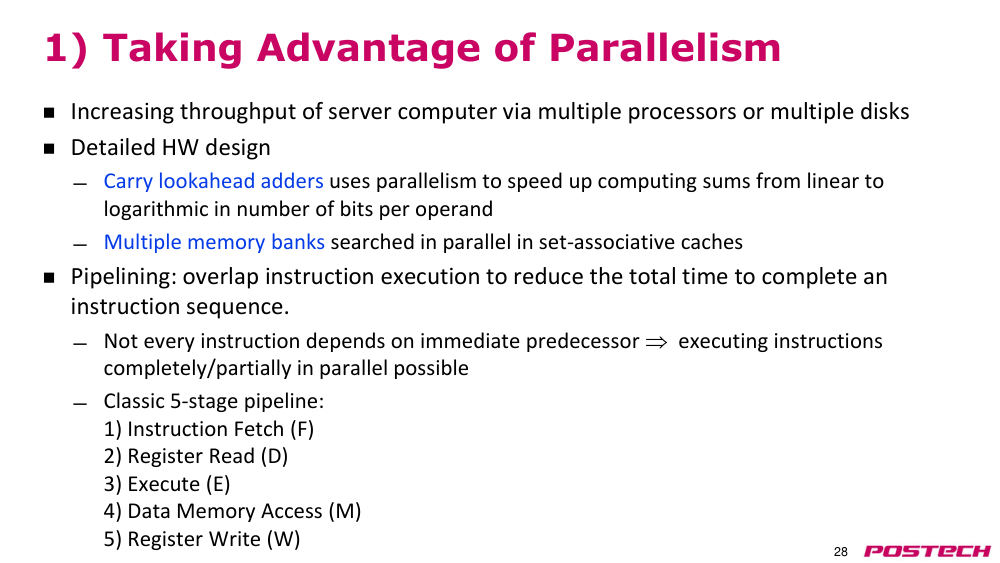
p.281) 병렬성 활용하기
- 다수의 프로세서 또는 다수의 디스크를 통해 서버 컴퓨터의 throughput(처리량) 증가
- 세부적인 하드웨어 설계
- carry lookahead adder(캐리 룩어헤드 어드더): 피연산자당 비트 수에 대해 선형에서 로그 수준으로 계산 속도 향상
- Set-Associative cache(세트 연관 캐시)에서 병렬적으로 검색되는 multiple memory banks(다수의 메모리 뱅크)
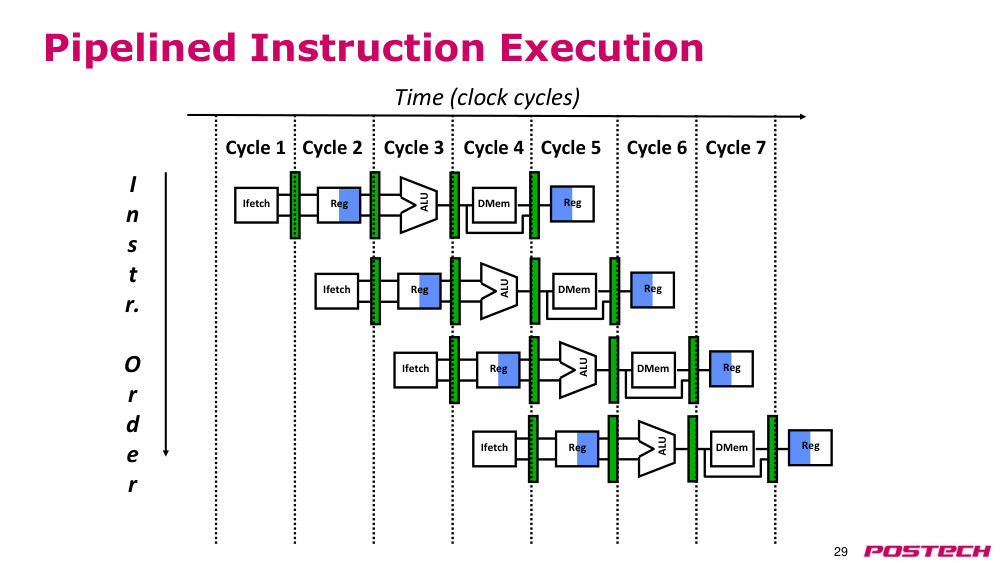
- pipelining(파이프라인): 명령어 execute (E)(실행)을 겹쳐서 명령어 시퀀스 완료에 소요되는 총 시간을 줄입니다.
- 모든 명령어가 즉각적인 이전 명령어에 의존하지 않음 → 명령어를 완전히/부분적으로 병렬로 execute (E)(실행) 가능
- 전형적인 5단계 pipelining(파이프라인):
- 1) 명령어 가져오기 (F)
- 2) 레지스터 읽기 (D)
- 3) 실행 (E)
- 4) 데이터 메모리 접근 (M)
- 5) 레지스터 쓰기 (W)
p.29pipelining(파이프라인) 명령어 execute (E)(실행)
p.30pipelining(파이프라인)의 한계
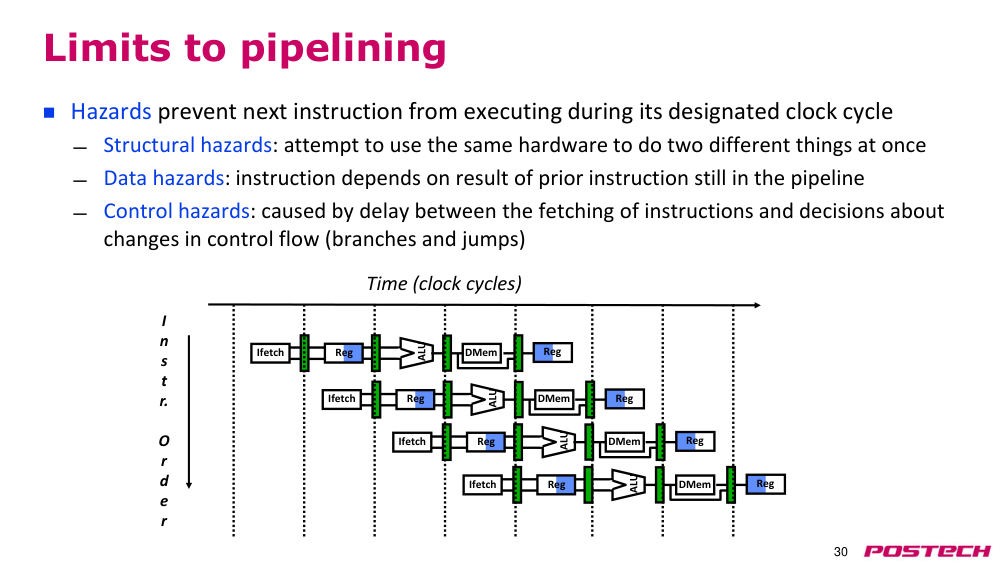
- 해저드는 다음 명령어가 지정된 clock cycle(클럭 사이클)에 execute (E)(실행)되지 못하게 합니다.
- structural hazards(구조적 해저드): 동시에 두 가지 다른 작업을 수행하기 위해 동일한 하드웨어를 사용하려는 시도
- data hazards(데이터 해저드): 명령어가 pipelining(파이프라인)에 아직 남아 있는 이전 명령어의 결과에 의존함
- control hazards(제어 해저드): instruction fetch (F)(명령어 가져오기)와 제어 흐름 변경 결정(브랜치 및 점프) 사이의 지연으로 인해 발생
p.31
p.32
p.33
p.34
p.35
p.36
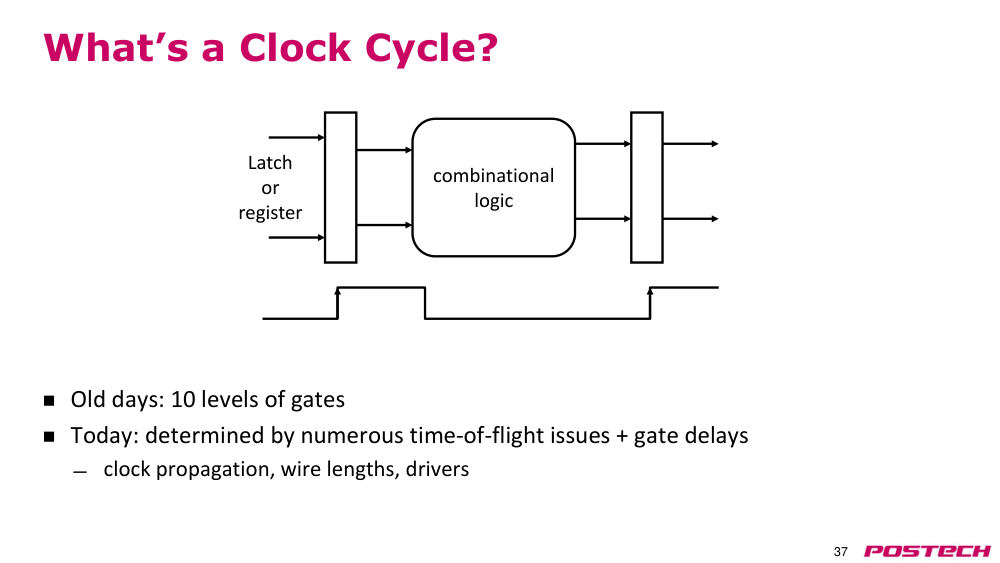
p.37clock cycle(클럭 사이클)이란?
- 옛날에는 게이트 10단계
- 오늘날은 수많은 time-of-flight(전파 시간) 문제 + 게이트 지연에 의해 결정됨
- 클럭 전파, 와이어 길이, 드라이버
p.38역사적 관점
p.39컴퓨터 아키텍처: 약간의 역사
- 수업 전반에 걸쳐 역사적 서사를 사용하여 특정 아이디어가 왜 등장했는지 이해하는 데 도움을 줄 것이다
- 오래된 아이디어에 신경 쓰는 이유:
- 디자인 과정을 설명하고 특정 결정이 왜 내려졌는지 이해하는 데 도움이 된다
- 미래 기술이 과거 기술처럼 제약을 받을 수 있기 때문이다
- 역사를 무시하는 자는 반복될 운명이다
- 메인프레임 설계에서 범한 모든 실수는 미니컴퓨터에서도 반복되었고, 그 다음에는 마이크로컴퓨터에서 어떻게 되었는가?
p.40아날로그 컴퓨터
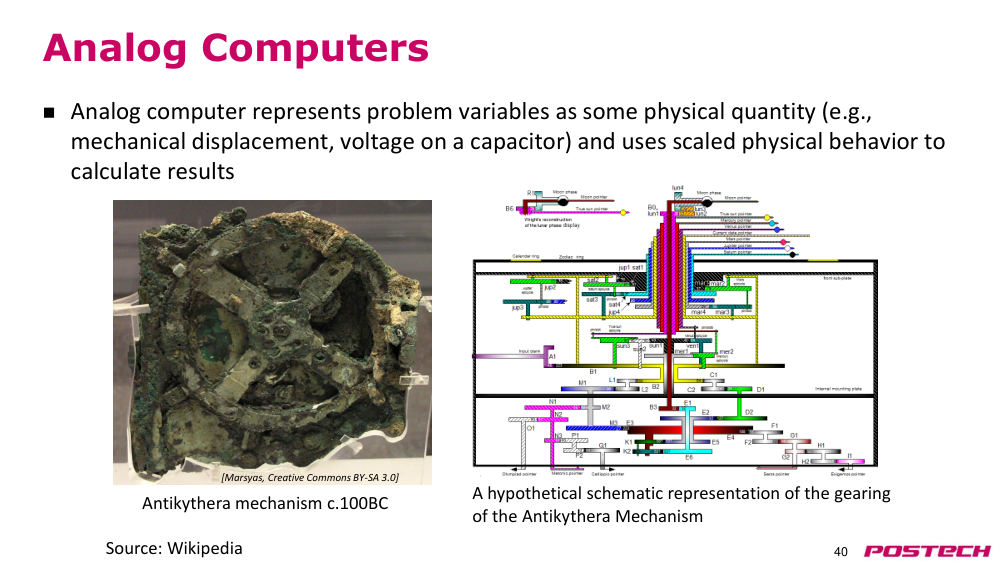
- 아날로그 컴퓨터는 문제 변수를 어떤 물리적 양(예: 기계적 변위, 커패시터의 전압)으로 표현하고, 스케일된 물리적 행동을 사용하여 결과를 계산한다
- [Marsyas, Creative Commons BY-SA 3.0]
- 기원전 100년경의 Antikythera mechanism
- Antikythera mechanism의 기어 구조에 대한 가정적 개략도
- 출처: Wikipedia
p.41디지털 컴퓨터
- 문제 변수를 이산 단계로 인코딩된 숫자로 표현한다
- 이산 단계는 노이즈에 대한 면역성을 제공한다
- 정확하고 결정론적인 계산이 가능하다
- 같은 입력은 정확히 같은 출력을 낸다
- 물리적으로 실현 가능한 함수에 제약을 받지 않는다
- 이 수업의 초점은 프로그래머블 디지털 컴퓨터이다
p.42Charles Babbage (1791-1871)
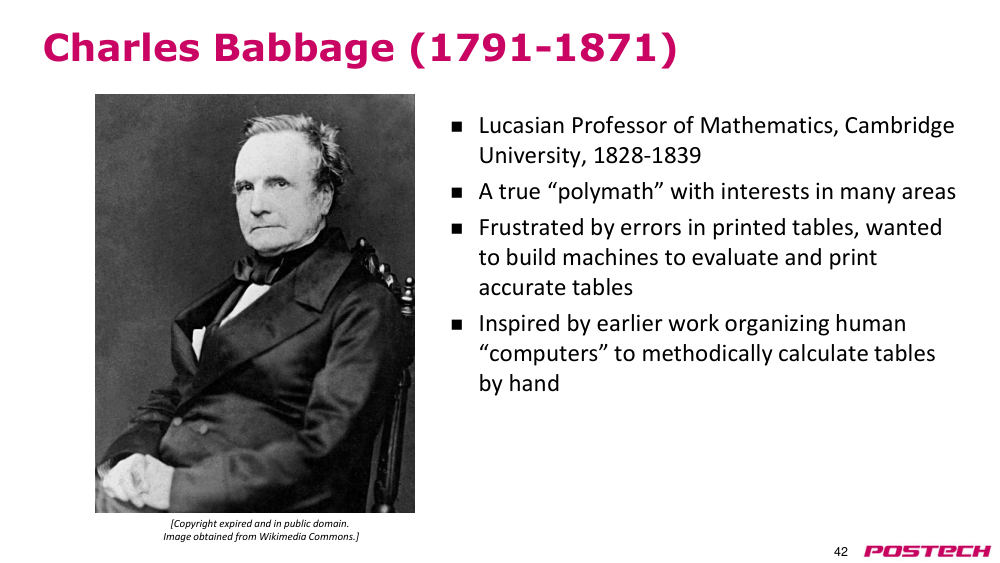
- 케임브리지 대학교 수학과 루카시안 교수, 1828-1839
- 다양한 분야에 관심을 가진 진정한 '다재다능한 인재'
- 인쇄된 표에서의 오류에 실망하여 정확한 표를 계산하고 인쇄할 수 있는 기계를 만들고 싶어 했다
- 이전에 인간 '컴퓨터'들을 조직하여 손으로 체계적으로 표를 계산한 일에 영감을 받았다
- [저작권 만료 및 공공 영역. 이미지 출처: 위키미디어 커먼즈]
p.43Difference Engine의 구현
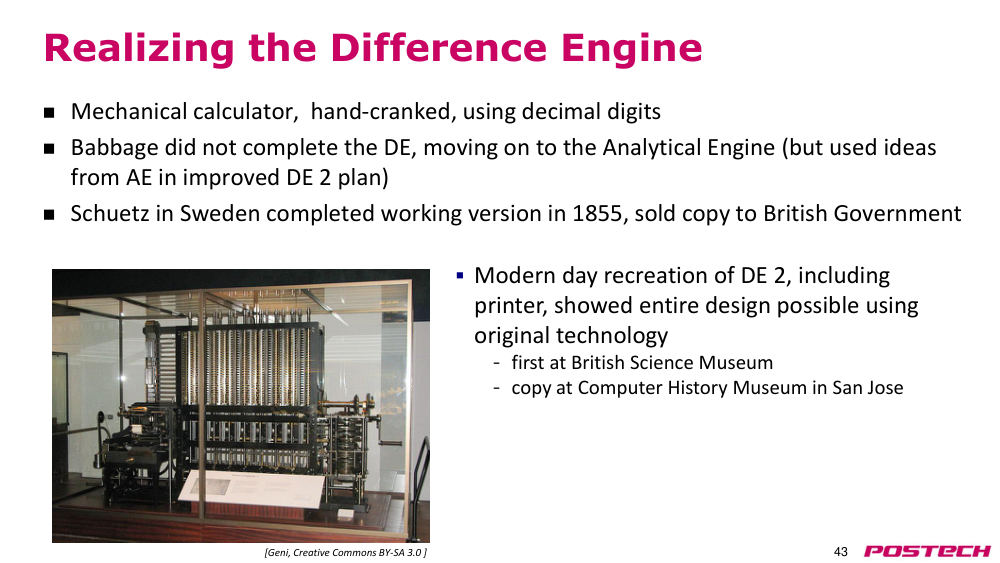
- 기계식 계산기, 수동 크랭크 방식, 십진수 자릿수 사용
- Babbage는 Difference Engine을 완성하지 못했으며, Analytical Engine으로 이동함 (그러나 개선된 DE 2 계획에서 Analytical Engine의 아이디어를 활용함)
- 스웨덴의 Schuetz가 1855년에 작동 가능한 버전을 완성하고 British Government에 판매함
- 현대의 DE 2 재현본(프린터 포함)은 원래 기술로 전체 설계가 가능함을 보여줌
- British Science Museum에서 최초로 전시됨
- Computer History Museum in San Jose에 복제본 있음
- [Geni, Creative Commons BY-SA 3.0]
p.44Analytical Engine 1837
- 현대 컴퓨터의 주요 구성 요소를 포함한 최초의 일반 목적 디지털 컴퓨터로 인정됨
- 다수의 설계 반복(여러 Analytical Engine)
- 현대 컴퓨터의 주요 구성 요소 포함:
- ‘스토어’: 숫자와 중간 결과를 저장하는 주기억장치 (1,000개의 십진 단어, 각각 40자리)
- ‘밀’: 덧셈, 곱셈, 나눗셈을 포함한 연산을 수행하는 산술 단위
- 조건부 분기 및 루프, 오버플로우 시 예외 처리(기계 정지 및 벨 소리) 지원
- ‘배럴’이라는 형태의 마이크로코드 존재
- 프로그래밍, 입력 및 출력 데이터는 펀치 카드에 기록됨
- 명령어 카드는 연산 코드와 스토어 내 피연산자 주소를 포함함
- 두 개의 소스와 하나의 목적지 모두 스토어 내에 있는 3주소 형식
- 분기는 기계적으로 카드 순서를 변경하여 구현됨
- 작은 부분만 실제로 제작됨
p.45Analytical Engine 설계 선택 사항
- 십진수 사용, 기계식 기어를 이용한 저장 방식 때문임
- Babbage는 이진수 및 기타 진법을 고려했으나, 인간 친화적인 십진수에 비해 명확한 이점 없음
- 40자리 정밀도 (133비트 이상과 동등)
- 부동소수점 하드웨어 부족으로 인한 스케일링 영향 최소화 목적
- 기계적 운동 전달 시 노이즈를 극복하기 위해 ‘잠금’ 또는 기계적 증폭 사용
- 디지털 전자 회로의 비선형 이득과 유사
- 빠른 ‘예측형’ 캐리 제공
- CMOS 어드더에서 사용되는 패스 트랜지스터 캐리 전파의 기계적 버전이며, 이전 릴레이 어드더에서도 사용됨
p.46초기 프로그래머블 계산기
- 20세기 전반기에는 디지털 계산이 너무 비싸기 때문에 아날로그 계산이 인기 있음
- 그러나 1930년대 후반과 1940년대에는 여러 프로그래머블 디지털 계산기가 제작됨 (작동 가능 시점):
- Atanasoff Linear Equation Solver (1939)
- Zuse Z3 (1941)
- Harvard Mark I (1944)
- ENIAC (1946)
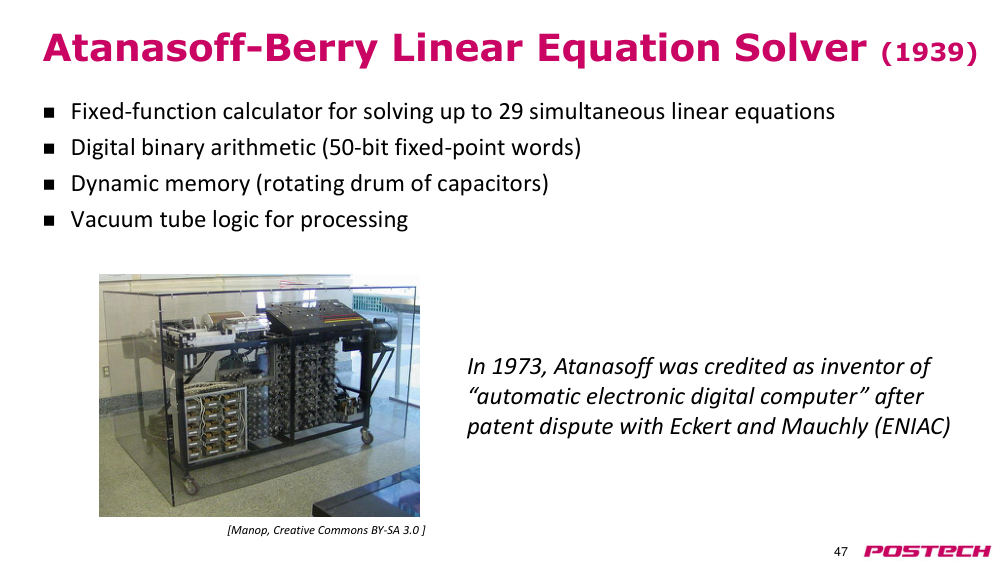
p.47Atanasoff-Berry Linear Equation Solver (1939)
- 최대 29개의 연립 선형 방정식을 풀기 위한 고정 기능 계산기
- 디지털 이진수 산술 (50비트 고정 소수점 단어)
- 동적 메모리 (커패시터로 구성된 회전 드럼)
- 처리를 위한 진공관 논리 회로
- [Manop, Creative Commons BY-SA 3.0]
- 1973년, Atanasoff는 Eckert와 Mauchly(ENIAC)와의 특허 분쟁 이후 ‘자동 전자 디지털 컴퓨터의 발명자’로 인정받음
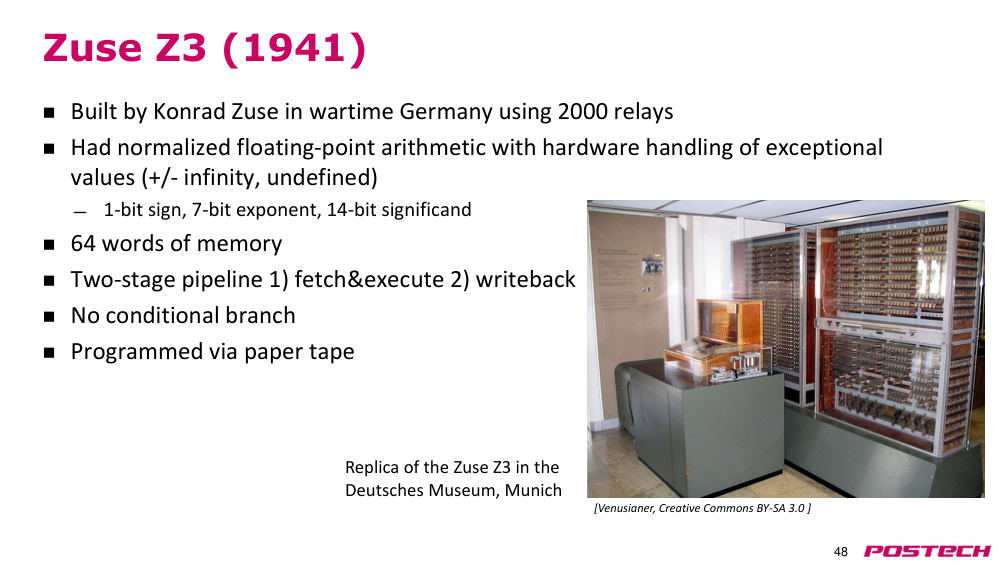
p.48Zuse Z3 (1941)
- wartime Germany에서 Konrad Zuse가 2,000개의 릴레이를 사용해 제작함
- 예외 값(+/- 무한대, 정의되지 않음)을 하드웨어로 처리하는 정규화된 부동소수점 산술 지원
- 1비트 부호, 7비트 지수, 14비트 significand(가수)
- 64단어의 메모리
- 이단계 pipelining(파이프라인): 1) instruction fetch (F)(명령어 가져오기) 및 execute (E)(실행), 2) writeback(레지스터 쓰기)
- 조건부 분기 없음
- 종이 테이프를 통해 프로그래밍됨
- Deutsches Museum, Munich에 있는 Zuse Z3의 복제본
- [Venusianer, Creative Commons BY-SA 3.0]
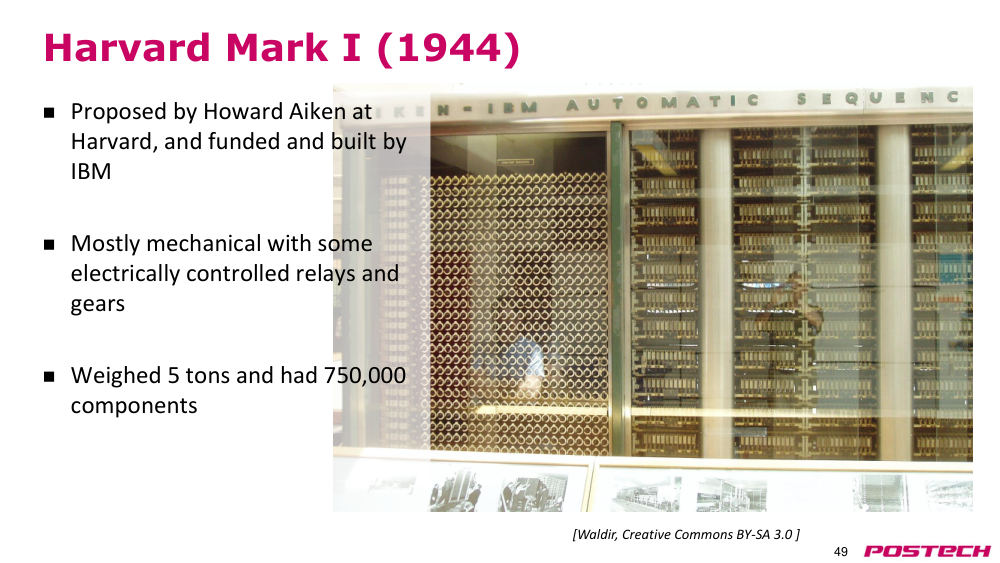
p.49Harvard Mark I (1944)
- Harvard의 Howard Aiken이 제안하고, IBM가 자금 지원 및 제작
- 주로 기계적 구성 요소로 이루어졌으며, 전기적으로 제어되는 리레이와 기어를 일부 사용
- 무게는 5톤이며, 총 75만 개의 부품을 포함
p.50Harvard Mark I (1944), 이어짐
- 각각 23자리 십진수를 72개 저장 가능
- 속도: 덧셈 0.3초, 곱셈 6초, 나눗셈 15초, 삼각함수 계산 1분 이상
- instructions(명령어)은 종이 테이프에 기록됨 (2주소 형식)
- 긴 프로그램을 자동으로 execute (E)(실행) 가능
- 루프는 종이 테이프를 연결하여 만듦
- 조건부 분기 없음
- 제안서에서 Babbage에 언급되었지만, Analytical Engine보다 제한적임
p.51ENIAC (1946)
- 최초의 전자식 일반 목적 컴퓨터
- 제2차 세계대전 중 미국 육군의 사격표 계산을 위해, University of Pennsylvania Moore School of Electrical Engineering에서 기밀로 건설됨. Eckert와 Mauchly가 설계
- 17,468개의 진공관 사용
- 무게 30톤, 공간 1800제곱피트 (~50평), 전력 소비 150kW
- 12개의 10자리 십진수 누산기
- 조건부 분기 기능 보유!
- 프로그램은 플러그보드와 스위치로 설정하며, 매우 시간 소모적임
- 순전히 전자식 instruction fetch (F)(명령어 가져오기) 및 execute (E)(실행)으로 인해 매우 빠름 — 10자리 × 10자리 곱셈 2.8ms (Mark-1보다 약 2,000배 빠름)
- 속도의 결과로 I/O-bound(I/O 바운드) 상태였음
- 진공관 수가 많아 자주 고장남 (고장 간 최장 기간 5일)
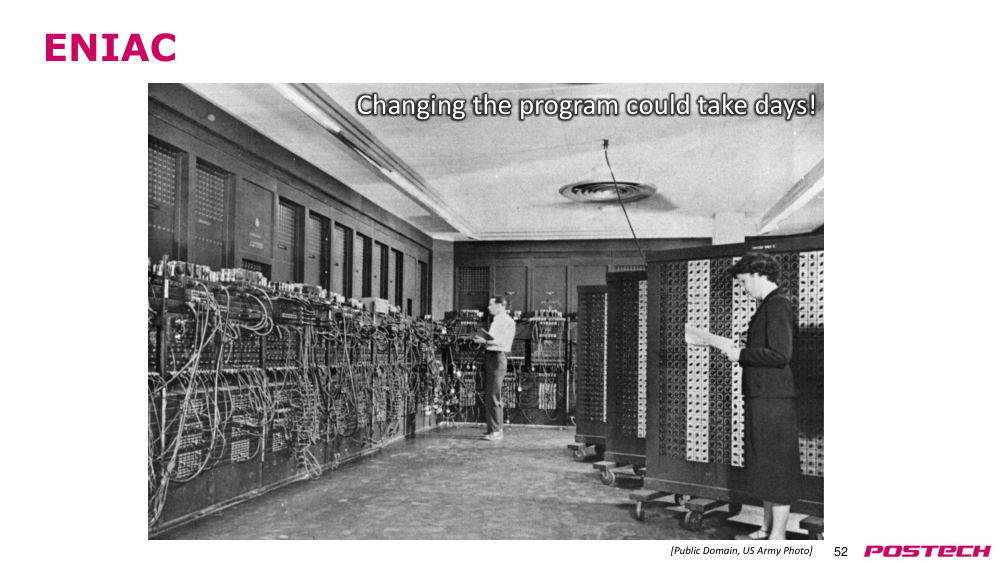
p.52ENIAC
- 프로그램 변경에 며칠이 걸릴 수 있음!
p.53EDVAC
- ENIAC 팀은 프로그래밍 속도 향상과 기계 설계 단순화를 위해 저장 프로그램 개념을 논의하기 시작
- John von Neumann은 University of Pennsylvania에서 자문을 맡았으며, 'First Draft of a Report on the EDVAC'에 아이디어를 정리
- Herman Goldstine은 1945년 6월에 초안을 여러 기관에 배포하여 저장 프로그램 개념에 대한 관심을 불러일으킴
- 그러나 이로 인해 특허화 기회가 사라짐
- 보고서는 아이디어를 폰 노이만에게 독점적으로 기여한 것으로 잘못 기재
- Maurice Wilkes는 보고서에 감명받아 미국에서 컴퓨터 구축 워크숍에 참석하기로 결정
- 후에 1948년 ENIAC에 저장 프로그램 모드 실행을 위한 수정이 이루어졌으나, hardwired(하드와이어드) 방식보다 6배 느림
- I/O 제약으로 인해 속도 저하가 실질적인 영향을 미치지 않았으며, 생산성 향상이 보상이 됨
- EDVAC는 결국 1951년에 건설되었고, 대부분 작동 가능해짐
- 대학 간 특허 분쟁으로 인해 지연됨
p.54지연선 메모리
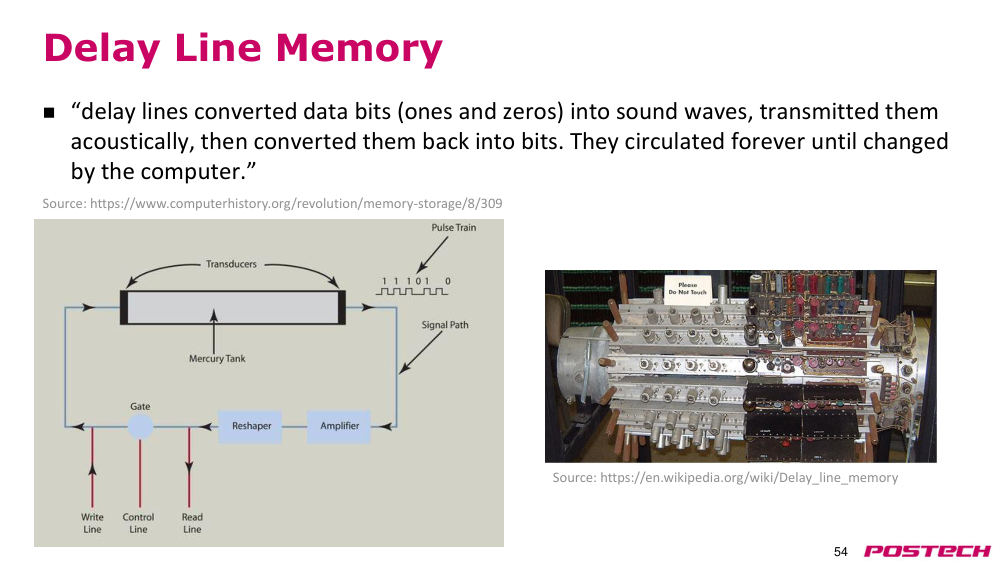
- '지연선은 데이터 비트(1과 0)를 음파로 변환하여 음향적으로 전송한 후 다시 비트로 변환한다. 컴퓨터에 의해 변경되지 않는 한 영원히 순환된다.'
- 출처: https://en.wikipedia.org/wiki/Delay_line_memory
- 출처: https://www.computerhistory.org/revolution/memory-storage/8/309
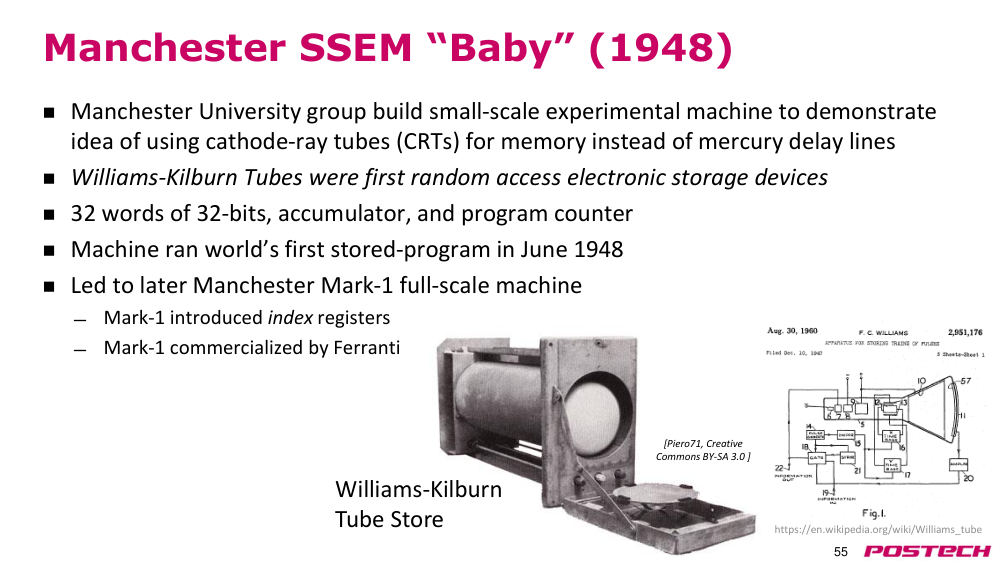
p.55Williams-Kilburn Tube Store
- Manchester University 그룹은 cathode-ray tube(CRT)(음극선관)을 메모리로 사용하는 아이디어를 실험적으로 증명하기 위해 소규모 실험용 기계를 구축했다.
- Williams-Kilburn Tubes는 처음으로 임의 접근이 가능한 전자식 저장 장치였다.
- 32개의 32비트 단어, 누산기, 프로그램 카운터를 포함했다.
- 이 기계는 1948년 6월에 세계 최초의 stored-program(저장 프로그램)을 execute (E)(실행)했다.
- 이후 Manchester Mark-1(full-scale machine)으로 이어졌다.
- Mark-1은 인덱스 레지스터를 도입했으며, Ferranti에 의해 상용화되었다.
p.56Cambridge EDSAC (1949)
- Maurice Wilkes는 미국의 워크숍에서 돌아온 후 Cambridge에서 저장 프로그램 컴퓨터를 구축하기 시작했다.
- EDSAC는 수은 지연선 저장장치를 사용하여 최대 1024개의 단어(초기에는 512개)를 17비트로 저장할 수 있었다(지연선 내에서 1비트의 패딩 포함).
- 2의 보수 이진 산술을 사용했다.
- 누산기 명령어 집합 아키텍처(ISA)를 사용하며, 인덱싱을 위해 자가 수정 코드를 사용했다.
- 세계 최초의 컴퓨터 과학 박사 학위를 받은 David Wheeler는 이 기계를 위해 서브루틴("Wheeler jump")을 발명했다.
- 사용자들은 유용한 서브루틴의 대규모 라이브러리를 구축했다.
- 영국 최초의 상용 컴퓨터인 LEO-I(Lyons Electronic Office)는 EDSAC를 기반으로 하였으며, 1951년에 비즈니스 소프트웨어를 실행했다.
- LEO용 소프트웨어는 1980년대까지 ICL 메인프레임에서 에뮬레이션을 통해 여전히 작동했다!
- EDSAC-II(1958)는 마이크로프로그래밍된 제어 유닛을 가진 최초의 기계였다.
p.57상용 컴퓨터: BINAC (1949) 및 UNIVAC (1951)
- Eckert와 Mauchly는 특허권 분쟁 후 University of Pennsylvania을 떠나 Eckert-Mauchly Computer Corporation를 설립했다.
- 세계 최초의 상용 컴퓨터는 두 개의 CPU를 갖춘 BINAC로, 서로를 검증하도록 설계되었다.
- BINAC는 첫 번째(유일한) 고객에게 배송된 후 작동하지 않았다.
- 두 번째 상용 컴퓨터는 UNIVAC였다.
- 수은 지연선 메모리를 사용하여 1000개의 12개의 알파 문자를 저장할 수 있었다.
- 1952년 대통령 선거 예측에 유명하게 사용되었다.
- 최종적으로 46대가 각각 100만 달러 이상에 판매되었다.
- 종종 IBM UNIVAC이라고 잘못 불린다.
p.58IBM 701 (1952)
- IBM의 첫 번째 상용 과학 계산용 컴퓨터이다.
- 주 메모리는 72개의 Williams Tubes로 구성되어 있으며, 각각 1Kib, 총 2048개의 36비트 단어를 저장할 수 있었다.
- 메모리 사이클 시간은 12µs였다.
- 누산기 명령어 집합 아키텍처(ISA)를 사용하며, 곱셈/나눗셈 레지스터를 포함했다.
- 부호-크기 고정소수점으로 18비트/36비트 수를 사용했다.
- Thomas Watson Sr/Jr의 잘못된 인용: "나는 세계적으로 다섯 대 정도의 컴퓨터가 시장이 있을 것이라고 생각한다."
- 실제로 TWJr는 주주 회의에서 말했다: "701 판매 여행에서 우리는 다섯 대 정도의 주문을 기대했지만, 실제로 18대의 주문을 받아 왔다."
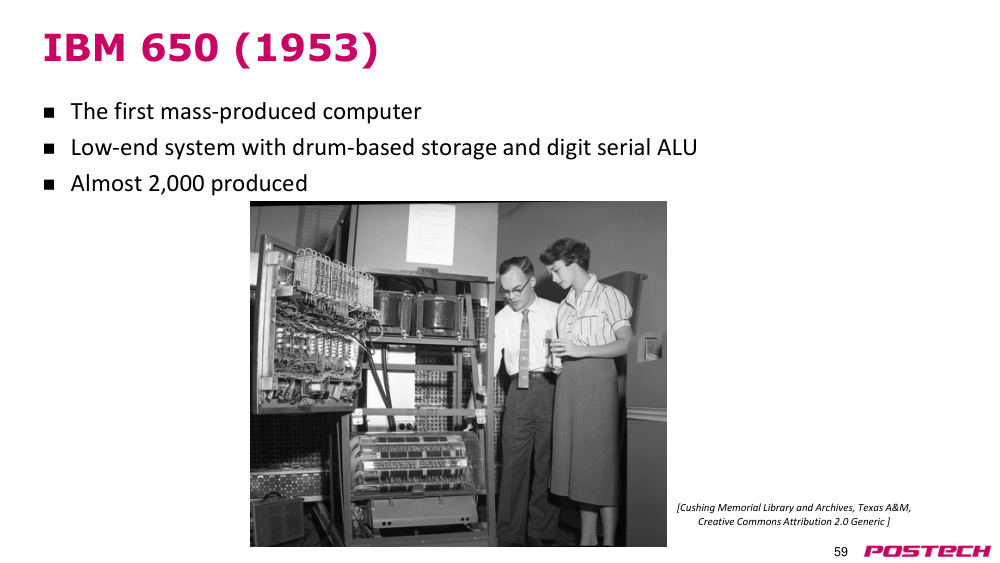
p.59IBM 650 (1953)
- 최초의 대량 생산된 컴퓨터이다.
- 드럼 기반 저장장치와 디지트 시리얼 ALU를 갖춘 저가형 시스템이다.
- 거의 2,000대가 생산되었다.
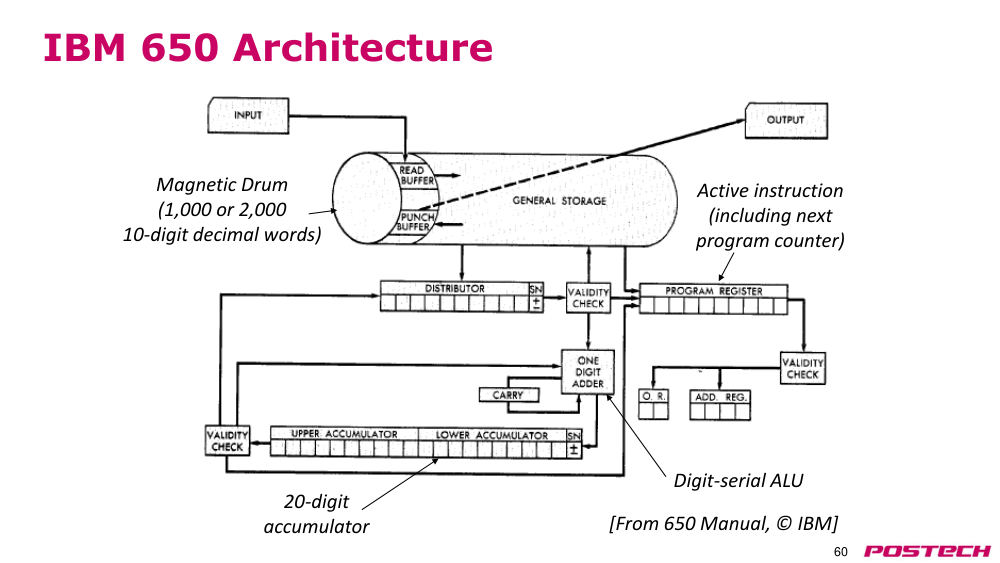
p.60IBM 650 아키텍처
- 자기 드럼 (1,000 또는 2,000개의 10자리 십진 단어)
- 20자리 누산기
- 활성 명령어 (다음 프로그램 카운터 포함)
- 디지트 시리얼 ALU
p.61IBM 650 명령어 집합
- 10자리 십진 단어로 주소와 데이터를 표현
- 명령어는 다음을 인코딩함:
- 2자리 오퍼코드: 기본 명령어 집합에서 44개의 명령어를 표현하며, 옵션을 통해 최대 97개로 확장 가능
- 4자리 데이터 주소
- 4자리 다음 명령어 주소
- 프로그래머는 드럼 latency(지연 시간)을 최소화하도록 코드를 배열해야 함!
- 트랙에 있는 모든 단어와 값을 비교하기 위한 특수 명령어 추가
p.62초기 명령어 집합
- 매우 단순한 명령어 집합 아키텍처(ISA), 주로 단일 주소 누산기 스타일의 기계로, 고속 회로가 비싸기 때문
- 이전의 '계산기' 모델을 기반으로 함
- 시간이 지남에 따라 소프트웨어의 필요성에 대한 인식이 ISA를 형성하게 됨
- 배열을 순회하기 위해 자가 수정 코드를 피하기 위해 인덱스 레지스터(Kilburn, Mark-1) 추가
- 시간이 지남에 따라 더 많은 인덱스 레지스터가 추가됨
- 인덱스 레지스터에 대한 더 많은 연산이 추가됨
- 결국 일반 목적 레지스터(GPR)와 orthogonal instruction set(직교 명령어 집합)을 제공하게 됨
- 그러나 다른 옵션들도 탐색됨...
p.63Burrough’s B5000 Stack Architecture: Robert Barton, 1960
- 고급 언어(ALGOL)를 사용하여 프로그래머에게 명령어 집합을 완전히 숨김
- 스택 아키텍처를 사용하여 컴파일, 표현식 평가, 재귀 서브루틴 호출, 인터럽트 처리 등을 간단히 함
p.64표현식 평가
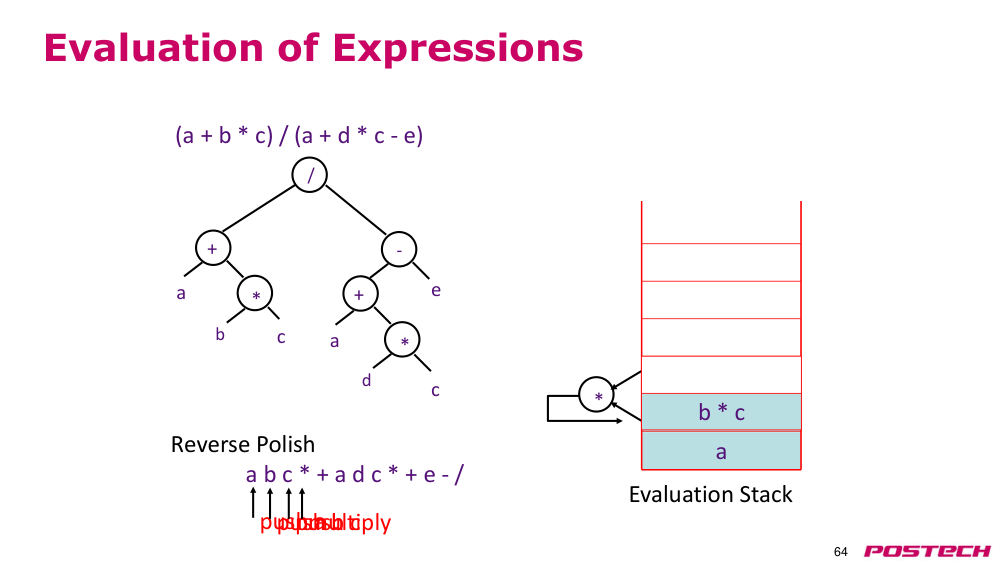
- 표현식: (a + b * c) / (a + d * c - e)
- Reverse Polish(역폴란드 표기법): a b c * + a d c * + e - /
- 평가 스택:
- push a
- push b
- push c
- multiply (*)
- b * c 평가됨
p.65표현식 평가
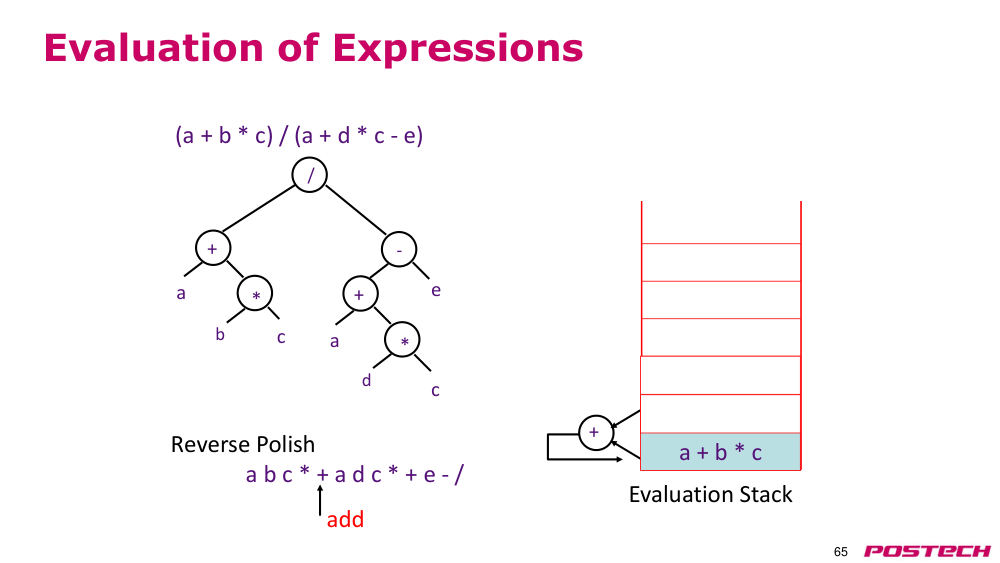
- 표현식: (a + b * c) / (a + d * c - e)
- Reverse Polish(역폴란드 표기법): a b c * + a d c * + e - /
- 평가 스택:
- b * c 평가됨
- add (+)
- a + b * c 평가됨
p.66IBM의 큰 도전: 360 아키텍처
- 1960년대 초, IBM는 서로 호환되지 않는 여러 컴퓨터 계열을 보유함:
- 701 → 7094
- 650 → 7074
- 702 → 7080
- 1401 → 7010
- 각 시스템은 고유한 특징을 가짐:
- 명령어 집합
- I/O 시스템 및 보조 저장장치(자기 테이프, 드럼, 디스크)
- 어셈블러, 컴파일러, 라이브러리 등
- 시장 니치(비즈니스, 과학, 실시간 등)
p.67IBM 360: 설계 전제
- Amdahl, Blaauw 및 Brooks, 1964
- 설계는 성장 가능성과 후속 기계에 적합해야 한다.
- I/O 장치를 연결하는 일반적인 방법이 필요하다.
- 전체 성능은 마이크로초당 비트 수가 아니라 월간 처리량(문제 해결 수)을 기준으로 한다 → 프로그래밍 보조 도구
- 기계는 수동 개입 없이 스스로 감시할 수 있어야 한다.
- 하드웨어 장애 검사 및 위치 확인 도구를 내장하여 다운타임을 줄인다.
- 장애 내성 위해 중복된 I/O 장치, 메모리 등을 간단히 조립할 수 있는 시스템 설계.
- 일부 문제는 36비트보다 큰 부동소수점 연산이 필요하다.
p.68IBM 360: 일반 목적 레지스터(GPR) 기계
- 프로세서 상태
- 16개의 일반 목적 32비트 레지스터
- • 인덱스 및 베이스 레지스터로 사용 가능
- • 레지스터 0는 일부 특수한 성질을 가짐
- 4개의 부동소수점 64비트 레지스터
- 프로그램 상태 워드(PSW)
- • PC, 조건 코드, 제어 플래그
- 32비트 기계이며 주소는 24비트
- 데이터 형식
- 8-bit byte(바이트), 16-bit half word(하프 워드), 32-bit word(워드), 64-bit double word(더블 워드)
- IBM 360이 오늘날 바이트가 8비트인 이유이다!
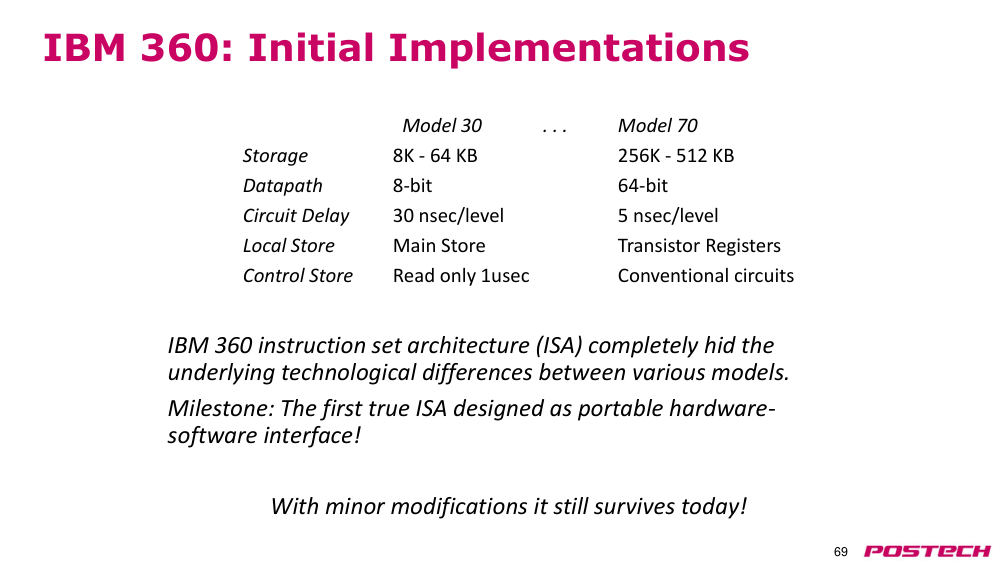
p.69IBM 360: 초기 구현
- 모델 30
- …
- 모델 70
- 저장장치
- 8K - 64 KB
- 256K - 512 KB
- 데이터 경로
- 8비트
- 64비트
- 회로 지연
- 30 nsec/레벨
- 5 nsec/레벨
- 로컬 스토어
- 메인 스토어
- 트랜지스터 레지스터
- 컨트롤 스토어
- 읽기 전용 1usec
- 기본 회로
- IBM 360 명령어 집합 아키텍처(ISA)는 다양한 모델 간 기술적 차이를 완전히 숨겼다.
- 기념비적 성과: 처음으로 이식 가능한 하드웨어-소프트웨어 인터페이스로 설계된 진정한 ISA!
- 소량의 수정만으로 오늘날까지도 여전히 존재한다!
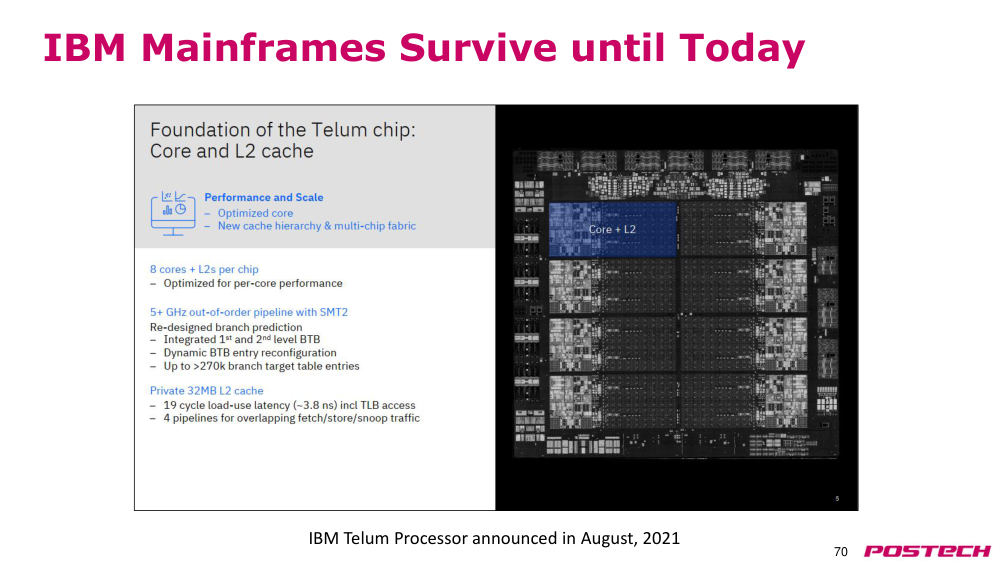
p.70IBM 메인프레임은 오늘날까지 지속되고 있다
- 2021년 8월, IBM Telum 프로세서 발표
p.71결론적으로…
- 컴퓨터 아키텍처 >> ISAs 및 RTL
- 이 과목은 하드웨어와 소프트웨어의 상호작용 및 적절한 추상화 계층 설계에 관한 것이다.
- 컴퓨터 아키텍처는 기술과 응용에 의해 형성된다.
- 역사는 미래를 위한 교훈을 제공한다.
p.72질문?
- CSED311 슬라이드에서 RISC-V ISA를 복습하세요 (PLMS에 제공될 예정)
- 읽기 자료:
- 교재 1장 및 부록 A 읽기
- 모든 부록은 여기에서도 제공됨
- 아래 링크에서 2017년 ACM A.M. 튜링상 수상 강연을 시청하세요:
- https://www.youtube.com/watch?v=3LVeEjsn8Ts