Lec 4 part2 · Lec 5 · 성능 요약(평균·SPEC)과 single-cycle CPU datapath
정밀 정리 · 검증 2026-09-24 14:46
1개요
1.1전반부(Lec4 part2): Amdahl's law 복습 후 성능 요약 metric — 양은 arithmetic mean, 비율은 geometric mean, rate 는 harmonic mean.
1.2SPEC benchmark 로 공통 비교 기준을 두고, 측정·요약 방법을 밝혀 재현 가능하게 한다.
1.3후반부(Lec5): CPU 를 instruction processing FSM 으로 보고 programmer visible state·5단계(IF/ID/EX/MEM/WB)를 정리.
1.4R-type → I-type(imm + mux) → load(주소 계산, write data mux) → store(rs2 → write data, RegWrite 제어) 순으로 single-cycle datapath 를 쌓는다. control flow 는 다음 강의.
2섹션별 정리 상황·문제 → 원인 → 해결
2.11:00–2:02세미나 안내 (행정)
상황·문제다음 날 오후 4시 NVIDIA SuInn Park 세미나(CSE/GSAI 세미나 시리즈): DNN 알고리즘·software stack, 자율주행용 GPU·accelerator 언급 예정. 참석 권장.
2.22:02–4:44Amdahl's law(암달의 법칙) 복습
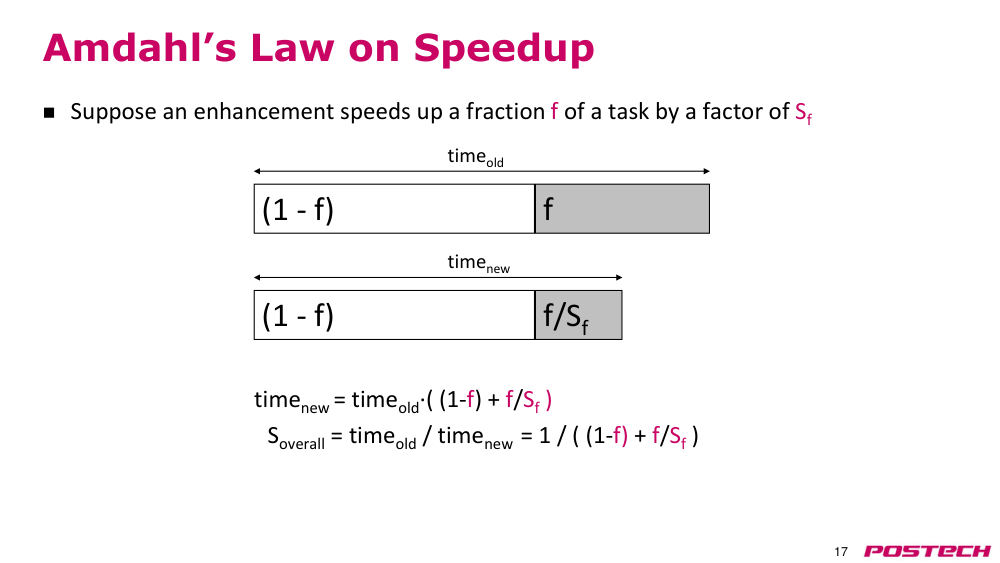
상황·문제여러 system 의 성능을 측정·비교하고 개선하려 할 때, 일부만 빨라지면 전체는 얼마나 빨라지는가?
원인전체 시간 = 변하지 않는 (1-f) + 빨라지는 f. f 부분만 Sf 배 줄어 f/Sf 가 된다.
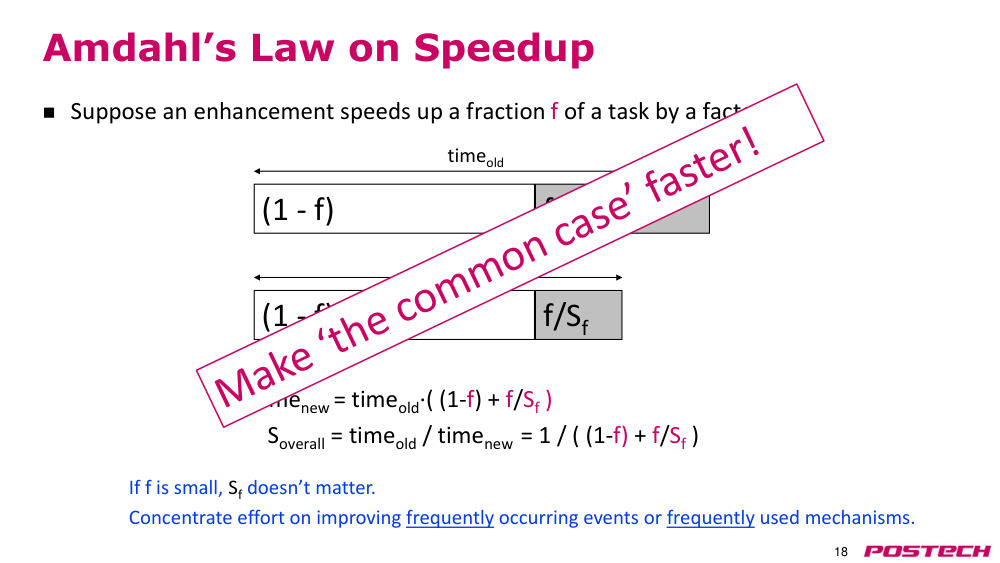
해결time_new = time_old·((1-f) + f/Sf), speedup = 1/((1-f)+f/Sf). common case 에 집중해야 한다.
- f 가 작으면 Sf 를 아무리 키워도 전체 speedup 은 작다
- 'Make the common case faster!'
2.34:44–7:42성능 요약의 문제: application 마다 다른 speedup
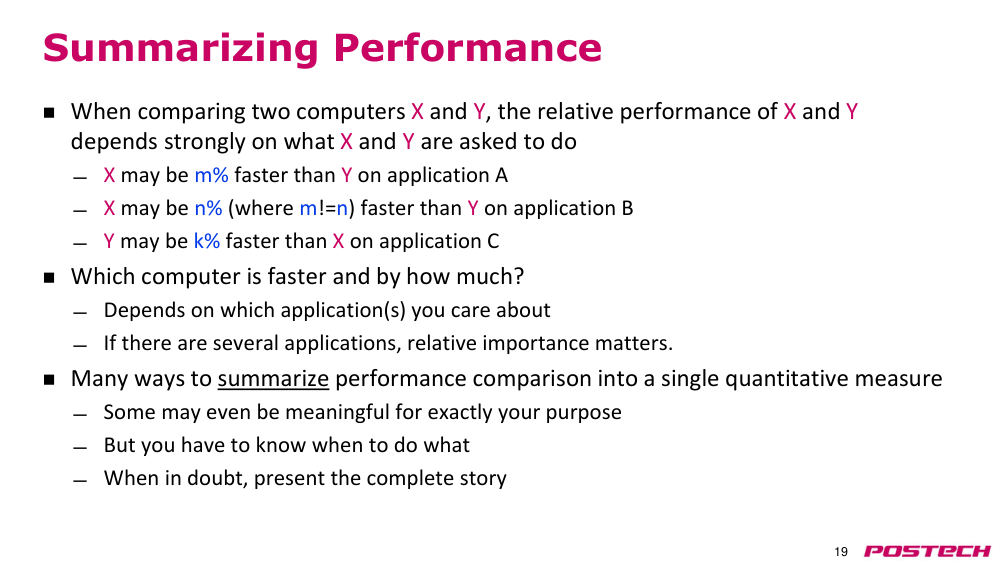
상황·문제X 가 game 에서 m%, web browser 에서 n% 빠르고 spreadsheet 에서는 Y 가 k% 빠르면 어느 쪽이 빠른가?
원인비교 결과는 어떤 application 이 중요한지에 달려 있다.
해결실제 사용 패턴에 맞는 metric 을 고르고, 여러 application 이면 relative importance 를 반영한다.
- gaming 위주 사용자라면 gaming 의 비중을 반영
- metric 마다 함의가 다르다
2.47:42–13:38arithmetic mean(산술 평균)과 weighted arithmetic mean
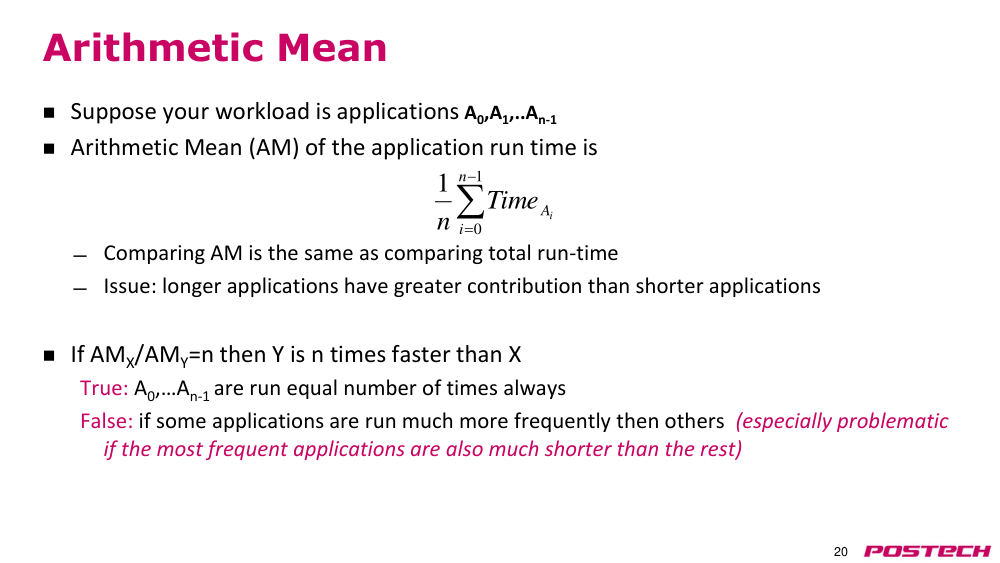
상황·문제execution time 을 단순 평균해 두 system 을 비교하면 무엇이 문제인가?
원인AM 비율 = 총 execution time 비율이라 긴 application(예 10분)이 평균을 지배하고 짧은 것(1초)의 개선은 거의 반영되지 않는다.
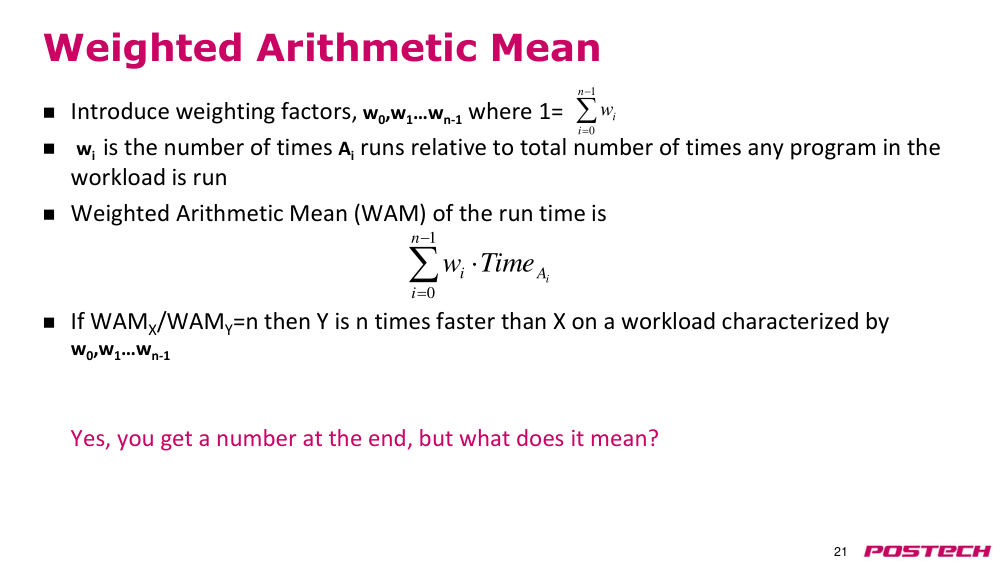
해결모든 application 이 같은 횟수로 실행될 때만 AM 이 적절. 아니면 합이 1 인 weight w_i 로 weighted AM 을 쓰고 weight 를 정당화한다.
- AM_X/AM_Y 에서 1/n 이 약분되어 총 시간 비교와 같다
- WAM_X/WAM_Y = n → 그 workload 에서 Y 가 n배 빠름
2.513:38–22:36geometric mean(기하 평균)과 normalization 예제
상황·문제application 별 speedup(비율)을 하나로 요약할 때 비율의 arithmetic mean 을 써도 되는가?
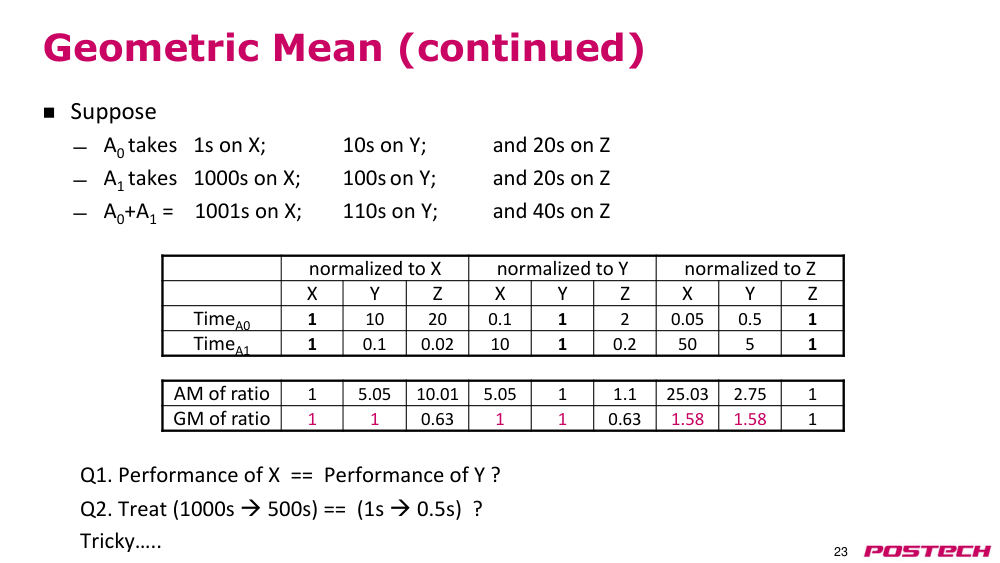
원인비율의 AM 은 기준 system 에 따라 결과가 뒤집힌다: X 기준이면 Y 가 약 5배 느리고(5.05), Y 기준이면 Y 가 5배 빠르다.
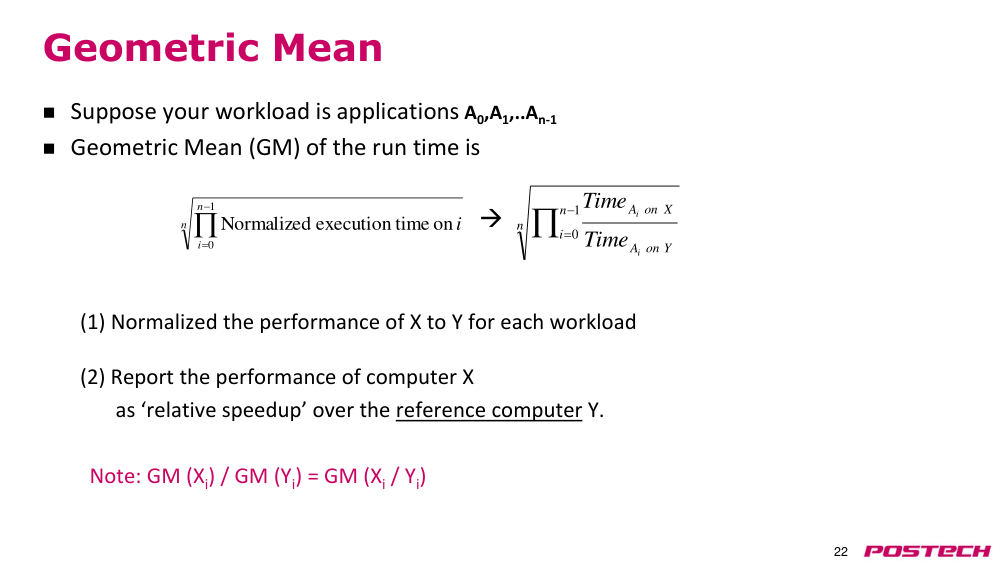
해결비율 요약에는 geometric mean: 어느 system 으로 normalize 해도 X:Y:Z = 1:1:0.63 비율이 유지된다.
- 예: A0 = X 1 s, Y 10 s, Z 20 s / A1 = X 1000 s, Y 100 s, Z 20 s
- GM(X_i)/GM(Y_i) = GM(X_i/Y_i)
- 주의: GM 은 1000→500 s 와 1→0.5 s 개선을 같게 본다. 실제 중요도와 맞는지 따져야 한다
- 슬라이드 식의 X·reference Y 위치 오기를 강의 중 정정
2.622:36–28:31harmonic mean(조화 평균)과 IPC 평균, 핵심 요약
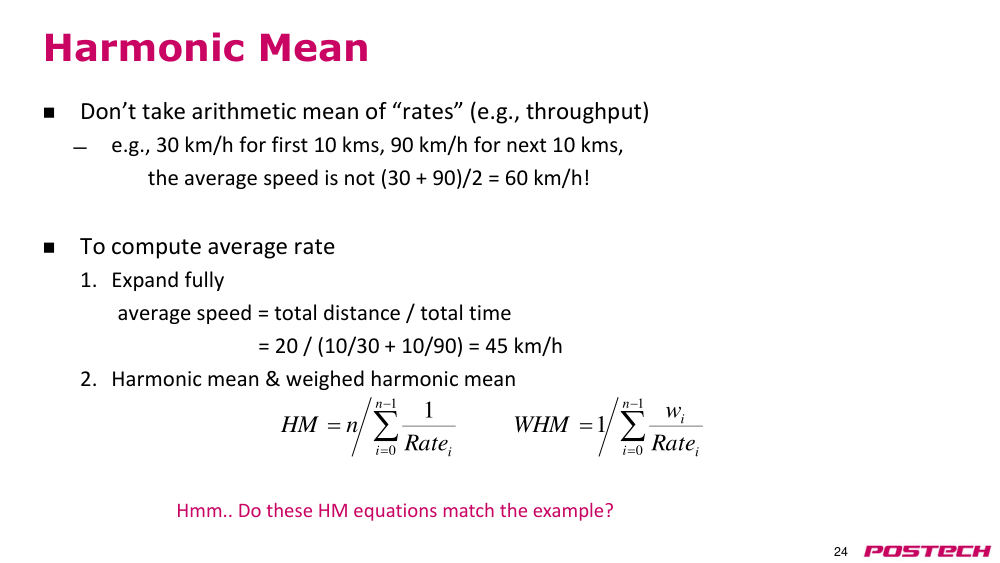
상황·문제속도나 IPC 같은 rate 를 평균할 때는 무엇을 써야 하나?
원인30 km/h 로 10 km, 90 km/h 로 10 km 달리면 AM 은 60 km/h 지만 실제 평균 속도는 총 거리/총 시간 = 45 km/h.
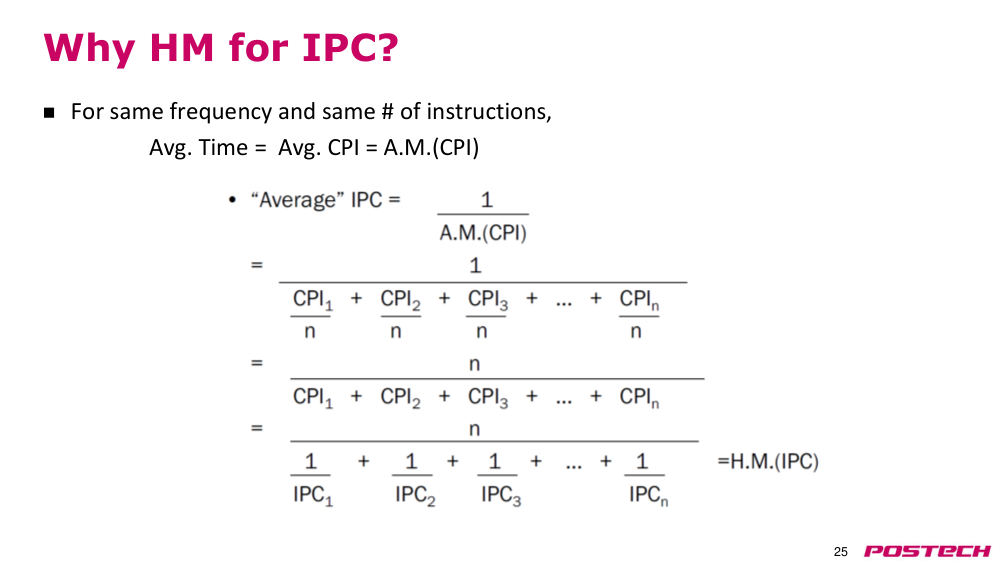
해결rate 는 harmonic mean(필요하면 weighted HM). CPI 는 시간이라 AM, 평균 IPC = 1/AM(CPI) = IPC 의 HM.
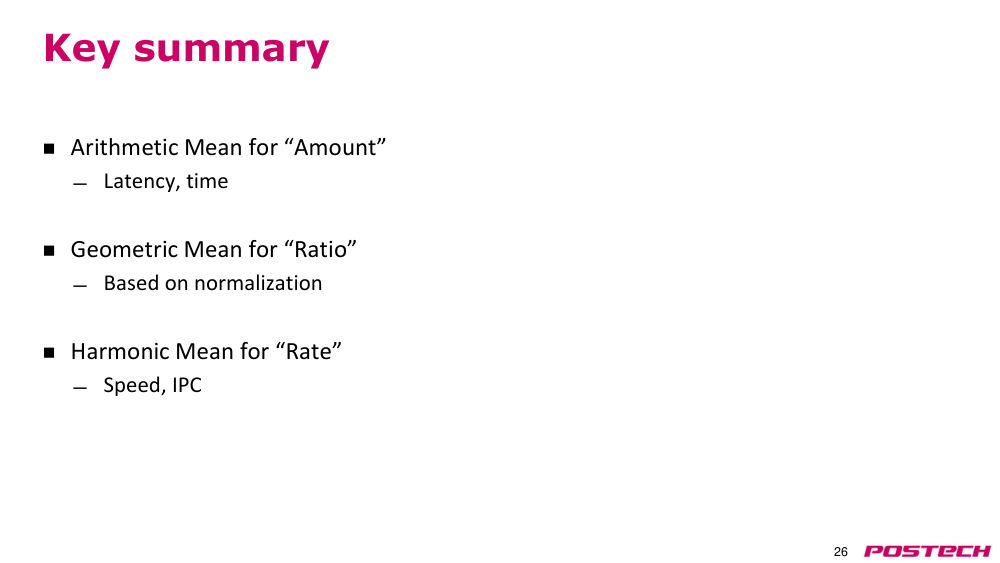
- 양(latency, 시간) → arithmetic mean
- 비율(normalized) → geometric mean
- rate(속도, IPC) → harmonic mean
2.728:31–33:46standard benchmark: SPEC 과 성능 평가 정리
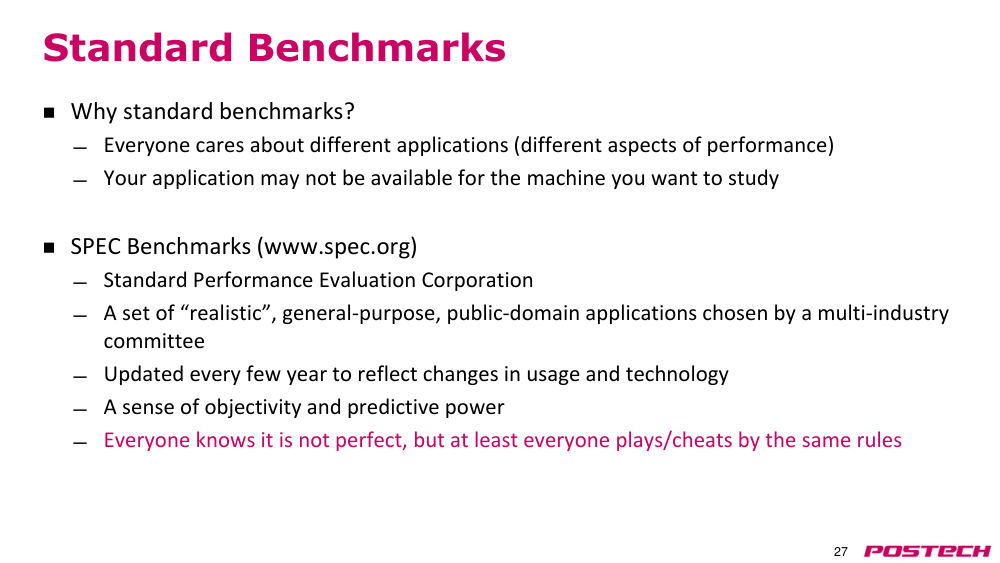
상황·문제사람마다 다른 application 으로 비교하면 정확한 비교가 어렵다.
원인공통 application 세트가 없으면 결과를 서로 비교·재현할 수 없다.
해결SPEC(Standard Performance Evaluation Corporation) benchmark 사용. SPEC CPU2006(CINT·CFP), 최신 2017. SPECratio = 296 MHz Sun machine 기준 normalized 성능의 GM.
- 약점: 특정 연산에 맞춘 최적화로 점수만 오를 수 있지만 모두 같은 규칙
- Java·web service 등 domain 별 suite 도 있다
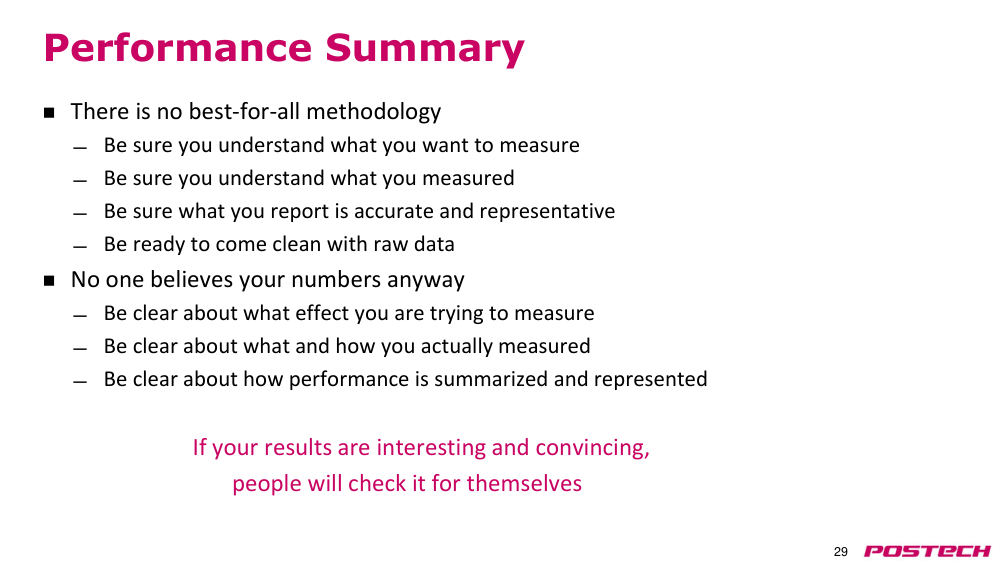
- 정리: 최선의 단일 방법은 없다. 무엇을 어떻게 쟀는지 밝혀 재현 가능하게
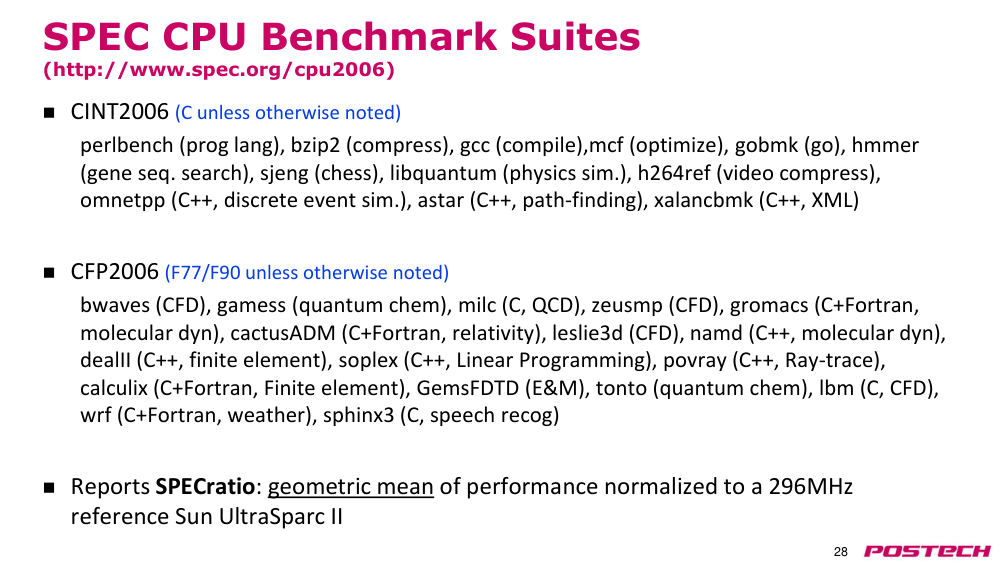
2.7.r.3SPEC CPU2006 readme1st (spec.org) ↗ · reference machine = Sun Ultra Enterprise 2 (1997), 296 MHz UltraSPARC II
2.833:46–39:39출석 체크 (행정)
상황·문제Zoom 이름을 '학번 + 공백 + 한글 이름'으로 바꾸고 chat 에 출석을 입력. 5분 안에 답하면 출석, 이후는 지각 처리.
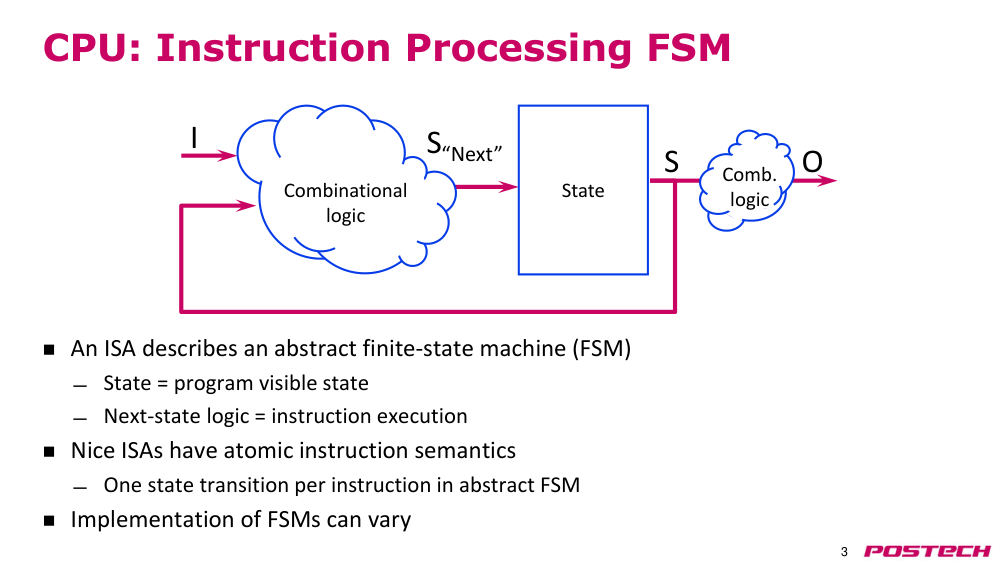
2.939:39–43:08Single-cycle CPU 도입: CPU = instruction processing FSM
상황·문제CPU 설계를 가장 단순한 single-cycle CPU 부터 시작해 multi-cycle·pipelined CPU 로 발전시킨다.
원인ISA 는 추상 FSM: state = programmer visible state, instruction 실행 = state transition.
해결좋은 ISA 는 atomic instruction semantics (실행 중 다른 변경 없음). 같은 ISA 에 여러 FSM 구현이 가능.
- 성능을 올릴수록 복잡도가 늘어난다
- atomic 예: x2+x3 계산 중 x2·x3 값은 바뀌지 않는다
2.1043:08–50:58programmer visible state 와 component 입출력
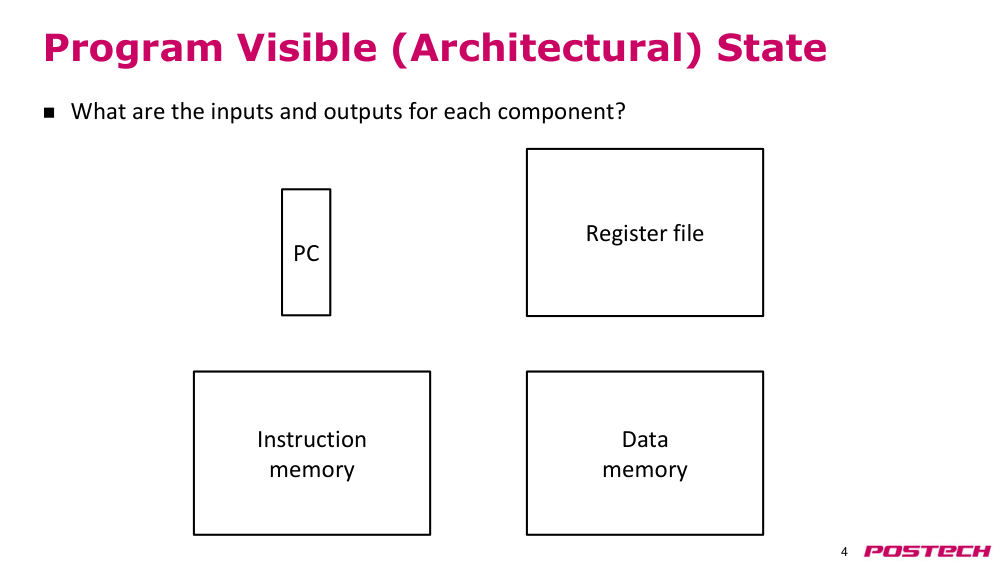
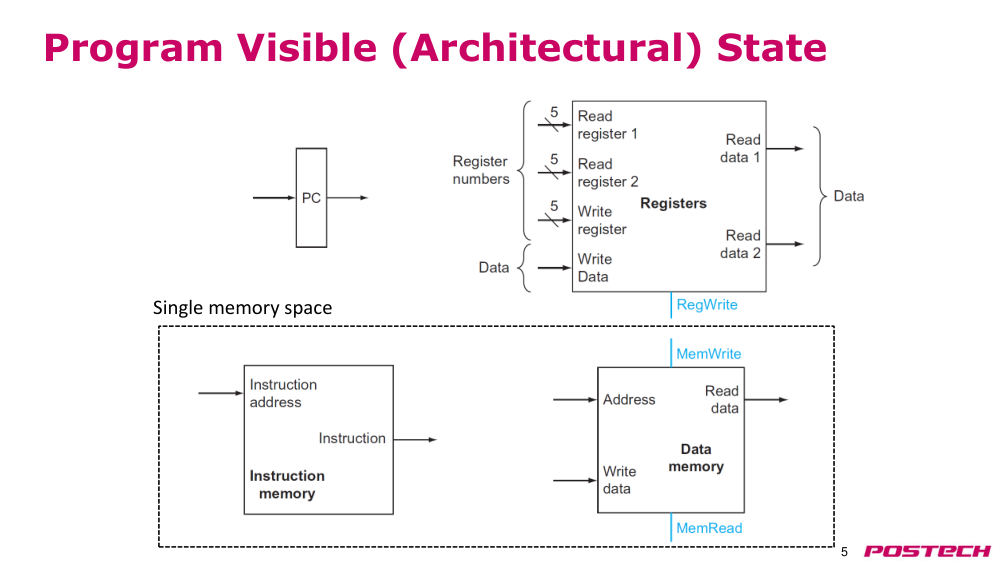
상황·문제PC, register file, instruction memory, data memory 의 input·output 은 무엇인가? (수업 중 질문)
원인single-cycle 에서는 한 instruction 이 instruction fetch 와 data 접근으로 memory 를 두 번 쓰므로 memory 를 둘로 가정한다.
해결PC: 출력 현재 주소·입력 다음 주소. register file: read register 1·2, write register, write data, read data 1·2, RegWrite. memory: address, (write data), read data, MemRead/MemWrite.
- 모든 state component 는 clock 입력을 가진다
- control 이 asserted 가 아니면 write register·write data 는 영향 없음
2.1150:58–53:16'magic' memory·register file 가정
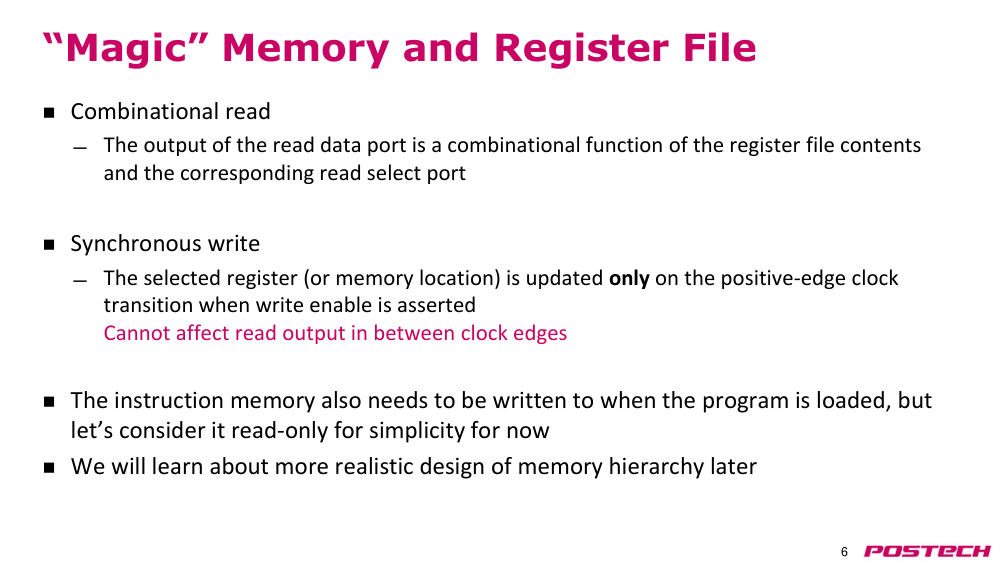
상황·문제설계를 단순화하려면 memory 와 register file 의 read/write 동작을 어떻게 가정할까?
원인실제 구현은 더 복잡하다 (이후 강의에서 다룸).
해결combinational read: read data 는 내용과 주소의 조합 함수. synchronous write: positive clock edge 에서만 갱신. instruction memory 는 read-only 로 간주.
- edge 사이의 변경은 저장값에 영향 없음
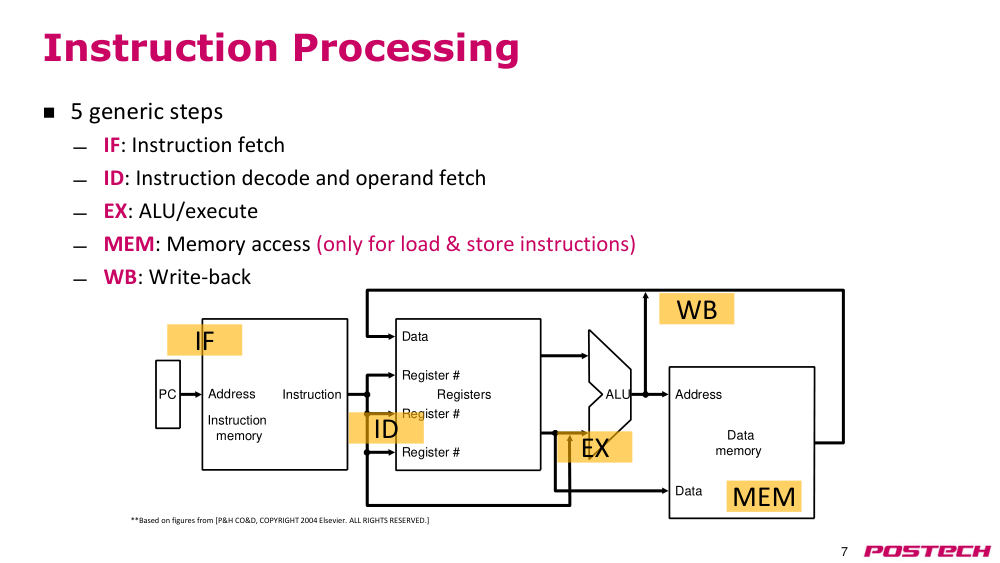
2.1253:16–58:06instruction processing 5단계와 microarchitecture 설계 순서
상황·문제instruction 하나를 처리하는 일반적인 단계는?
원인IF → ID(decode + register operand fetch) → EX(ALU) → MEM(load/store 만) → WB(register 갱신). PC 갱신은 암묵적으로 포함.
해결ISA(RISC-V)는 그대로 두고 microarchitecture 를 설계: ALU → LD/ST → control flow instruction datapath → control signal 순.
- operand fetch 는 register 에서만, load 의 memory read 는 MEM 단계
- von Neumann: control + datapath + memory + I/O
2.1358:06–1:04:27R-type ALU instruction datapath
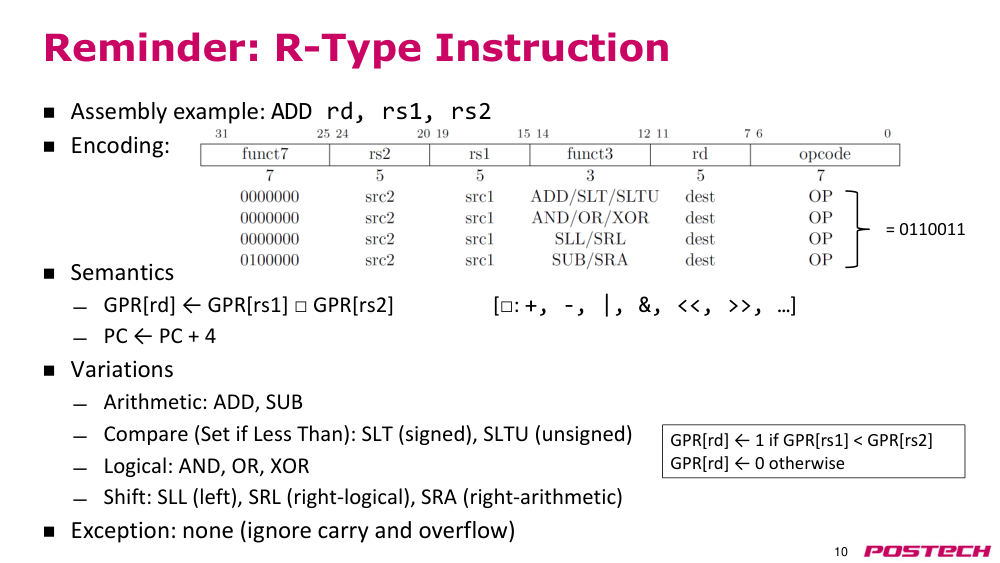
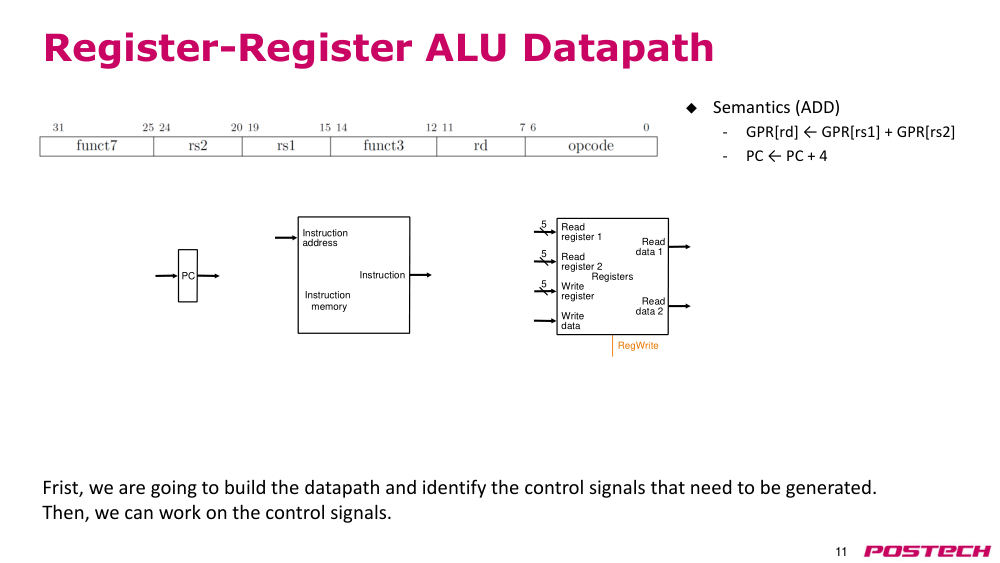
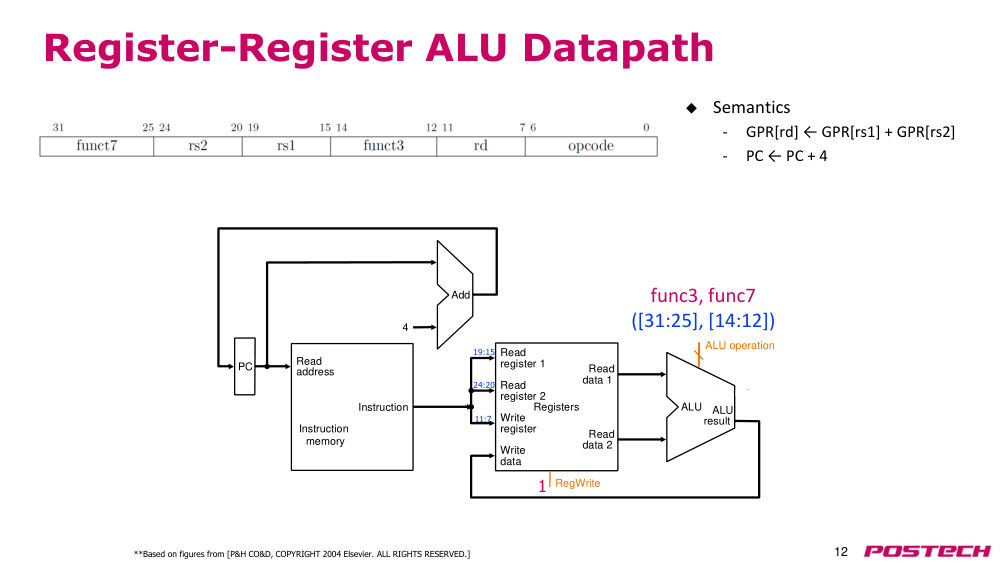
상황·문제ADD rd, rs1, rs2 (GPR[rd] ← GPR[rs1] + GPR[rs2], PC ← PC + 4)를 실행하는 datapath 를 만든다.
원인instruction 의 rs1[19:15]·rs2[24:20]·rd[11:7] 을 register file 에 연결하고 read data 를 ALU 로, 결과를 write data 로 되돌린다.
해결ALU 가 연산에 쓰이므로 PC + 4 는 별도 adder 로 계산. funct3·funct7 로 ALU operation 지정.
- datapath 를 먼저, control signal 은 나중에
- 수업 질문: PC 갱신은 PC + 4 용 adder 추가
2.141:04:27–1:08:45I-type ALU instruction: immediate 와 mux
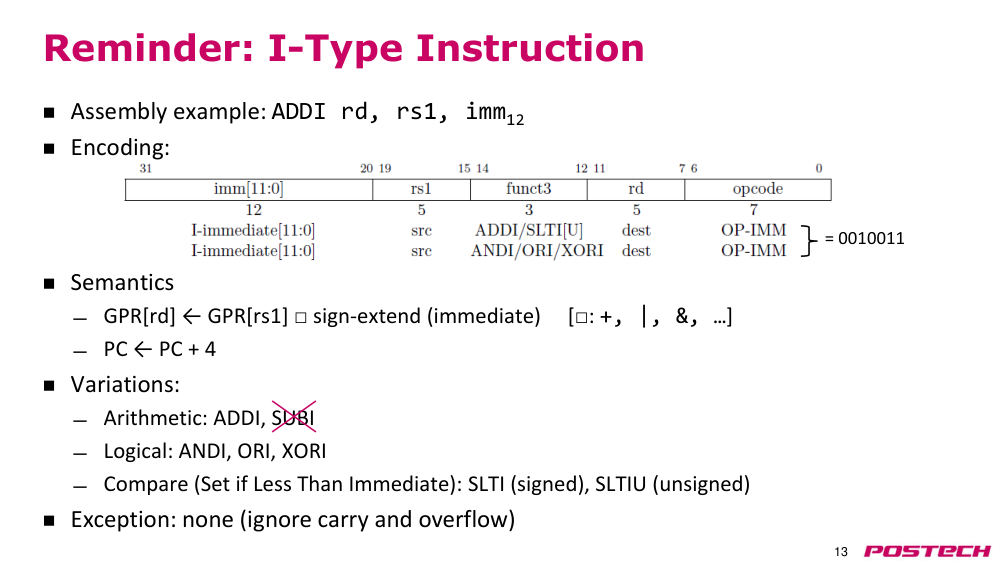
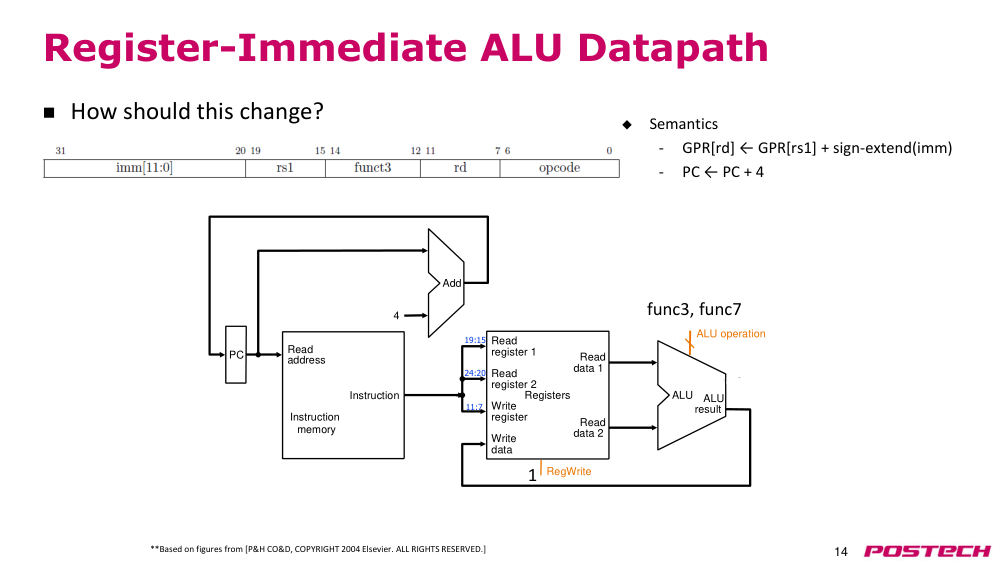
상황·문제ADDI 처럼 두 번째 operand 가 register 가 아니라 immediate 인 instruction 도 실행해야 한다.
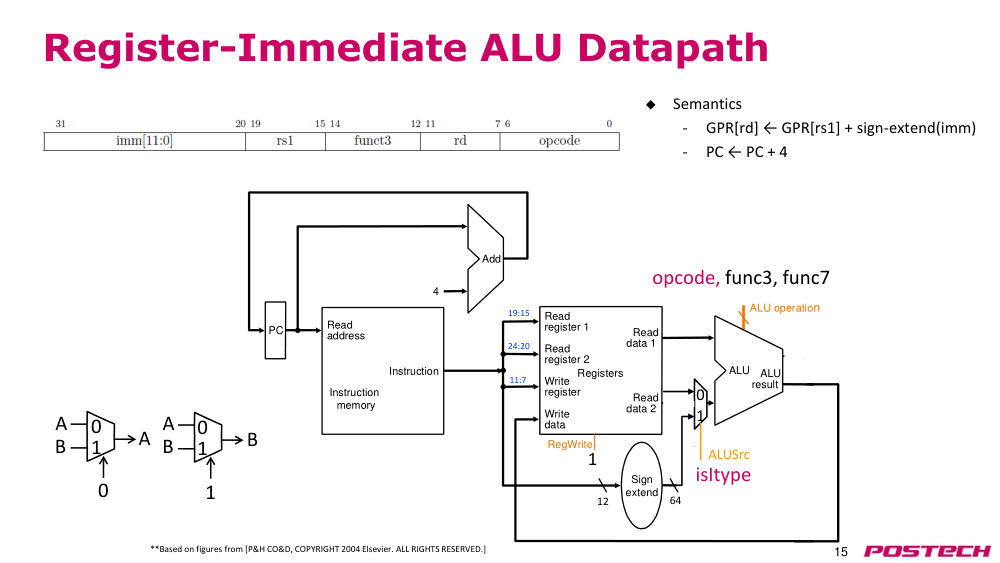
원인ALU 두 번째 입력이 하나뿐이라 read data 2 와 immediate 중 선택이 필요.
해결instruction imm field 를 sign extension 하는 logic 추가, ALU 두 번째 입력에 mux(control = isItype). ALU operation 에 opcode 도 사용.
- immediate 입력은 instruction 의 imm field
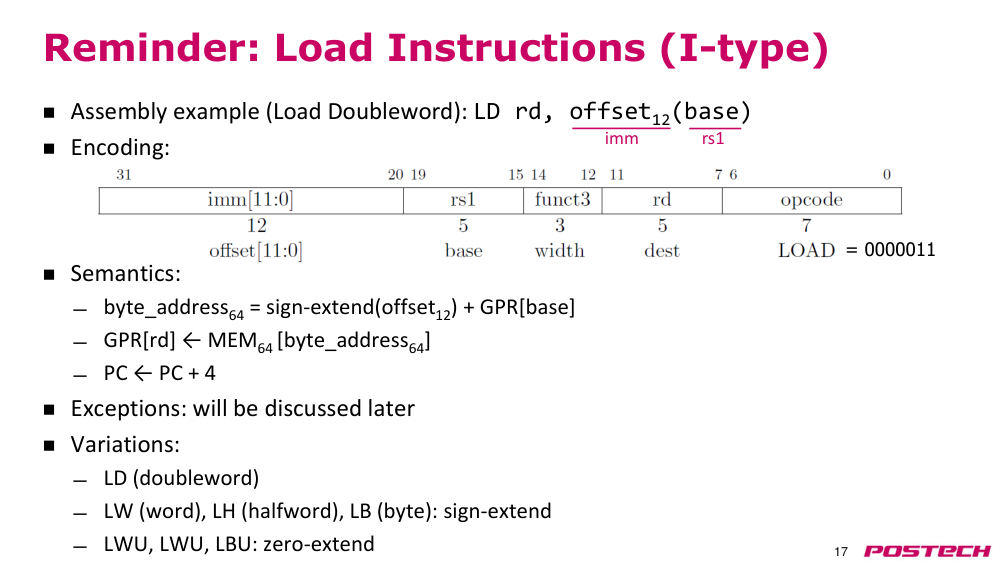
2.151:08:45–1:12:56LD(load) datapath
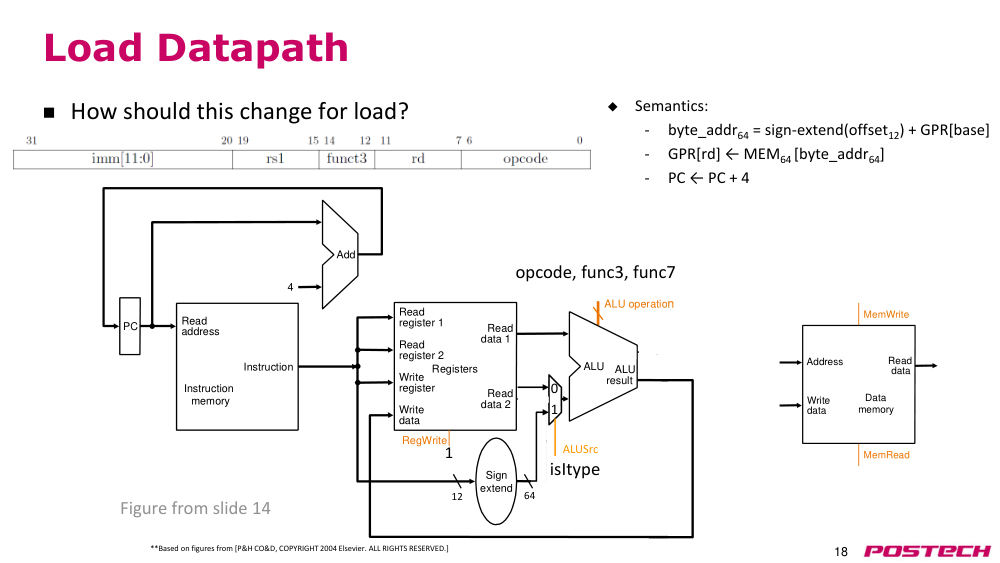
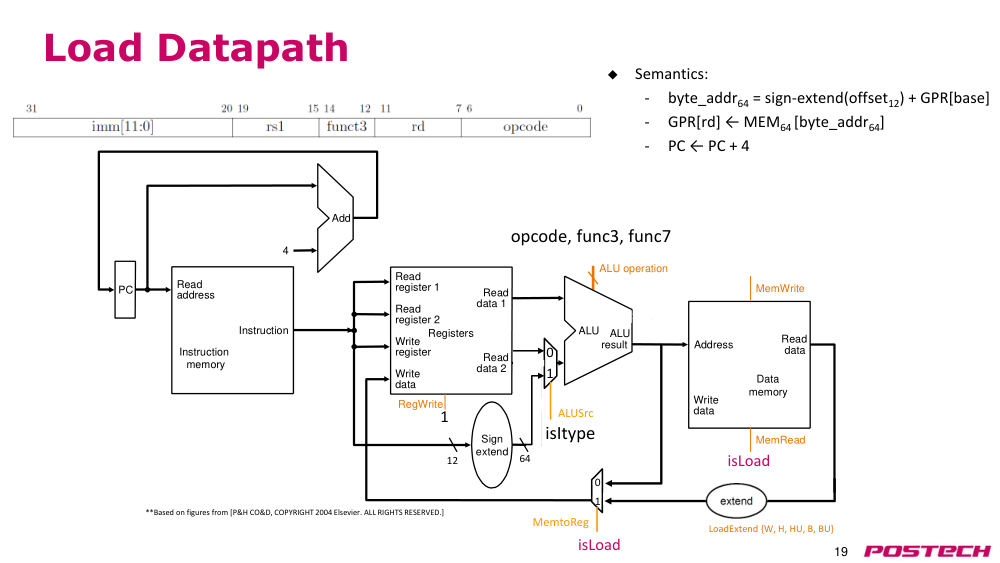
상황·문제load 도 I-type 이지만 CPU 안에서 하는 일이 다르다: data memory 를 어디에 연결할까?
원인주소 = base(rs1) + sign-extended imm 이므로 기존 ALU 로 계산 가능. register 에 쓸 값이 ALU result 와 memory read data 둘이 된다.
해결ALU result → data memory address, write data 앞에 mux 추가(isLoad). load 폭에 따라 read data 를 extend 하는 logic 추가.
- load 는 write data 를 memory 에 주지 않는다
2.161:12:56–1:16:57SD(store) datapath 와 control, 다음 강의 예고
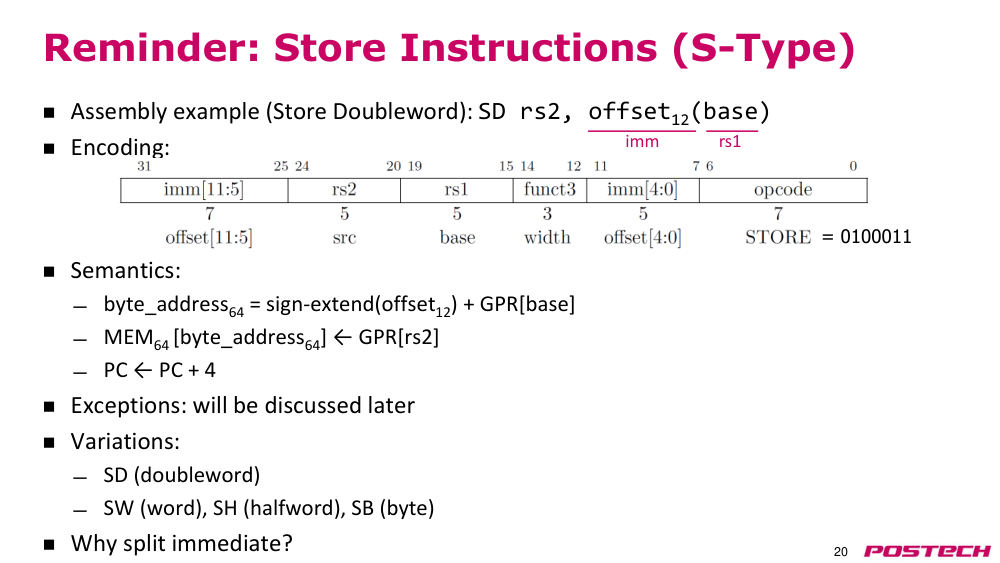
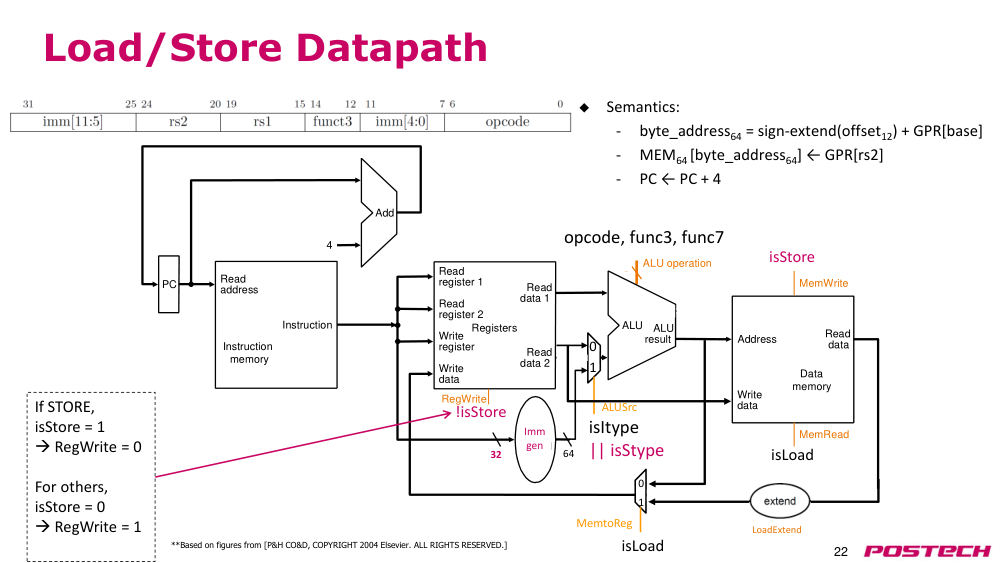
상황·문제store 는 주소 계산은 load 와 같지만 memory 에 쓴다. write data 는 어디서 오나?
원인store 는 register 에 쓰지 않는 첫 instruction 이고 imm 이 다른 bit 위치에 있다.
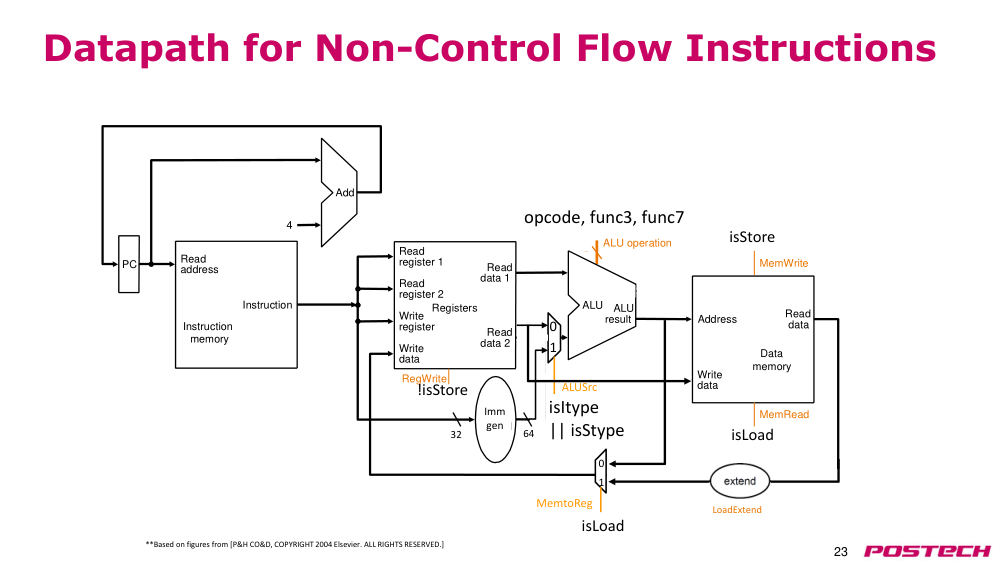
해결write data ← register file 두 번째 read port(rs2). MemWrite = isStore, RegWrite = !isStore, Imm gen 에 instruction 전체 입력, ALU mux control = isItype || isStype.
- non-control-flow instruction datapath 완성
- control flow instruction 은 다음 강의
2.16.r.3Computer Organization and Design RISC-V Edition (Elsevier) ↗ · P&H 교재, Ch 4 single-cycle datapath 원출처
3핵심 개념
3.1Amdahl's law(암달의 법칙)
S = 1/((1-f)+f/Sf). 개선 대상 fraction f 가 작으면 전체 speedup 도 작다.
3.2weighted arithmetic mean(가중 산술 평균)
합이 1 인 weight 로 application 중요도(실행 횟수)를 반영한 평균.
3.3geometric mean(기하 평균)
normalized 비율 요약용. 어느 system 기준으로 normalize 해도 상대 순위·비율이 일관.
3.4harmonic mean(조화 평균)
rate(속도, IPC) 요약용. 평균 IPC = 1/AM(CPI).
3.5SPECratio
reference machine(296 MHz Sun) 대비 normalized 성능의 geometric mean.
3.5.r.1SPEC CPU2006 readme1st (spec.org) ↗ · reference machine = Sun Ultra Enterprise 2 (1997), 296 MHz UltraSPARC II
3.6atomic instruction semantics(원자적 명령어 의미)
instruction 하나가 다른 변경 없이 state 를 한 번에 바꾼다.
3.7programmer visible state(프로그래머 가시 상태)
PC, register file, memory. ISA 가 정의하는 architectural state.
3.8combinational read / synchronous write
read 는 조합 논리로 즉시, write 는 enable 된 rising clock edge 에서만.
3.9sign extension(부호 확장)
imm 의 최상위 bit 를 복제해 폭을 늘려 two's complement 값을 유지.
3.10multiplexer(mux)
control 로 여러 입력 중 하나를 선택. ALU 입력·write data 선택에 사용.
4스스로 확인
4.1A0: X 1 s, Y 10 s / A1: X 1000 s, Y 100 s 일 때 X 기준 normalized 비율의 AM 으로 본 Y 는?
답
(10 + 0.1)/2 = 5.05 로 X 보다 약 5배 느리다. Y 기준이면 반대로 5배 빠르게 나와 AM 은 일관성이 없다.
4.210 km 를 30 km/h, 다음 10 km 를 90 km/h 로 달린 평균 속도는?
답
20/(10/30 + 10/90) = 45 km/h. rate 는 harmonic mean.
4.3IPC 평균에 harmonic mean 을 쓰는 이유는?
답
CPI 는 시간이라 AM 이 맞고, 평균 IPC = 1/AM(CPI) 를 전개하면 IPC 의 HM 이 된다.
4.4single-cycle datapath 에서 PC + 4 를 ALU 로 계산하지 않는 이유는?
답
같은 cycle 에 ALU 가 instruction 연산(예: ADD)에 쓰이므로 별도 adder 가 필요하다.
4.5store instruction 에서 write data 와 RegWrite 는?
답
write data 는 register file 두 번째 read port(rs2). store 는 register 에 쓰지 않으므로 RegWrite = !isStore.
5참고 자료
5.1Computer Organization and Design RISC-V Edition (Elsevier) ↗ · P&H 교재, Ch 4 single-cycle datapath 원출처