Lec 3 · Memory hierarchy 개요와 memory 기술
정밀 정리 · 검증 2026-09-23 22:19
1개요
1.1processor-memory 성능 격차(memory wall)와 latency·bandwidth bottleneck 에서 출발해 memory hierarchy 의 필요성을 설명.
1.2cell 크기·물리적 크기·MPKI·bandwidth filter 관점에서 cache hierarchy 설계 trade-off 와 locality 원리를 다룸.
1.3punched card·core memory 부터 SRAM·DRAM cell, DRAM array·bank, DIMM·TSV·HBM·eDRAM 까지 memory 기술을 훑음.
1.4cache organization(slide 32~45)은 학부 복습으로 넘기고 associativity 의 access time·energy 비용만 짚음. 읽기: 교재 2.1-2.2, Appendix B.1-B.6.
2섹션별 정리 상황·문제 → 원인 → 해결
2.14:56–9:27행정: 프로젝트 주제·proposal 일정 (행정)
상황·문제프로젝트 주제를 수요일까지 이메일로 알리고, 새 insight·설계가 있는 한 학기 분량 주제를 고를 것. proposal 은 다음 주 금요일 마감, template 은 수요일 공지.
2.29:27–13:19Memory wall: processor-memory 성능 격차
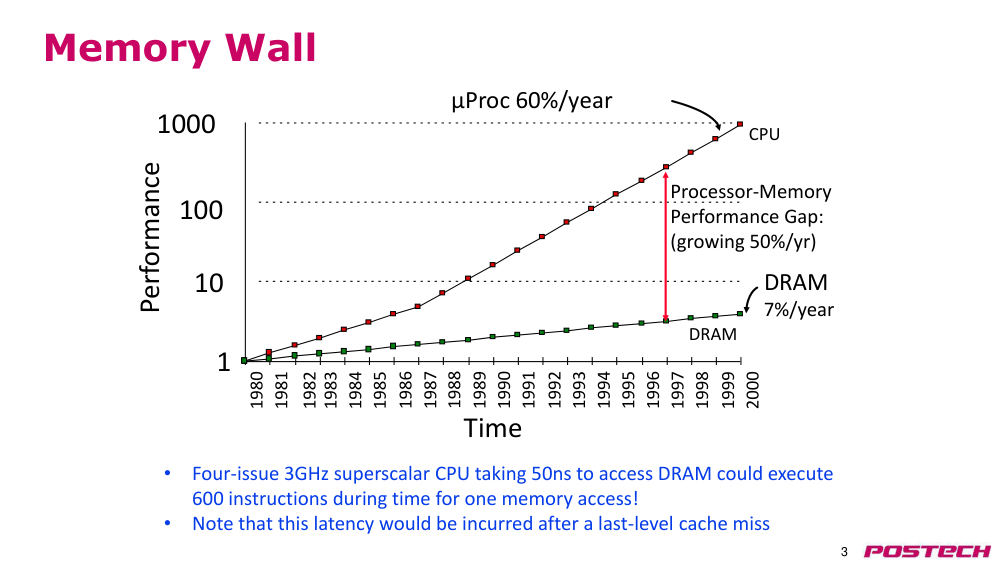
상황·문제CPU 는 연 60%, DRAM 은 연 7% 성능 향상 → 격차가 연 50%씩 커짐. DRAM 을 계속 접근하는 workload 는 DRAM 성능에 묶임.
원인4-issue 3GHz CPU 는 DRAM 접근 50ns 동안 600 명령어를 처리할 수 있고, 명령어의 20~30% 가 load/store. 이 latency 는 LLC miss 이후이며 L1·L2·L3 miss 경로가 더해져 100ns 를 넘기도 함.
해결memory 접근이 성능 bottleneck 이 되는 현상을 memory wall 이라 부르고, 이후 cache hierarchy 로 완화하는 방법을 다룸.
- y축 log scale: 둘 다 지수 성장이지만 gap 이 벌어짐
- DRAM latency 50ns ≈ 600 명령어 (slide 기준)
- end-to-end latency 는 cache level 통과 시간까지 포함
2.2.r.1Random-access memory § Memory wall — Wikipedia ↗ · processor-memory 성능 격차(memory wall) 개념 (RAM 문서의 절로 redirect)
2.313:19–15:55Processor-memory bottleneck: latency 와 bandwidth
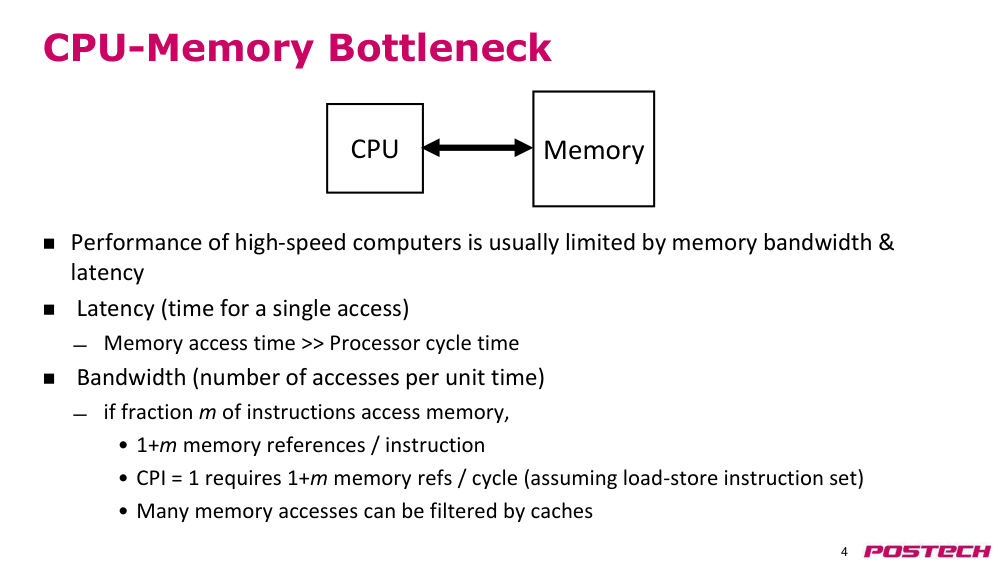
상황·문제고속 컴퓨터의 성능은 memory latency 와 bandwidth 로 제한됨.
원인latency: processor cycle time 은 빠르게 줄었지만 memory access time 은 느리게 개선(1970~80년대엔 비슷). bandwidth: 명령어 중 m 비율이 data 접근이면 명령어당 1+m 회 참조(instruction fetch 포함).
해결CPI=1 이려면 cycle 당 1+m 회 참조를 처리해야 함. 대부분은 cache 가 filter 하지만 memory-intensive workload 는 cache miss 로 memory 접근이 많음.
- m=0.2 → 명령어당 1.2 회 memory 참조
- clock 이 빠를수록 요구 bandwidth 증가
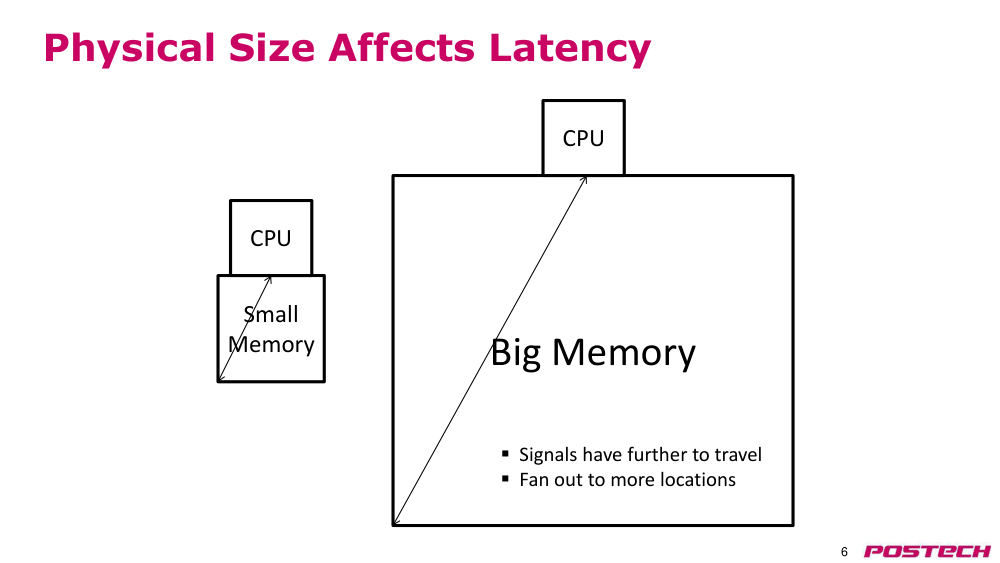
2.415:55–20:18Memory cell 크기와 물리적 크기가 latency 에 미치는 영향
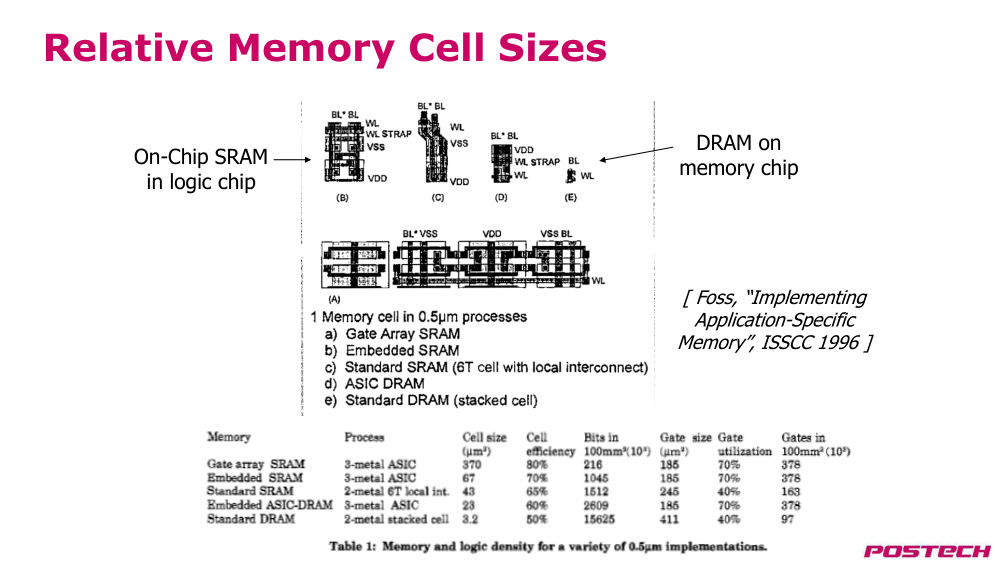
상황·문제memory hierarchy 를 이해하려면 하부 기술(SRAM·DRAM cell)을 알아야 함.
원인SRAM cell 은 standard DRAM cell 보다 훨씬 커서 같은 면적당 bit 수가 적음. 또 memory 가 물리적으로 크면 signal 이동 거리와 fan-out 이 커져 latency 가 늘어남.
해결→ 작고 빠른 memory 와 크고 느린 memory 사이의 trade-off 가 생김 (hierarchy 의 근거).
- 0.5µm 공정: Standard SRAM 43µm² vs Standard DRAM 3.2µm²
- fan-out: 한 signal 을 10개 transistor 에 전달하면 2~3개보다 오래 걸림
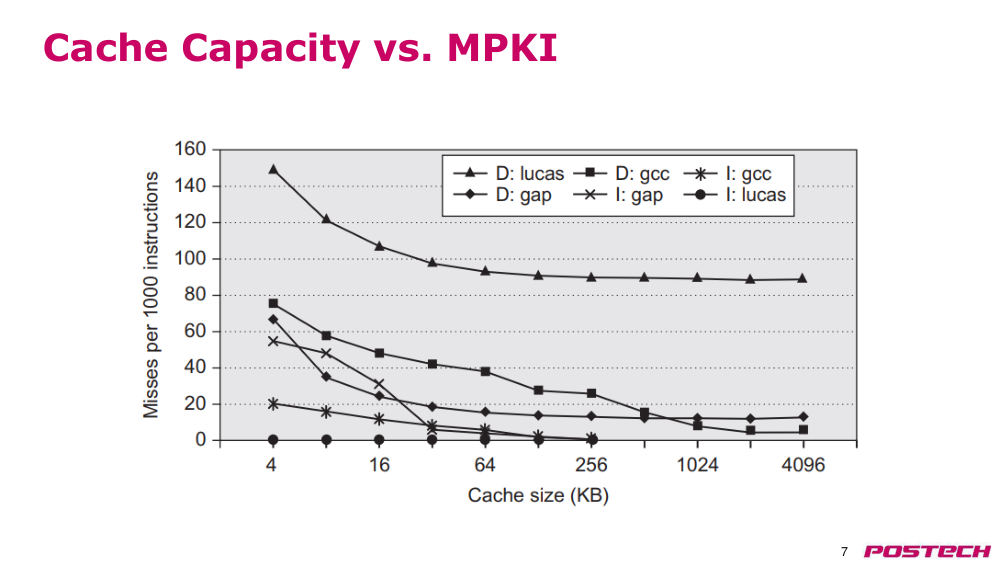
2.520:18–22:15Cache 용량 vs MPKI
상황·문제cache 를 얼마나 크게 만들어야 하는가.
원인cache 가 커지면 MPKI 는 줄지만 어느 크기 이후 개선이 미미하고, 큰 cache 는 access time 이 길어짐.
해결관심 workload 전체를 종합적으로 보고 최적 크기를 선택.
- MPKI = misses per kilo instructions
- workload 마다 곡선 모양이 다름
2.622:15–25:58Memory hierarchy 와 bandwidth filter
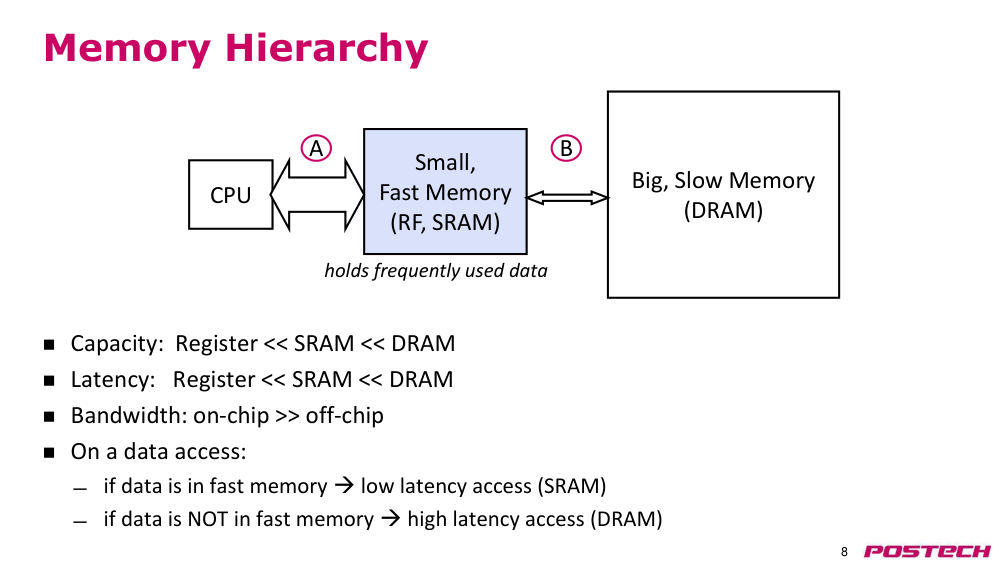
상황·문제capacity 와 latency 사이 trade-off 때문에 한 종류 memory 로는 크고 빠를 수 없음.
원인register·L1(경우에 따라 L0) 은 작고 빠르며 on-chip 이라 bandwidth 가 높고, DRAM 은 크지만 느림.
해결자주 쓰는 data 를 빠른 memory 에 두고, 각 cache level 이 상위 요청을 filter 하게 함. level 별 크기는 bandwidth demand 와 제공 bandwidth 를 보고 결정.
- 용량·latency: register << SRAM << DRAM
- L1 은 모든 접근을 받으므로 가장 많이 filter·가장 높은 bandwidth
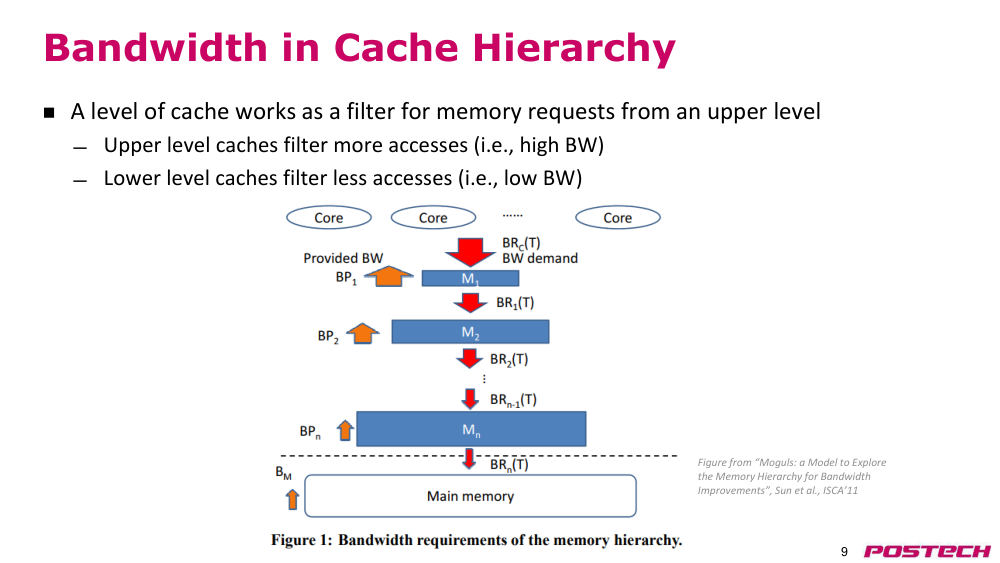
2.6.r.2Moguls: a Model to Explore the Memory Hierarchy for Bandwidth Improvements (ISCA'11, PDF) ↗ · slide 9 그림 원 논문 (저자 페이지)
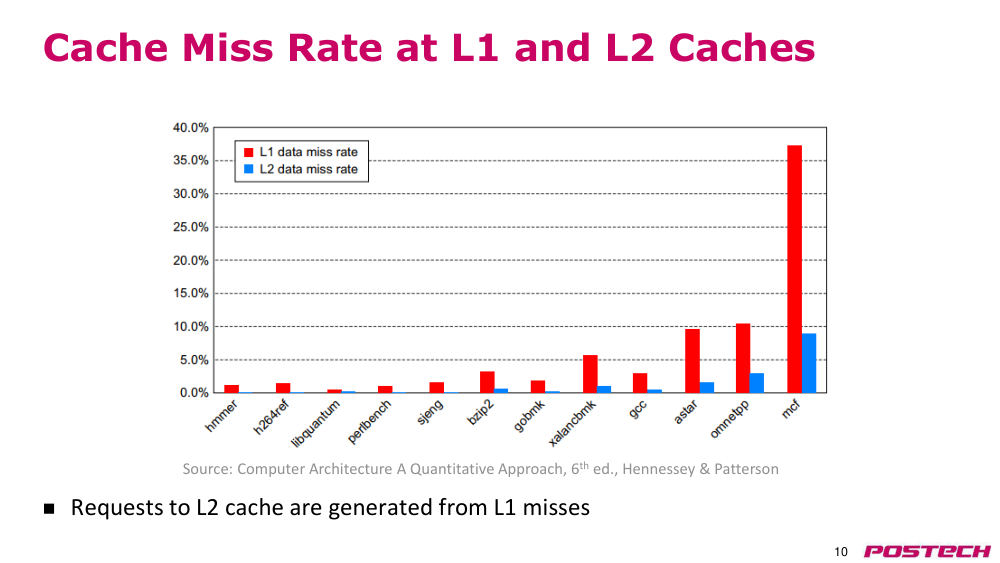
2.725:58–27:41L1·L2 cache miss rate
상황·문제workload 에 따라 cache miss rate 가 크게 다름.
원인mcf 는 miss rate 가 매우 높고, 왼쪽 workload 들은 locality 가 좋거나 memory 접근이 적어 cache 영향이 작음.
해결L2 miss rate 가 낮아 보여도 L2 요청은 L1 miss 에서만 오므로, 실제로는 L1 이 훨씬 많은 요청을 filter 함에 유의.
- L2 miss rate 는 L1 miss 를 분모로 함
- miss rate 만으로 compute-intensive 여부를 판단하긴 어려움
2.7.r.1Computer Architecture: A Quantitative Approach, 6th ed. — Elsevier ↗ · 교재. 2.1-2.2 및 Appendix B.1-B.6 읽기 과제, slide 10·41·42 그림 출처
2.827:41–31:06Memory hierarchy 관리: SW vs HW
상황·문제level 마다 누가 관리하는가가 다름.
원인register 는 instruction 이 번호를 지정하고 compiler 가 할당·spill. main memory 주소는 register 값에서 계산. cache 관리(replacement)를 SW 로 하면 너무 느림.
해결register 는 SW 관리(단 HW 의 renaming, stack machine 의 stack 관리), cache 는 HW 관리 + SW hint(bypass, prefetch 억제).
- register renaming: architectural ↔ physical register mapping 은 HW
- locality 없는 data 는 cache bypass hint
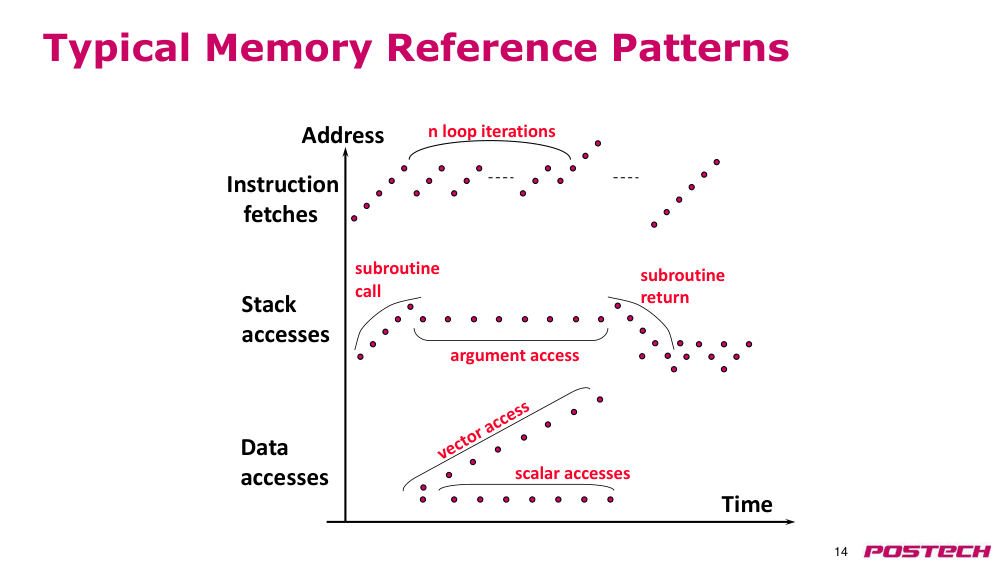
2.931:06–36:40Principle of locality 와 memory reference pattern
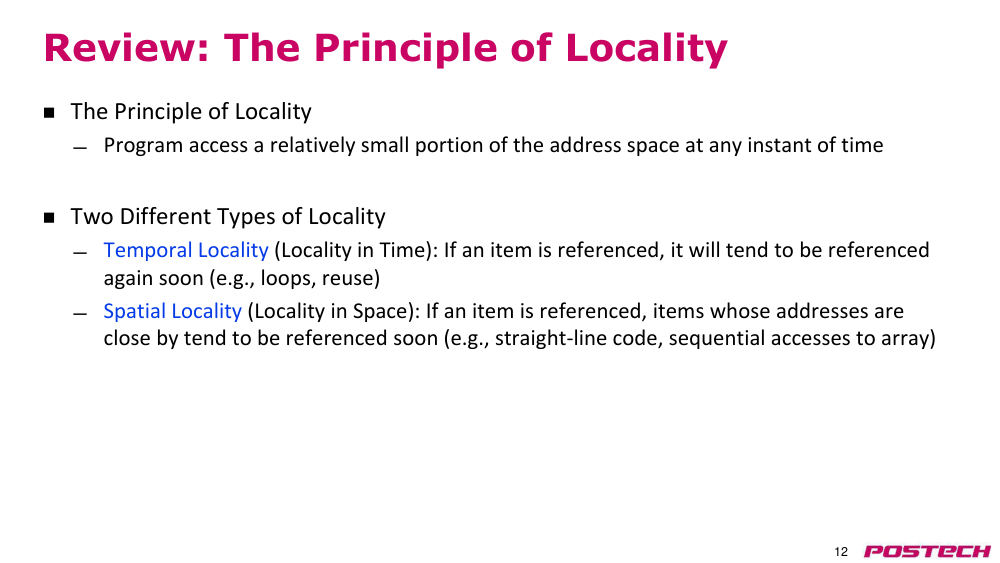
상황·문제memory hierarchy 는 locality 원리에 기반함.
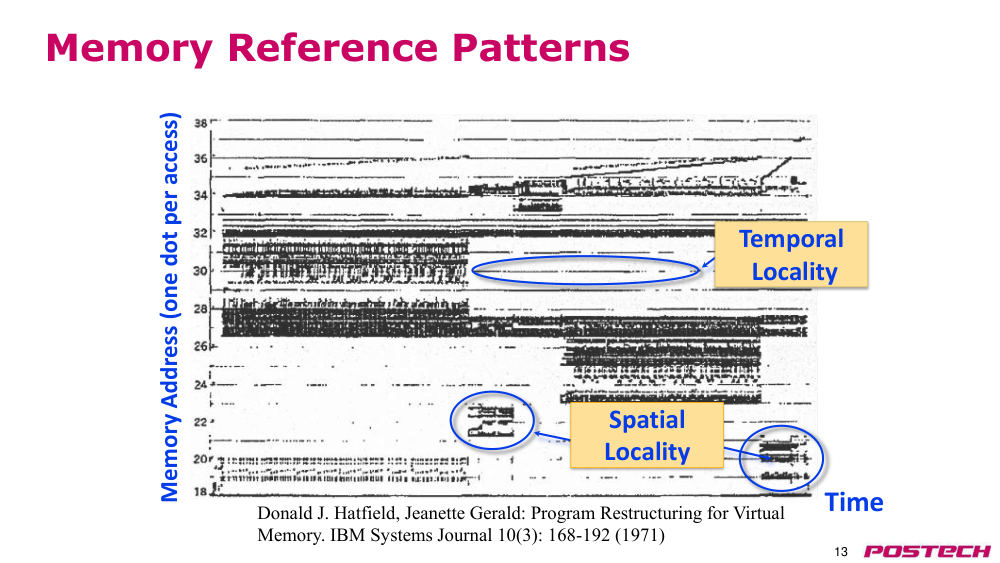
원인temporal locality(loop·재사용)와 spatial locality(straight-line code, 배열 순차 접근)가 실제 주소-시간 plot 에서 관찰됨.
해결access pattern 을 보면 loop 반복, subroutine call 의 stack push/pop, vector·scalar 접근 등 CPU 동작을 추론할 수 있음.
- plot 의 점 하나 = memory 접근 1회
- stack 은 위에서 자라므로 push 시 주소는 감소해야 함(강의 중 언급)
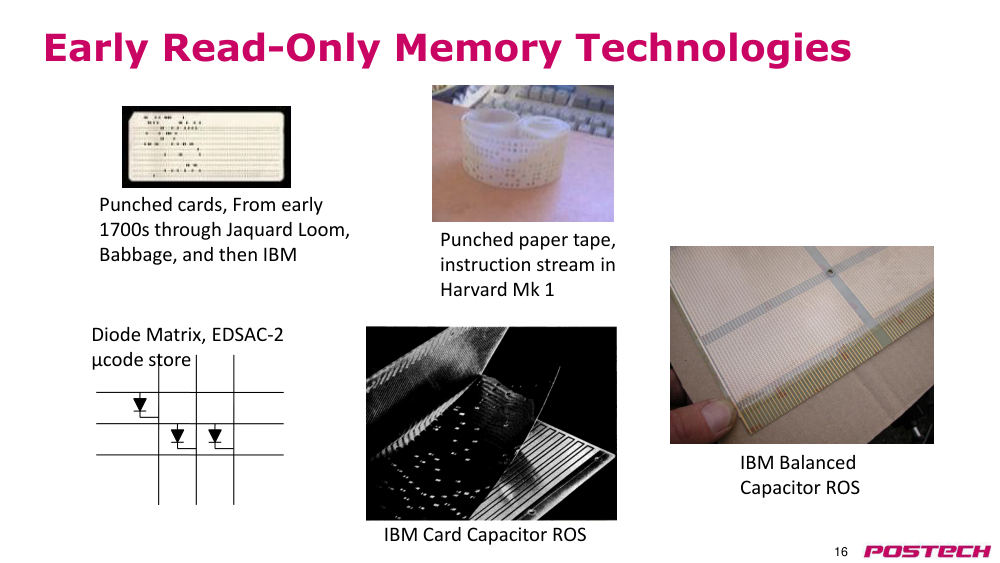
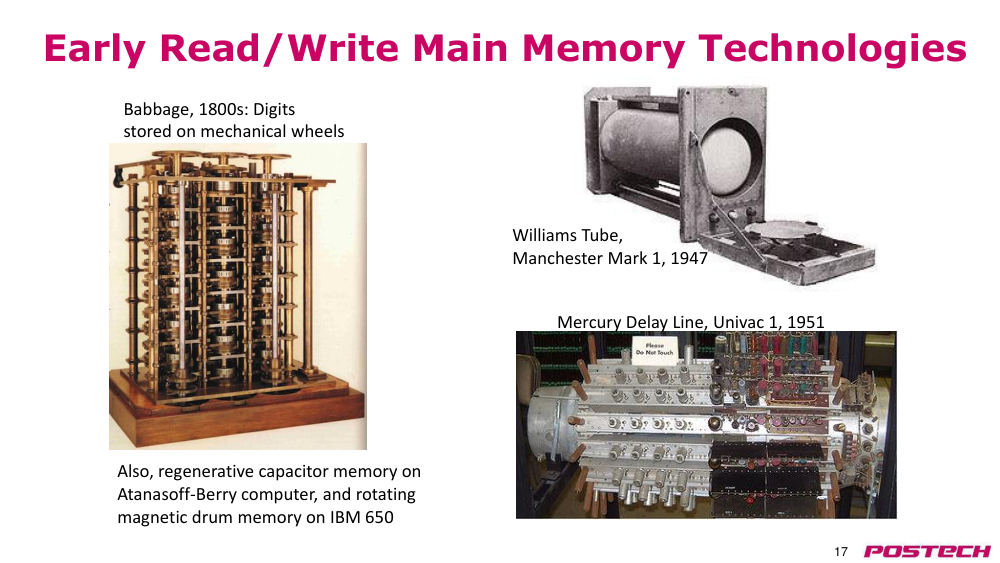
2.1036:40–42:00초기 memory 기술: punched card 에서 core memory 까지
상황·문제DRAM 이전에는 어떤 memory 를 썼는가.
원인read-only: punched card·paper tape, diode matrix(microcode store), capacitor ROS. read/write: Babbage 기계식, Williams tube(CRT), mercury delay line.
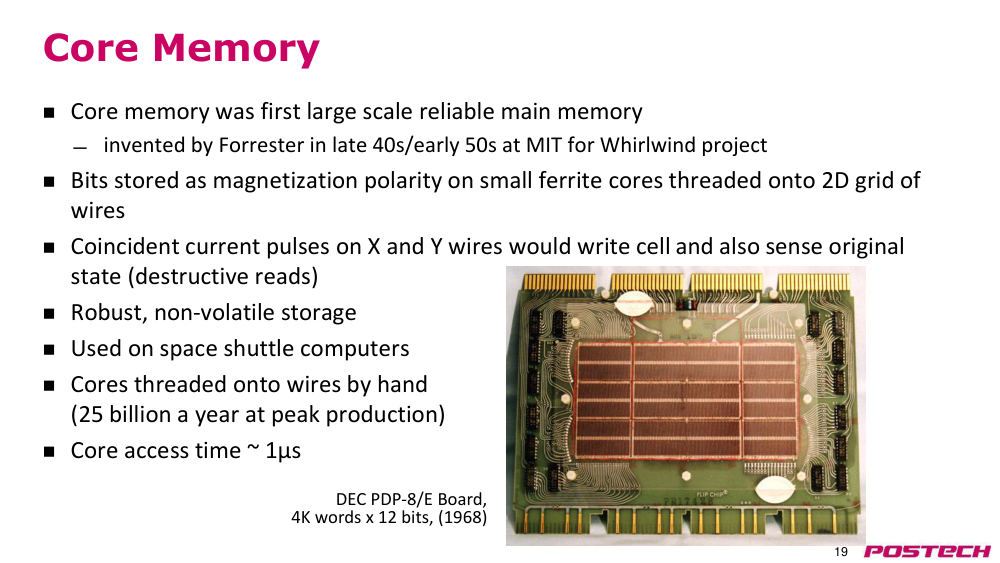
해결core memory: 도선 교차점의 magnetic core 자화 방향으로 bit 저장. 최초의 대규모 신뢰성 main memory(1940년대 후반~50년대 초).
- core memory read 는 destructive → 다시 써야 함
- non-volatile, access time 약 1µs, 수작업 제조로 생산량 제한
2.1142:00–47:46Semiconductor memory: SRAM 과 1T DRAM cell
상황·문제core memory 는 수작업이라 확장·속도에 한계.
원인SRAM 은 cross-coupled inverter 로 값을 유지(BL/BL̄ 2개, WL 1개). DRAM 은 capacitor 1개 + transistor 1개로 transistor 수가 적음. Intel 1103 은 1 Kbit 최초 상용 DRAM.
해결공장 생산 가능한 semiconductor memory 가 '70년대 core 를 대체. DRAM 은 bit line 전압 변화를 sense amplifier 로 증폭해 판독, 최근엔 trench capacitor 사용.
- DRAM: word line 이 cell 선택 → bit line 전압 변화 → sense amp
- trench capacitor 도 두 electrode + dielectric 원리 동일
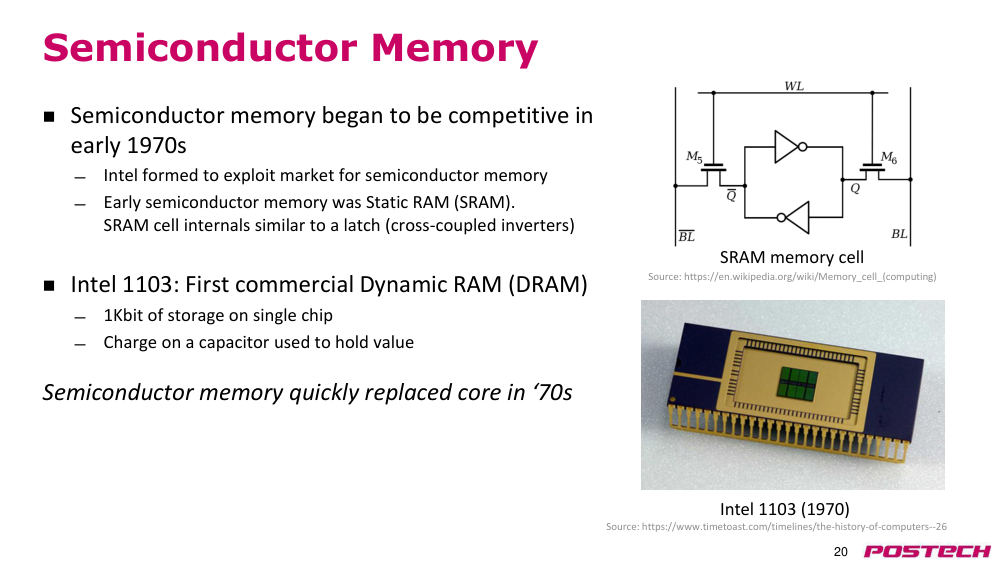
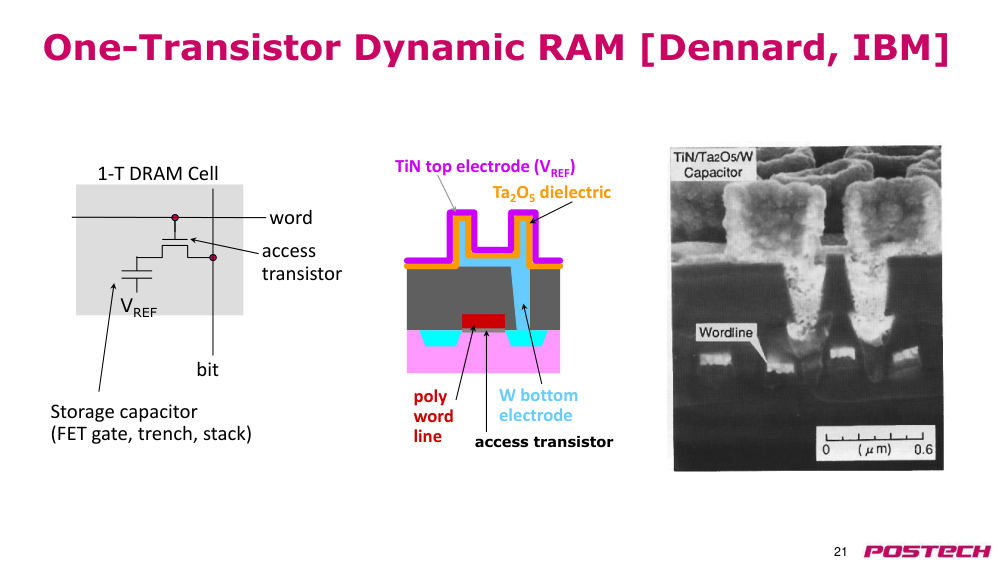
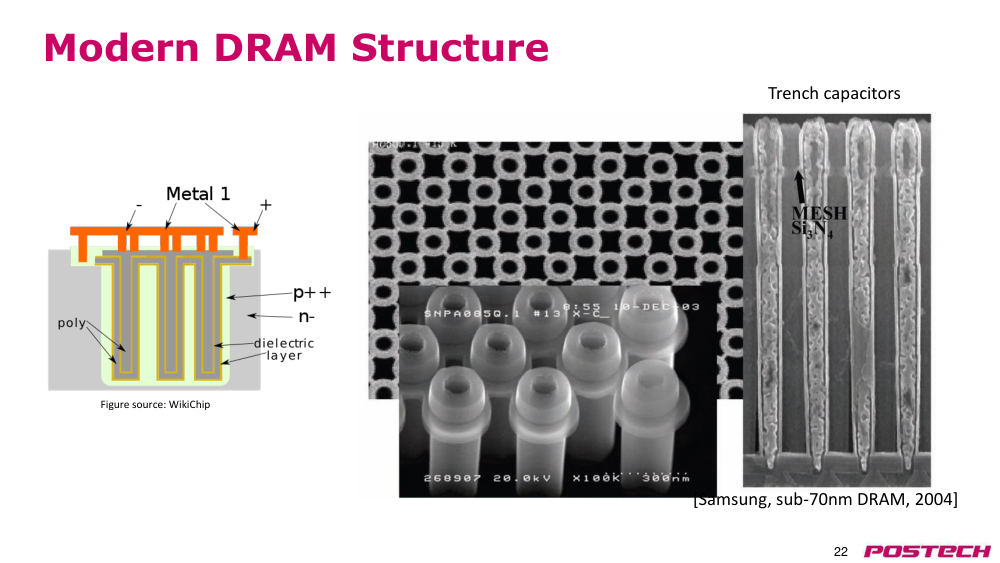
2.11.r.1Static random-access memory — Wikipedia ↗ · 6T cell: cross-coupled inverter + access transistor, BL/BL̄
2.11.r.3Dynamic random-access memory — Wikipedia ↗ · 1T1C cell, sense amplifier, destructive read·refresh, trench/stacked capacitor
2.1247:46–55:50DRAM array 구조와 bank vs multi-port
상황·문제DRAM cell 을 array 로 묶었을 때 접근 방식과 동시성.
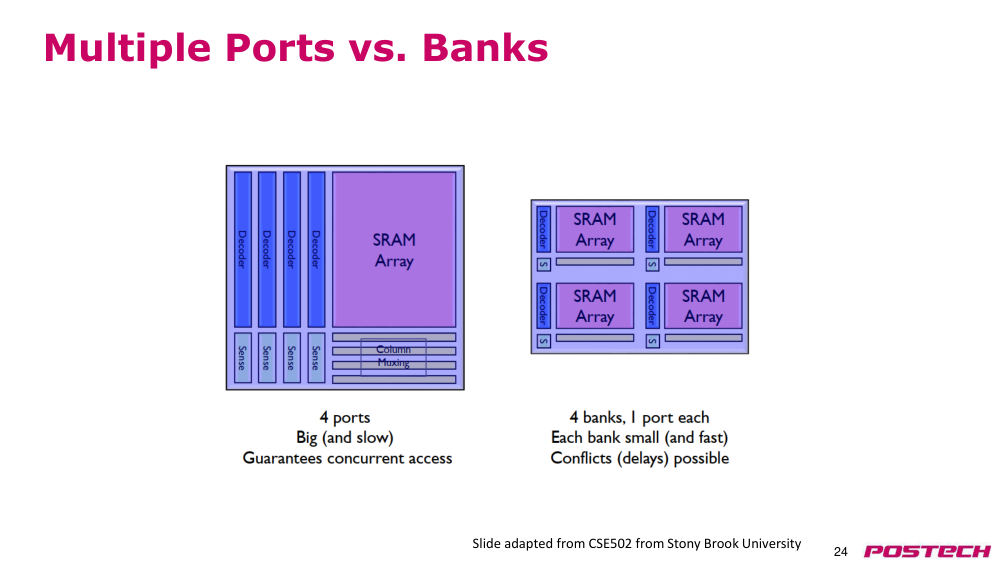
원인row decoder 가 word line 을 선택하면 row 전체가 sense amplifier(row buffer)로 읽힘. read 는 destructive 라 복원 필요, 한 array 는 한 번에 한 row 만 접근.
해결동시 접근을 위해 multi-port(크고 느림, 동시성 보장) 대신 여러 작은 bank(빠르고 효율적, 충돌 시 대기)를 둠. chip 당 bank 4~16개.
- row buffer 에 있는 row 는 여러 column 을 반복 접근 가능
- 유연성이 필요하면(register file) multi-port, 밀도·energy 가 중요하면 multi-bank
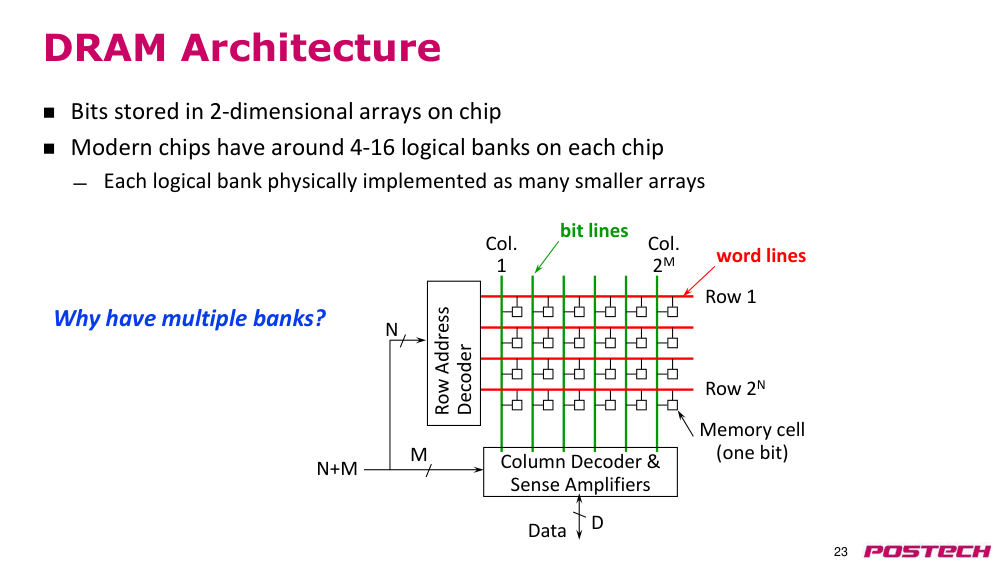
2.12.r.1Dynamic random-access memory — Wikipedia ↗ · 1T1C cell, sense amplifier, destructive read·refresh, trench/stacked capacitor
2.1355:50–1:03:19DRAM packaging: DIMM, mobile package, TSV
상황·문제DRAM chip 의 data bus 는 CPU bus 보다 좁고, 용량·신호 수를 늘려야 함.
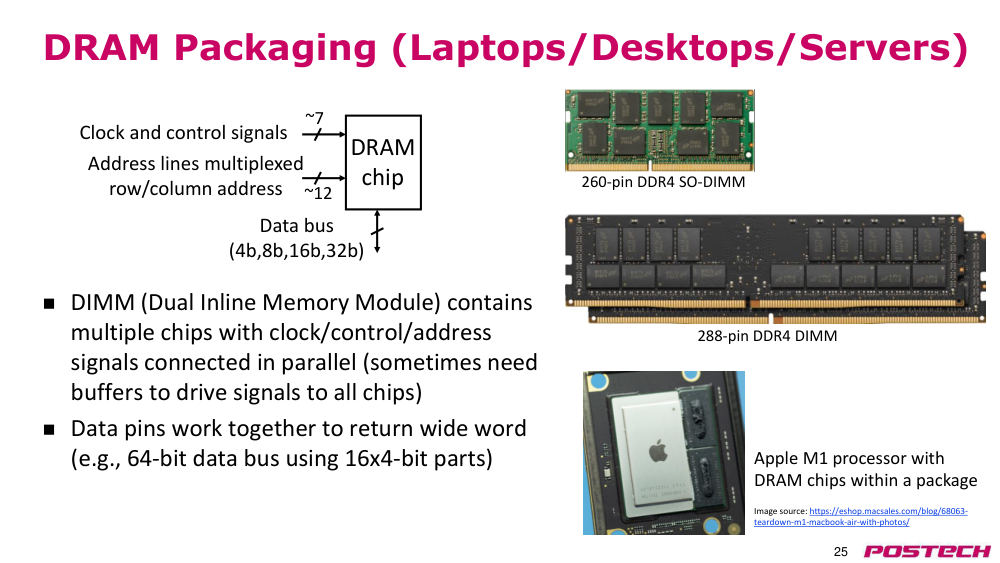
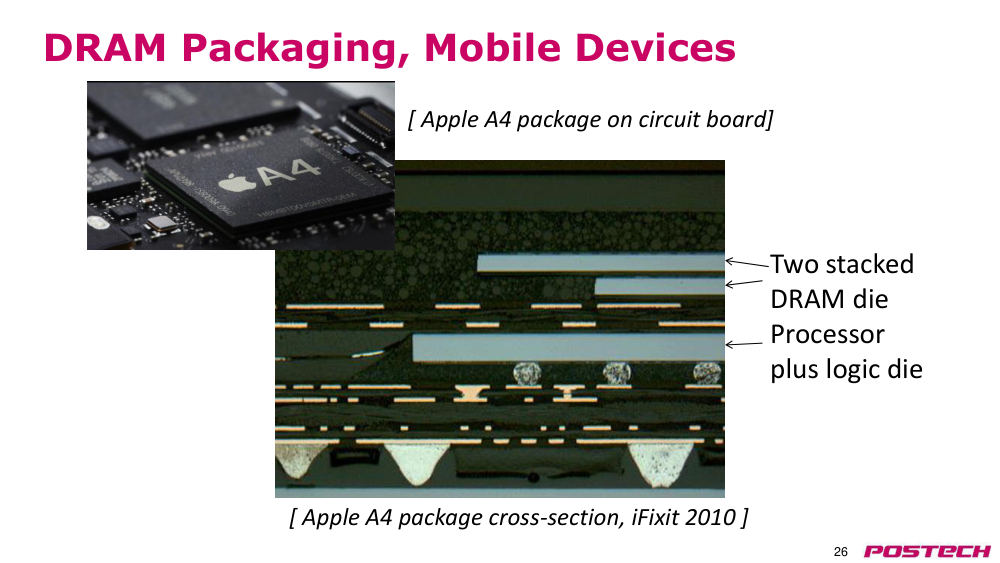
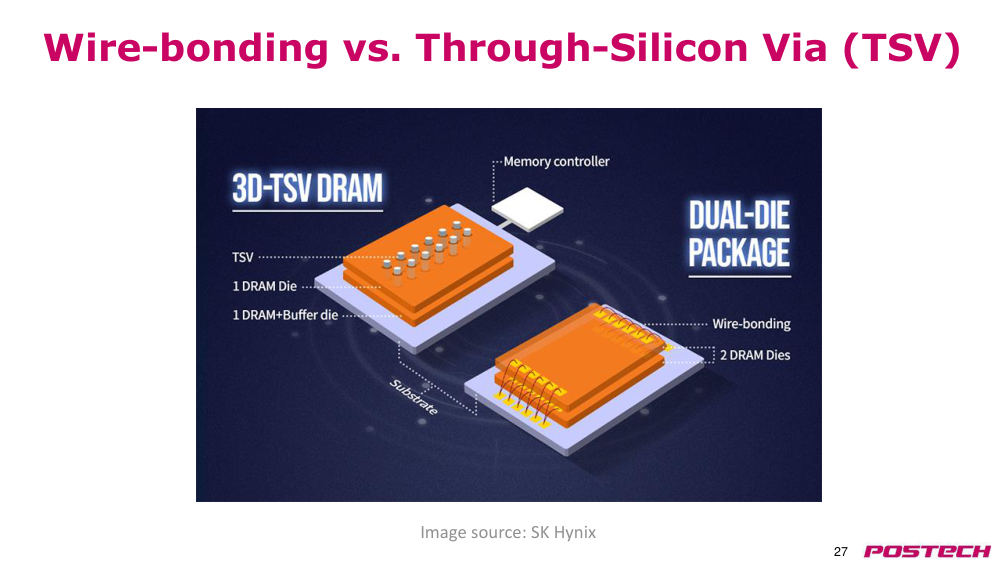
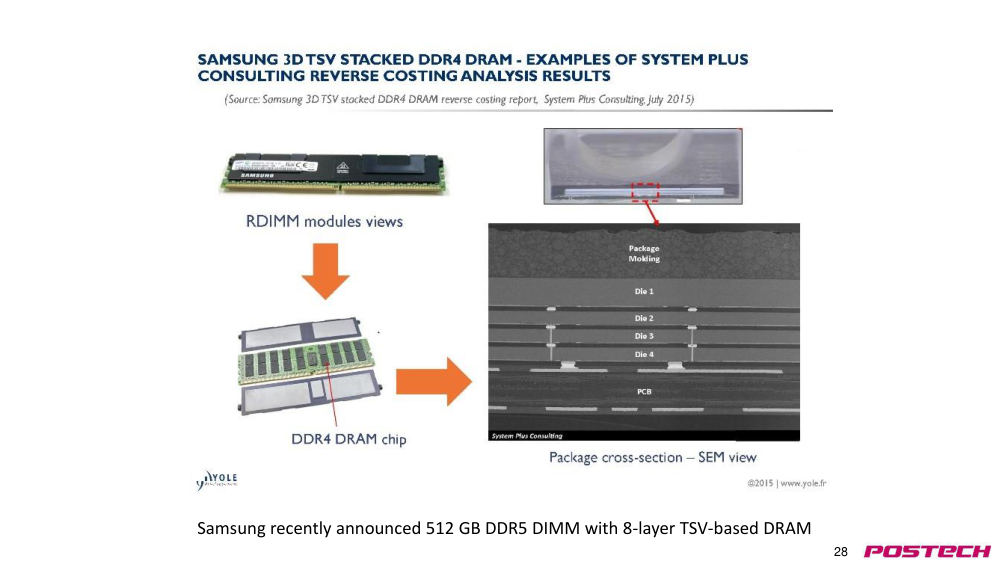
원인DIMM 은 여러 chip 을 lockstep 으로 묶어(clock·control·address 공유) 넓은 word 를 만듦. mobile AP 는 DRAM die 를 processor 위에 쌓고 가장자리 wire 로 연결하지만 wire 수가 제한됨.
해결TSV 로 die 를 관통 연결해 더 많은 signal·더 높은 밀도 확보. Samsung 은 8-layer TSV DRAM 으로 512GB DDR5 DIMM 발표(보통 server DIMM 16/32GB).
- Apple M1: package 내부 DRAM → energy 감소, 교체 불가
- TSV stacked DRAM 으로 DIMM 당 용량 증가
2.13.r.3Samsung Newsroom: Industry's First HKMG-Based DDR5 (2021) ↗ · 8-layer TSV 기반 512GB DDR5 module 발표 원문
2.141:03:19–1:10:40HBM 과 NVIDIA A100
상황·문제DIMM interface 로는 GPU 가 요구하는 memory bandwidth 를 못 맞춤.
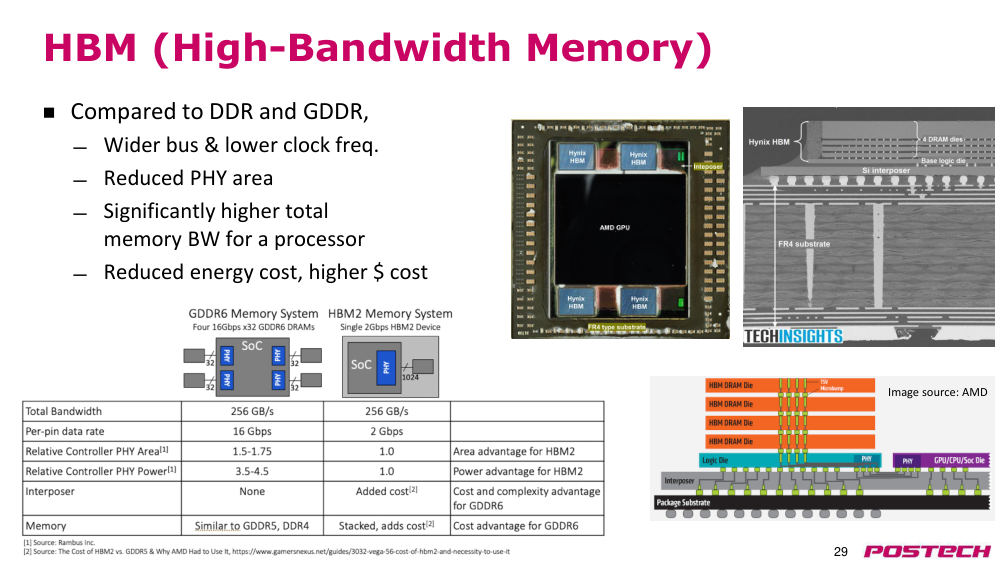
원인HBM 은 TSV 로 쌓은 DRAM 과 GPU 를 silicon interposer 위에 두고 작은 bump 로 1024-lane 의 넓은 bus 를 낮은 data rate 로 구동.
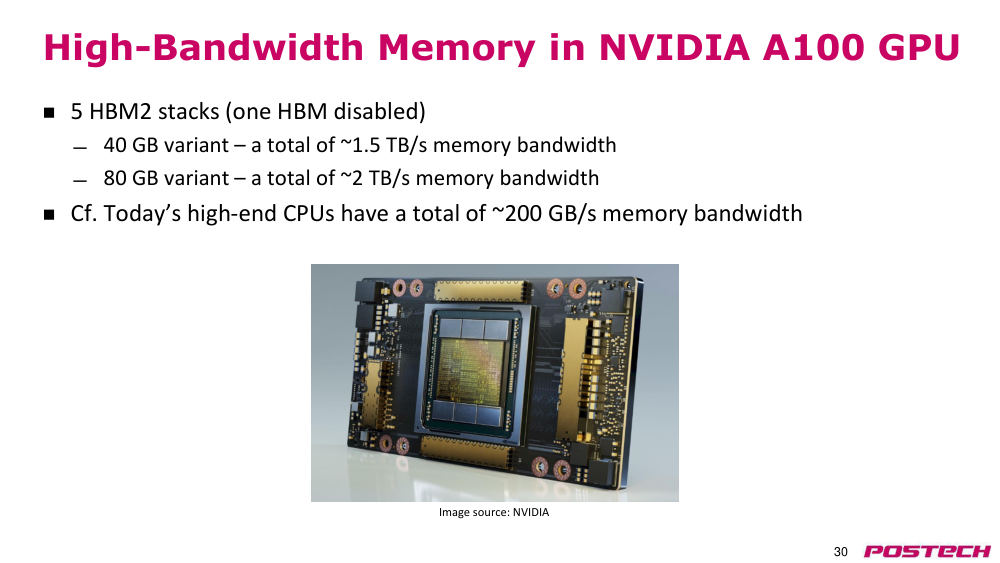
해결같은 256GB/s 에서 GDDR6 대비 PHY area·power 가 작음. 대신 interposer·stacking 비용과 yield 문제로 high-end 전용. A100 은 HBM2 5 stack 으로 ~1.5/~2TB/s.
- GDDR6 16Gbps/pin × 128-bit vs HBM2 2Gbps/pin × 1024-bit
- high-end CPU 는 총 ~200GB/s
2.151:10:40–1:14:01eDRAM cache (IBM z15)
상황·문제큰 last-level cache 를 SRAM 으로 만들기엔 용량 밀도가 부족.
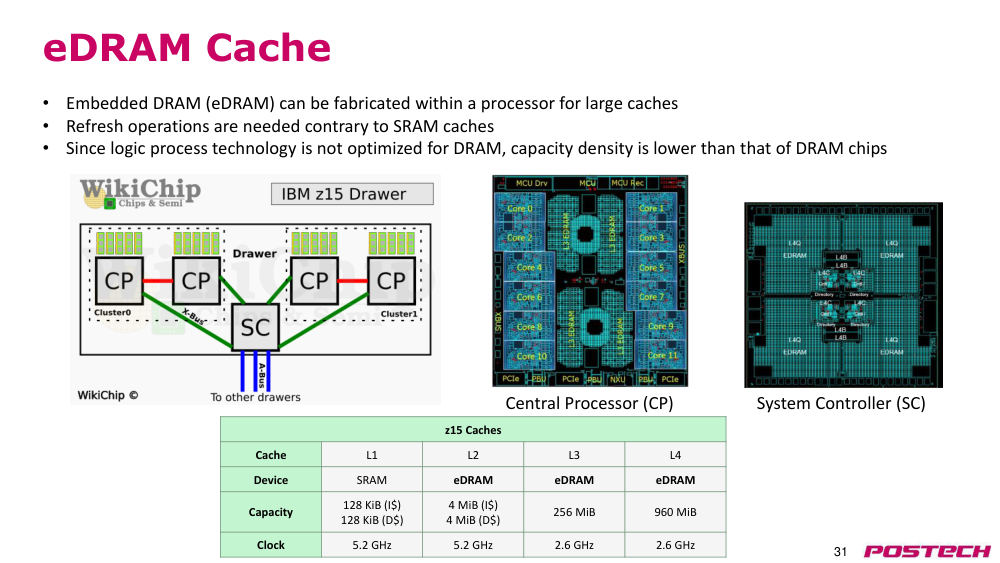
원인DRAM 은 SRAM 보다 밀도가 높아 processor 안에 eDRAM 으로 큰 cache 를 만들 수 있음. IBM z15 는 L2~L4 를 eDRAM 으로 구성(L4 960 MiB 는 SC chip).
해결단점: capacitor 누설로 주기적 refresh 필요, logic process 가 DRAM 에 최적화되지 않아 DRAM chip 보다 밀도가 낮음.
- z15 L2 = core 당 4+4 MiB eDRAM, L3 256 MiB
- SC(system controller) 가 drawer 내 CP 들을 연결
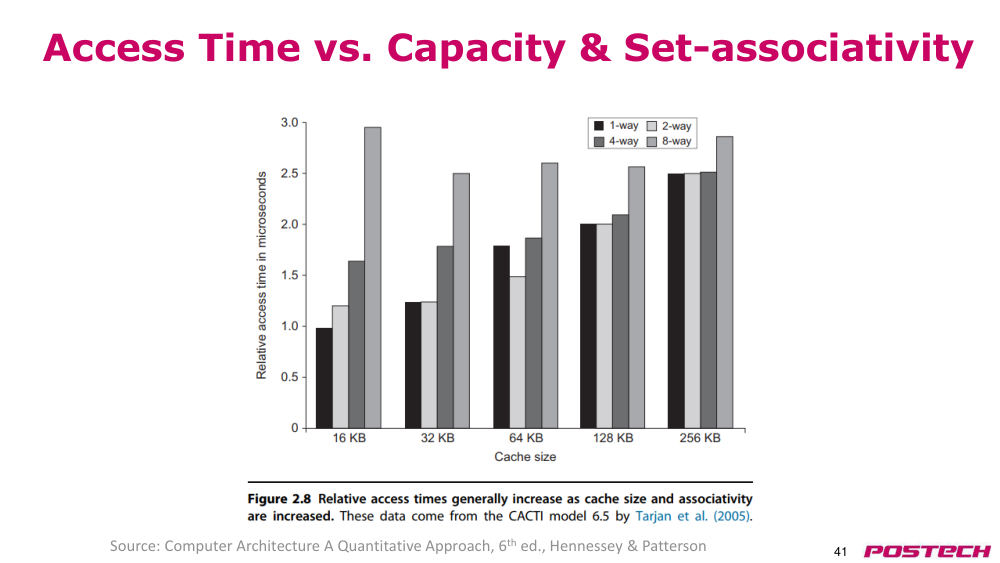
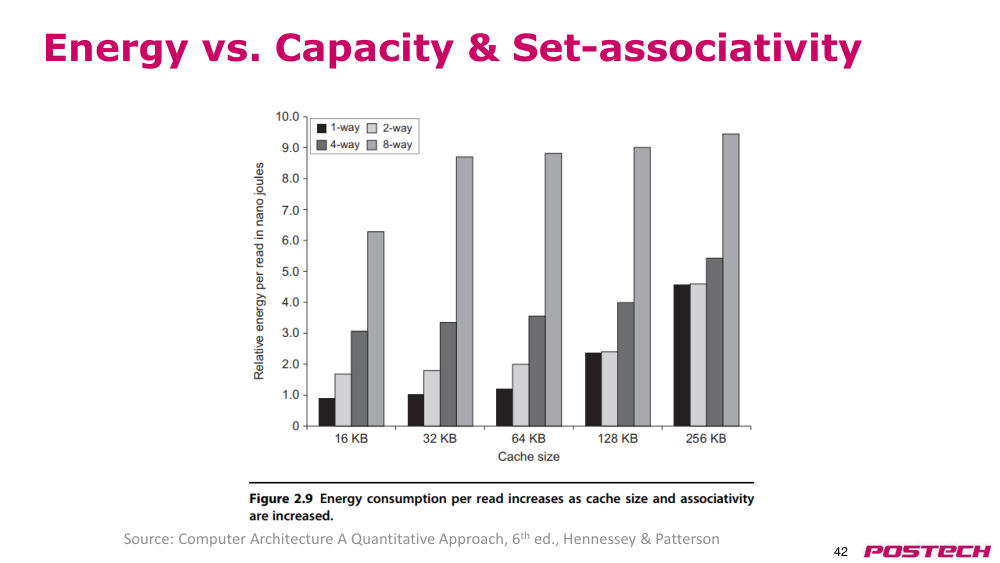
2.161:14:01–1:17:40Cache organization 복습과 set-associativity trade-off
상황·문제나머지(slide 32~45)는 학부 cache 내용 복습이라 각자 교재로 확인하도록 함.
원인set-associative cache 는 hit rate 를 높이지만 access time 이 늘고(작은 cache 에서 급증), energy 도 direct-mapped 보다 훨씬 큼.
해결cache hierarchy 설계 시 miss rate·latency·energy 를 함께 고려. 교재 2.1-2.2, Appendix B.1-B.6 읽기.
- 16KB direct-mapped 대비 상대 access time
- way 증가 → miss rate↓, hit·miss latency↑
2.16.r.1Computer Architecture: A Quantitative Approach, 6th ed. — Elsevier ↗ · 교재. 2.1-2.2 및 Appendix B.1-B.6 읽기 과제, slide 10·41·42 그림 출처
2.16.r.2Cache placement policies — Wikipedia ↗ · direct-mapped·set-associative·fully associative 와 tag/index/offset
3핵심 개념
3.1memory wall(메모리 벽)
processor 성능(연 60%)과 DRAM 성능(연 7%) 격차가 커져 memory 접근이 성능 bottleneck 이 되는 현상.
3.1.r.1Random-access memory § Memory wall — Wikipedia ↗ · processor-memory 성능 격차(memory wall) 개념 (RAM 문서의 절로 redirect)
3.2MPKI(misses per kilo instructions)
명령어 1000개당 cache miss 수. cache 크기에 따른 miss 추이 비교에 사용.
3.3bandwidth filter(대역폭 필터)
각 cache level 이 상위 level 요청을 걸러 하위로 가는 접근 수를 줄이는 역할.
3.3.r.1Moguls: a Model to Explore the Memory Hierarchy for Bandwidth Improvements (ISCA'11, PDF) ↗ · slide 9 그림 원 논문 (저자 페이지)
3.4temporal / spatial locality(시간적/공간적 지역성)
temporal: 같은 항목이 곧 재참조. spatial: 인접 주소가 곧 참조.
3.5core memory(코어 메모리)
ferrite core 자화 방향으로 bit 저장. destructive read, non-volatile, ~1µs.
3.61T1C DRAM cell
access transistor 1개 + capacitor. bit line 전압 변화를 sense amplifier 로 판독.
3.6.r.1Dynamic random-access memory — Wikipedia ↗ · 1T1C cell, sense amplifier, destructive read·refresh, trench/stacked capacitor
3.7row buffer(행 버퍼)
activate 된 row 를 보관하는 sense amplifier. 같은 row 의 column 을 반복 접근 가능.
3.7.r.1Dynamic random-access memory — Wikipedia ↗ · 1T1C cell, sense amplifier, destructive read·refresh, trench/stacked capacitor
3.8bank(뱅크) vs multi-port
multi-port 는 동시 접근 보장하지만 크고 느림. bank 는 작고 빠르지만 같은 bank 충돌 시 대기.
3.9TSV(through-silicon via)
silicon die 를 관통하는 수직 배선. stacked DRAM·HBM 의 die 간 연결.
3.10HBM(high bandwidth memory)
TSV stacked DRAM + silicon interposer. 넓은 bus·낮은 clock 으로 높은 bandwidth, 비용은 높음.
3.11eDRAM(embedded DRAM)
logic chip 안에 만든 DRAM. 큰 LLC 에 쓰지만 refresh 필요, 밀도는 DRAM chip 보다 낮음.
4스스로 확인
4.14-issue 3GHz CPU 에서 DRAM 접근 50ns 동안 몇 개의 명령어를 실행할 수 있나?
답
3GHz × 50ns = 150 cycle, × 4-issue = 600 명령어.
4.2memory 접근 명령어 비율이 m 일 때 CPI=1 을 위해 cycle 당 필요한 memory 참조 수는?
답
1+m (instruction fetch 1 + data 접근 m). m=0.2 면 1.2.
4.3L2 miss rate 가 L1 보다 낮다고 L2 가 더 많이 filter 한다고 볼 수 있나?
답
아니다. L2 요청은 L1 miss 에서만 오므로 분모가 다르다. 실제로는 L1 이 더 많이 filter 한다.
4.4DRAM 을 여러 bank 로 나누는 이유와 multi-port 대비 단점은?
답
한 array 는 한 번에 한 row 만 접근하므로 동시 접근을 위해 bank 를 둔다. 같은 bank 에 요청이 겹치면 대기한다.
4.5HBM 이 GDDR 대비 넓은 bus 를 쓸 수 있는 이유와 대가는?
답
silicon interposer 의 작은 bump 로 많은 배선 가능. interposer·stacking 비용과 yield 손실로 비싸다.
4.6eDRAM cache 의 두 가지 단점은?
답
refresh 가 필요하고, logic process 라 DRAM chip 보다 capacity density 가 낮다.
5참고 자료
5.1Computer Architecture: A Quantitative Approach, 6th ed. — Elsevier ↗ · 교재. 2.1-2.2 및 Appendix B.1-B.6 읽기 과제, slide 10·41·42 그림 출처
5.4Dynamic random-access memory — Wikipedia ↗ · 1T1C cell, sense amplifier, destructive read·refresh, trench/stacked capacitor