이 자료를 쓰는 강의: 03 Memory hierarchy 개요와 memory 기술
Lec3 - MemoryHierarchy
한국어판 강의자료 · 46쪽
p.1memory hierarchy(메모리 계층 구조) 개요
p.2행정사항 – 프로젝트 주제
- 9/15까지 프로젝트 주제를 선택하고 이메일로 강사에게 알리기
- 기여도와 투입해야 할 작업량을 고려하기
- 프로젝트 일정과 평가를 위한 도구 선택에 대해 대략적인 아이디어를 가져오기
- 프로젝트 제안서는 9/24(금)까지 제출하기
- 가이드라인은 9/15까지 공지될 예정
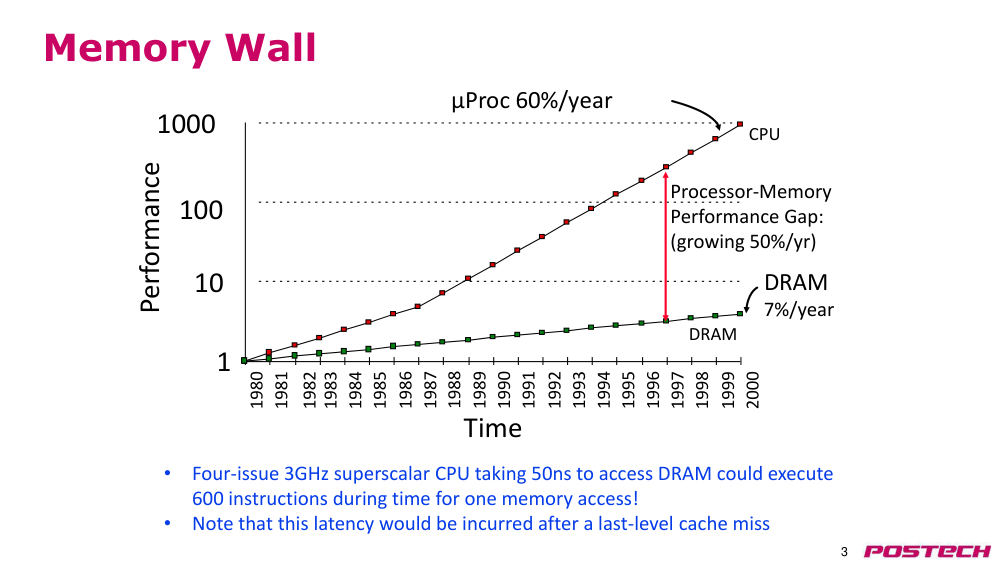
p.3memory wall(메모리 벽)
- 시간
- 프로세서 성능 증가율: 연간 60%
- DRAM 성능 증가율: 연간 7%
- 1
- 10
- 100
- 1000
- 1980
- 1981
- 1983
- 1984
- 1985
- 1986
- 1987
- 1988
- 1989
- 1990
- 1991
- 1992
- 1993
- 1994
- 1995
- 1996
- 1997
- 1998
- 1999
- 2000
- DRAM
- CPU
- Processor-Memory performance gap(프로세서-메모리 성능 격차): 연간 50% 증가
- 성능
- • 3GHz 4-issue superscalar(슈퍼스칼라) CPU가 DRAM에 접근하는 데 50ns가 걸릴 경우, 한 memory access time(메모리 접근 시간) 동안 600개의 명령어를 실행할 수 있음!
- • 이 latency(지연 시간)은 마지막 레벨 cache miss(캐시 미스) 이후 발생함
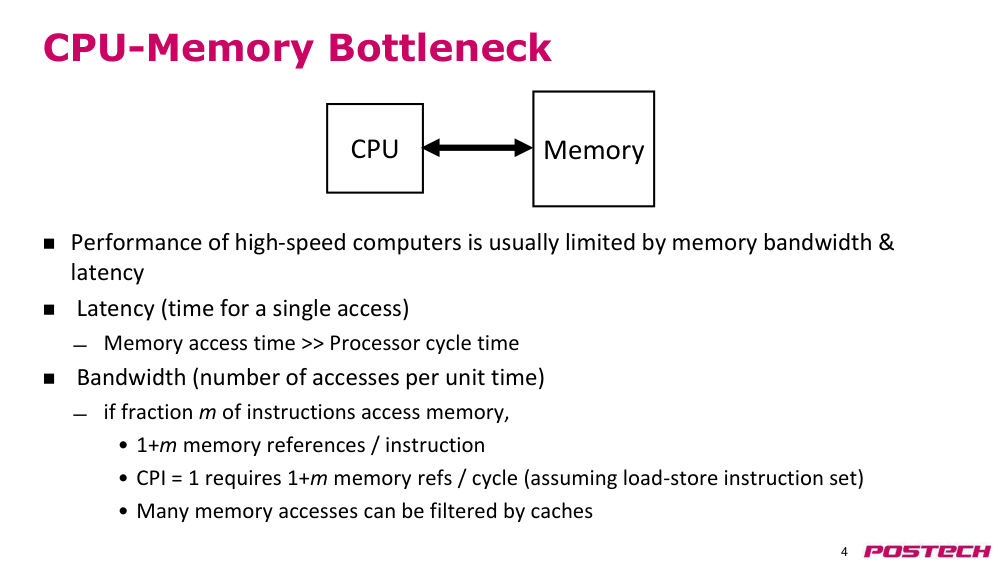
p.4프로세서-메모리 병목 현상
- 고속 컴퓨터의 성능은 일반적으로 memory bandwidth(메모리 대역폭)과 latency(지연 시간)에 의해 제한됨
- • 지연 시간(단일 접근에 소요되는 시간)
- memory access time(메모리 접근 시간) >> 프로세서 사이클 시간
- • 대역폭(단위 시간당 접근 횟수)
- 메모리 접근을 하는 명령어 비율이 m일 경우
- • 명령어당 1+m회의 메모리 참조
- • CPI = 1일 경우, 사이클당 1+m회의 메모리 참조 필요 (로드-스토어 명령어 집합을 가정)
- • 많은 메모리 접근은 캐시를 통해 필터링될 수 있음
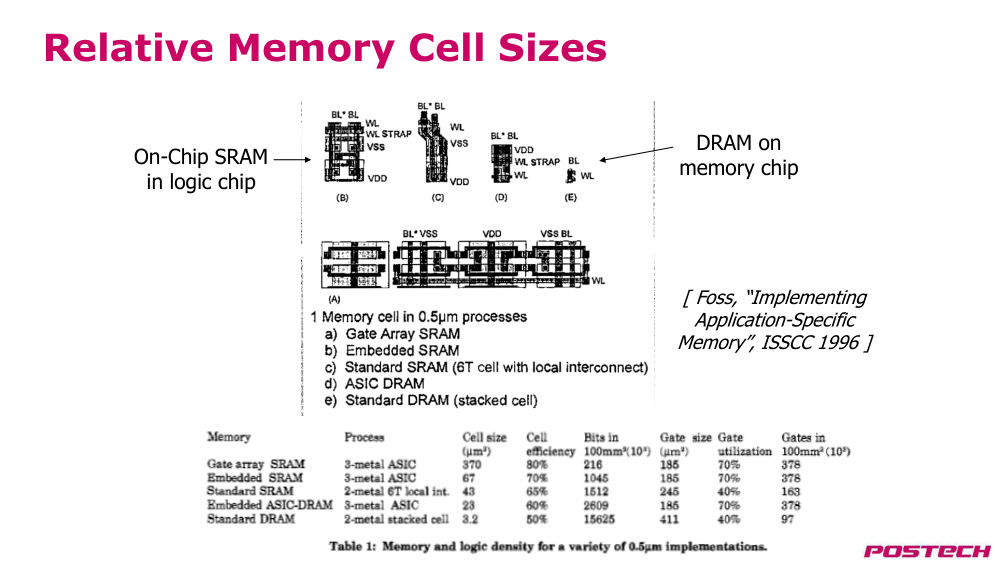
p.5memory cell(메모리 셀)의 상대적 크기
- [Foss, “Implementing Application-Specific Memory”, ISSCC 1996]
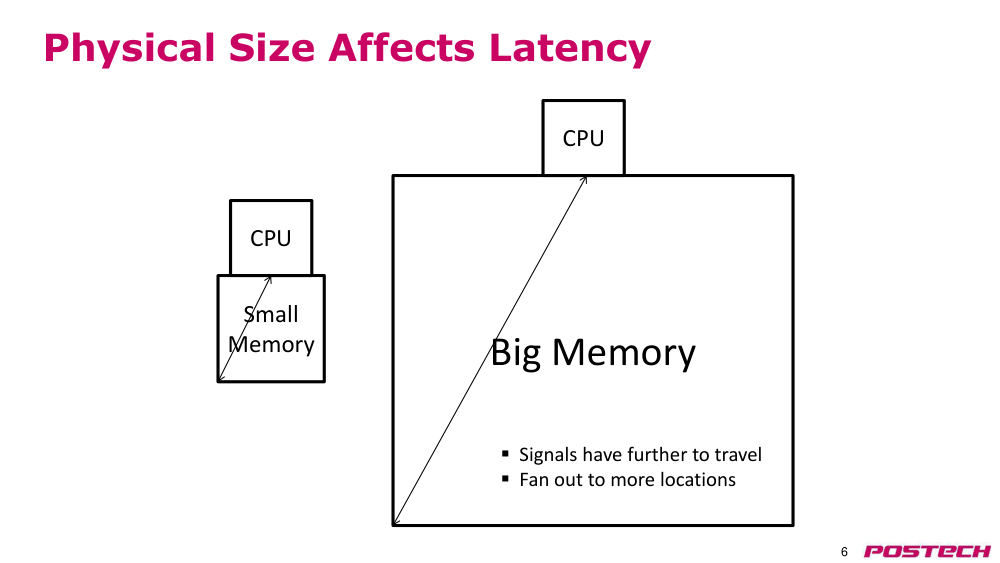
p.6물리적 크기가 latency(지연 시간)에 영향을 미침
- 작은 메모리
- CPU
- 큰 메모리
- CPU
- • 신호가 더 멀리 이동해야 함
- • 더 많은 위치로 팬아웃됨
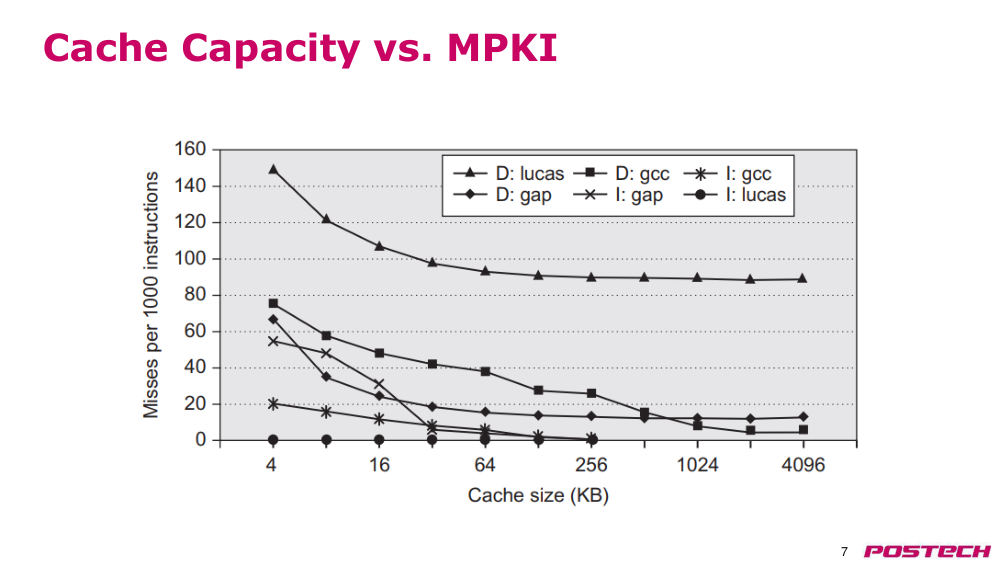
p.7캐시 용량 vs. MPKI
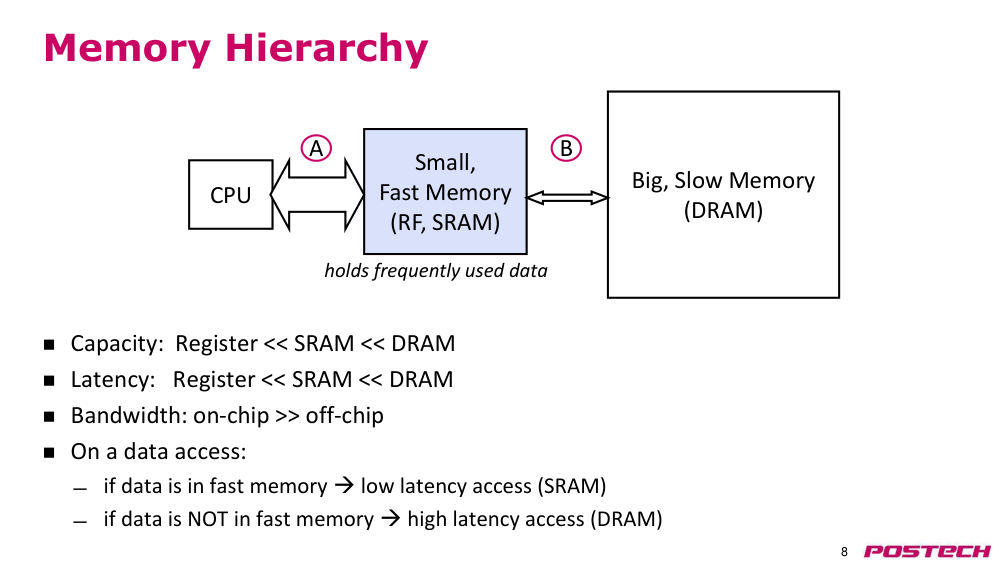
p.8memory hierarchy(메모리 계층 구조)
- 용량: 레지스터 << SRAM << DRAM
- latency(지연 시간): 레지스터 << SRAM << DRAM
- bandwidth(대역폭): 온칩 >> 오프칩
- 데이터 접근 시:
- • 데이터가 빠른 메모리에 있으면 → 낮은 latency(지연 시간) 접근 (SRAM)
- • 데이터가 빠른 메모리에 없으면 → 높은 latency(지연 시간) 접근 (DRAM)
- 작고 빠른 메모리 (RF, SRAM)
- CPU
- 크고 느린 메모리 (DRAM)
- A
- B
- 자주 사용되는 데이터를 보유
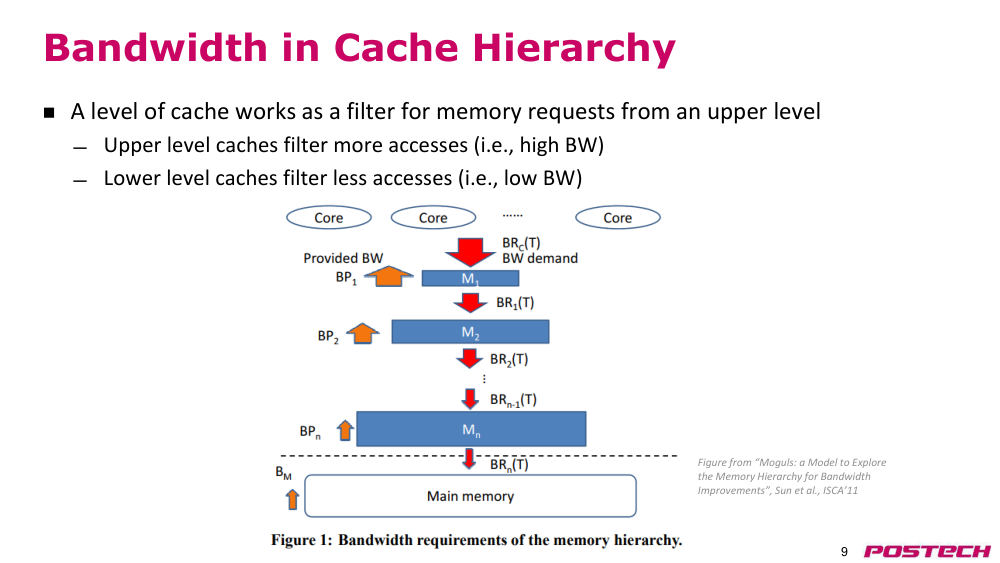
p.9cache hierarchy(캐시 계층 구조)에서의 bandwidth(대역폭)
- 캐시의 한 수준은 상위 수준의 메모리 요청에 대해 필터 역할을 함
- 상위 수준 캐시는 더 많은 접근을 필터링함 (즉, 높은 대역폭)
- 하위 수준 캐시는 덜 많은 접근을 필터링함 (즉, 낮은 대역폭)
- 출처: “Moguls: a Model to Explore the Memory Hierarchy for Bandwidth Improvements”, Sun et al., ISCA’11
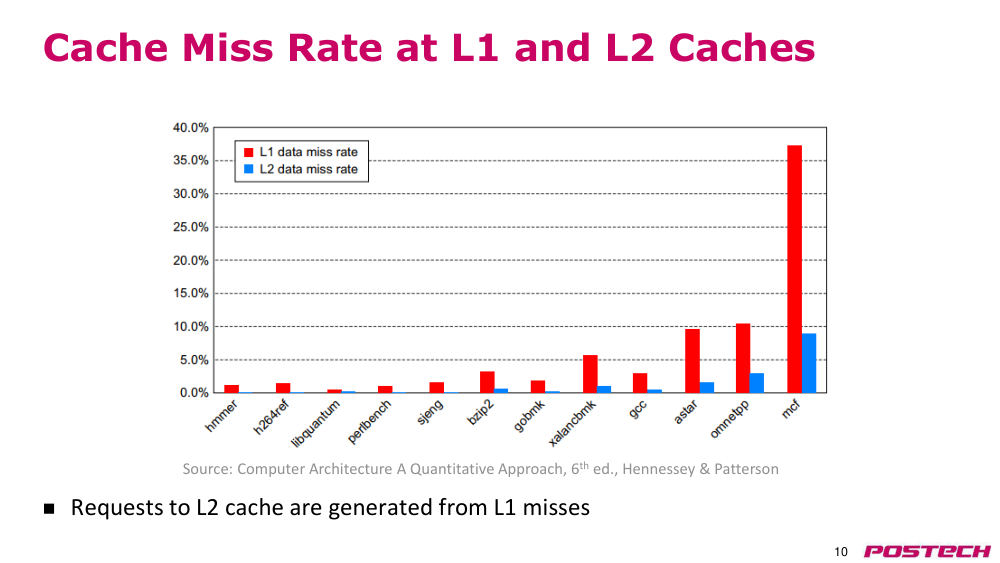
p.10L1 및 L2 캐시에서의 cache miss rate(캐시 미스 비율)
- L2 캐시로의 요청은 L1 미스에서 발생함
- 출처: Computer Architecture A Quantitative Approach, 6th ed., Hennessey & Patterson
p.11memory hierarchy(메모리 계층 구조)의 관리
- 작고 빠른 저장소, 예: 레지스터
- • 주소는 일반적으로 명령어에서 지정됨
- • 일반적으로 register file(레지스터 파일)로 직접 구현됨
- • 하지만 하드웨어가 소프트웨어의 뒤에서 일어나는 일도 가능함, 예: 레지스터 이름 변경, 스택 기계에서 스택 관리
- 더 크고 느린 저장소, 예: 주 메모리
- • 주소는 일반적으로 레지스터의 값에서 계산됨
- • 일반적으로 하드웨어 관리 cache hierarchy(캐시 계층 구조)로 구현됨 (하드웨어가 빠른 메모리에 무엇을 유지할지 결정함)
- • 하지만 소프트웨어가 "힌트"를 제공할 수 있음, 예: 캐시하지 않거나 prefetch(프리패치)하지 않음
p.12복습: principle of locality(지역성 원리)
- principle of locality(지역성 원리)
- • 프로그램은 어느 순간에도 주소 공간의 상대적으로 작은 부분만 접근함
- 두 가지 다른 유형의 지역성
- • 시간적 지역성 (시간 내 지역성): 항목이 참조되면, 곧 다시 참조될 가능성이 높음 (예: 반복문, 재사용)
- • 공간적 지역성 (공간 내 지역성): 항목이 참조되면, 주소가 가까운 항목들도 곧 참조될 가능성이 높음 (예: 직선 코드, 배열의 순차적 접근)
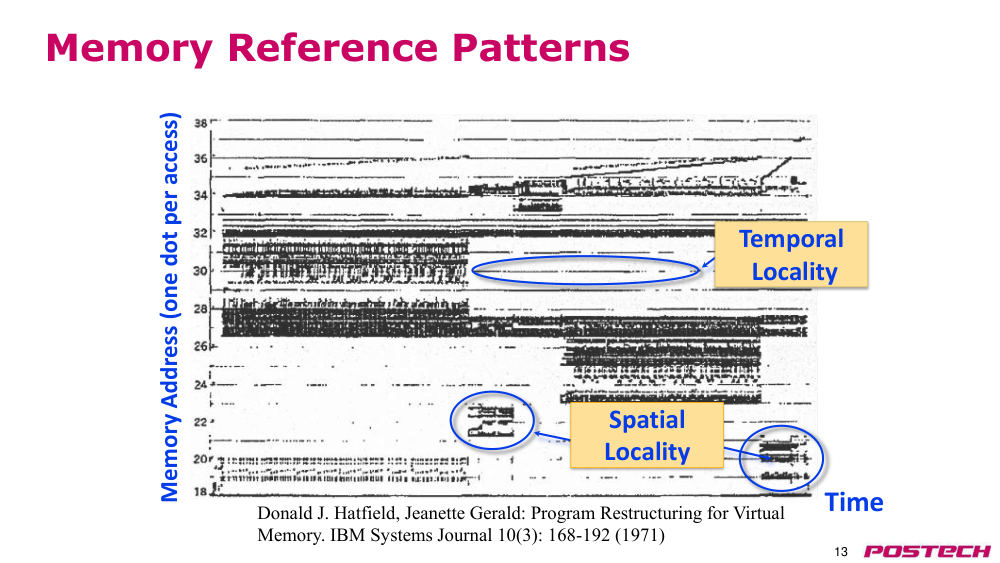
p.13memory reference pattern(메모리 참조 패턴)
- Donald J. Hatfield, Jeanette Gerald: Program Restructuring for Virtual Memory. IBM Systems Journal 10(3): 168-192 (1971)
- 메모리 주소 (각 접근마다 점 하나)
- spatial locality(공간적 지역성)
- temporal locality(시간적 지역성)
- 시간
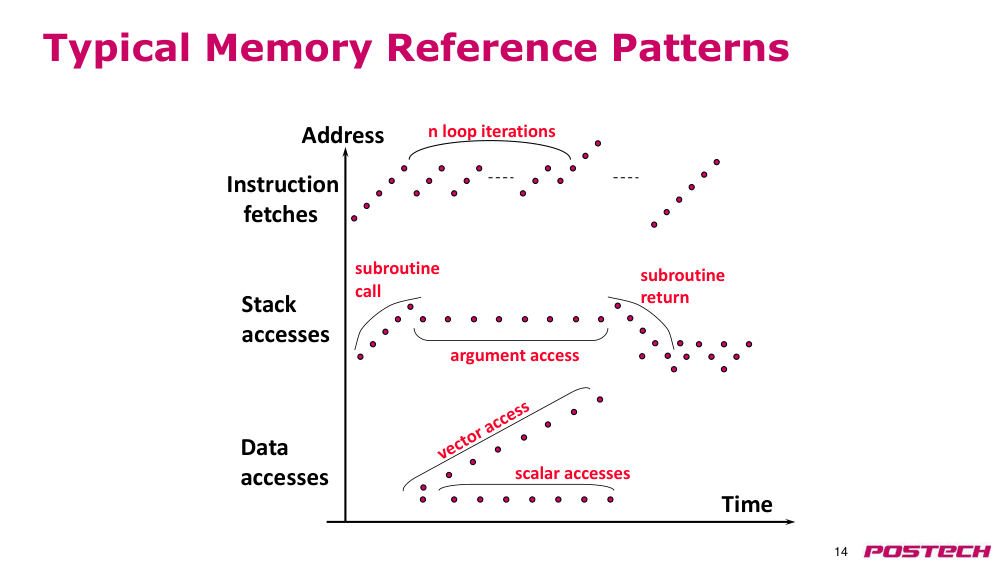
p.14일반적인 memory reference pattern(메모리 참조 패턴)
- 주소
- 시간
- 명령어 가져오기
- stack access(스택 접근)
- 데이터 접근
- n번 반복
- 서브루틴 호출
- 서브루틴 반환
- 인자 접근
- 스칼라 접근
p.15memory technology(메모리 기술)
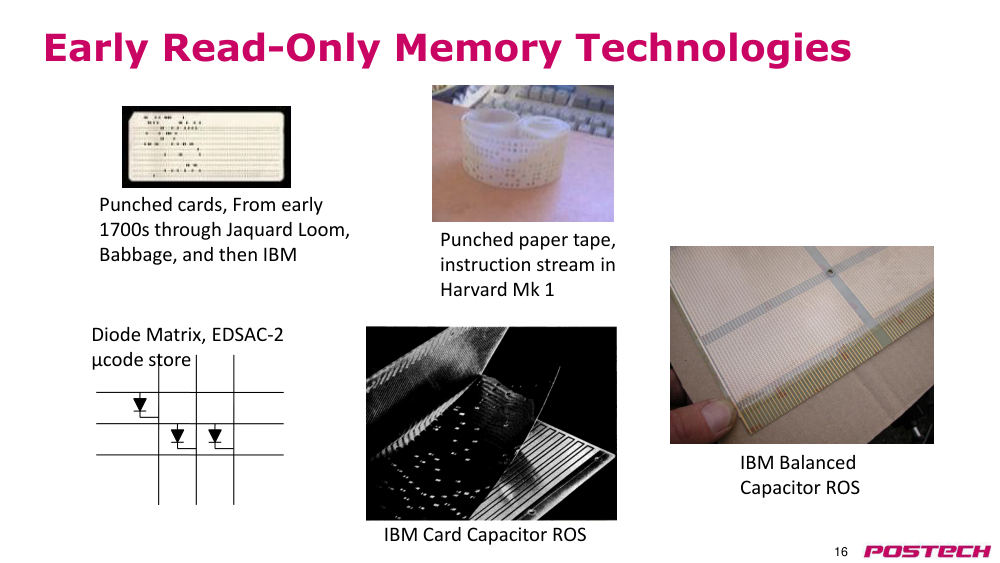
p.16초기 읽기 전용 memory technology(메모리 기술)
- 구멍 뚫린 카드, 1700년대 초부터 Jacquard Loom, Babbage, 그리고 IBM
- 구멍 뚫린 종이 테이프, Harvard Mk 1의 instruction stream(명령어 스트림)
- IBM Card Capacitor ROS
- IBM Balanced Capacitor ROS
- 다이오드 매트릭스, EDSAC-2 마이크로코드 저장소
p.17초기 읽기/쓰기 주 memory technology(메모리 기술)
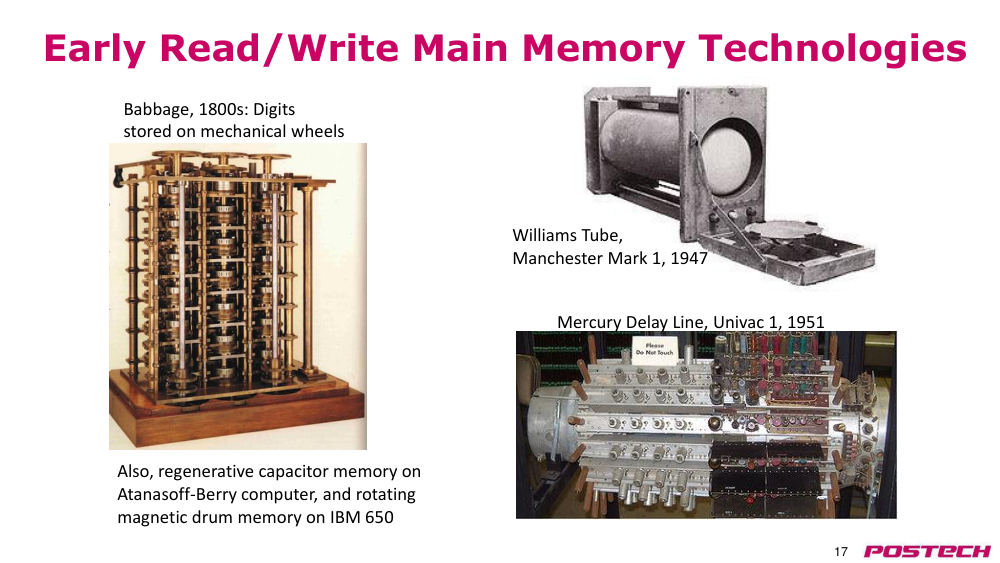
- Williams Tube, Manchester Mark 1, 1947
- Babbage, 1800년대: 기계적 휠에 숫자 저장
- Mercury Delay Line, Univac 1, 1951
- 또한 Atanasoff-Berry computer의 regenerative capacitor memory(재생 캐패시터 메모리), IBM 650의 rotating magnetic drum memory(회전 자성 드럼 메모리)
p.18MIT Whirlwind core memory(코어 메모리)
p.19core memory(코어 메모리)
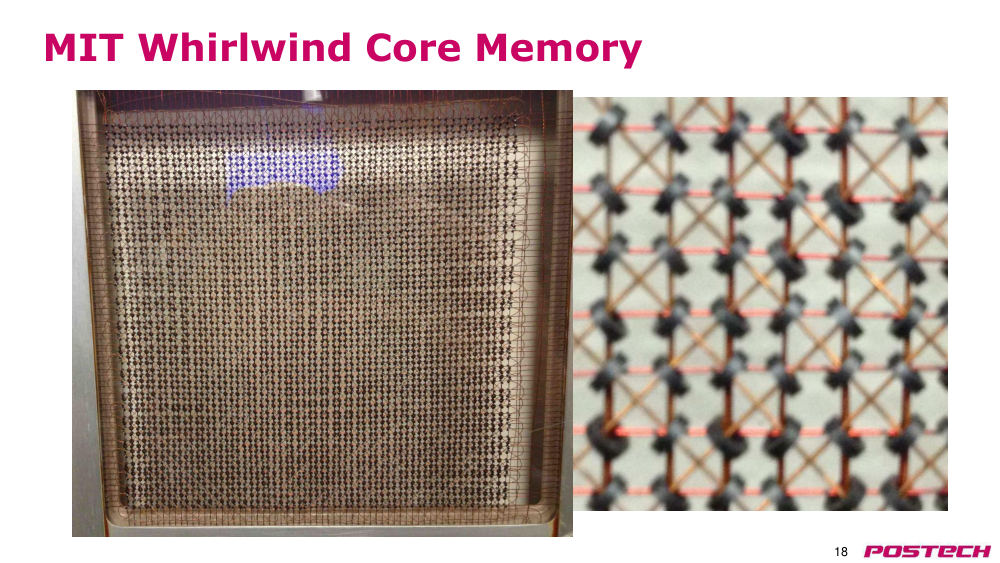
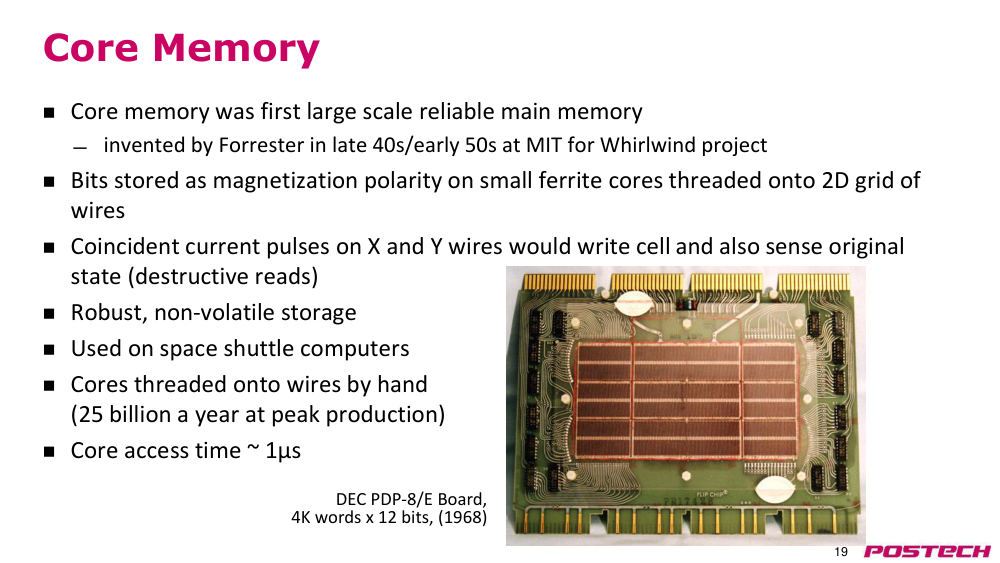
- core memory(코어 메모리)는 Forrester가 1940년대 후반~1950년대 초에 MIT에서 Whirlwind 프로젝트를 위해 개발한 최초의 대규모 신뢰성 있는 main memory(주기억장치)였다.
- 비트는 2차원 와이어 그리드에 끼워진 작은 ferrite core(페라이트 코어)의 자화 방향에 저장된다.
- X와 Y 와이어에 동시에 전류 펄스를 가하면 셀에 쓰기 작업을 수행할 수 있으며, 원래 상태도 감지할 수 있다(파괴적 읽기).
- 강건하고 비휘발성 저장 장치이다.
- 우주 셔틀 컴퓨터에도 사용되었다.
- 코어는 손으로 와이어에 끼워졌다 (정점 생산 시 1년에 250억 개).
- 코어 접근 시간은 약 1µs이다.
- DEC PDP-8/E board(보드), 4K word(워드) × 12비트 (1968)
p.20반도체 메모리
- 반도체 메모리는 1970년대 초반부터 경쟁력 있게 되기 시작했다.
- Intel은 반도체 메모리 시장을 활용하기 위해 설립되었다.
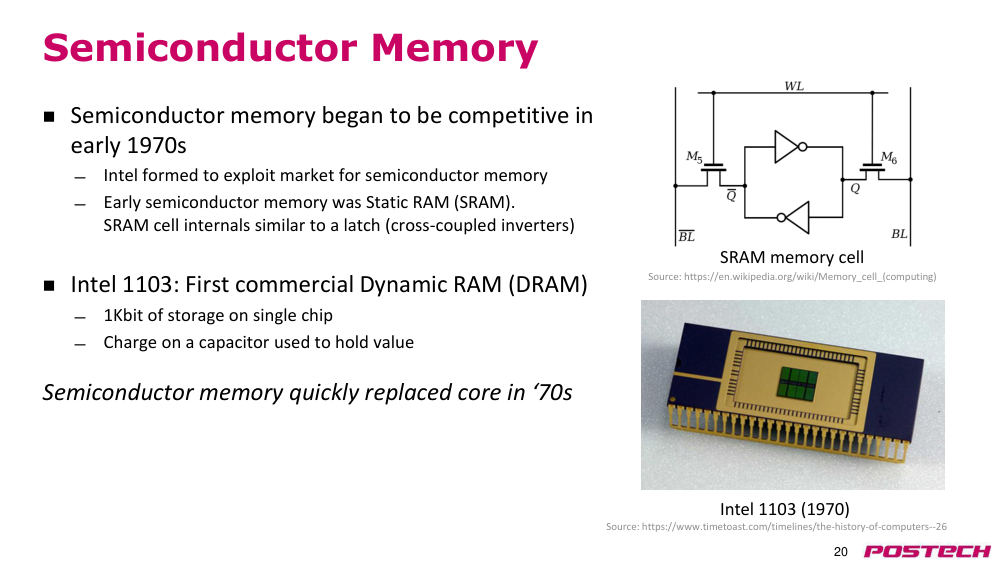
- 초기 반도체 메모리는 static RAM(SRAM, 정적 랜덤 액세스 메모리)였다. SRAM 셀 내부 구조는 래치와 유사하다(교차 연결된 인버터).
- Intel 1103: 최초의 상용 dynamic RAM(DRAM, 동적 랜덤 액세스 메모리).
- 단일 칩에 1K비트의 저장 용량을 가졌다.
- capacitor(캐패시터)의 전하를 이용해 값을 저장한다.
- 반도체 메모리는 1970년대에 core memory(코어 메모리)를 빠르게 대체했다.
- 출처: https://en.wikipedia.org/wiki/Memory_cell_(computing)
- SRAM memory cell(메모리 셀)
- Intel 1103 (1970)
- 출처: https://www.timetoast.com/timelines/the-history-of-computers--26
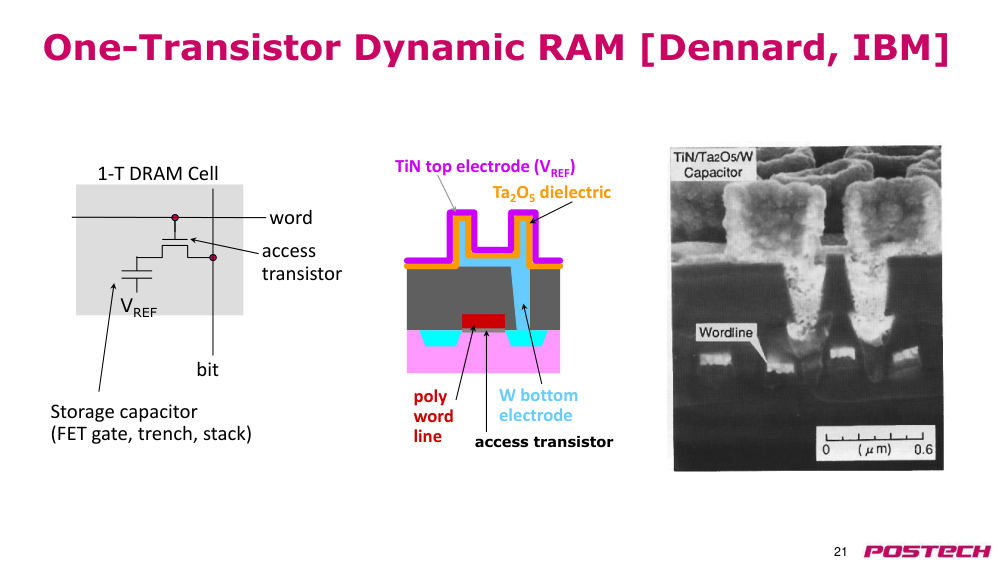
p.21단일 트랜지스터 DRAM(동적 랜덤 액세스 메모리)
- [Dennard, IBM]
- TiN 상전극 (VREF)
- Ta2O5 절연체
- W 하전극
- 폴리 word line(워드 라인)
- 액세스 트랜지스터
- 1-T DRAM 셀
- 워드 비트 액세스 트랜지스터
- 저장 캐패시터 (FET 게이트, 터널, 스택)
- VREF
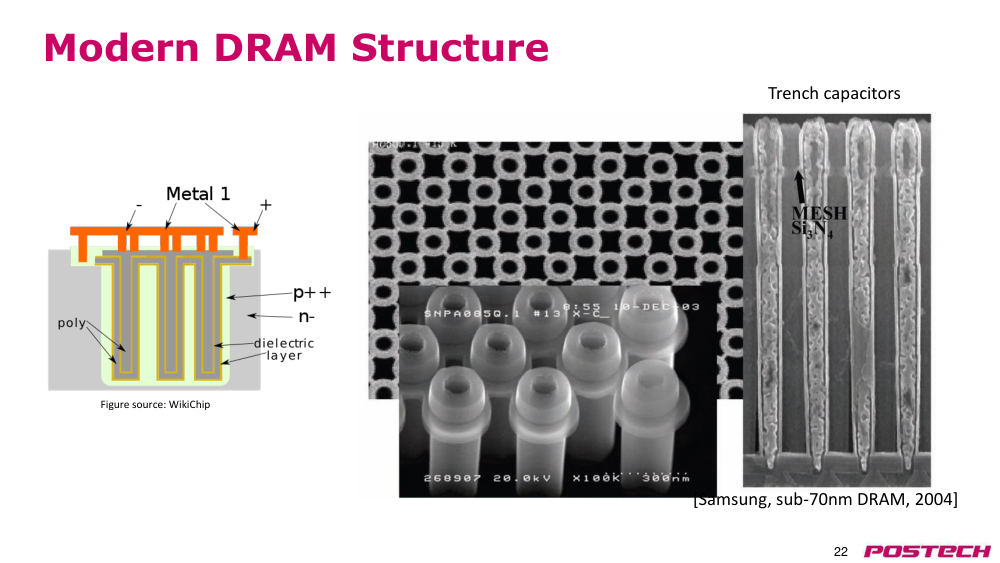
p.22현대 DRAM 구조
- [Samsung, 70nm 미만 DRAM, 2004]
- trench capacitor(트렌치 캐패시터)
- 도면 출처: WikiChip
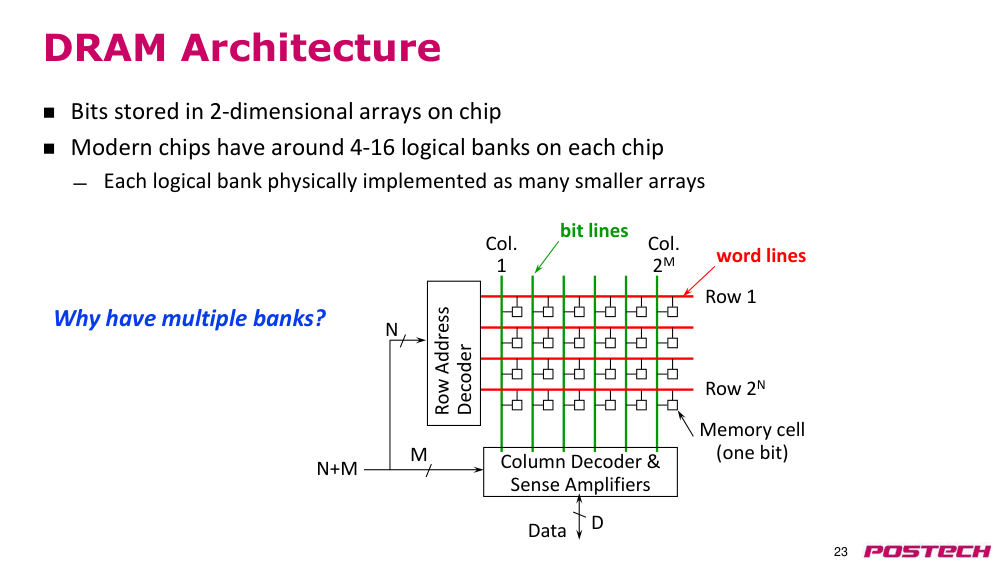
p.23DRAM 아키텍처
- 비트는 칩 위의 2차원 배열에 저장된다.
- 현대 칩은 각 칩당 약 4~16개의 logical bank(논리적 뱅크)를 가진다.
- 각 logical bank(논리적 뱅크)는 여러 개의 더 작은 배열로 물리적으로 구현된다.
- 행 주소 디코더
- 열 1
- 열 2M
- 행 1
- 행 2N
- column decoder(열 디코더) 및 sense amplifier(센스 증폭기)
- M
- N
- N+M bit line(비트 라인)
- word line(워드 라인)
- 메모리 셀 (1비트)
- D 데이터
- 왜 여러 bank(뱅크)를 사용하는가?
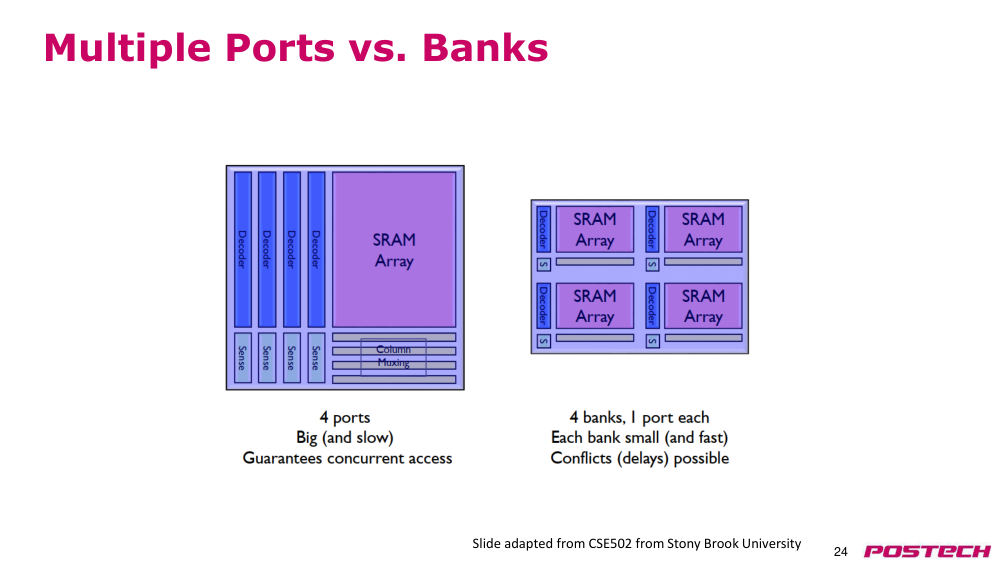
p.24multiple ports(다중 포트) vs. banks(뱅크)
- 슬라이드는 Stony Brook University의 CSE502 강의 자료를 개조함
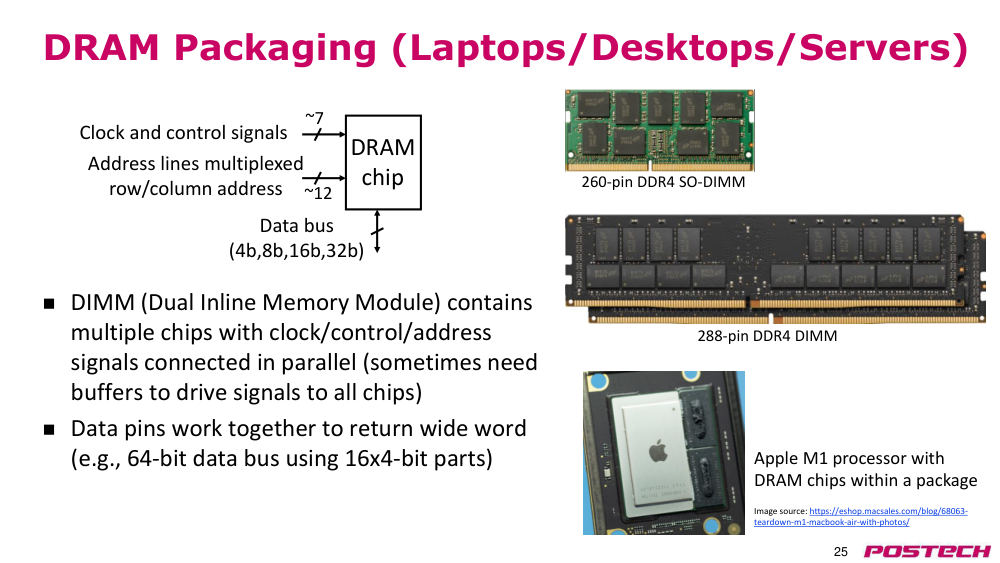
p.25DRAM 패키징 (노트북/데스크톱/서버)
- DIMM (이중 인라인 메모리 모듈)은 클럭/제어/주소 신호가 병렬로 연결된 여러 개의 칩을 포함한다 (때로는 모든 칩에 신호를 전달하기 위해 버퍼가 필요하다).
- 데이터 핀은 함께 작동하여 넓은 워드를 반환한다 (예: 16x4비트 부품을 사용한 64비트 데이터 버스).
- 주소 라인은 행/열 주소로 멀티플렉싱된다.
- 클럭 및 제어 신호
- 데이터 버스 (4비트, 8비트, 16비트, 32비트)
- DRAM 칩
- 약 12
- 약 7
- 이미지 출처: https://eshop.macsales.com/blog/68063-teardown-m1-macbook-air-with-photos/
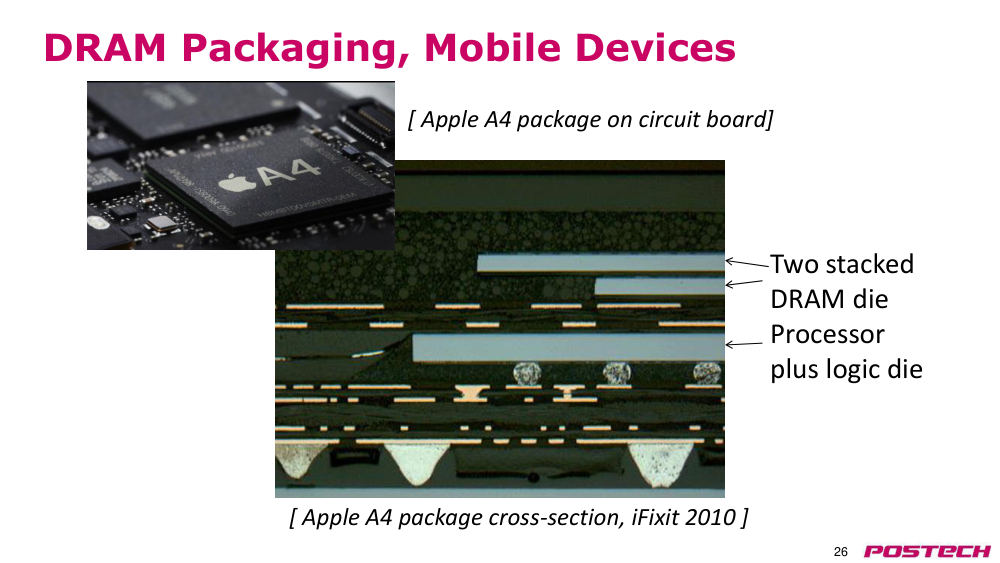
p.26DRAM 패키징, 모바일 장치
- [Apple A4 패키지 단면도, iFixit 2010]
- 두 개의 스택된 DRAM 다이
- 프로세서 및 로직 다이
- [Apple A4 패키지 회로 기판 위에]
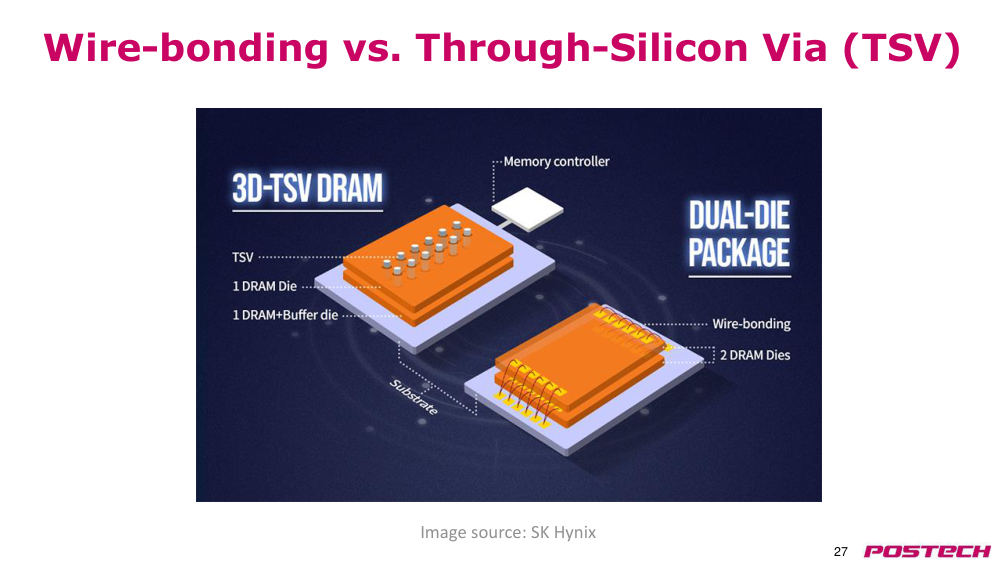
p.27wire bonding(와이어 본딩) vs. through-silicon via(실리콘 관통 비아, TSV)
- 이미지 출처: SK Hynix
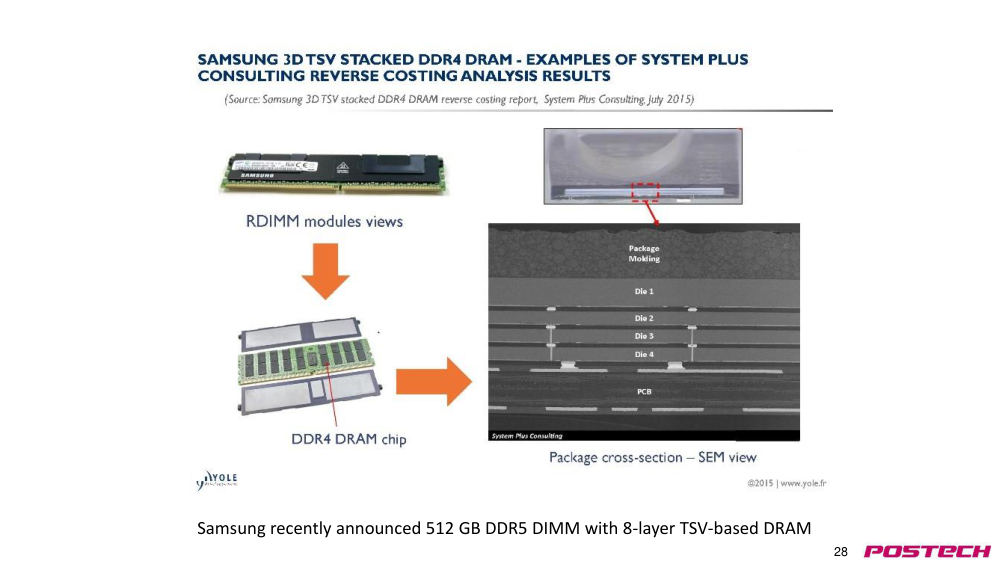
p.28Samsung, 최근 512GB DDR5 DIMM 발표 – 8층 TSV 기반 DRAM
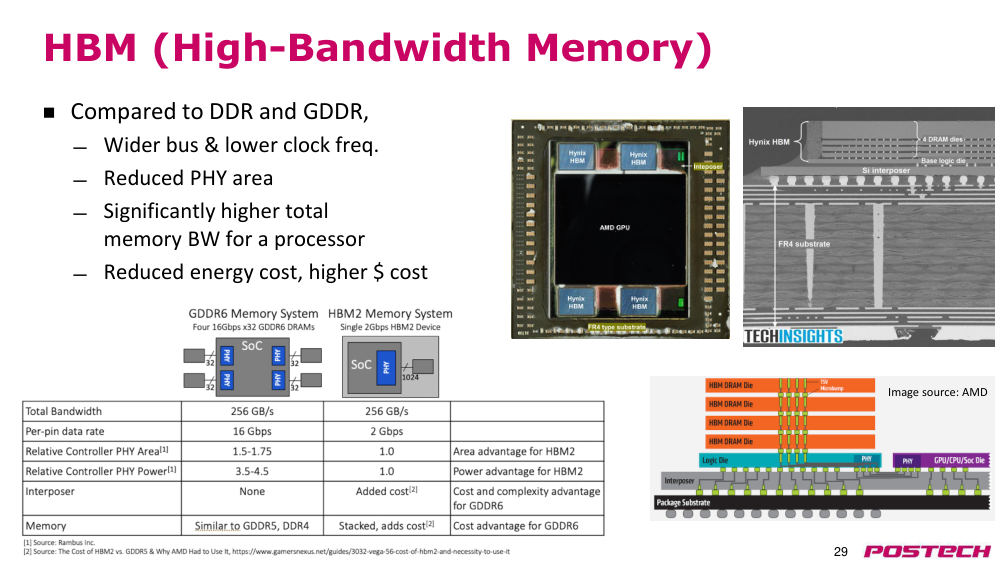
p.29HBM (고대역폭 메모리)
- DDR 및 GDDR와 비교하여
- 더 넓은 버스 및 더 낮은 클럭 주파수
- PHY 영역 감소
- 프로세서에 대해 상당히 높은 전체 memory bandwidth(메모리 대역폭) 제공
- 에너지 비용 감소, 가격 비용 증가
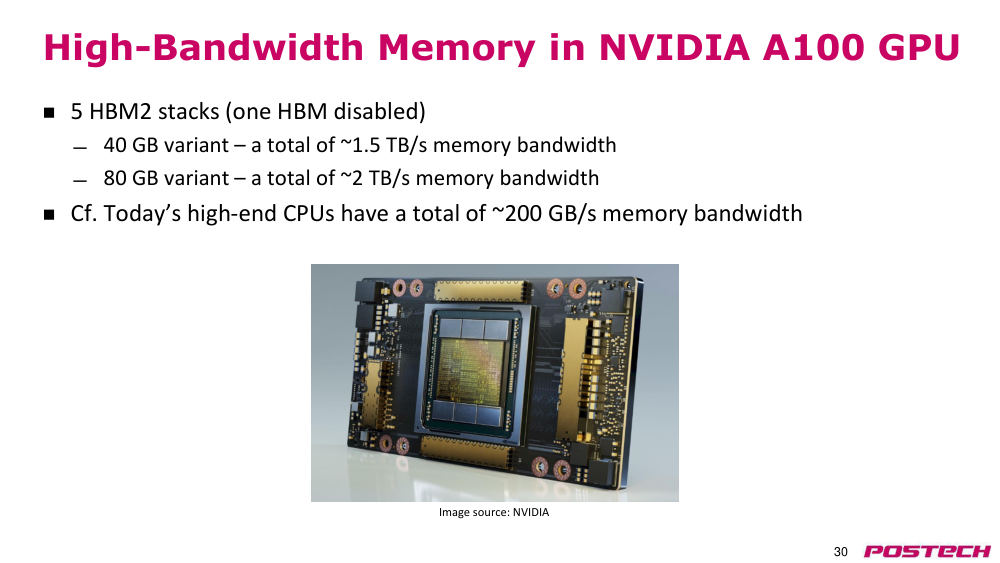
p.30NVIDIA A100 GPU 내 HBM(고대역폭 메모리)
- 5개의 HBM2 스택 (하나는 비활성화됨)
- 40GB 버전 – 총 약 1.5TB/s memory bandwidth(메모리 대역폭)
- 80GB 버전 – 총 약 2TB/s memory bandwidth(메모리 대역폭)
- 비교: 현재 고성능 CPU는 총 약 200GB/s memory bandwidth(메모리 대역폭)을 가짐
- 이미지 출처: NVIDIA
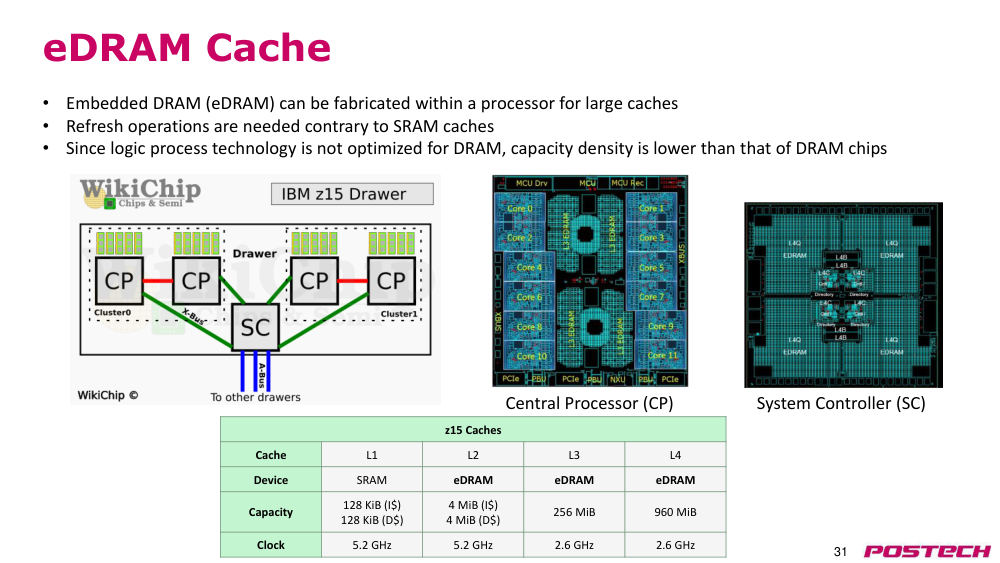
p.31eDRAM 캐시
- z15 캐시
- 캐시
- L1
- L2
- L3
- L4
- 장치
- SRAM
- eDRAM
- eDRAM
- eDRAM
- 용량
- 128 KiB (I$)
- 128 KiB (D$)
- 4 MiB (I$)
- 4 MiB (D$)
- 256 MiB
- 960 MiB
- 클록
- 5.2 GHz
- 5.2 GHz
- 2.6 GHz
- 2.6 GHz
- 중앙 프로세서 (CP)
- 시스템 컨트롤러 (SC)
- 임베디드 동적 랜덤 액세스 메모리 (eDRAM)는 대용량 캐시를 위해 프로세서 내부에서 제조될 수 있다
- SRAM 캐시와는 달리 refresh operation(리프레시 연산)이 필요하다
- 논리 공정 기술이 DRAM에 최적화되어 있지 않기 때문에, DRAM 칩에 비해 용량 밀도가 낮다
p.32캐시 구성 (복습)
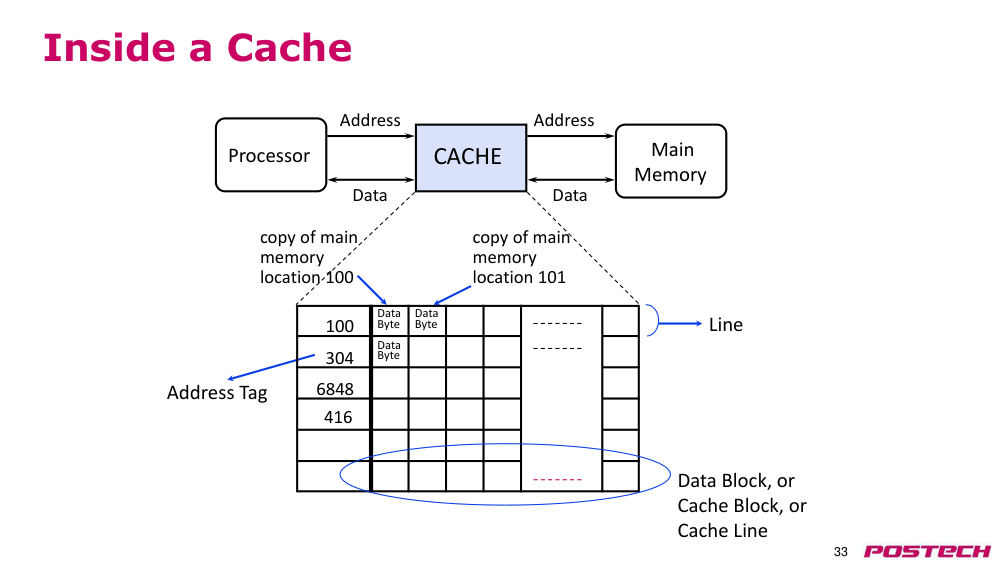
p.33캐시 내부
- 캐시
- 프로세서
- main memory(주기억장치)
- 주소
- 주소
- 데이터
- 데이터
- 주소 tag(태그)
- 데이터 블록, 또는
- cache block(캐시 블록), 또는
- cache line(캐시 라인)
- 데이터
- 바이트
- 데이터
- 바이트
- 데이터
- 바이트
- 라인
- 100
- 304
- 6848
- main memory(주기억장치) 위치 100의 사본
- main memory(주기억장치) 위치 101의 사본
- 416
p.34캐시 알고리즘 (읽기)
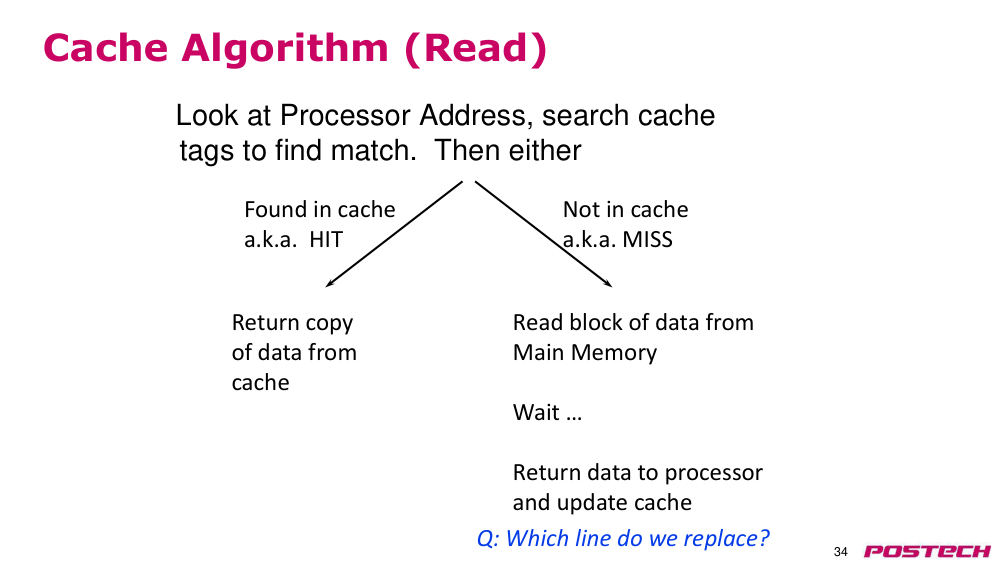
- 프로세서 주소를 확인하고 cache tag(캐시 태그)를 검색하여 일치 여부를 확인한다. 그 후
- 캐시 내에 존재함
- 즉, cache hit(캐시 히트)
- 캐시에서 데이터 사본을 반환한다
- 캐시에 없음
- 즉, cache miss(캐시 미스)
- main memory(주기억장치)에서 데이터 블록을 읽는다
- 대기 중 …
- 데이터를 프로세서에 반환하고 캐시를 업데이트한다
- 질문: 어느 라인을 치환할까?
p.35cache miss(캐시 미스)의 원인: 3개 (+1개)의 C
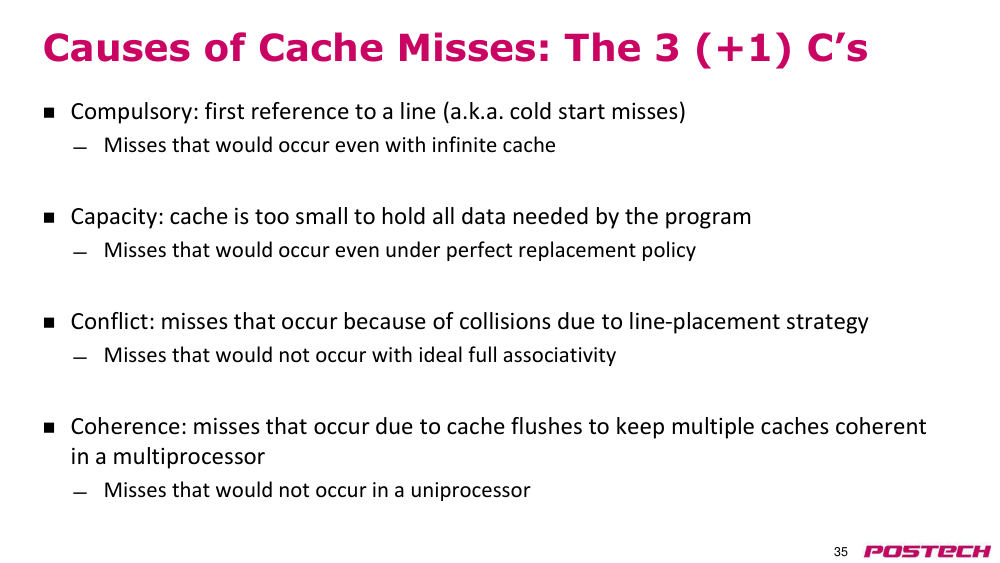
- compulsory miss(강제 미스): 라인에 대한 처음 참조 (또는 cold start miss(콜드 스타트 미스)로도 알려짐)
- 무한한 캐시가 있어도 발생하는 미스
- capacity miss(용량 미스): 프로그램이 필요로 하는 모든 데이터를 캐시가 수용할 수 없을 정도로 작음
- 완벽한 replacement policy(치환 정책)을 사용해도 발생하는 미스
- conflict miss(충돌 미스): 라인 배치 전략으로 인한 충돌로 인해 발생하는 미스
- 완전 연관성으로 이상적으로 구현했을 때는 발생하지 않는 미스
- coherence miss(일관성 미스): multiprocessor(다중 프로세서)에서 여러 캐시 간 일관성을 유지하기 위해 캐시를 플러시할 때 발생하는 미스
- 단일 프로세서에서는 발생하지 않는 미스
p.36placement policy(배치 정책)
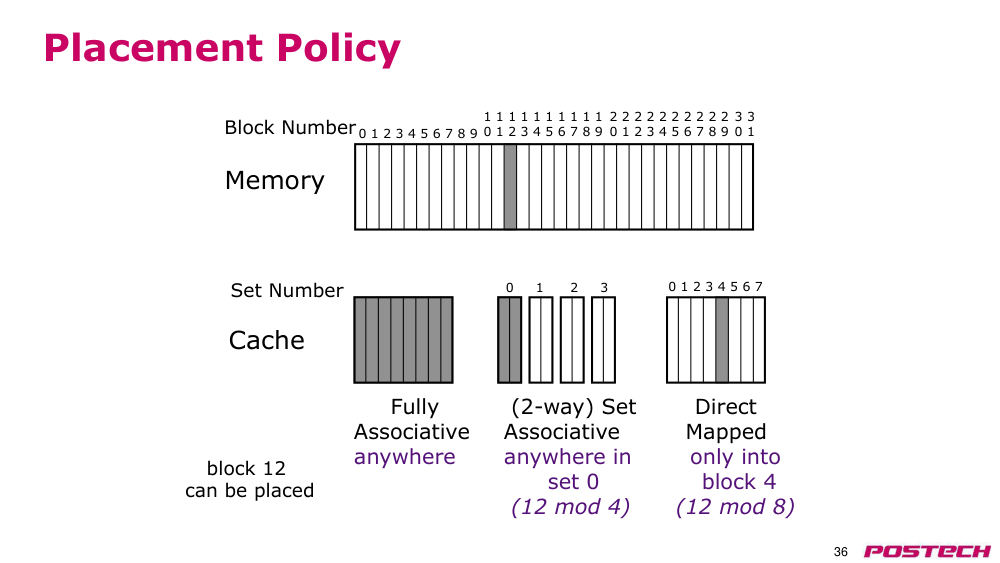
- 0 1 2 3 4 5 6 7
- 0 1 2 3
- 세트 번호
- 캐시
- 완전 연관
- (2-way) 세트 연관
- 직접 매핑
- 어디에나
- 어디에나 세트 0에
- 블록 4에만
- (12 mod 4)
- (12 mod 8)
- 0 1 2 3 4 5 6 7 8 9
- 1 1 1 1 1 1 1 1 1 1
- 0 1 2 3 4 5 6 7 8 9
- 2 2 2 2 2 2 2 2 2 2
- 0 1 2 3 4 5 6 7 8 9
- 3 3
- 0 1
- 메모리 블록 번호
- 블록 12는 배치될 수 있음
p.37Direct-Mapped cache(직접 매핑 캐시)
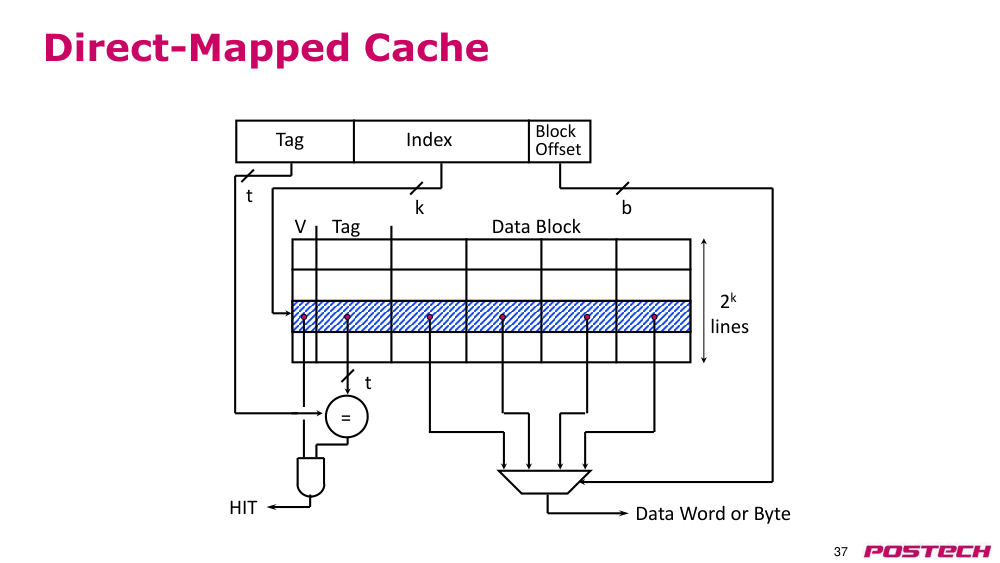
- cache line(캐시 라인)은 메모리 블록의 일부를 저장한다.
- 각 cache line(캐시 라인)은 tag field(태그 필드), 데이터 블록, 유효 비트(V)로 구성된다.
- 주소는 tag(태그), index(인덱스), offset(오프셋)으로 분할된다.
- 블록 오프셋(b비트): 블록 내에서 데이터의 위치를 지정한다.
- 인덱스(k비트): cache line(캐시 라인)의 위치를 지정한다. 2^k개의 라인이 있다.
- 태그(t비트): 메모리 블록의 고유 식별자를 제공한다.
- cache hit(캐시 히트): index(인덱스)와 tag(태그)가 일치하면 캐시 히트가 발생한다.
- cache miss(캐시 미스): index(인덱스)가 일치하지 않거나 tag(태그)가 일치하지 않으면 캐시 미스가 발생한다.
p.38직접 매핑 주소 선택
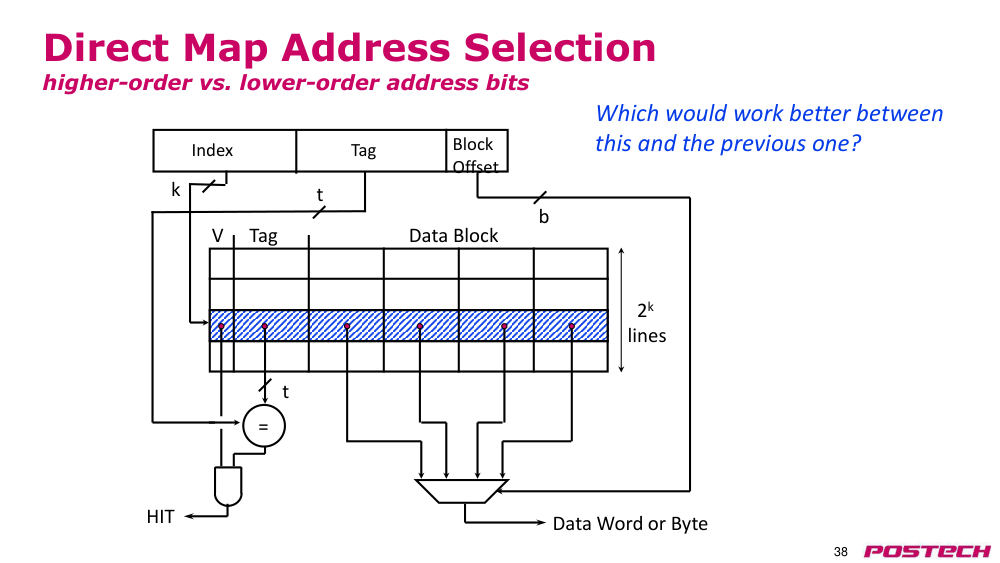
- 고순위 주소 비트 vs. 저순위 주소 비트 사용
- 이전 슬라이드와 비교하여 어떤 것이 더 나은가?
- 고순위 비트를 index(인덱스)로 사용하면, 주소 패턴에 따라 cache line(캐시 라인)에 균형 있게 분포될 수 있다.
- 저순위 비트를 index(인덱스)로 사용하면, 연속된 메모리 주소가 같은 cache line(캐시 라인)에 할당되어 충돌이 발생할 가능성이 높다.
- 따라서 고순위 주소 비트를 index(인덱스)로 사용하는 것이 일반적으로 더 효과적이다.
p.392웨이 Set-Associative cache(세트 연관 캐시)
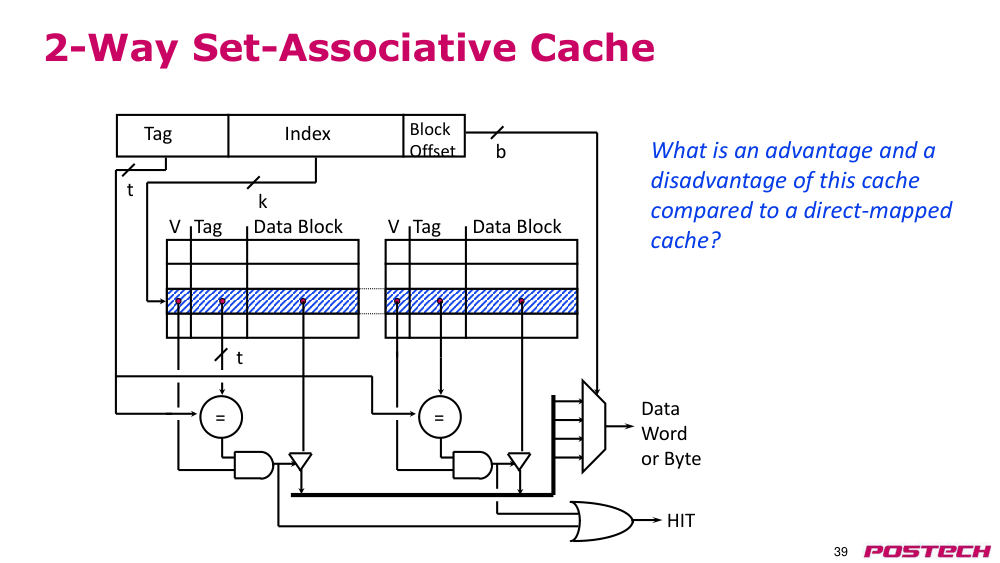
- 각 세트는 2개의 cache line(캐시 라인)을 포함한다.
- index(인덱스)는 세트의 위치를 결정하며, 각 세트 내에서 tag(태그)를 비교하여 cache hit(캐시 히트) 여부를 판단한다.
- 이전의 Direct-Mapped cache(직접 매핑 캐시)와 비교했을 때의 장점:
- - conflict miss(충돌 미스)가 줄어든다. 동일한 index(인덱스)에 여러 블록을 저장할 수 있다.
- 이전의 Direct-Mapped cache(직접 매핑 캐시)와 비교했을 때의 단점:
- - 하드웨어가 더 복잡해진다. tag(태그) 비교 회로가 두 개 필요하다.
- - 접근 시간이 증가할 수 있다. 두 라인 모두 검사해야 하기 때문이다.
p.40fully associative cache(완전 연관 캐시)
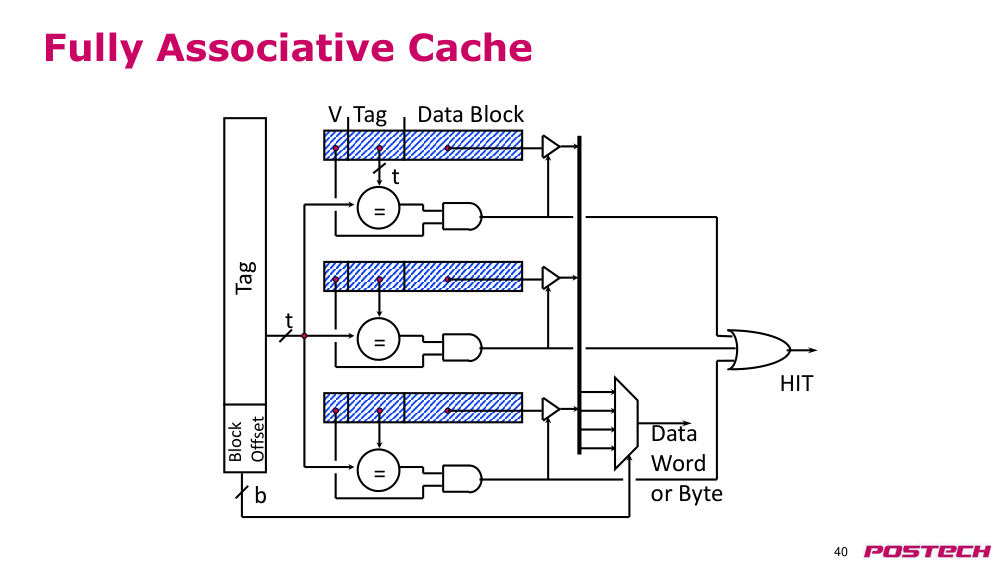
- 모든 메모리 블록이 캐시의 어느 라인에든 저장될 수 있다.
- 주소는 tag(태그)와 offset(오프셋)으로만 구성된다.
- 블록 오프셋(b비트): 블록 내에서 데이터의 위치를 지정한다.
- 태그(t비트): 메모리 블록의 고유 식별자를 제공한다.
- cache hit(캐시 히트): tag(태그)가 일치하면 캐시 히트가 발생한다.
- cache miss(캐시 미스): tag(태그)가 일치하지 않으면 캐시 미스가 발생한다.
- 모든 라인을 검사해야 하므로 하드웨어 비용과 접근 시간이 증가한다.
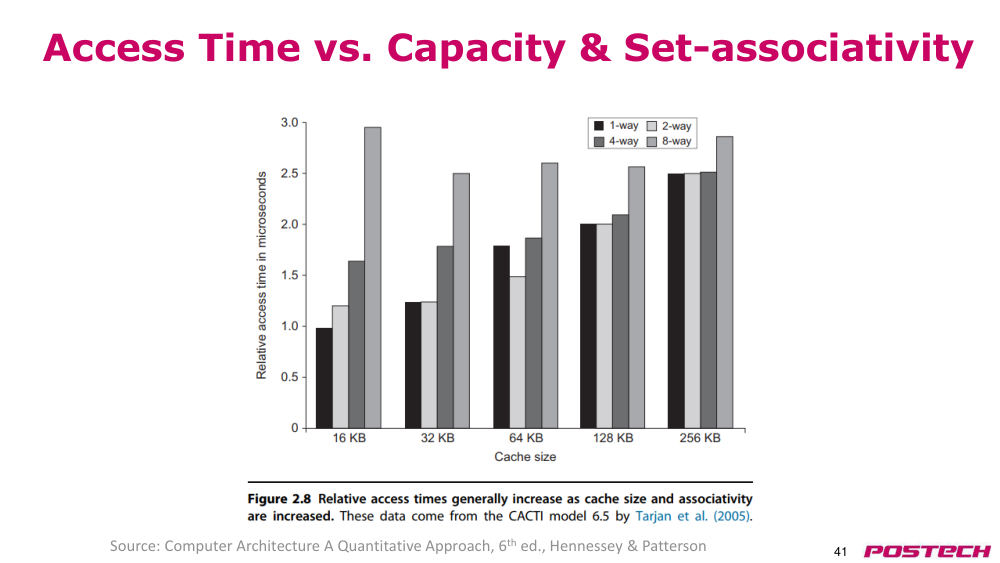
p.41접근 시간 vs. 용량 및 세트 연관성
- 캐시의 접근 시간은 용량과 세트 연관성에 따라 달라진다.
- Direct-Mapped cache(직접 매핑 캐시): 접근 시간이 가장 짧지만, conflict miss(충돌 미스)가 많을 수 있다.
- 2웨이 Set-Associative cache(세트 연관 캐시): 접근 시간이 약간 증가하지만, conflict miss(충돌 미스)가 줄어든다.
- fully associative cache(완전 연관 캐시): 접근 시간이 가장 길지만, conflict miss(충돌 미스)가 최소화된다.
- 성능과 비용의 균형을 고려해야 한다.
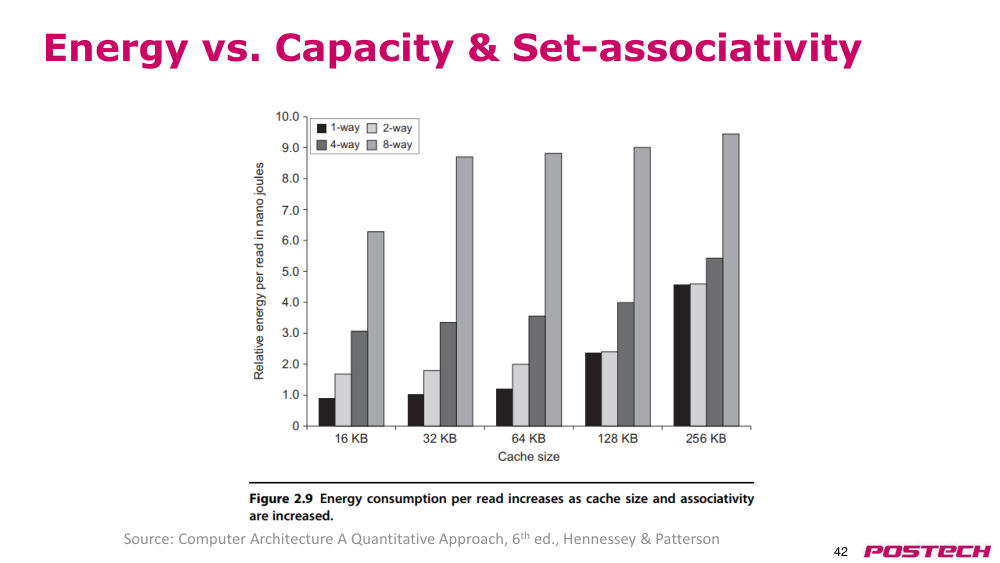
p.42에너지 소비 vs. 용량 및 세트 연관성
- 캐시의 에너지 소비는 용량과 세트 연관성에 따라 달라진다.
- Direct-Mapped cache(직접 매핑 캐시): 에너지 소비가 가장 낮다. 하드웨어가 간단하다.
- 2웨이 Set-Associative cache(세트 연관 캐시): 에너지 소비가 약간 증가한다. tag(태그) 비교 회로가 두 개 필요하다.
- fully associative cache(완전 연관 캐시): 에너지 소비가 가장 높다. 모든 라인을 비교해야 하기 때문이다.
- 에너지 효율성과 성능 사이의 균형을 고려해야 한다.
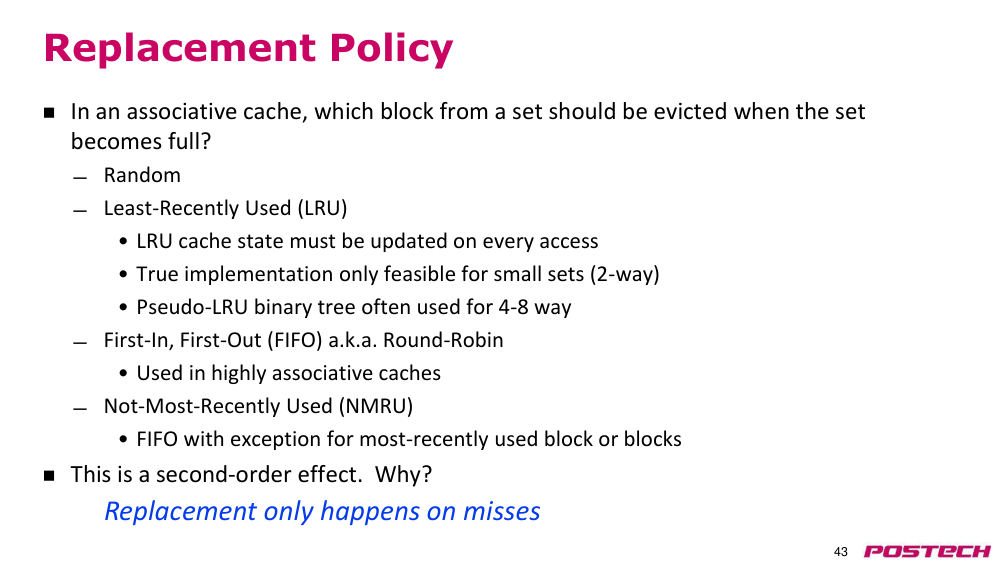
p.43replacement policy(치환 정책)
- - 연관 캐시에서 세트가 가득 찼을 때, 어떤 블록을 제거해야 하는가?
- • 랜덤
- • 최근에 사용되지 않은 것 (Least-Recently Used, LRU)
- • LRU 캐시 상태는 모든 접근 시 업데이트되어야 한다
- • 진정한 구현은 작은 세트(2-way)에서만 가능하다
- • 4-8 way에서는 Pseudo-LRU(의사 LRU) 이진 트리가 흔히 사용된다
- • 선입선출 (First-In, First-Out, FIFO) 또는 라운드 로빈
- • 매우 연관성이 높은 캐시에서 사용된다
- • 가장 최근에 사용되지 않은 것 (Not-Most-Recently Used, NMRU)
- • 가장 최근에 사용된 블록 또는 블록들에 대한 예외를 두는 FIFO
- • 이는 이차 효과이다. 왜인가?
- • 치환이 미스 발생 시에만 일어난다
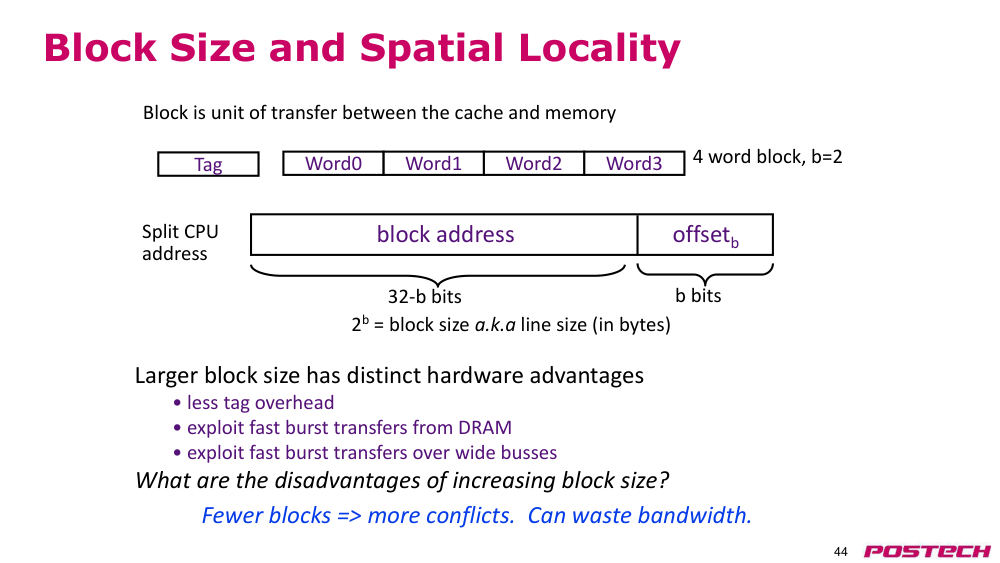
p.44block size(블록 크기)와 spatial locality(공간적 지역성)
- - 더 큰 block size(블록 크기)는 하드웨어 측면에서 명확한 장점이 있다
- • tag(태그) 오버헤드 감소
- • DRAM에서의 빠른 burst transfer(버스트 전송) 활용
- • 넓은 버스를 통한 빠른 burst transfer(버스트 전송) 활용
- • block size(블록 크기)를 늘리는 단점은 무엇인가?
- • 블록 주소
- • offset(오프셋)b
- • 2b = 블록 크기 (바이트 단위), 즉 line size(라인 크기)
- • CPU 주소 분할
- • b 비트
- • 32-b 비트
- • tag(태그)
- • 블록은 캐시와 메모리 사이의 전송 단위이다
- • 4워드 블록, b=2
- • 블록 수 감소 → 더 많은 충돌 발생 가능
- • bandwidth(대역폭) 낭비 가능성 있음
p.45cost amortization(비용 상각)
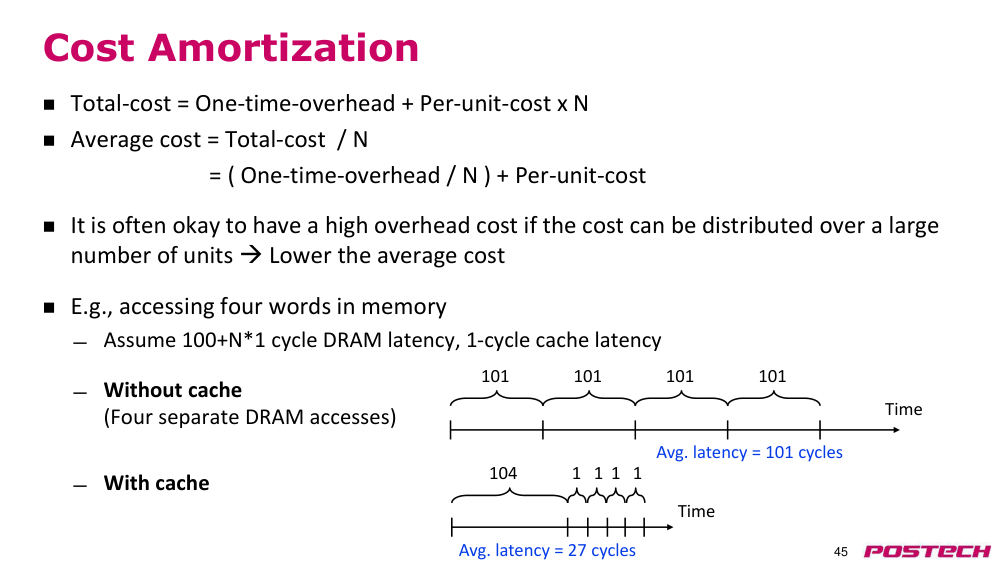
- - 총비용 = 일회성 오버헤드 + 단위비용 × N
- - 평균 비용 = 총비용 / N
- = (일회성 오버헤드 / N) + 단위비용
- • 단위 수가 많을 경우 일회성 비용이 높아도 괜찮다 → 평균 비용 감소
- • 예: 메모리에서 4워드 접근
- • DRAM latency(지연 시간): 100+N×1 사이클, 캐시 지연 시간: 1 사이클 가정
- • 캐시 없음 (4개의 별도 DRAM 접근)
- 시간: 101 101 101 101
- 평균 latency(지연 시간) = 101 사이클
- • 캐시 있음
- 시간: 104 1 1 1 1
- 평균 latency(지연 시간) = 27 사이클
p.46질문?
- - 추천 독서:
- • 교재 2.1-2.2 및 부록 B.1-B.6