Lec 27 · 메모리 장치와 Memory Controller (DRAM, refresh, scheduling, HBM, SCM)
정밀 정리 · 검증 2026-09-24 09:16
1개요
1.1Lec19 전체(ca_L19 42쪽): DRAM 1T1C cell, precharge·activation·sensing, access 5단계와 row hit
1.2JEDEC timing(tRCD/tRAS/tRP/tRC, tCL, burst), DIMM·rank·bank·channel 과 bank-level parallelism
1.3refresh 오버헤드(tRFC·tREFI, per-bank refresh), memory controller 기능, FR-FCFS 와 open/closed row policy
1.4power mode, DRAM 추세(latency 정체), HBM, storage-class memory(PCM, STT-MRAM) 비교
2섹션별 정리 상황·문제 → 원인 → 해결
2.11:26–5:10DRAM cell: 1T1C 와 destructive read
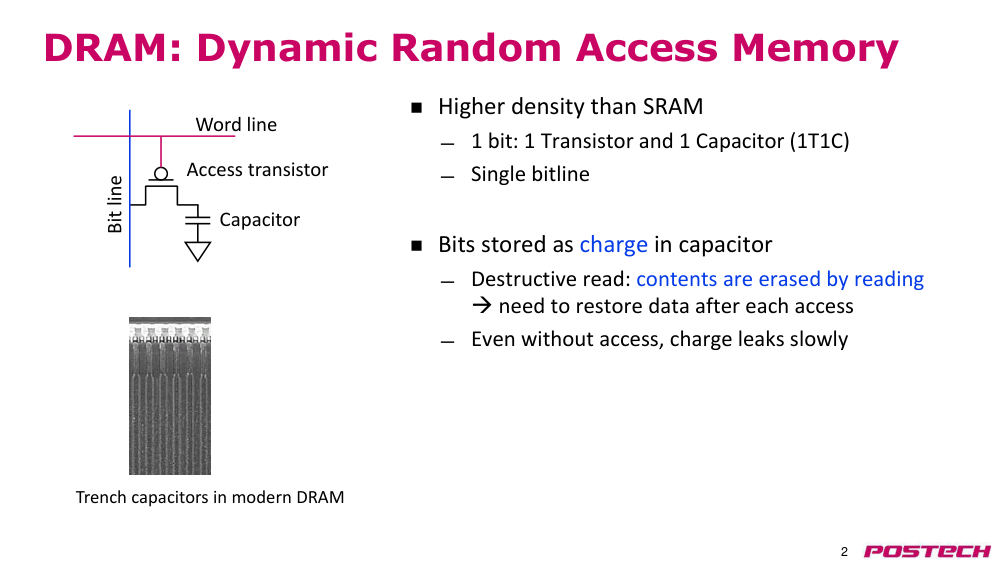
상황·문제main memory 는 DRAM. cell = access transistor 1개 + capacitor 1개(1T1C), bit line 1개라 6T SRAM 보다 dense
원인bit 를 capacitor 전하로 저장 → read 하면 전하가 bit line 으로 빠져 내용이 지워지고(destructive read), 접근 없어도 누설
해결매 access 후 data restore, 주기적 refresh 필요. trench capacitor(위 좁고 깊음)로 밀도 확보
- 1T1C vs SRAM 6T·bit line 2개
- destructive read → restore
- leakage → periodic refresh
2.1.r.1Wikipedia: Dynamic random-access memory ↗ · 1T1C cell, sense amplifier, 64 ms refresh(JEDEC) 정리
2.25:10–11:40Cell array 와 precharge·activation·sensing
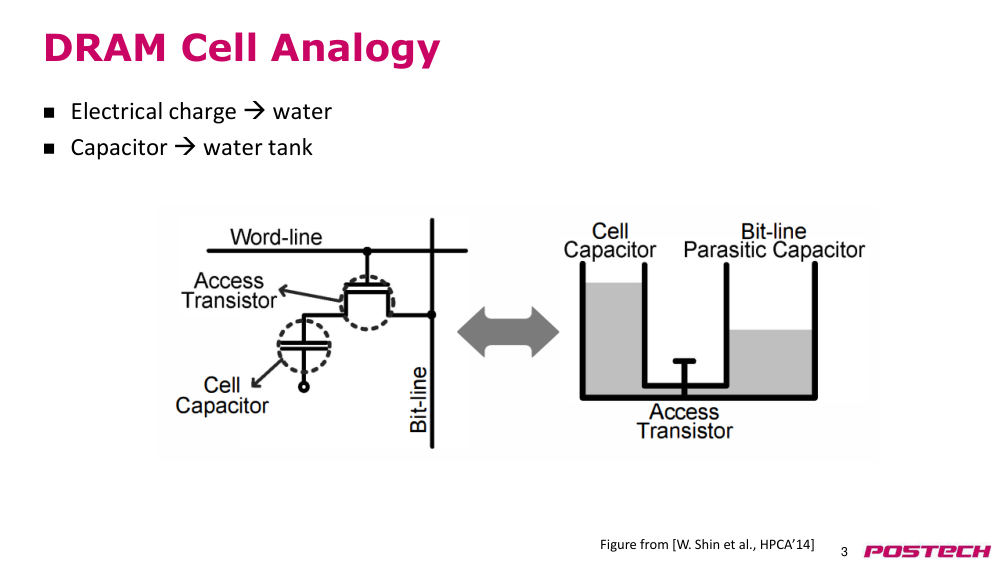
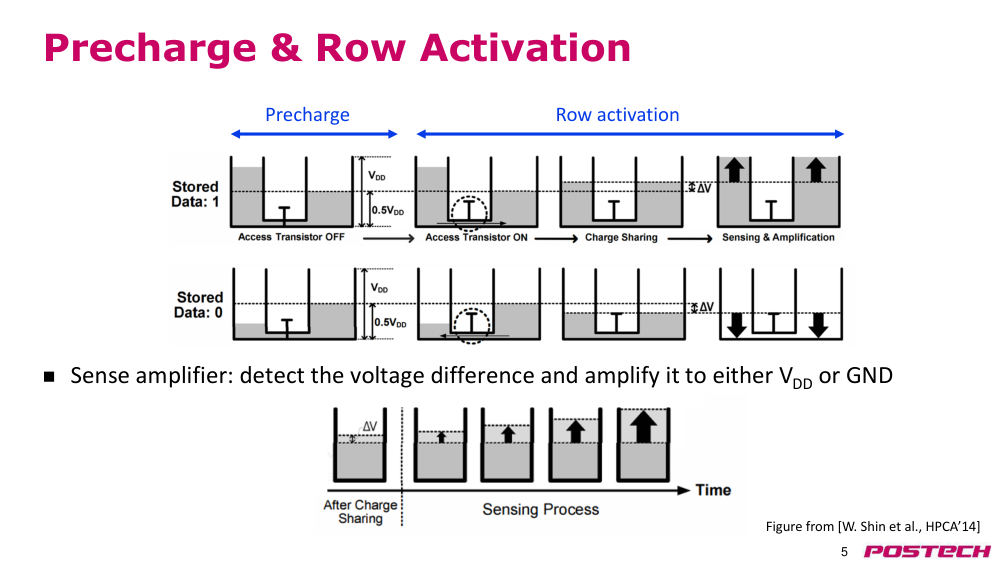
상황·문제cell 전하는 작고 bit line 은 긴 wire 라 parasitic capacitance 가 큼(물탱크 비유: bit line 탱크가 더 큼)
원인cell 을 연결해도 bit line 전압은 조금만 변함
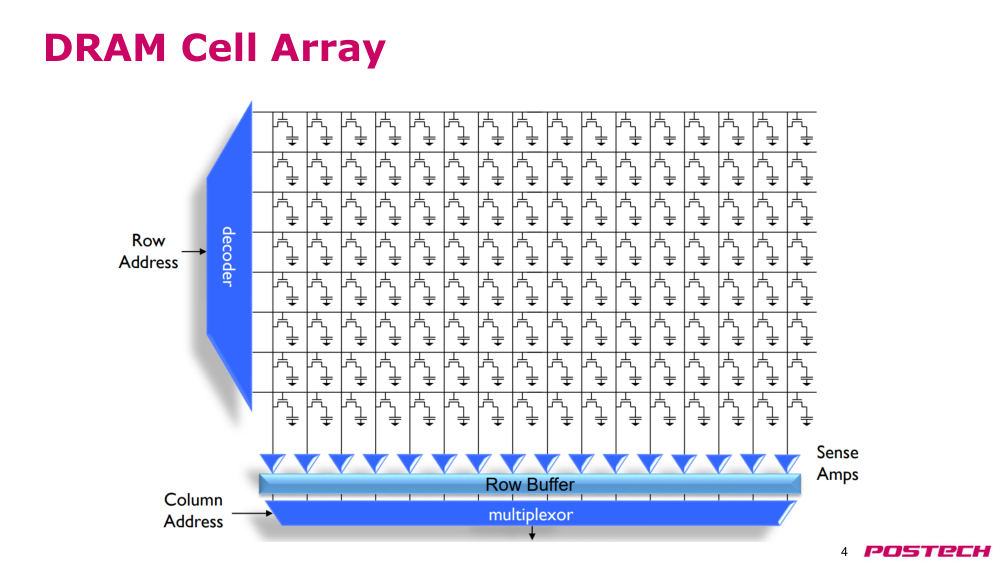
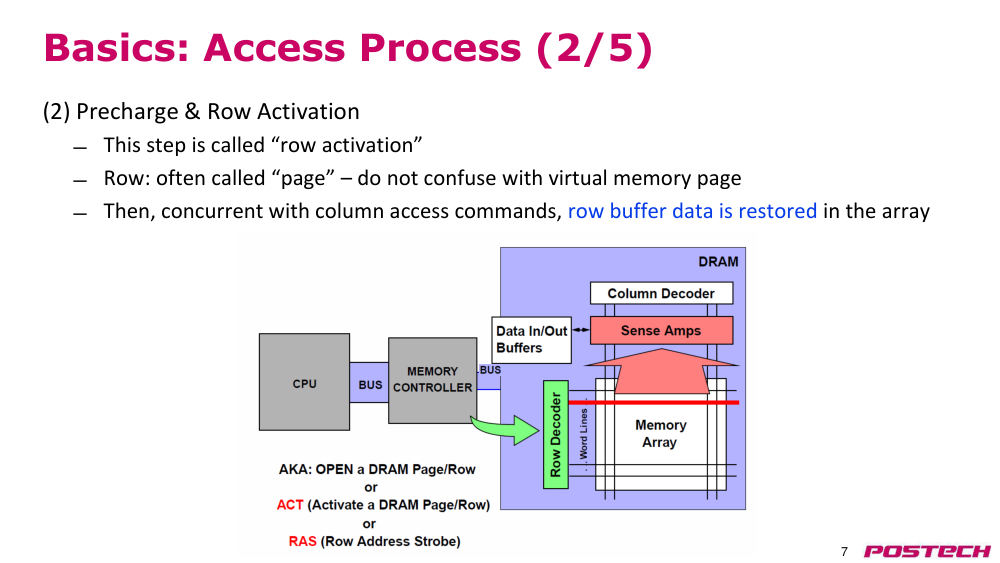
해결precharge 로 bit line 을 VDD/2 에 맞춘 뒤 activate → sense amplifier 가 작은 차이를 VDD/GND 로 증폭하며 cell 도 restore
- row decoder·bit line·sense amp(row buffer)·column mux 구조
- precharge = VDD/2
- sensing 과 동시에 restore
2.2.r.1Wikipedia: Dynamic random-access memory ↗ · 1T1C cell, sense amplifier, 64 ms refresh(JEDEC) 정리
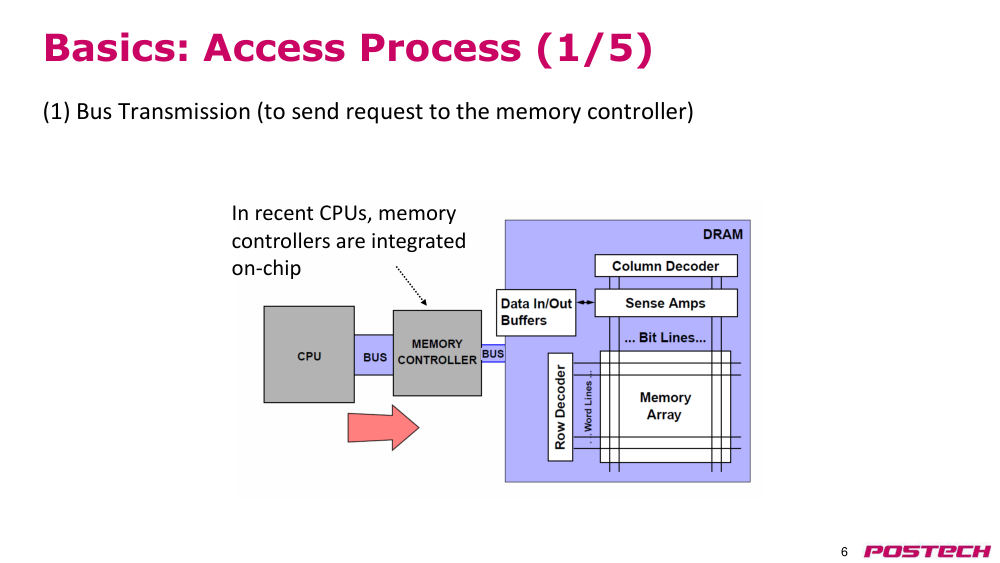
2.311:40–14:57DRAM access 5단계와 row hit/conflict
상황·문제CPU 요청이 DRAM data 로 돌아오기까지 여러 단계가 있음
원인row 를 바꾸려면 precharge + activate 후 sense amp 에 data 가 찰 때까지 기다려야 함
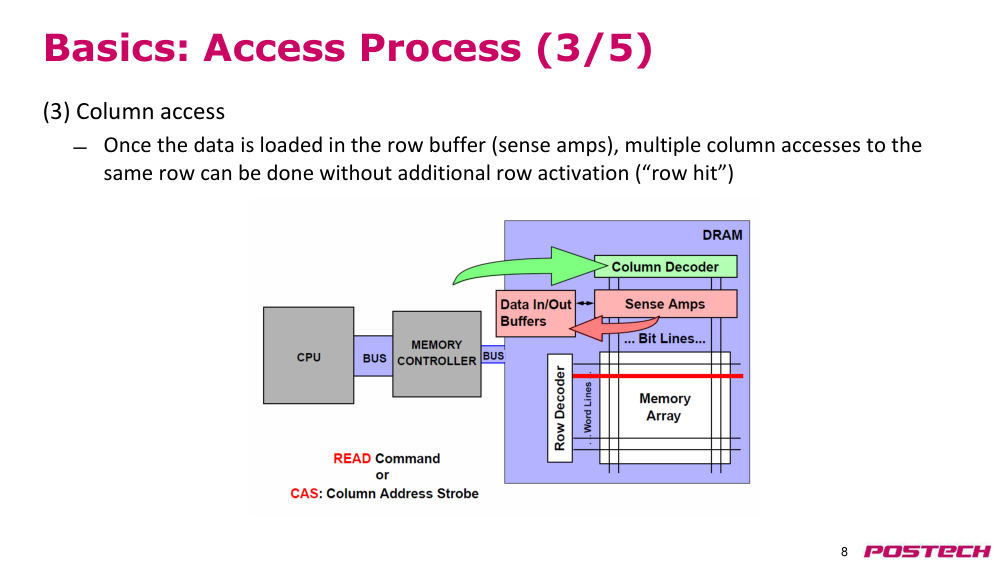
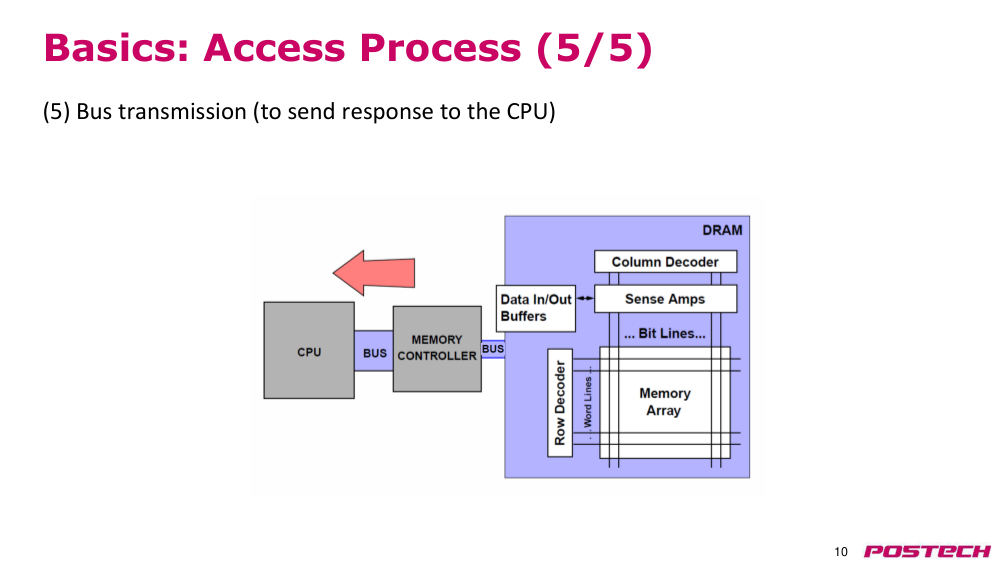
해결(1) controller 로 요청(요즘 온칩) (2) precharge·activate (3) column access (4) data 전송 (5) CPU 로 응답. 열린 row 에 여러 column = row hit
- row = page (virtual memory page 와 다름)
- row hit 는 latency 짧음, row miss/conflict 는 김
2.414:57–22:08Timing parameter 와 burst access
상황·문제controller 가 보내는 모든 명령은 JEDEC 표준 timing 을 지켜야 함
원인activate→column(tRCD 15ns), restore 동안 row 유지(tRAS), precharge(tRP 15ns), ACT→ACT = tRC = tRAS + tRP
해결READ 후 tCL 뒤 burst(BL 8, DDR 이라 cycle 당 2회) 전송. ACT 간격이 길어 row 당 column access 를 최대화 → scheduling 중요
- C_B ≈ 3.5 C_C
- DDR3/4 BL 8, DDR5 BL 16(강의)
- DDR3-1066 tRC 52.5ns
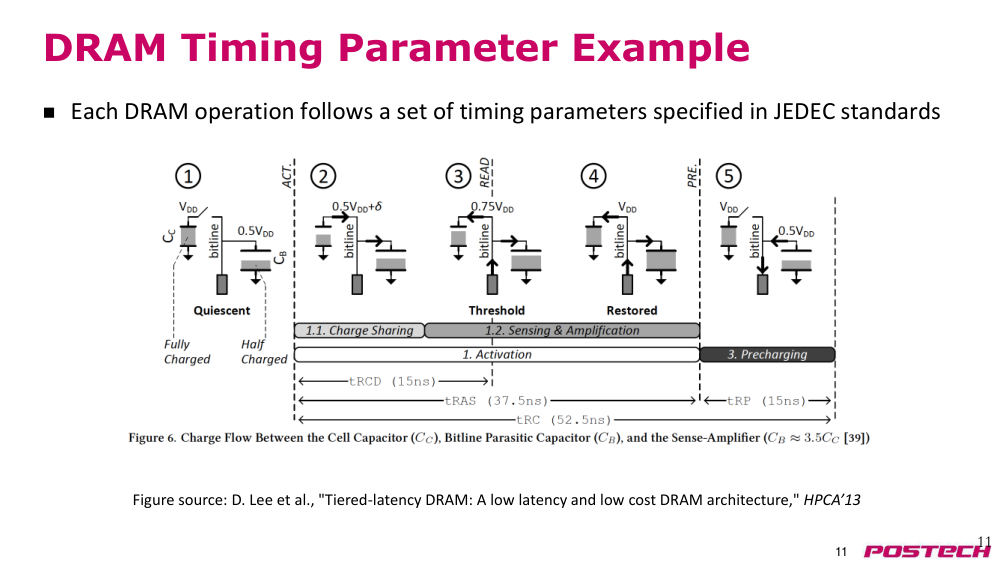
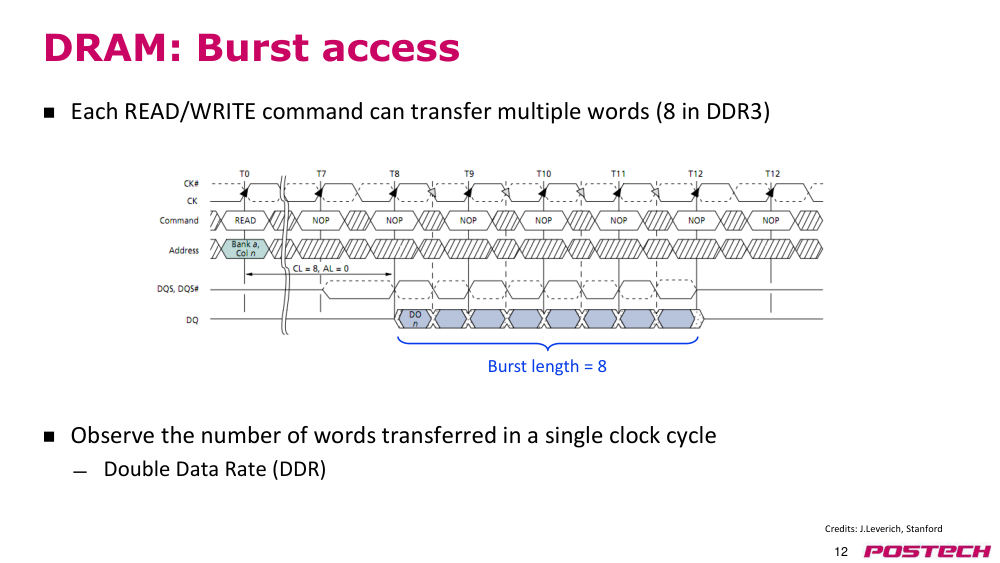
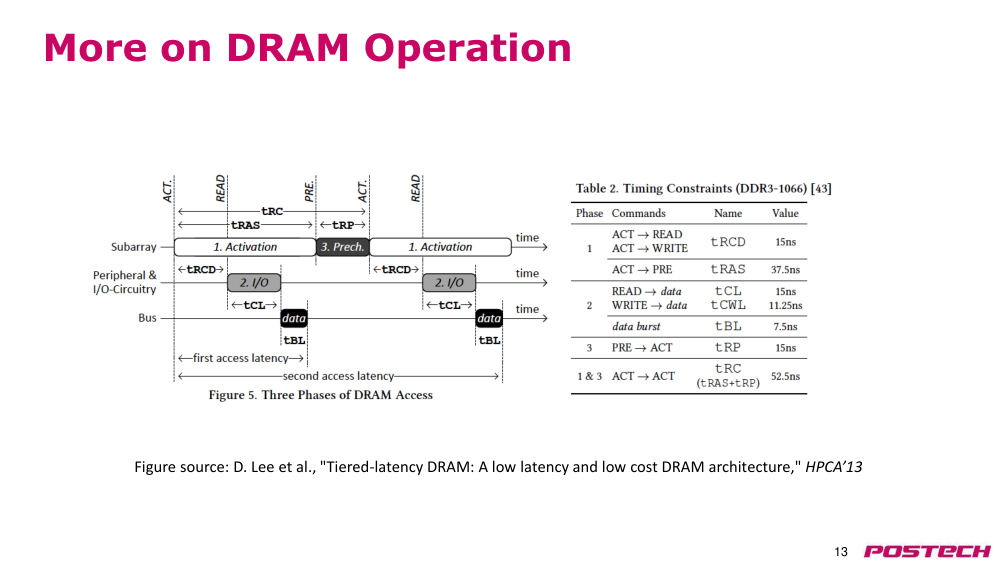
2.4.r.1Lee et al., Tiered-Latency DRAM (HPCA'13, CMU PDF) ↗ · 슬라이드 11·13 그림 원 논문. tRCD/tRAS/tRP/tRC, DDR3-1066 timing 표
2.4.r.2Wikipedia: Dynamic random-access memory ↗ · 1T1C cell, sense amplifier, 64 ms refresh(JEDEC) 정리
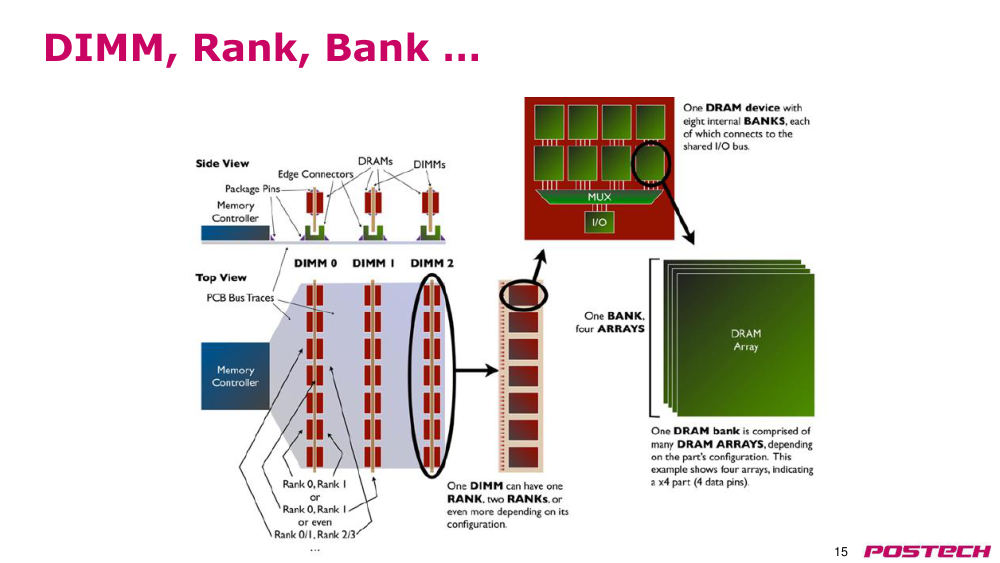
2.522:08–26:32물리 구성: DIMM · rank · bank · channel
상황·문제cache line 폭의 data 를 여러 chip 에서 동시에 얻어야 함
원인chip 하나는 x4/x8 등 좁은 폭
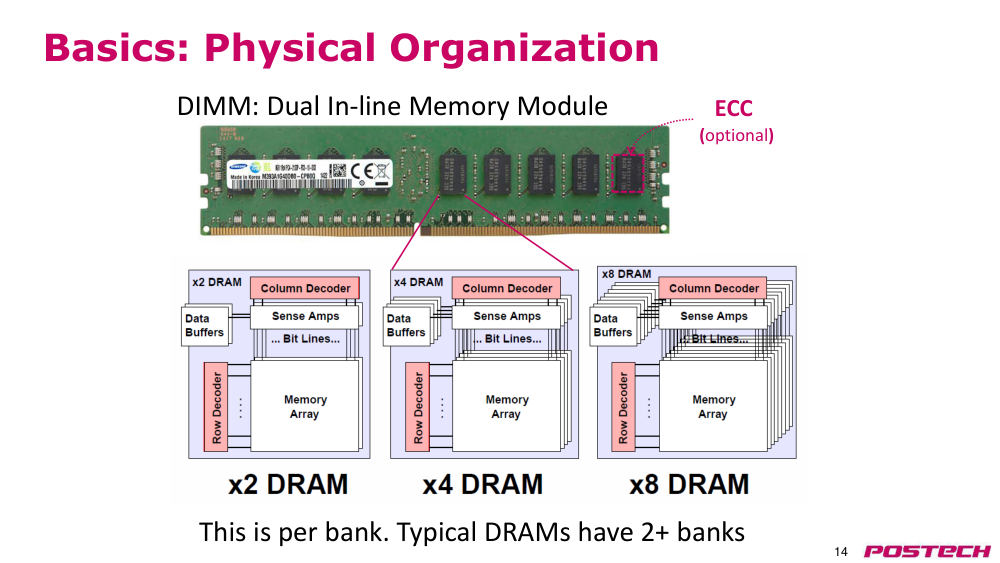
해결DIMM 에 x8 chip 8개(+ECC 1개, 72-bit), chip 은 8 bank, channel 당 DIMM 2개(과거 4개), DIMM 은 rank 1~2+, 여러 channel 로 bandwidth·capacity 확보
- ECC 는 서버 필수, desktop 은 보통 없음
- bank 내 array 들이 같은 명령으로 lockstep
2.626:32–31:17Bank-level parallelism 과 64B cache line 읽기
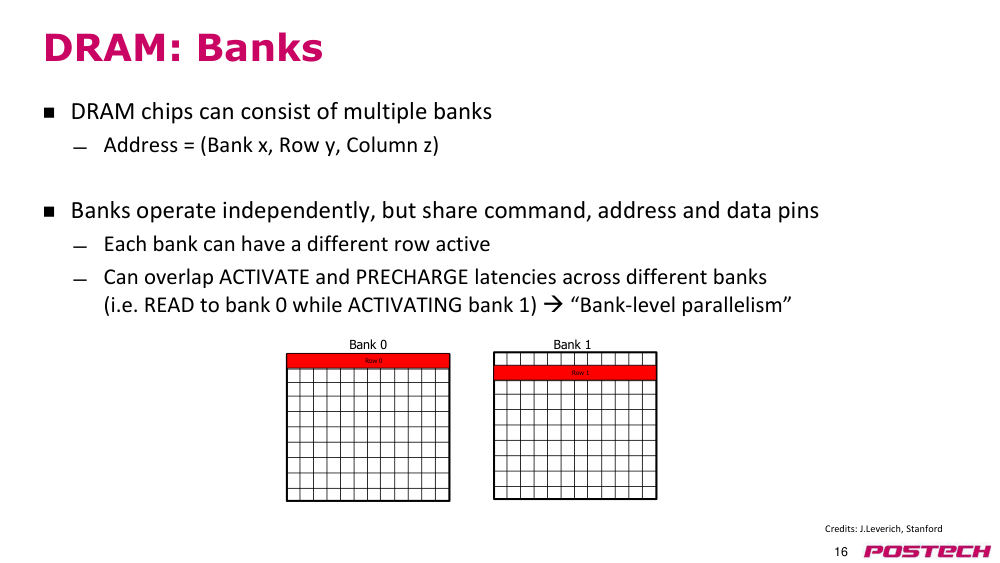
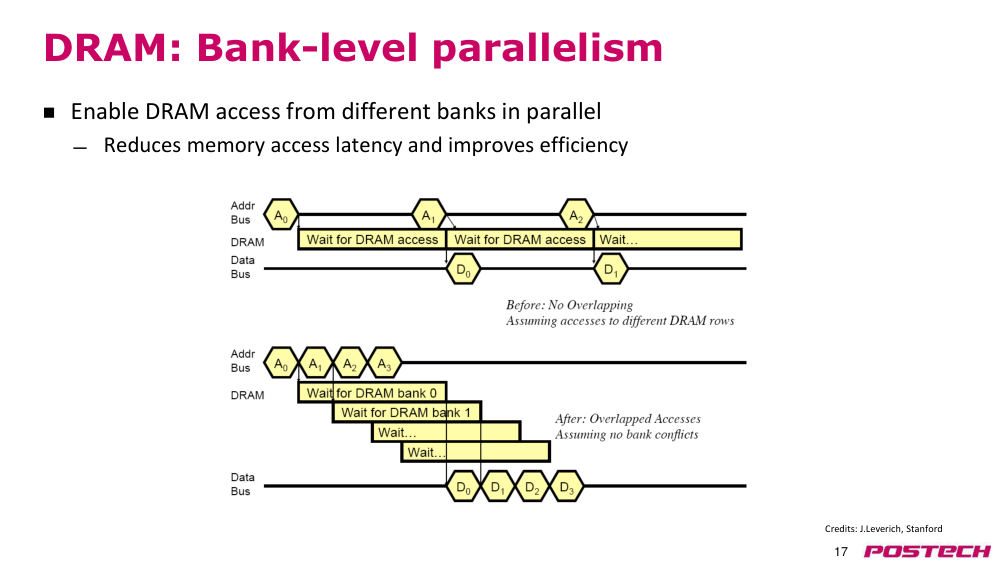
상황·문제bank 가 하나면 DRAM access 동안 CPU 가 대기하고 row 전환 지연이 그대로 노출
원인bank 는 command/address/data 핀을 공유하지만 독립 동작, 각자 다른 row 를 열 수 있음
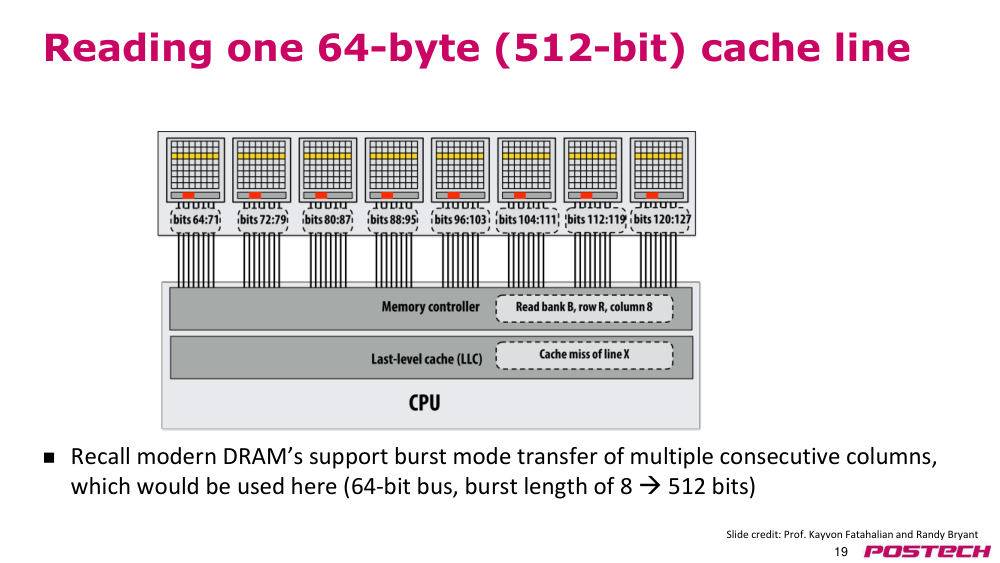
해결여러 bank 에 activate/precharge 를 겹쳐 latency 숨김(bank-level parallelism). data 를 bank 에 분산해야 효과. 64-bit bus × BL 8 = 512 bit = 64B line
- 주소 = (bank, row, column)
- 모든 chip 이 같은 command/address 수신
2.731:17–43:50Refresh: 문제와 완화 (distributed/burst, per-bank)
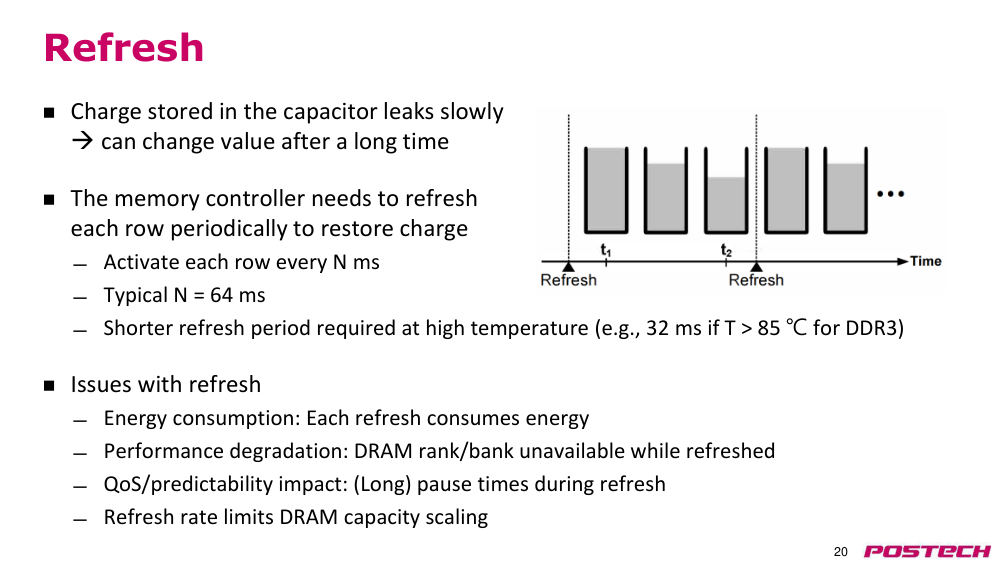
상황·문제각 row 를 64 ms 마다 refresh(DDR3 85℃ 초과 시 32 ms). 한 명령이 여러 row 를 처리하지만 오래 걸림
원인refresh 중 rank/bank 접근 불가 → 성능·energy 낭비·QoS(deadline) 악화. 용량↑ = row↑ → tRFC 거의 선형 증가
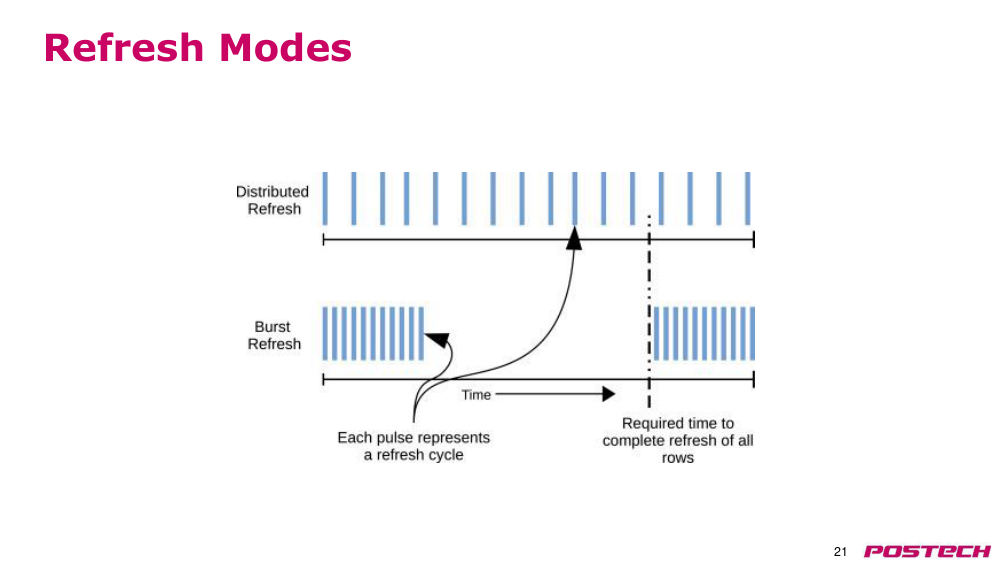
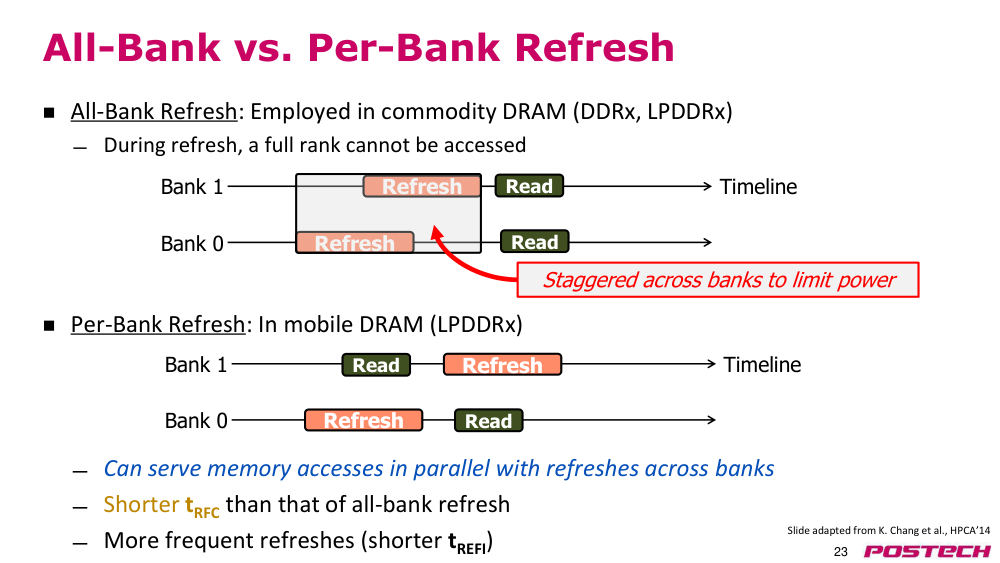
해결distributed vs burst refresh, 1x/2x/4x mode, per-bank refresh(LPDDRx): 다른 bank 는 계속 서비스, tRFC 짧고 tREFI 도 짧음
- tRFC 8Gb 350ns → 32Gb 640ns (1x)
- all-bank 은 power 제한으로 staggered
- 현재 DDR3 throughput loss 10% 미만(강의)
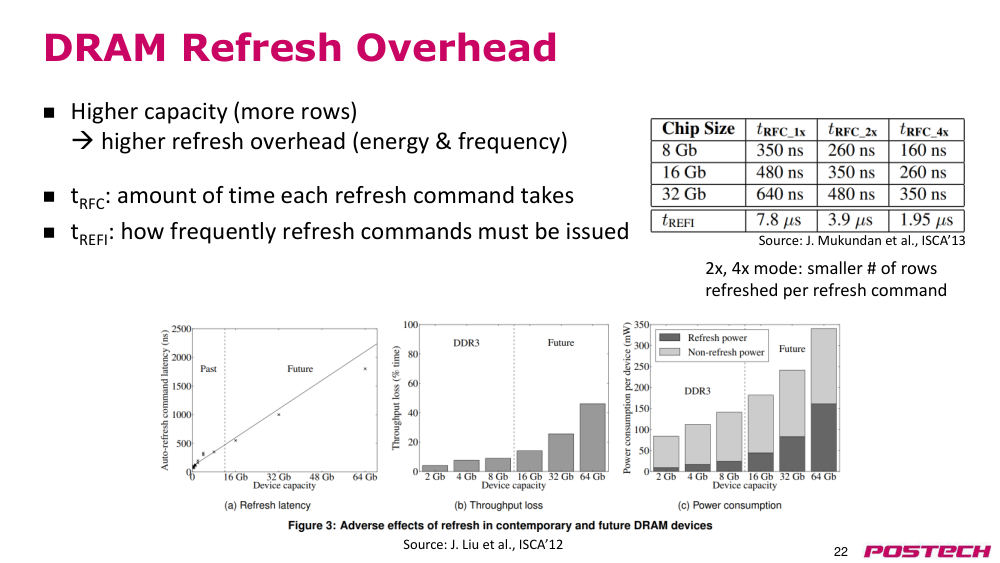
2.7.r.1Liu et al., RAIDR (ISCA'12, CMU PDF) ↗ · 슬라이드 22 그래프 원 논문. 용량 증가에 따른 refresh latency·throughput·power
2.7.r.2Chang et al., Parallelizing Refreshes with Accesses (HPCA'14, CMU PDF) ↗ · 슬라이드 23 출처. all-bank vs per-bank refresh(REFpb)
2.843:50–54:12DRAM controller 기능과 scheduling policy
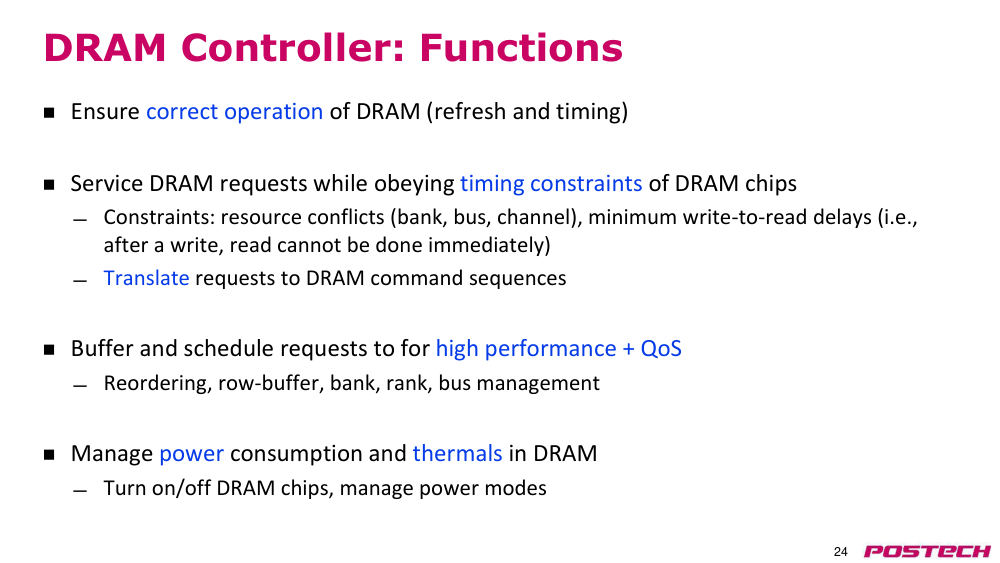
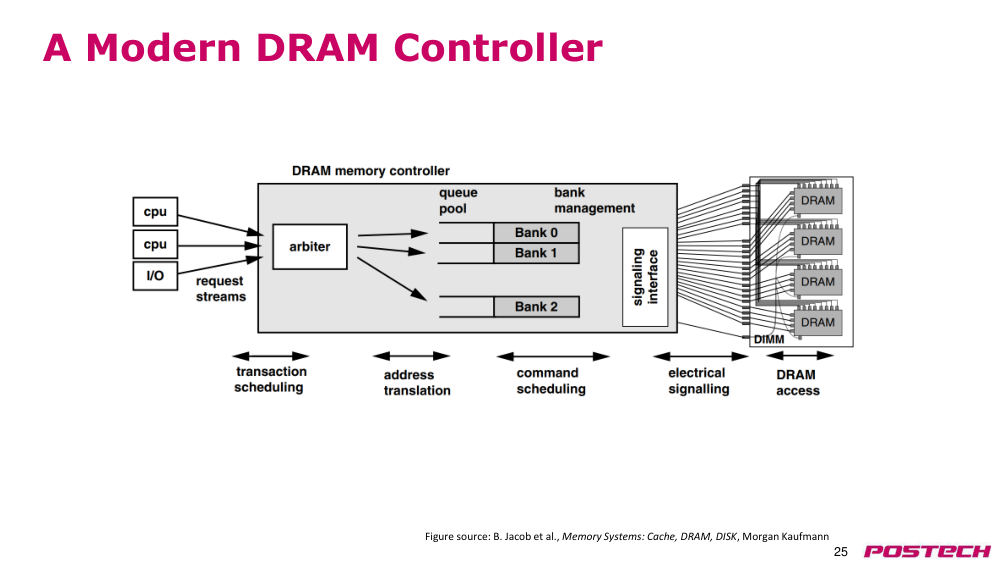
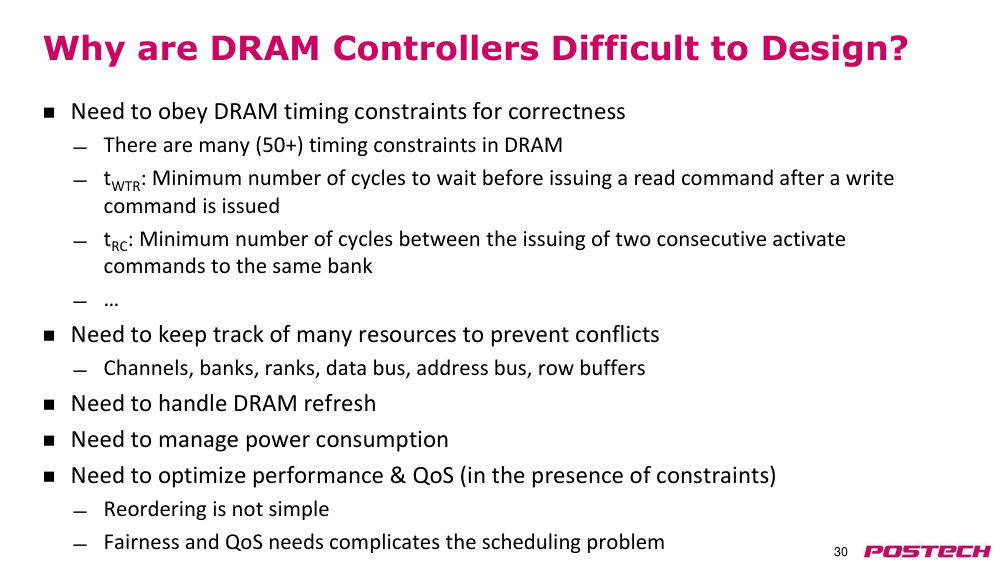
상황·문제controller 는 timing·resource 제약(bank/bus/channel 충돌, write→read 지연)을 지키며 요청을 처리해야 함
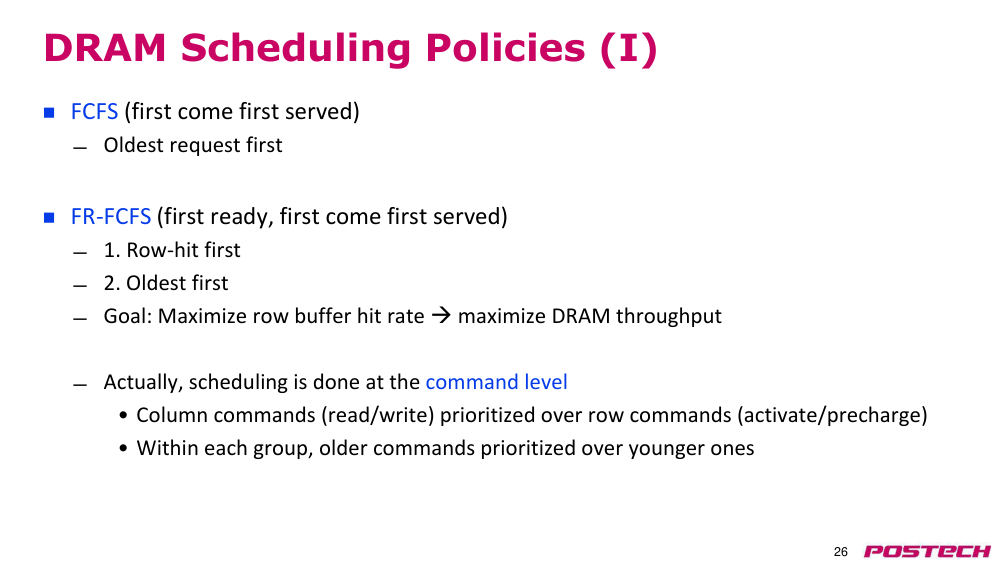
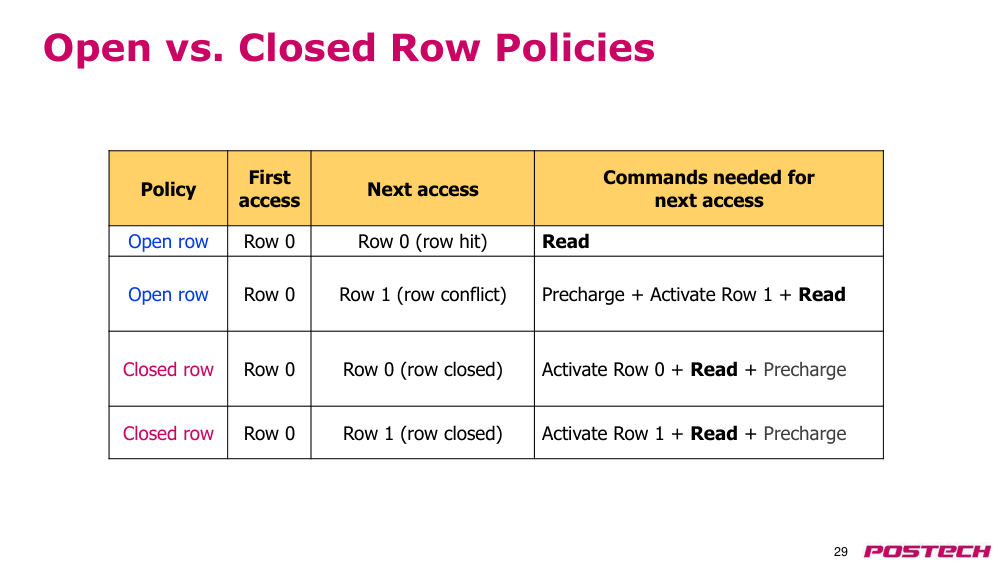
원인같은 load 도 row 상태에 따라 필요한 명령열이 다름(열림: READ, 닫힘: PRE+ACT+READ)
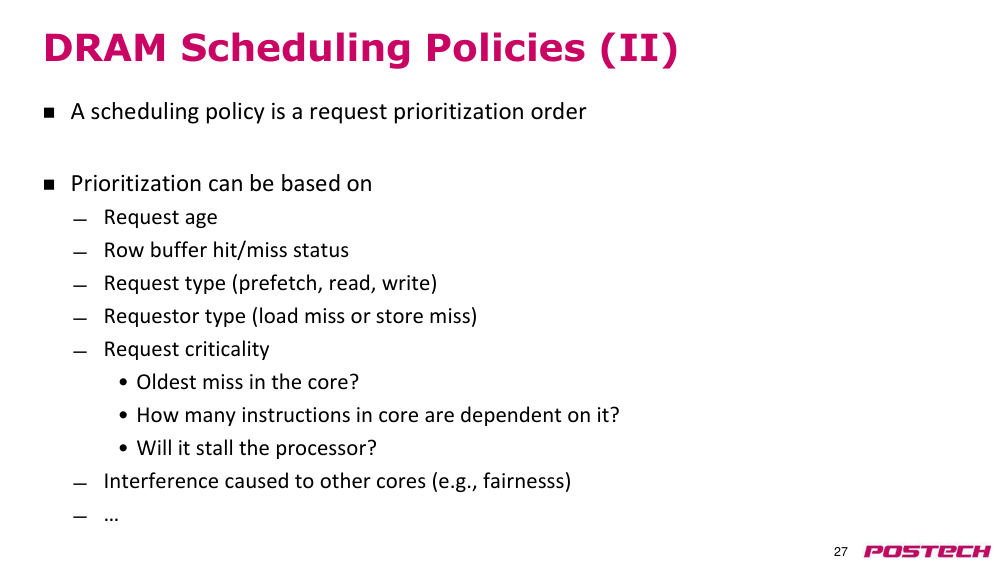
해결요청 buffer(bank 별) + scheduling. FCFS 대신 FR-FCFS(row hit 우선, 다음 oldest; command 수준에선 column 명령 우선). 우선순위에 age, 요청 유형, load/store miss, criticality, fairness 고려
- power·thermal 관리(low power mode 진입)
- prefetch < demand read, load miss > store miss
- ROB head 근처·의존 명령 많은 miss 가 critical
2.8.r.1Rixner et al., Memory Access Scheduling (ISCA'00, Rice PDF) ↗ · first-ready 스케줄링(FR-FCFS 원형)과 open/closed precharge policy
2.954:12–59:24Row buffer 관리 정책과 controller 설계 난이도
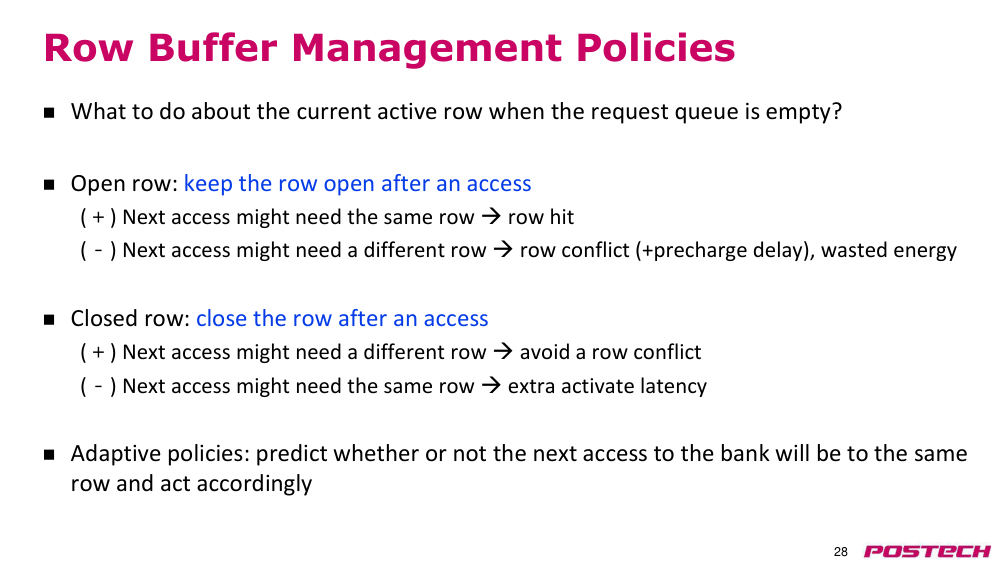
상황·문제요청 queue 가 비었을 때 열린 row 를 둘지 닫을지 결정해야 함
원인open row: 다음이 같은 row 면 hit, 다른 row 면 precharge 지연·sense amp energy 낭비. closed row: conflict 는 피하나 같은 row 재접근 시 re-activate
해결adaptive policy 로 다음 access 가 같은 row 일지 예측. 50개 이상 timing 제약, resource 상태 추적, refresh·power·QoS 까지 함께 처리해야 해 설계가 어려움
- open: hit=READ, conflict=PRE+ACT+READ
- closed: 둘 다 ACT+READ(+PRE)
- tWTR, tRC 예
2.9.r.1Rixner et al., Memory Access Scheduling (ISCA'00, Rice PDF) ↗ · first-ready 스케줄링(FR-FCFS 원형)과 open/closed precharge policy
2.1059:24–1:07:10Power mode, DRAM 추세, HBM
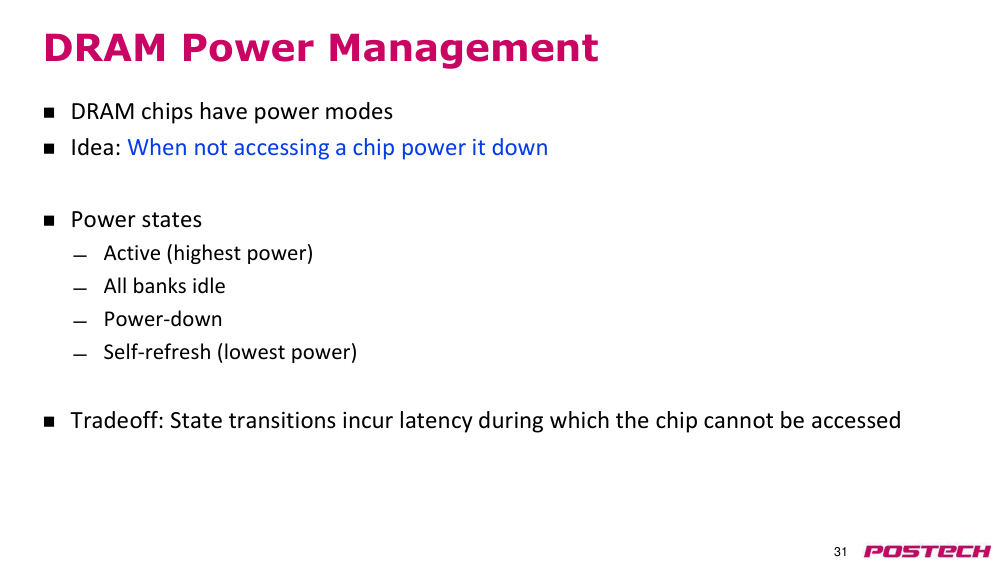
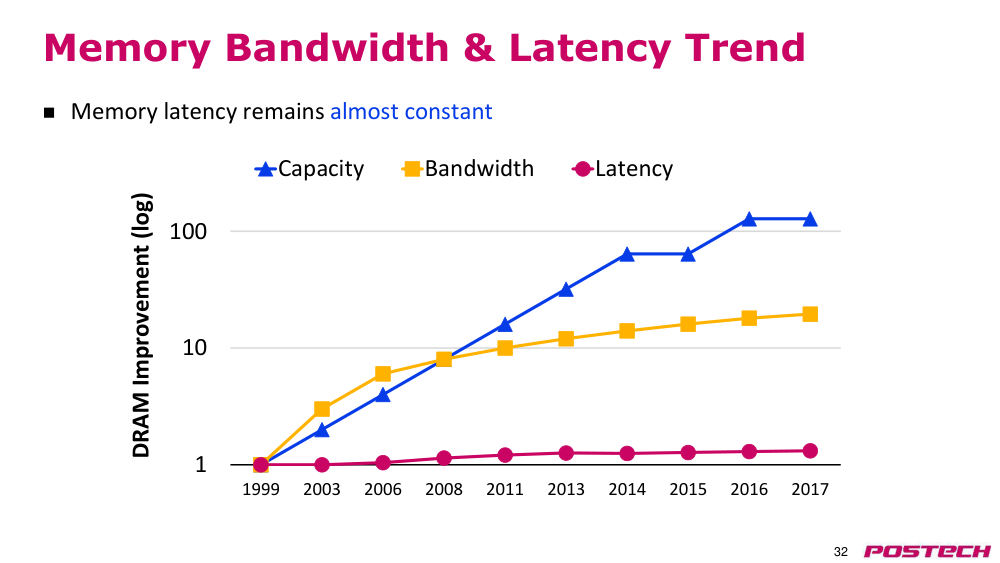
상황·문제DRAM 은 active 에서 가장 많은 전력. capacity 는 지수적 증가, bandwidth 는 느리게, latency 는 거의 상수
원인DIMM form factor 는 bandwidth 한계. 상태 전환(power-down, self-refresh)은 wake-up latency 발생
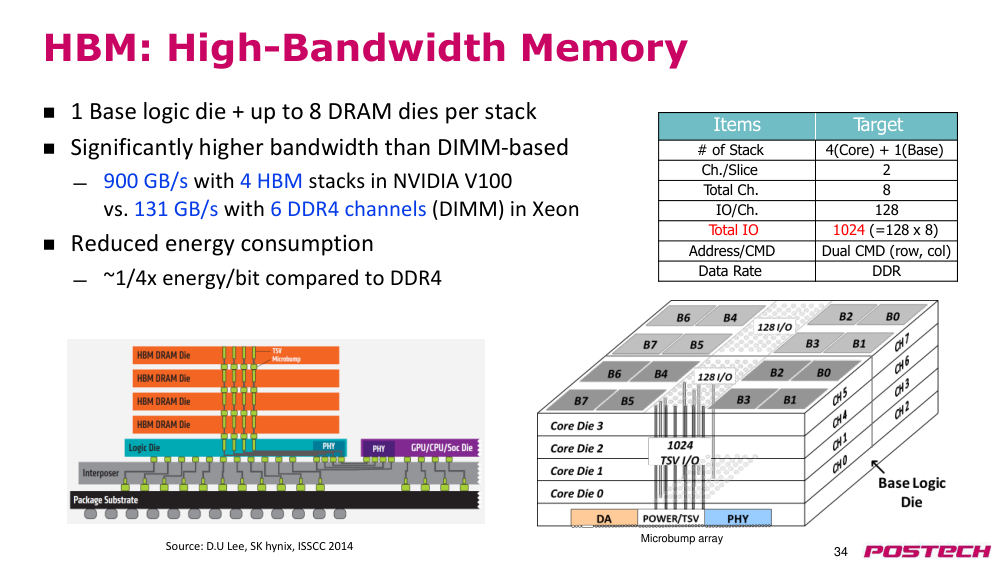
해결HBM: interposer 위 processor 옆에 DRAM die 적층(TSV), die 당 2 channel·channel 당 128-bit, 8 channel = 1024 IO. V100 4 stack 900 GB/s vs Xeon DDR4 6ch 131 GB/s, energy/bit ~1/4
- power: active > idle > power-down > self-refresh
- MT/s 는 data rate(clock 아님)
- 고성능 GPU·TOP500 1위 일본 슈퍼컴 CPU 가 HBM 사용(강의)
2.111:07:10–1:17:40Storage-class memory: PCM, STT-MRAM, 비교
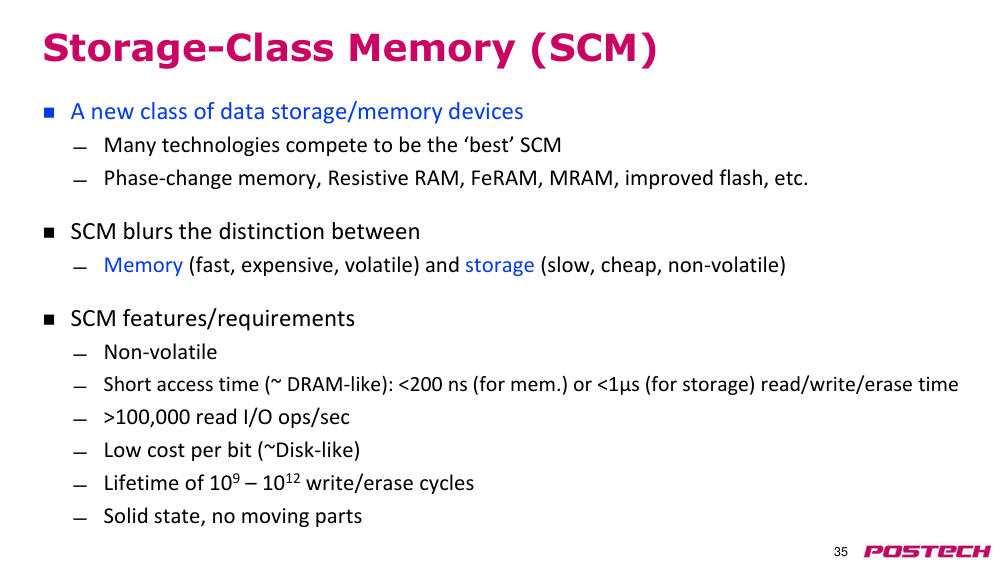
상황·문제DRAM(수십 ns)과 flash 사이 latency gap 이 큼(~1500x)
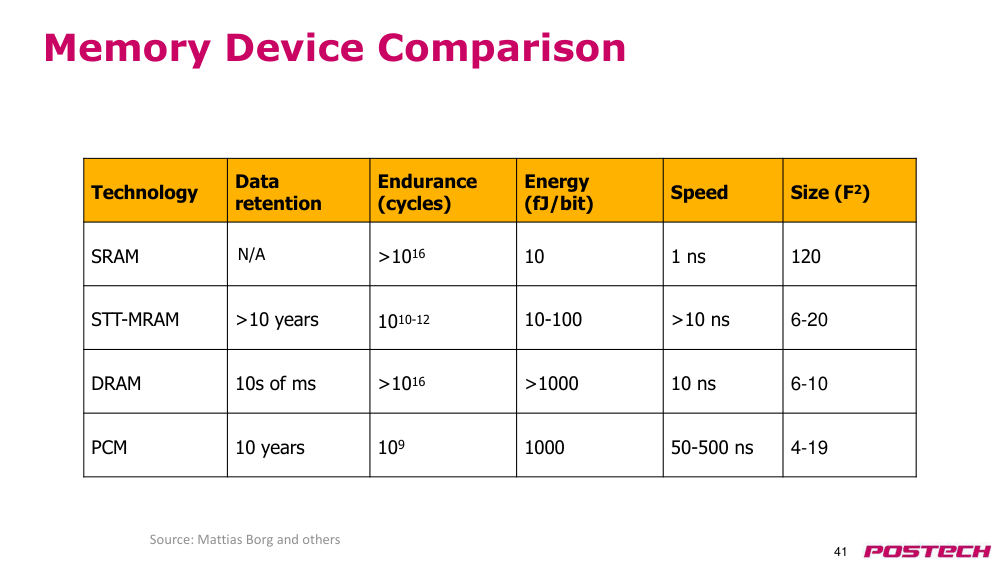
원인SCM 은 non-volatile, DRAM 보다 느리지만(수백 ns) storage 보다 빠르고 비트당 저렴
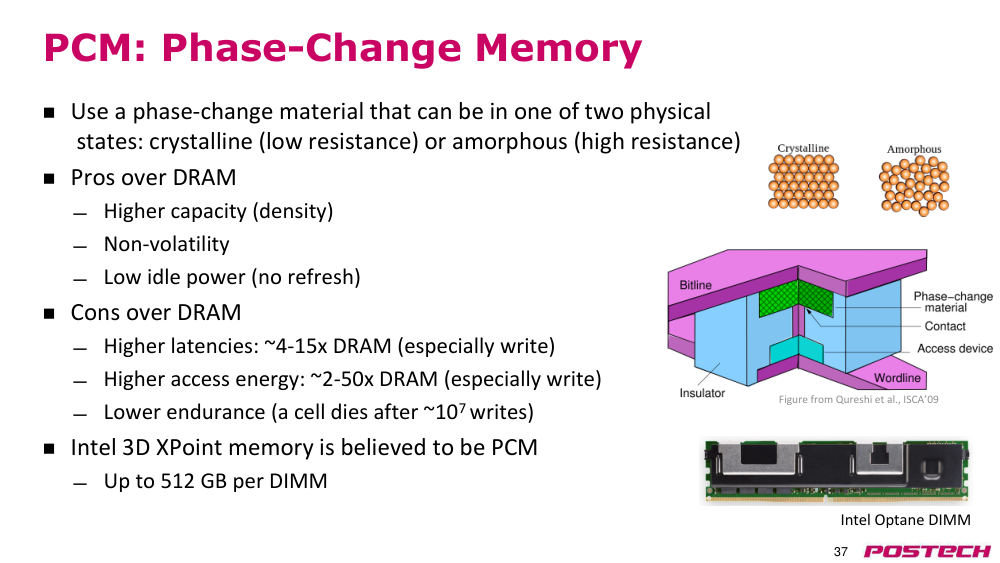
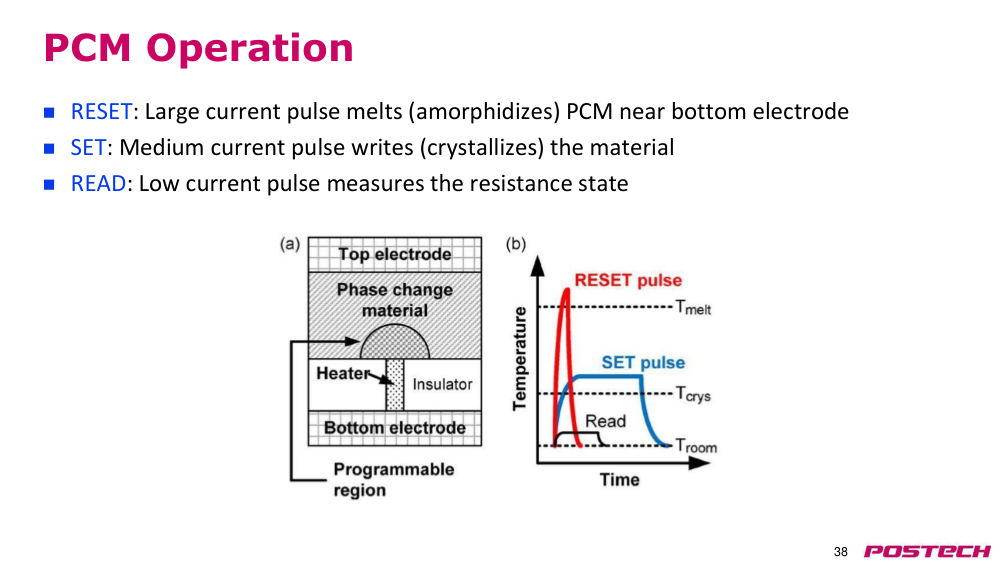
해결PCM: crystalline(저저항)/amorphous(고저항), RESET=melt, SET=중간 전류로 결정화, multi-level 가능, 쓰기 느리고 endurance ~10⁷. STT-MRAM: MTJ, SRAM 보다 dense → LLC 후보
- Intel Optane DIMM 은 PCM 추정, DIMM 당 512 GB
- 4 level = 2 bit, 8 level = 3 bit
- PCM 4-15x latency, 2-50x energy(특히 write)
2.121:17:40–1:18:00마무리
상황·문제질문은 PLMS Q&A 게시판, 추천 읽기 교재 2.2절
2.12.r.1Hennessy & Patterson, Computer Architecture: A Quantitative Approach 6th (Elsevier) ↗ · 추천 읽기 교재 2.2절(Chapter 2 Memory Hierarchy Design)
3핵심 개념
3.1destructive read(파괴적 읽기)
read 시 cell 전하가 bit line 으로 빠져 내용 소실 → sense amp 가 증폭하며 restore
3.1.r.1Wikipedia: Dynamic random-access memory ↗ · 1T1C cell, sense amplifier, 64 ms refresh(JEDEC) 정리
3.3sense amplifier / row buffer(센스 앰프)
bit line 전압 차를 VDD/GND 로 증폭, 열린 row 를 보관
3.3.r.1Wikipedia: Dynamic random-access memory ↗ · 1T1C cell, sense amplifier, 64 ms refresh(JEDEC) 정리
3.4row hit / row conflict(로우 히트/충돌)
열린 row 에 대한 column access 는 hit, 다른 row 면 PRE+ACT 필요
3.5tRCD / tRAS / tRP / tRC
ACT→READ / row 유지 / precharge / ACT→ACT(=tRAS+tRP), DDR3-1066: 15 / 37.5 / 15 / 52.5ns
3.5.r.1Lee et al., Tiered-Latency DRAM (HPCA'13, CMU PDF) ↗ · 슬라이드 11·13 그림 원 논문. tRCD/tRAS/tRP/tRC, DDR3-1066 timing 표
3.6burst length(버스트 길이)
column access 1회에 연속 전송하는 횟수. DDR3/4 8, DDR5 16(강의)
3.7bank-level parallelism(뱅크 수준 병렬성)
여러 bank 의 activate/precharge 를 겹쳐 latency 를 숨김
3.8tRFC / tREFI
refresh 명령 1회 시간 / 명령 발행 간격. 용량↑ → tRFC↑
3.8.r.1Liu et al., RAIDR (ISCA'12, CMU PDF) ↗ · 슬라이드 22 그래프 원 논문. 용량 증가에 따른 refresh latency·throughput·power
3.9per-bank refresh(퍼뱅크 리프레시)
bank 단위 refresh 로 다른 bank 는 계속 요청 처리. LPDDRx
3.9.r.1Chang et al., Parallelizing Refreshes with Accesses (HPCA'14, CMU PDF) ↗ · 슬라이드 23 출처. all-bank vs per-bank refresh(REFpb)
3.10FR-FCFS
row hit 요청 우선, 그다음 oldest. row buffer hit rate·throughput 극대화
3.10.r.1Rixner et al., Memory Access Scheduling (ISCA'00, Rice PDF) ↗ · first-ready 스케줄링(FR-FCFS 원형)과 open/closed precharge policy
3.11open / closed row policy
queue 가 비었을 때 row 를 열어 둘지 닫을지. adaptive 는 예측
3.11.r.1Rixner et al., Memory Access Scheduling (ISCA'00, Rice PDF) ↗ · first-ready 스케줄링(FR-FCFS 원형)과 open/closed precharge policy
3.12HBM(High Bandwidth Memory)
TSV 적층 DRAM + interposer, 8 channel × 128-bit = 1024 IO
3.13storage-class memory(SCM)
DRAM 과 storage 사이의 non-volatile 메모리(PCM, ReRAM, FeRAM, MRAM 등)
3.14PCM(phase-change memory)
crystalline/amorphous 저항 차로 저장. RESET=melt, SET=결정화, multi-level 가능
3.15STT-MRAM
MTJ free layer 자화 방향(parallel/anti-parallel)으로 저항 차 저장, non-volatile
4스스로 확인
4.1DRAM read 가 destructive 인데 data 는 어떻게 유지되나?
답
sense amp 가 bit line 을 VDD/GND 로 증폭하는 동안 cell 도 같은 전압으로 restore
4.2DDR3-1066 에서 같은 bank 의 두 row 를 연속 activate 하려면 최소 몇 ns?
답
tRC = tRAS 37.5 + tRP 15 = 52.5ns
4.364-bit bus, BL 8 이면 column access 1회로 얻는 data 는?
답
64 × 8 = 512 bit = 64B, cache line 하나
4.4per-bank refresh 가 all-bank 보다 유리한 점과 대가는?
답
다른 bank 가 요청 처리 가능, tRFC 짧음 / 대신 더 자주 발행(tREFI 짧음)
4.5FR-FCFS 를 command 수준에서 구현하면?
답
column 명령(READ/WRITE)을 row 명령(ACT/PRE)보다 우선, 같은 group 안에선 older 우선
4.6HBM 한 stack 의 data IO 폭은?
답
8 channel × 128-bit = 1024
5참고 자료
5.1Hennessy & Patterson, Computer Architecture: A Quantitative Approach 6th (Elsevier) ↗ · 추천 읽기 교재 2.2절(Chapter 2 Memory Hierarchy Design)
5.2Rixner et al., Memory Access Scheduling (ISCA'00, Rice PDF) ↗ · first-ready 스케줄링(FR-FCFS 원형)과 open/closed precharge policy
5.4Lee et al., Tiered-Latency DRAM (HPCA'13, CMU PDF) ↗ · 슬라이드 11·13 그림 원 논문. tRCD/tRAS/tRP/tRC, DDR3-1066 timing 표
5.5Liu et al., RAIDR (ISCA'12, CMU PDF) ↗ · 슬라이드 22 그래프 원 논문. 용량 증가에 따른 refresh latency·throughput·power
5.6Chang et al., Parallelizing Refreshes with Accesses (HPCA'14, CMU PDF) ↗ · 슬라이드 23 출처. all-bank vs per-bank refresh(REFpb)