Lec 7 · Tomasulo algorithm: reservation station, CDB, register renaming
정밀 정리 · 검증 2026-09-24 00:47
1개요
1.1Lec6 뒷부분: OoO execution 만으로는 WAR 에 막힌다는 동기에서 Tomasulo algorithm 으로.
1.2reservation station·register renaming·Common Data Bus 구조와 dispatch/issue/write result 3단계.
1.36개 명령어 예제를 cycle 1~57 로 따라가며 WAR 회피와 in-order dispatch·OoO completion 확인.
1.4한계: imprecise exception, CDB 병목, 복잡성. dynamic loop unrolling 과 OoO 역사(1960년대→1990년대 재도입).
2섹션별 정리 상황·문제 → 원인 → 해결
2.10:00–5:46동기: OoO execution 만으로는 WAR 에 막힌다
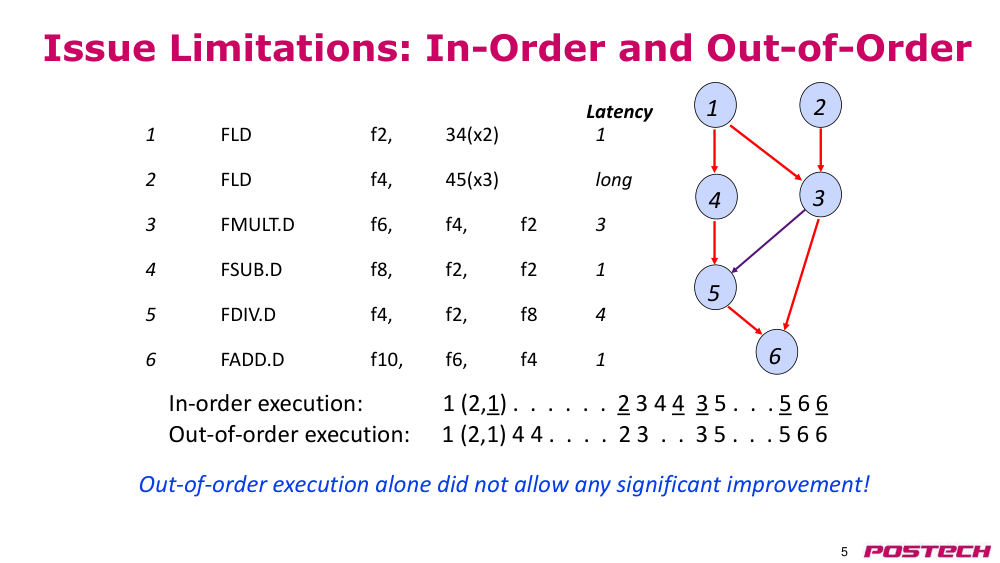
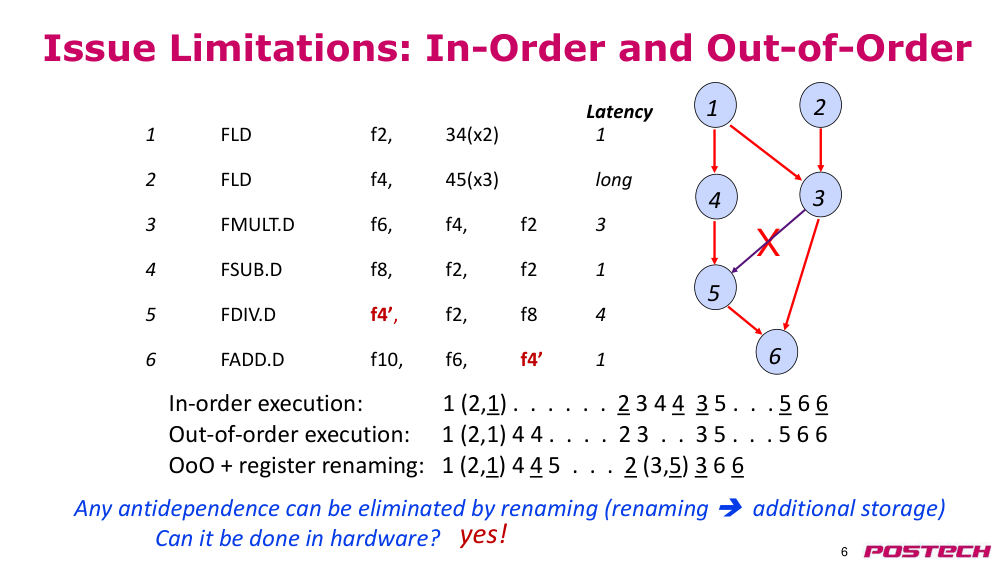
상황·문제2번 FLD 가 cache miss 로 길 때, OoO execution 으로 4번을 먼저 실행해도 5번 FDIV 가 멈춰 전체 성능은 in-order 와 같음.
원인5번이 3번 FMULT 의 source f4 를 덮어쓰는 WAR(write-after-read) false dependence. 강사가 처음엔 FU 공유 탓이라 했다가 정정.
해결5번 목적지를 다른 register(f4')로 renaming 하면 3·5번 동시 실행. Tomasulo 는 RAW 만 지키고 false dependence 를 HW 로 제거.
- OoO execution alone did not allow any significant improvement (p5)
- renaming = 추가 storage, HW 로 가능 (p6)
2.1.r.1Data dependency — Wikipedia ↗ · RAW(true)·WAR(anti)·WAW(output) 정의, name dependence 는 renaming 으로 제거
2.1.r.2Register renaming — Wikipedia ↗ · WAR/WAW false dependence 제거, architectural vs physical register
2.25:46–13:55Tomasulo 개요: RS, renaming, CDB
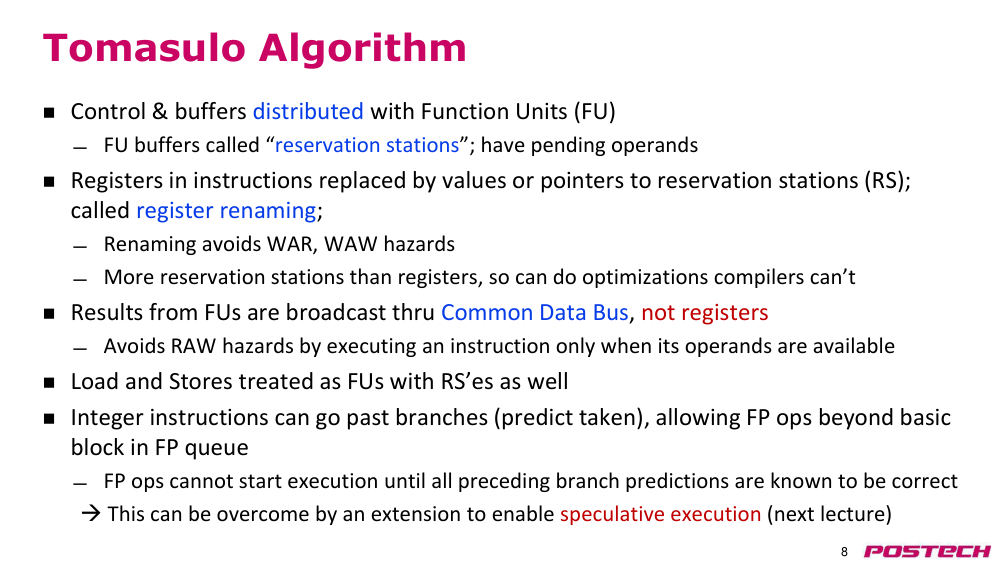
상황·문제360/91 배경(p7)은 이미 다뤄 넘김. Tomasulo 는 FU 옆에 분산된 buffer 와 control 로 동작.
원인명령어가 RS 에 들어갈 때 register 를 값이나 RS pointer 로 바꿔(renaming) register file 에 의존하지 않음. RS 는 compiler 에 보이지 않는 추가 register.
해결결과는 CDB 로 broadcast 해 기다리는 RS 가 직접 복사. load/store buffer 도 RS 역할. FP op 은 앞선 branch 가 확정될 때까지 실행 시작 안 함(speculation 은 다음 강의).
- renaming 으로 WAR·WAW 회피, RAW 는 operand 준비 시 실행으로 해결
- FP op 은 queue 에만 쌓고 branch 확정 전 실행 금지: 틀린 branch 뒤 결과가 architectural register 를 망치기 때문
- 강사가 RS 에 들어갈 수 있다고 했다가 FP op queue 까지만이라고 정정(817초)
2.2.r.1Tomasulo's algorithm — Wikipedia ↗ · reservation station·CDB·register renaming·3단계와 precise exception 문제 정리
2.313:55–16:49Tomasulo organization 그림
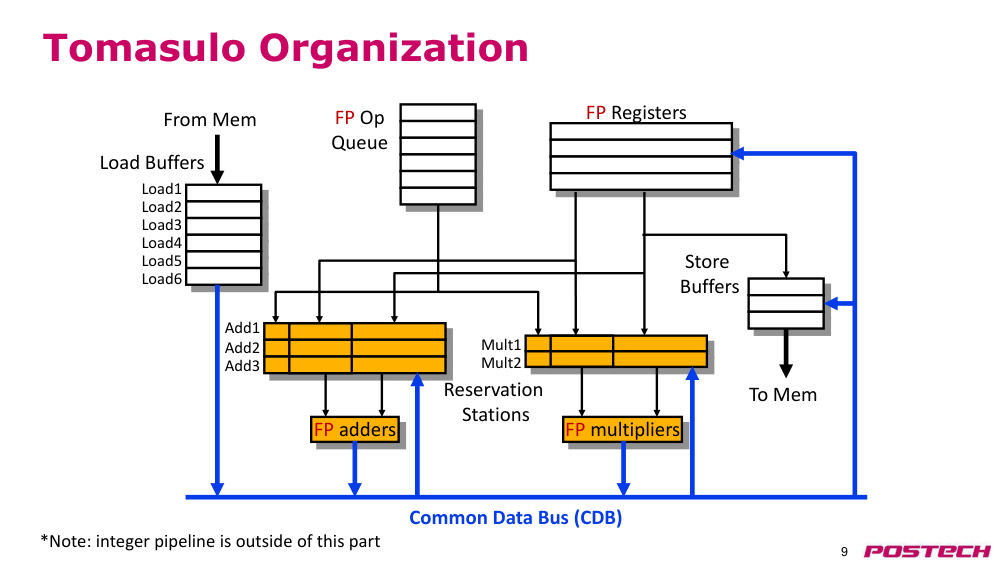
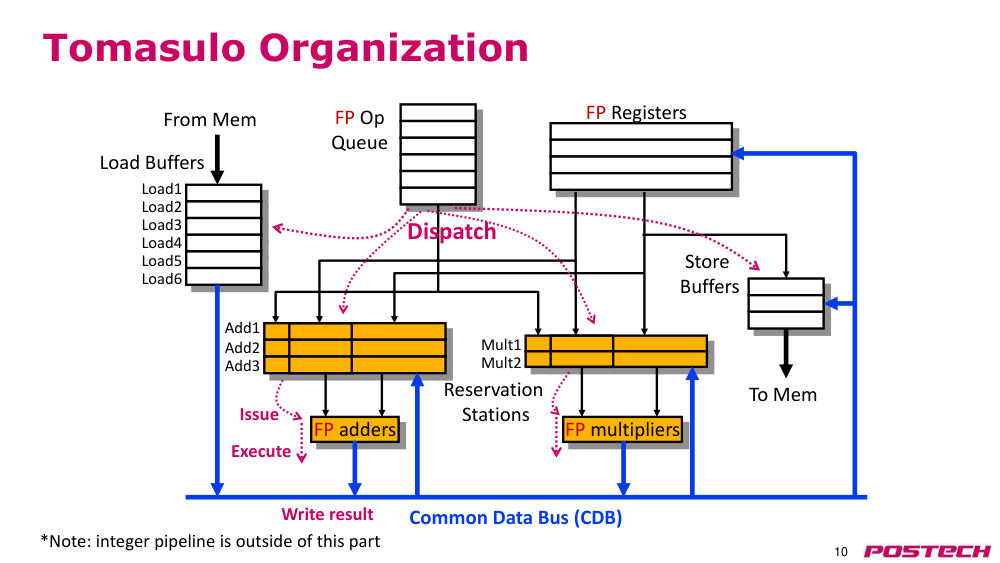
상황·문제Tomasulo 에 필요한 구성 요소와 데이터 흐름.
원인FP op queue 에서 명령어가 adder/multiplier RS 또는 load/store buffer 로 감.
해결FU 결과는 CDB 로 adder·multiplier RS, store buffer, register file 에 동시에 전달되어 여러 entry 를 한 번에 갱신.
- Load1~6, Add1~3, Mult1~2 RS
- 단계: Dispatch → Issue/Execute → Write result (p10)
2.3.r.1Tomasulo's algorithm — Wikipedia ↗ · reservation station·CDB·register renaming·3단계와 precise exception 문제 정리
2.416:49–20:17세 단계와 Common Data Bus
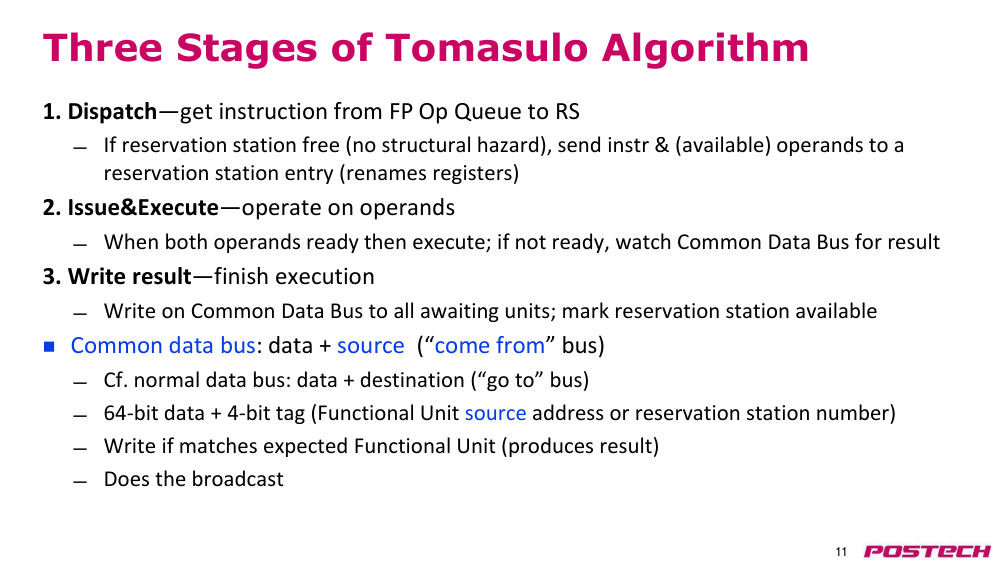
상황·문제명령어 하나가 거치는 단계와 결과 전달 방식.
원인Dispatch 는 빈 RS 가 있어야 가능(없으면 stall), 이때 준비된 operand 를 복사하는 것이 renaming.
해결operand 가 다 준비되면 issue·execute, 아니면 CDB 감시. CDB 는 data + source tag(원 구현 64-bit + 4-bit RS 번호)를 broadcast 하고 tag 일치 entry 가 가져감.
- 일반 bus 는 destination 을 주지만 CDB 는 source 를 줌 ("come from" bus)
2.4.r.1R. M. Tomasulo, An Efficient Algorithm for Exploiting Multiple Arithmetic Units (IBM JRD 1967) — PDF ↗ · 원 논문. common data bus 와 register tagging 을 직접 설명
2.4.r.2Tomasulo's algorithm — Wikipedia ↗ · reservation station·CDB·register renaming·3단계와 precise exception 문제 정리
2.520:17–23:26Reservation station field 와 register result status
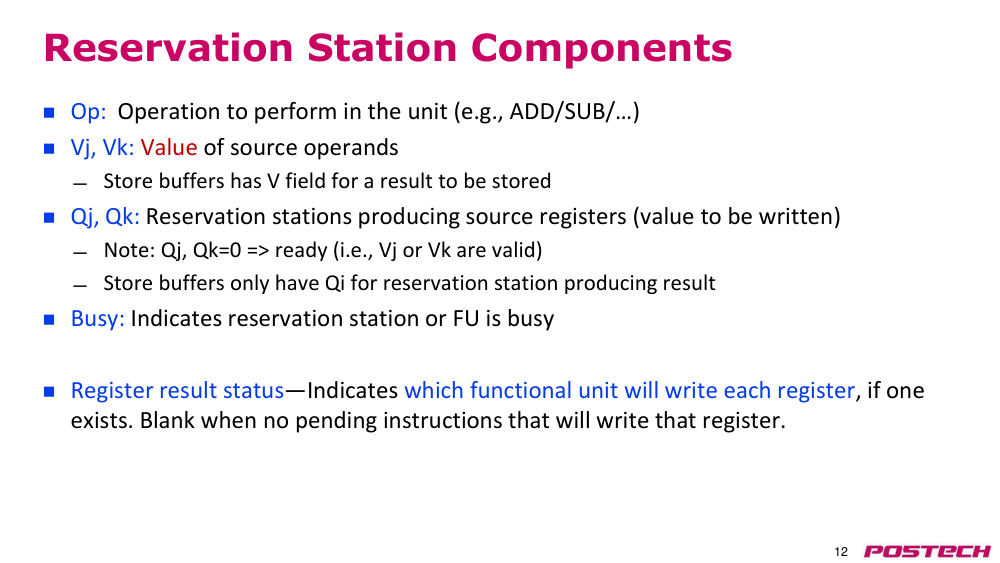
상황·문제RS entry 와 register 상태를 추적할 field 정의.
원인operand 가 dispatch 시점에 없으면 값 대신 만들 RS 의 tag 를 보관해야 함.
해결Op, Vj/Vk(값), Qj/Qk(tag, 0 이면 준비), Busy. store buffer 는 V·Qi 하나씩. register result status 는 register 별로 쓸 RS 를 기록.
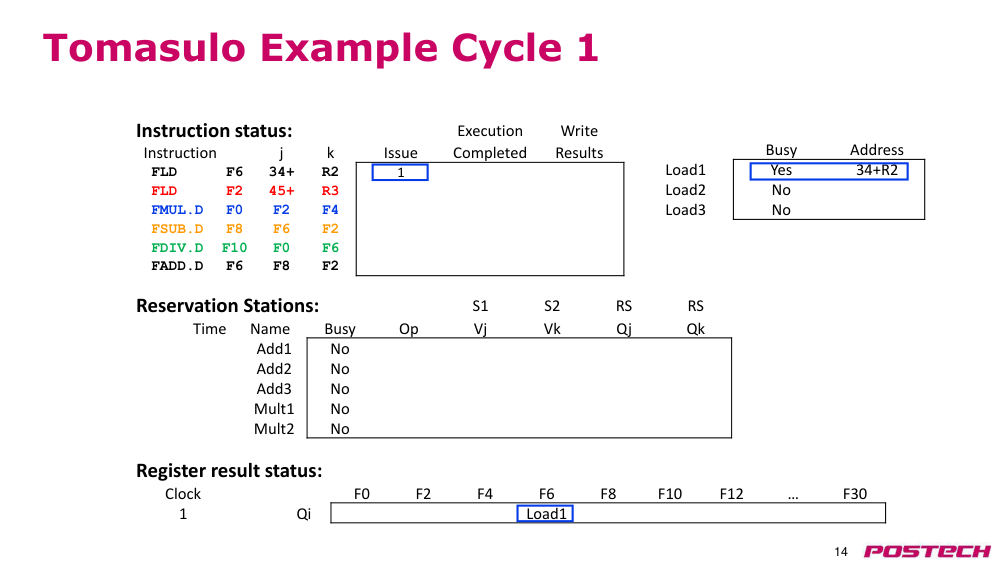
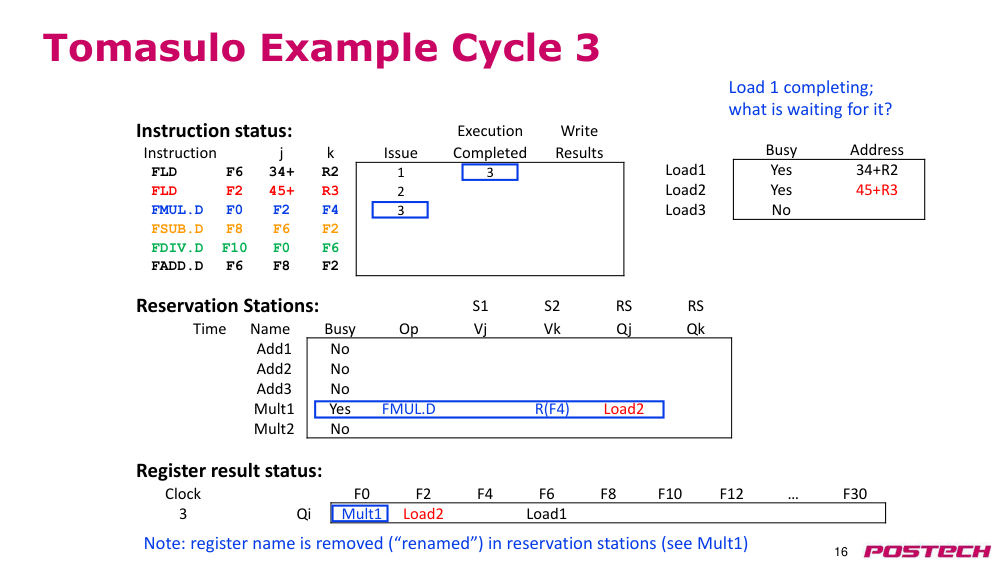
2.623:26–30:55예제 설정과 cycle 1~3
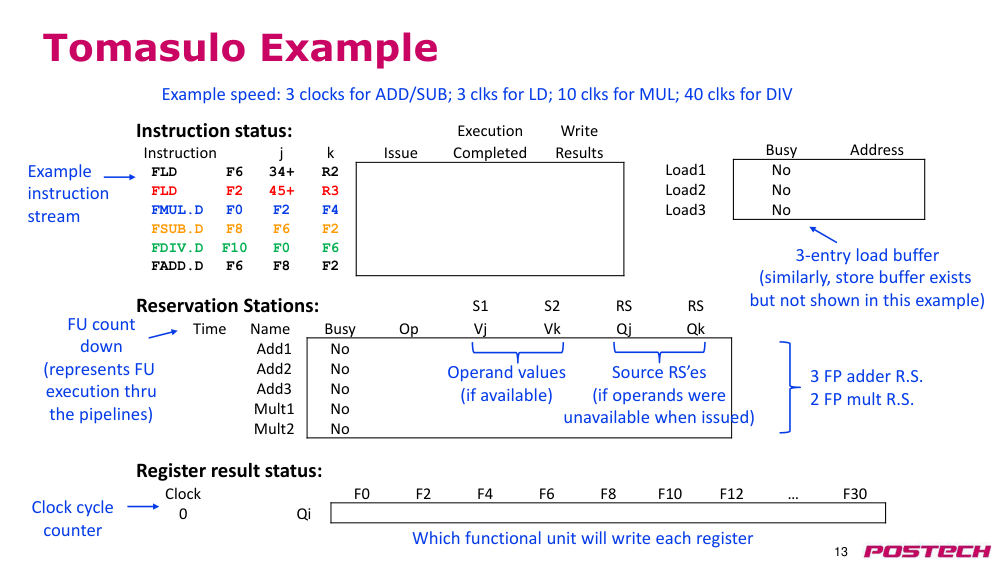
상황·문제6개 명령어 예제, latency ADD/SUB 3·LD 3·MUL 10·DIV 40 (FU 안의 cycle 만).
원인Cycle 1·2 에 FLD 두 개가 Load1·Load2 로 들어가며 F6=Load1, F2=Load2 로 기록.
해결Cycle 3 FMUL.D 는 F2 대신 Qj=Load2, F4 는 값 R(F4) 복사, F0=Mult1. Load1 완료.
- 강사가 load 를 two cycles 라고 잠깐 말했으나 슬라이드·예제는 3 cycle
- load 여러 개 outstanding 가능
2.730:55–37:26Cycle 4~5: CDB write 와 dispatch/issue 용어
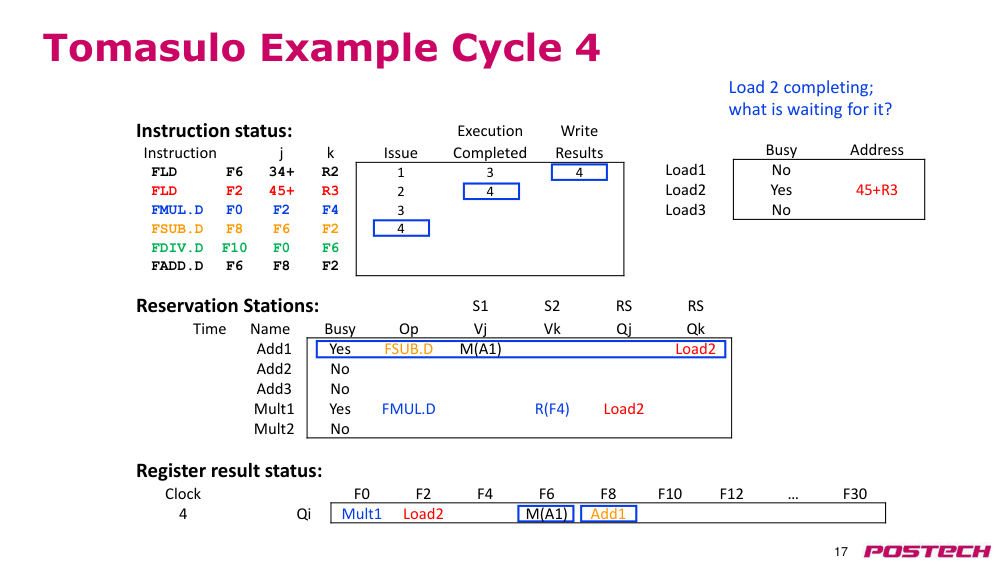
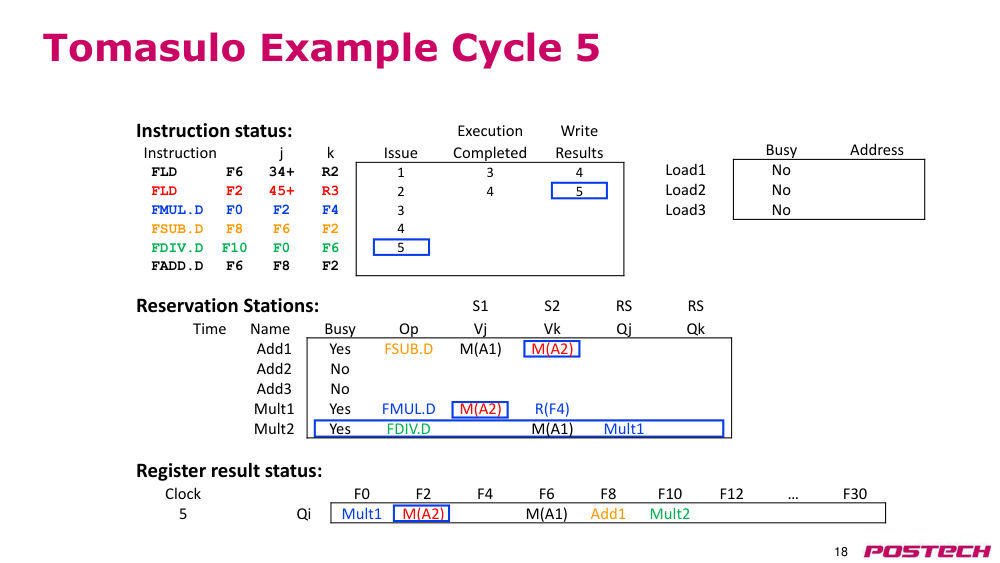
상황·문제Load 결과가 CDB 로 나오며 대기 entry 가 채워짐.
원인Cycle 4 Load1 → F6, FSUB 는 Vj=M(A1)·Qk=Load2. Cycle 5 Load2 → Add1 Vk, Mult1 Vj, F2 가 채워지고 Q 가 지워짐.
해결FDIV 는 Mult2 로(Qj=Mult1, Vk=M(A1)). 이 강의의 dispatch(→RS)를 교재는 issue 라 부르고, 여기서 issue 는 RS→FU.
- tag 일치 시 CDB 값을 V 로 복사하고 Q 를 지움
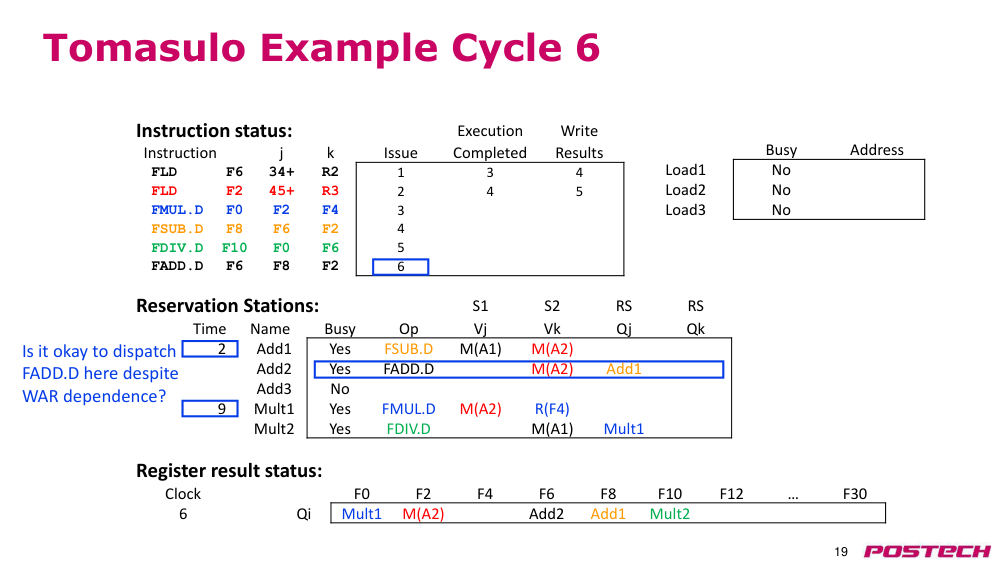
2.837:26–44:01Cycle 6: WAR 가 있어도 FADD 를 dispatch 할 수 있는 이유
상황·문제FADD.D F6 은 앞선 FSUB 가 읽는 F6 에 씀(WAR). Add1·Mult1 실행 시작.
원인FSUB 가 dispatch 될 때 F6 값을 RS 로 이미 복사했고 dispatch 는 in-order 이므로 이후 F6 을 덮어써도 안전.
해결renaming 으로 WAR 제거. WAW 도 같은 방식으로 피함(과제). 강사 설명 중 cycle 5 로 돌아가 확인.
- 자막상 2609초 'right-to-right' 는 문맥상 WAR, 2623초는 WAW
2.8.r.1Register renaming — Wikipedia ↗ · WAR/WAW false dependence 제거, architectural vs physical register
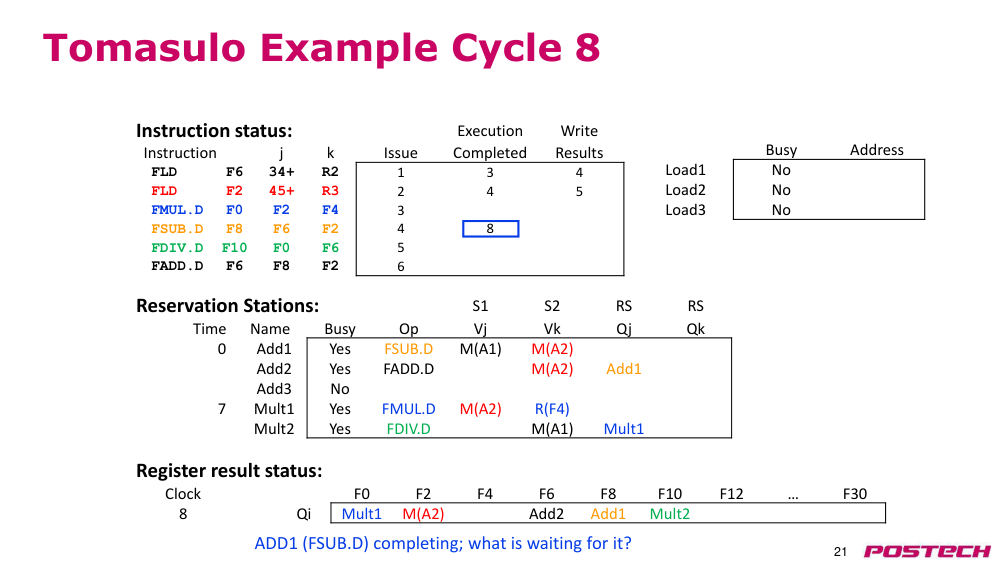
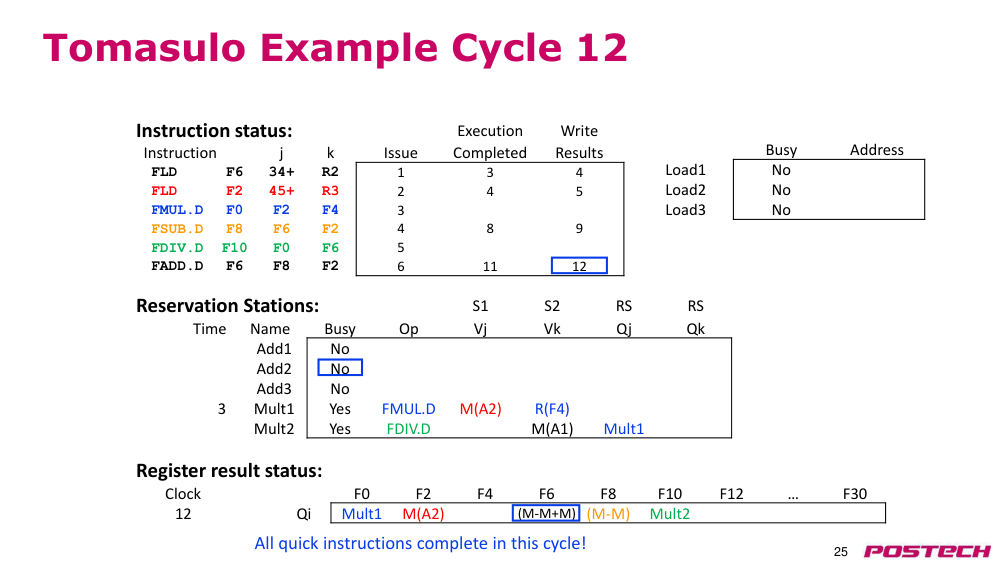
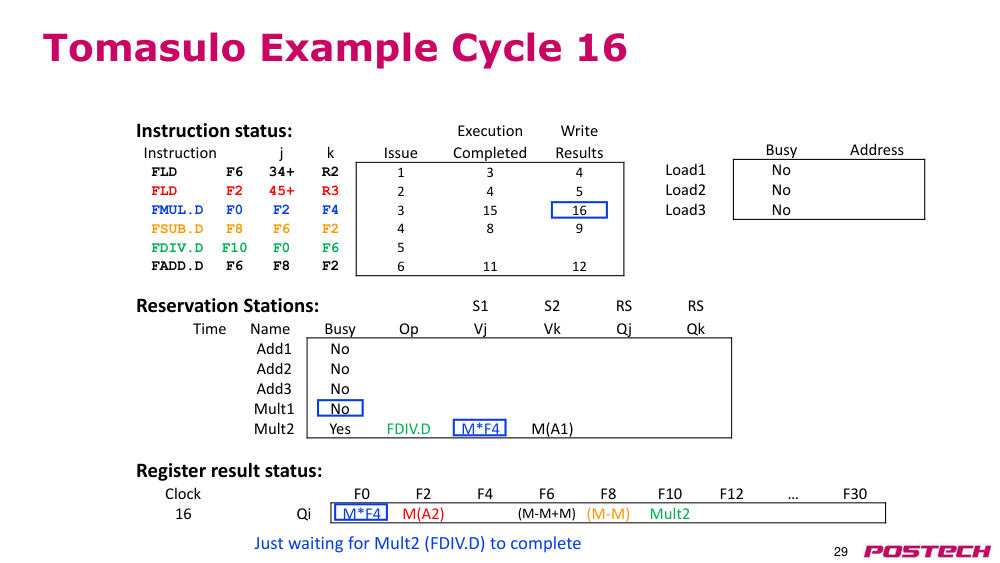
2.944:01–48:53Cycle 7~57: 완료와 write-back
상황·문제남은 명령어가 latency 에 따라 끝나는 과정.
원인Cycle 8 FSUB 완료→9 에 F8·Add2 갱신, FADD 11 완료→12 에 F6. FMUL 15 완료→16 에 F0·Mult2 갱신.
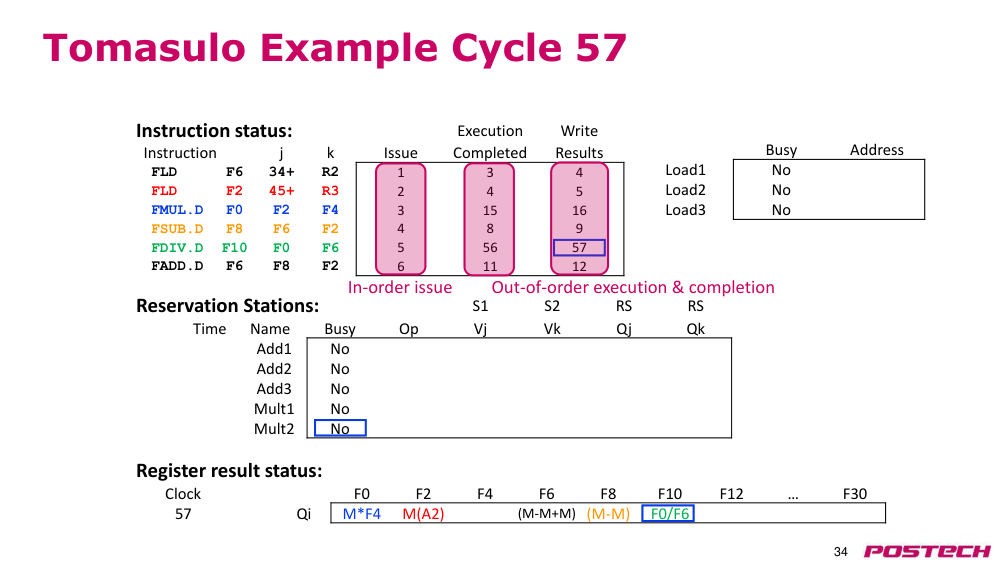
해결FDIV 가 16 부터 실행, 56 완료, 57 에 F10 write 로 종료.
- cycle 17 슬라이드 Clock 칸은 16 으로 오기
2.1048:53–58:23in-order dispatch·OoO completion 과 imprecise exception, 비용
상황·문제dispatch 는 in-order, execution completion 과 write result 는 out-of-order.
원인branch 는 확정 전 FP 실행을 막아 문제가 없지만, FDIV divide-by-zero exception 시 이미 뒤의 FADD 가 F6 을 덮어 복구 불가 → precise exception 불가, OS·program debugging 어려움.
해결다음 강의에서 program order 로 architectural state 를 갱신해 해결. RS field 는 in-order pipeline 에 없던 physical register 라 비용이 늘고 ILP 가 적으면 놀게 됨.
- 학생 질문(RS 로 값 복사 overhead)에 비용 증가를 인정, 많은 application 에서 성능 이득
2.10.r.1Out-of-order execution — Wikipedia ↗ · CDC 6600→360/91→1990년대 재도입 역사, precise exception·memory latency 동기
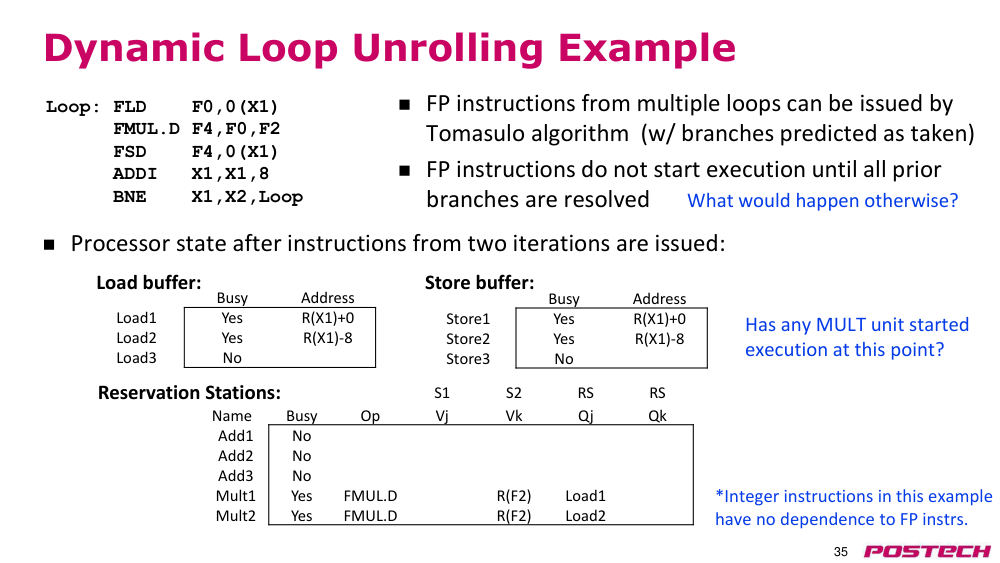
2.1158:23–1:06:12Dynamic loop unrolling
상황·문제compiler loop unrolling 은 architectural register 가 많이 필요하고 부족하면 spill 로 더 느려질 수 있음.
원인Tomasulo 는 RS 라는 추가 physical register 로 여러 iteration 을 겹침. 두 iteration 후 Load1/2, Store1/2, Mult1/2 사용.
해결integer 명령어가 앞서 나가 FP op 을 queue 에 쌓고, FP op 은 앞선 branch 확정 후 실행. 확정 전 실행하면 잘못된 iteration 이 register 를 덮어 틀린 결과.
- 슬라이드 ADDI X1,X1,8 은 주소 R(X1)-8 과 맞지 않아 감소여야 한다고 강사 지적
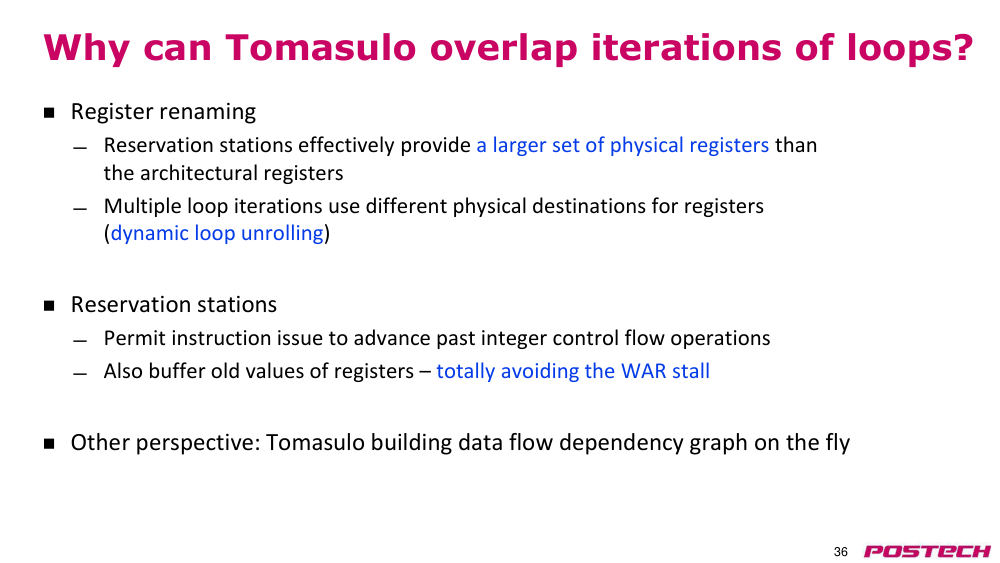
2.121:06:12–1:09:40Tomasulo 가 iteration 을 겹칠 수 있는 이유
상황·문제p36 정리.
원인RS 가 architectural 보다 많은 physical register 제공, 옛 register 값을 buffer 해 WAR·WAW stall 제거.
해결operand 준비 시 실행 = dataflow graph 를 실행 중 구성. 'control flow 를 넘어 issue' 항목은 강사가 오해 소지가 있어 다음 강의에서 정정하겠다고 함.
- 정정 요지: RS 로 dispatch 는 하되 branch 확정 전에는 issue 를 막는 형태
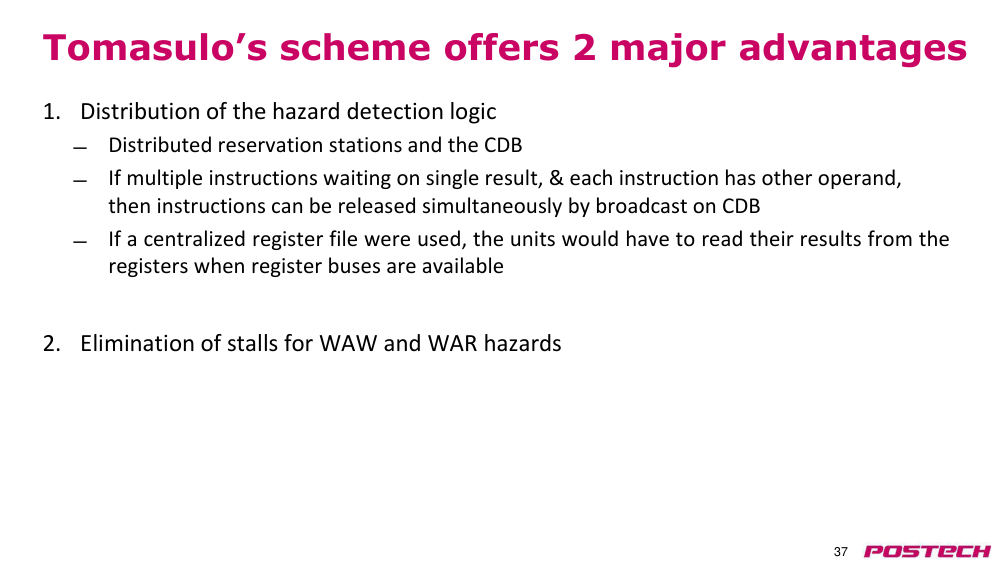
2.131:09:40–1:11:49장점: 분산 hazard detection 과 CDB broadcast
상황·문제RAW 검사를 RS 마다 수행.
원인중앙 register file 이면 먼저 쓰고 FU 들이 cycle 마다 하나씩 읽어야 함.
해결CDB broadcast 로 같은 결과를 기다리는 여러 명령어가 같은 cycle 에 시작. WAR·WAW 회피.
2.141:11:49–1:13:53단점: 복잡성, CDB 병목, imprecise interrupt
상황·문제구현이 복잡해 360/91 등 제품이 지연.
원인CDB 는 모든 unit 에 broadcast 하는 high capacitance·high wiring density bus 라 clock 을 올리기 어렵고, cycle 당 하나의 FU 만 write.
해결CDB 를 여러 개 두면 RS 마다 여러 bus 와 비교해 비용 증가. non-precise interrupt 도 단점.
2.14.r.1Out-of-order execution — Wikipedia ↗ · CDC 6600→360/91→1990년대 재도입 역사, precise exception·memory latency 동기
2.151:13:53–1:18:30OoO 의 쇠퇴와 1990년대 이후 재도입, 요약
상황·문제OoO 는 1960년대 상용화 뒤 1990년대까지 사라짐.
원인precise trap(→ 다음 강의 reorder buffer)과 정확한 branch prediction 이 없었고, 공정 발전이 빨라 단순 core + on-chip cache 가 유리했음.
해결이후 memory 가 상대적으로 느려져 latency hiding 이 중요, compiler 최적화 의존 감소, wider issue·deeper pipeline 의 ILP 필요로 desktop·laptop·smartphone 대부분이 OoO 사용.
2.15.r.1Out-of-order execution — Wikipedia ↗ · CDC 6600→360/91→1990년대 재도입 역사, precise exception·memory latency 동기
3핵심 개념
3.1WAR(write-after-read)·WAW(write-after-write) hazard
name(false) dependence. 뒤 명령어가 앞 명령어의 source/destination register 를 먼저 덮어쓰는 위험.
3.1.r.1Data dependency — Wikipedia ↗ · RAW(true)·WAR(anti)·WAW(output) 정의, name dependence 는 renaming 으로 제거
3.2reservation station(예약 스테이션, RS)
FU 옆 buffer. Op, Vj/Vk, Qj/Qk, Busy 로 operand 값이나 생산자 tag 를 보관.
3.3register renaming(레지스터 이름 재할당)
dispatch 때 register 를 값 또는 RS tag 로 바꿔 WAR·WAW 제거.
3.3.r.1Register renaming — Wikipedia ↗ · WAR/WAW false dependence 제거, architectural vs physical register
3.4Common Data Bus(공통 데이터 버스, CDB)
data + source tag 를 broadcast, tag 가 일치하는 RS·register 가 가져감.
3.4.r.1Tomasulo's algorithm — Wikipedia ↗ · reservation station·CDB·register renaming·3단계와 precise exception 문제 정리
3.5dispatch vs issue
이 강의: dispatch = FP queue→RS(in-order), issue = RS→FU. 교재는 앞쪽을 issue 라 부름.
3.6register result status(레지스터 결과 상태)
register 마다 값을 쓸 RS 이름(Qi). 비어 있으면 register file 값이 최신.
3.7imprecise exception(부정확한 예외)
OoO write-back 으로 exception 명령어 뒤의 결과가 이미 반영돼 상태 복구 불가.
3.7.r.1Out-of-order execution — Wikipedia ↗ · CDC 6600→360/91→1990년대 재도입 역사, precise exception·memory latency 동기
3.8dynamic loop unrolling(동적 루프 전개)
RS 의 추가 physical register 로 여러 iteration 을 HW 에서 겹쳐 실행.
3.9dataflow execution
operand 가 준비되면 실행. Tomasulo 는 dataflow graph 를 실행 중에 구성.
4스스로 확인
4.1p5 예제에서 OoO execution 만으로 성능이 거의 안 오른 이유는?
답
5번 FDIV 가 3번 FMULT 의 source f4 에 쓰는 WAR 때문에 3번을 기다려야 함.
4.2CDB 가 일반 bus 와 다른 점은?
답
destination 대신 source(RS 번호 tag)를 data 와 함께 broadcast, 대기 entry 가 tag 비교로 가져감.
4.3Qj=0 의 의미는?
답
첫 operand 를 기다리지 않음, 즉 Vj 값이 유효.
4.4cycle 6 에 FADD.D F6 을 WAR 가 있어도 dispatch 할 수 있는 이유는?
답
앞선 FSUB 가 dispatch 때 F6 값을 RS 로 복사했고 dispatch 가 in-order 이기 때문.
4.5예제에서 FDIV 가 write result 하는 cycle 과 그 전 실행 시작 cycle 은?
답
16 에 F0 을 받아 실행 시작, 56 완료, 57 write.
4.6Tomasulo 에서 precise exception 이 안 되는 이유는?
답
register 를 out-of-order 로 갱신해 FDIV exception 전에 뒤의 FADD 가 F6 을 이미 덮어씀.
4.7CDB 가 병목이 되는 두 이유는?
답
high capacitance·wiring 으로 고속 동작 어려움, cycle 당 FU 하나만 write.
5참고 자료
5.1Computer Architecture: A Quantitative Approach, 6th ed. — Elsevier ↗ · 교재. 덱 권장 읽기 Chapter 3.4–3.5
5.2Tomasulo's algorithm — Wikipedia ↗ · reservation station·CDB·register renaming·3단계와 precise exception 문제 정리
5.3R. M. Tomasulo, An Efficient Algorithm for Exploiting Multiple Arithmetic Units (IBM JRD 1967) — PDF ↗ · 원 논문. common data bus 와 register tagging 을 직접 설명
5.4Out-of-order execution — Wikipedia ↗ · CDC 6600→360/91→1990년대 재도입 역사, precise exception·memory latency 동기