이 자료를 쓰는 강의: 59 GPGPU (범용 GPU 컴퓨팅)과 CUDA programming model · 60 CUDA 예제·warp divergence 와 domain-specific accelerator(DNN·systolic array·TPU)
Lec21-ParallelArchitectures II
한국어판 강의자료 · 41쪽
p.1CSED311 컴퓨터구조 – 강의 21
- 병렬 아키텍처 II – GPGPU
- Gwangsun Kim
- Department of Computer Science and Engineering
- POSTECH
- 면책 조항: 슬라이드는 Carnegie Mellon University, University of Michigan, Purdue University, University of Pennsylvania, University of Wisconsin의 교수진 Austin, Brehob, Falsafi, Hill, Hoe, Lipasti, Martin, Roth, Shen, Smith, Sohi, Tyson, Vijaykumar, Mutlu, Wenisch 등이 부분적으로 개발함
p.2GPGPU의 역사
- GPGPU: 그래픽스 처리 장치에서의 일반 목적 컴퓨팅
p.3실시간 컴퓨터 그래픽스 데모
- 링크: https://www.youtube.com/watch?v=NgcYLIvlp_k
p.4GPU가 빠르게 필요하는 이유
- GPGPU: 그래픽스 처리 장치에서의 일반 목적 컴퓨팅
- 엄청난 FLOP 요구사항
- 풀 HD 1080p 화면 해상도: 200만 픽셀
- 50-100 Hz 리프레시 레이트
- 정점당 10-100 연산
- 프래그먼트(프로토-픽셀)당 100-1000 연산
- 이것들은 CPU의 핵심에서 수행되는 연산(덧셈, 곱셈, 비교 등)과 본질적으로 동일함
- 엄청난 bandwidth(대역폭) 요구사항
- 여러 텍스처 맵에서 텍스처링
- bilinear(쌍선형) 및 anisotropic(이방성) filtering(필터링)
- 전면화면 안티앨리어싱
- 성능 요구가 끝없이 커짐
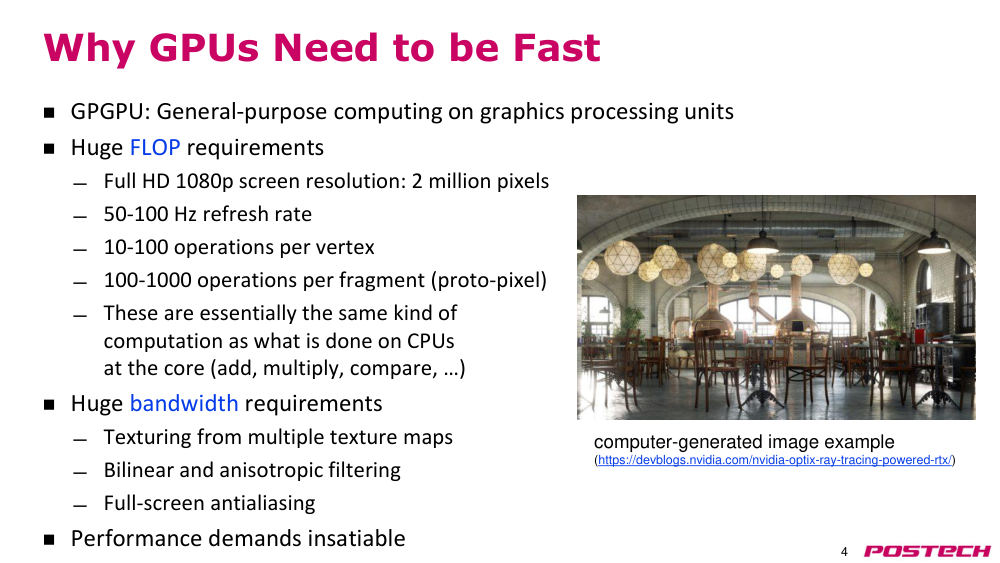
- 컴퓨터 생성 이미지 예시 (https://devblogs.nvidia.com/nvidia-optix-ray-tracing-powered-rtx/)
p.5그래픽 워크로드
- 본질적으로 대규모 병렬성
- task parallelism(태스크 병렬성) 및 data parallelism(데이터 병렬성)
- 정점들 병렬 처리
- 픽셀(프래그먼트)들 병렬 처리
- 모두 동시에
- 100만 배의 격차
- 인간 시각 시스템: 밀리초 단위
- GHz 프로세서: 나노초 단위
- 개별 연산의 지연은 (그렇게) 중요하지 않음
- throughput(처리량)이 최대화됨
- GPU 하드웨어는 이러한 관찰에 기반하여 설계됨
p.6그래픽스 파이프라인
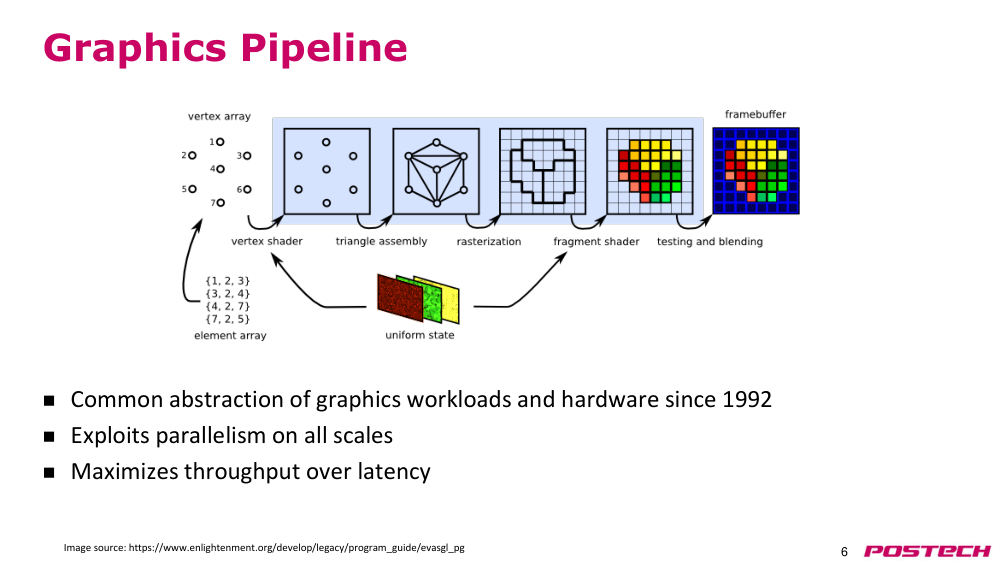
- 1992년부터 그래픽 워크로드와 하드웨어의 일반적인 추상화
- 모든 규모의 병렬성을 활용함
- 지연보다 throughput(처리량)을 최대화함
- 이미지 출처: https://www.enlightenment.org/develop/legacy/program_guide/evasgl_pg
p.7초기 GPGPU
- GPGPU: 그래픽스 처리 장치에서의 일반 목적 컴퓨팅
- GPU의 높은 성능이 개발자들을 끌어모았다
- GPU를 사용하기 위해 알고리즘을 그래픽 계산으로 다시 표현해야 했다
- 매우 번거롭고, 사용성에 한계가 있었다
- 그럼에도 불구하고 매우 좋은 결과를 얻을 수 있었다
- 이것이 CUDA로 이어지는 계기였다
- Buck et al., SIGGRAPH’04
p.8CUDA (Compute Unified Device Architecture)
- NVIDIA가 개발한 GPU 프로그래밍 인터페이스 (링크)
- 산업 표준 C/C++ 기반
- GPGPU를 가능하게 하는 소규모 확장 제공
- 병렬성은 서로 다른 데이터 파티션에 대해 거의 동일한 계산을 수행하는 thread(스레드)로 표현됨
- 프로그래머가 표현해야 할 내용:
- - GPU에 launch(실행)할 thread(스레드)와 실행 방법
- - host(호스트)와 GPU 간의 데이터 조직 및 이동
- - synchronization(동기화), memory management(메모리 관리), 테스트 등
- CUDA는 이질적 아키텍처를 지원한 초기 사례 중 하나이다
- CUDA 환경:
- - compiler(컴파일러), runtime(런타임) 유틸리티, 라이브러리, emulation(에뮬레이션), profiling(성능 프로파일링) 등
- CUDA는 NVIDIA 전용이며, 다른 하드웨어 제조사에게는 개방되지 않는다
p.9OpenCL (오픈 컴퓨팅 언어)
- 병렬적이고 계산 집약적인 애플리케이션 개발을 위한 오픈, 로열티 없는 표준
- Apple이 주도하고, Khronos 그룹이 사양을 유지 관리
- 여러 장치 클래스를 지원: CPU, GPU, DSP, Cell 등
- OpenCL의 data-parallel execution model(데이터 병렬 실행 모델)은 CUDA와 유사하지만 용어가 다름
- 호환되는 장치 제조사들이 SDK 및 도구를 제공
- OpenCL은 CUDA만큼 성공하지 못함
- AMD는 최근 CUDA의 오픈소스 대안으로 ROCm(링크)을 발표
p.10피크 성능 비교
p.11왜 딥러닝이 지금 핫한가?
- GPU 가속
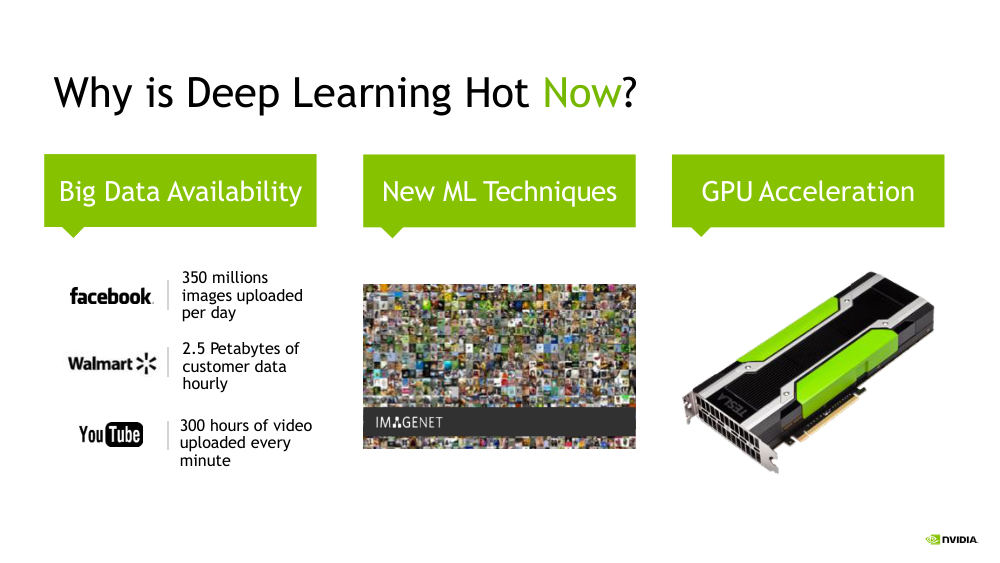
- 하루에 3억 5천만 장의 이미지 업로드
- 시간당 2.5 페타바이트의 고객 데이터
- 매 분마다 300시간의 영상 업로드
- 새로운 ML 기법
- 빅데이터의 가용성
p.12대규모 시스템에서의 GPU
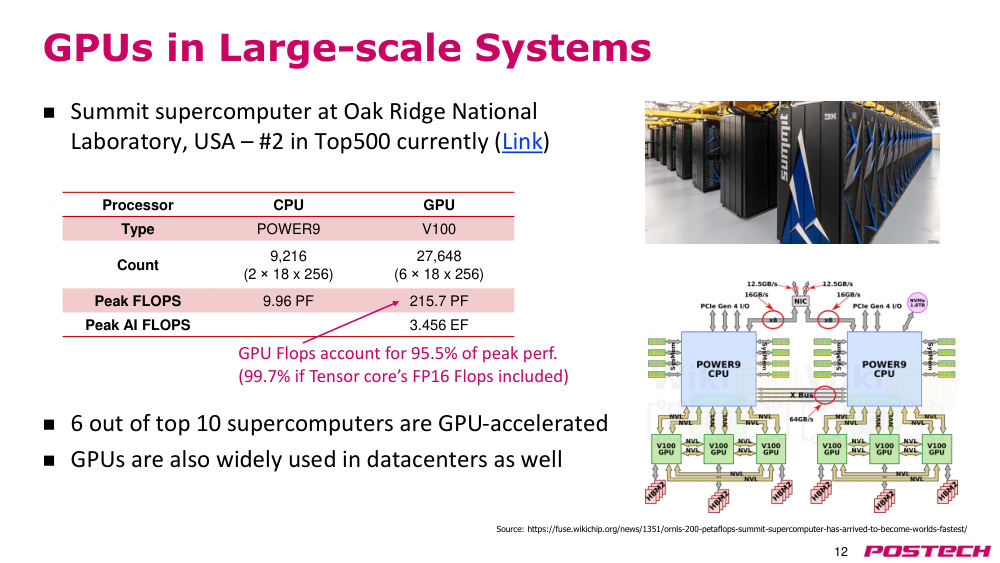
- Oak Ridge National Laboratory, USA의 Summit supercomputer(슈퍼컴퓨터) – 현재 Top500 2위 (링크)
- 상위 10개 슈퍼컴퓨터 중 6개가 GPU 가속을 지원
- GPU는 데이터센터에서도 널리 사용됨
- 출처: https://fuse.wikichip.org/news/1351/ornls-200-petaflops-summit-supercomputer-has-arrived-to-become-worlds-fastest/
- 프로세서:
- - CPU: POWER9
- - GPU: V100
- 수량:
- - CPU: 9,216 (2 × 18 × 256)
- - GPU: 27,648 (6 × 18 × 256)
- peak FLOPS(피크 FLOPS):
- - CPU: 9.96 PF
- - GPU: 215.7 PF
- 피크 AI FLOPS:
- - CPU: 3.456 EF
- GPU FLOPS는 피크 성능의 95.5% 차지
- (텐서 코어의 FP16 FLOPS를 포함하면 99.7%)
p.13CPU와 GPU의 비교
- 다른 목적이 다른 설계를 초래함
- CPU: 시리얼 작업에 최적화됨
- 지연 민감 – 각 thread(스레드)가 경험하는 지연을 최소화함
- 큰 on-chip cache(온칩 캐시) 보유
- 복잡한 control logic(제어 논리)
- GPU: 병렬 작업에 최적화됨
- 대규모 thread-level parallelism(TLP, 스레드 수준 병렬성)을 통해 throughput(처리량)을 극대화함
- • GPU는 완전한 활용을 위해 1,000개 이상의 thread(스레드)가 필요함 (GA100에서 2,048 스레드/SM)
- bandwidth(대역폭) 민감, 지연에 관용적 (다중 스레딩이 지연을 숨김 – context switch(컨텍스트 전환)에 비용 없음)
- in-flight thread(실행 중 스레드) 수는 자원에 의해 제한됨 → 많은 자원 필요 (레지스터, bandwidth(대역폭) 등)
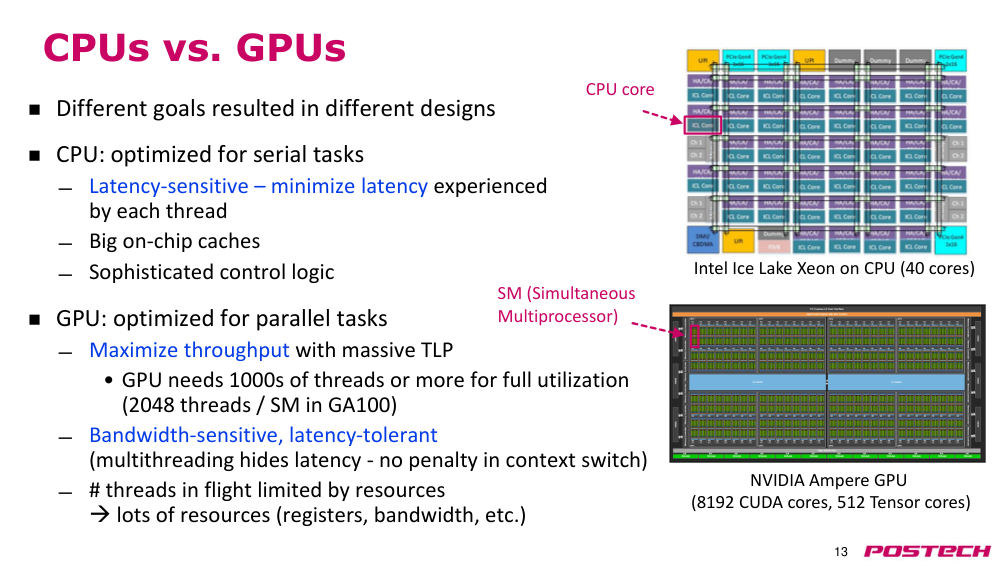
- Intel Ice Lake Xeon CPU (40코어)
- NVIDIA Ampere GPU (8,192 CUDA 코어, 512 Tensor 코어)
- 스트리밍 멀티프로세서 (SM)
- CPU 코어
p.14heterogeneous computing(이질적 컴퓨팅)
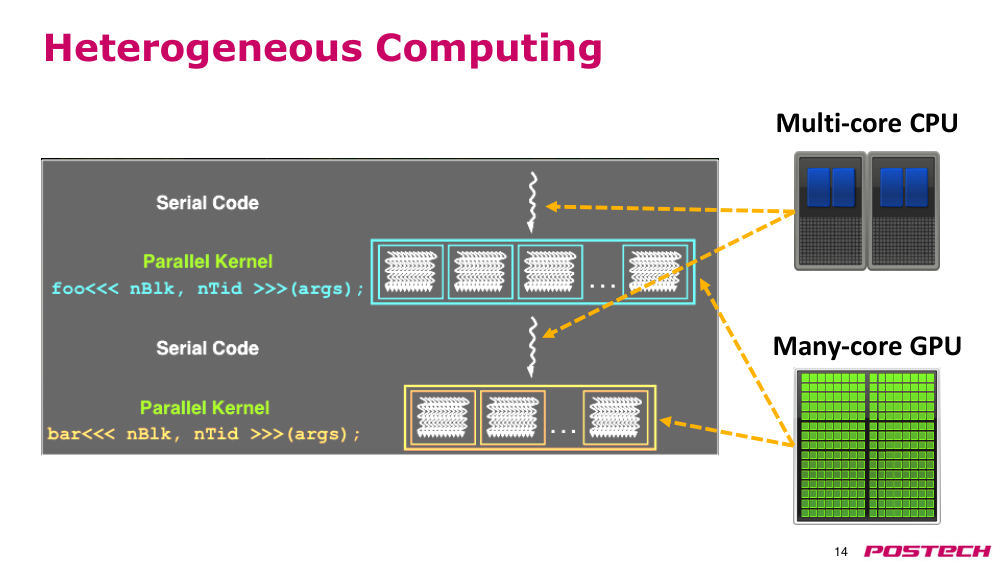
- 다중 코어 CPU
- 다수 코어 GPU
p.15더 높은 효율성
- 여러 픽셀/정점에 대해 동일한 작업을 수행함을 주목
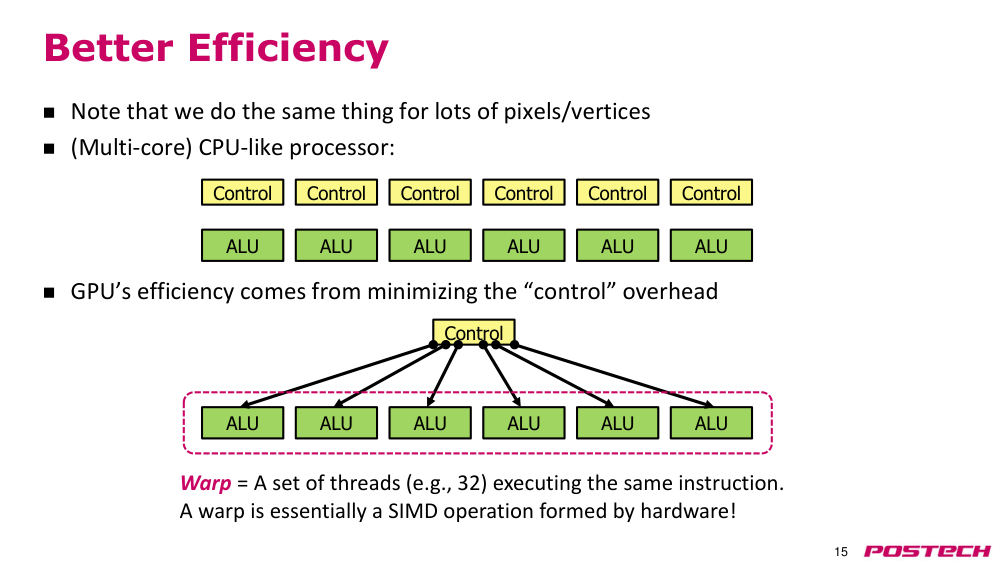
- (다중 코어) CPU 유사 프로세서:
- GPU의 효율성은 '제어' 오버헤드를 최소화함으로써 나옴
- ALU
- control logic(제어 논리)
- ALU
- control logic(제어 논리)
- ALU
- control logic(제어 논리)
- ALU
- control logic(제어 논리)
- ALU
- control logic(제어 논리)
- ALU
- control logic(제어 논리)
- warp(워프) = 동일한 명령을 execute(실행)하는 thread(스레드) 집합 (예: 32개)
- warp(워프)는 하드웨어에 의해 형성된 실질적인 SIMD 연산임!
- ALU
- ALU
- ALU
- control logic(제어 논리)
- ALU
- ALU
- ALU
p.16NVIDIA A100 SM (streaming multiprocessor(SM, 스트리밍 멀티프로세서))
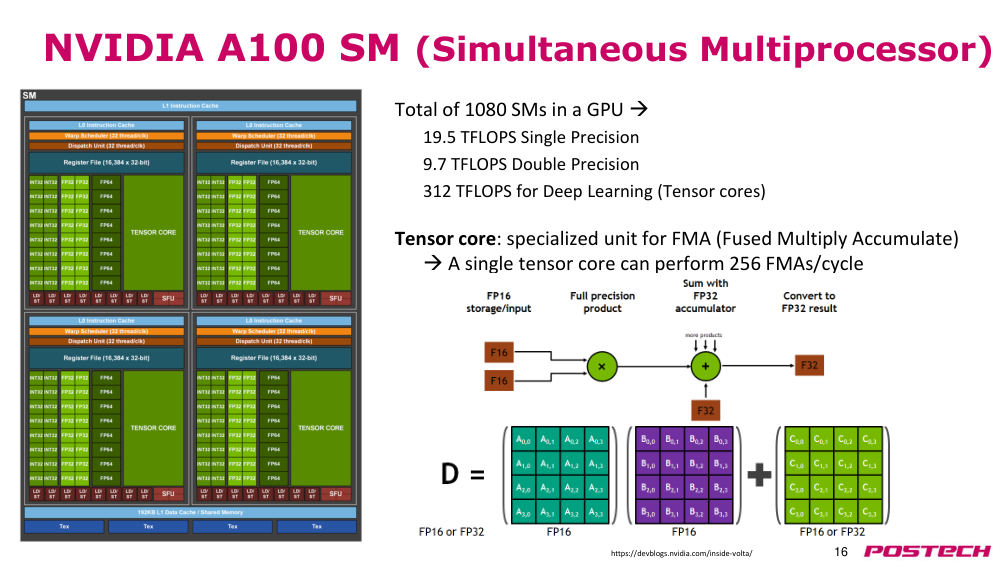
- GPU 내 총 1,080개의 SM →
- 싱글 정밀도: 19.5 TFLOPS
- 더블 정밀도: 9.7 TFLOPS
- 딥러닝용: 312 TFLOPS (Tensor 코어)
- tensor core(텐서 코어): FMA (융합 곱셈 누산) 전용 단위
- → 단일 tensor core(텐서 코어)는 1사이클당 256개의 FMA 수행 가능
- https://devblogs.nvidia.com/inside-volta/
p.17warp(워프) 수준의 세밀한 다중 스레딩 (Fine-grained Multi-threading)
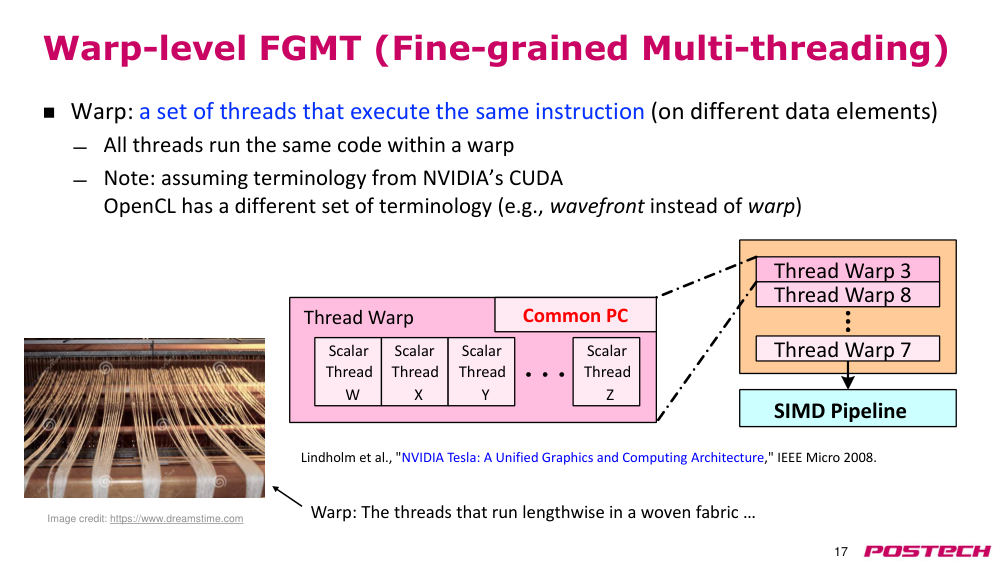
- warp(워프): 동일한 명령을 execute(실행)하는 thread(스레드) 집합 (다른 데이터 요소에서)
- warp(워프) 내 모든 thread(스레드)는 동일한 코드를 execute(실행)함
- 참고: NVIDIA의 CUDA 용어 기준 가정
- OpenCL은 다른 용어 체계 사용 (예: warp(워프) 대신 웨이브프론트)
- thread(스레드) warp(워프) 3
- thread(스레드) warp(워프) 8
- thread(스레드) warp(워프) 7
- thread(스레드) warp(워프)
- 스칼라 thread(스레드)
- W
- 스칼라 thread(스레드)
- X
- 스칼라 thread(스레드)
- Y
- 스칼라 thread(스레드)
- Z
- 공통 PC
- SIMD 파이프라인
- Lindholm et al., "NVIDIA Tesla: A Unified Graphics and Computing Architecture," IEEE Micro 2008.
- 이미지 출처: https://www.dreamstime.com
- warp(워프): 직조된 천에서 길게 뻗은 thread(스레드)들 …
p.18GPU는 SIMD (SIMT) 기계이다
- 단, SIMD 명령어를 사용해 프로그래밍하지는 않음
- thread(스레드)를 사용해 프로그래밍함 – SPMD (단일 프로그램 다중 데이터) 모델
- 각 thread(스레드)는 동일한 코드를 execute(실행)하지만 다른 데이터 조각을 처리함
- 각 thread(스레드)는 자체 컨텍스트를 가짐 (즉, 독립적으로 처리/재시작/execute(실행) 가능)
- SIMT (단일 명령 다중 스레드) execution(실행)
- thread(스레드)는 32개씩 그룹화되어 warp(워프)라고 함
- warp(워프) 내 thread(스레드)는 명령어 유닛 (IU)을 공유함
- 하드웨어 다중 스레딩
- 하드웨어 자원 할당 및 thread(스레드) 스케줄링 (CPU의 OS와 대조)
- 하드웨어는 thread(스레드)를 이용해 memory access latency(메모리 접근 지연)을 숨김
- thread(스레드)는 execute(실행)에 필요한 모든 자원을 보유함
- 무엇을 기다리지 않는 warp(워프)는 언제든지 execute(실행) 가능함. context switch(컨텍스트 전환)은 (기본적으로) 무료
p.19SIMD vs. SIMT execution model(실행 모델)
- SIMD: 단일 순차 명령 스트림의 SIMD 명령어 → 각 명령어는 여러 데이터 입력을 지정함 [VLD, VLD, VADD, VST], VLEN
- SIMT: 스칼라 명령어의 다수 명령 스트림 → 스레드가 동적으로 warp(워프)로 그룹화됨 [LD, LD, ADD, ST], NumThreads
- SIMT의 두 가지 주요 장점:
- - 각 thread(스레드)를 별도로 처리 가능 → 즉, 각 스레드를 독립적으로 execute(실행) 가능 (어떤 유형의 스칼라 파이프라인에서도 가능) → 필요 시 MIMD와 유사한 작업 수행 가능
- - thread(스레드)를 warp(워프)로 유연하게 그룹화 가능 → 즉, 실제로 동일한 명령어를 execute(실행)해야 하는 스레드를 그룹화 가능 → 동적으로 SIMD 처리의 이점을 얻고 최대화 가능
p.20warp(워프) 수준의 fine-grained multithreading(세밀한 다중 스레딩)을 통한 latency hiding(지연 숨기기)
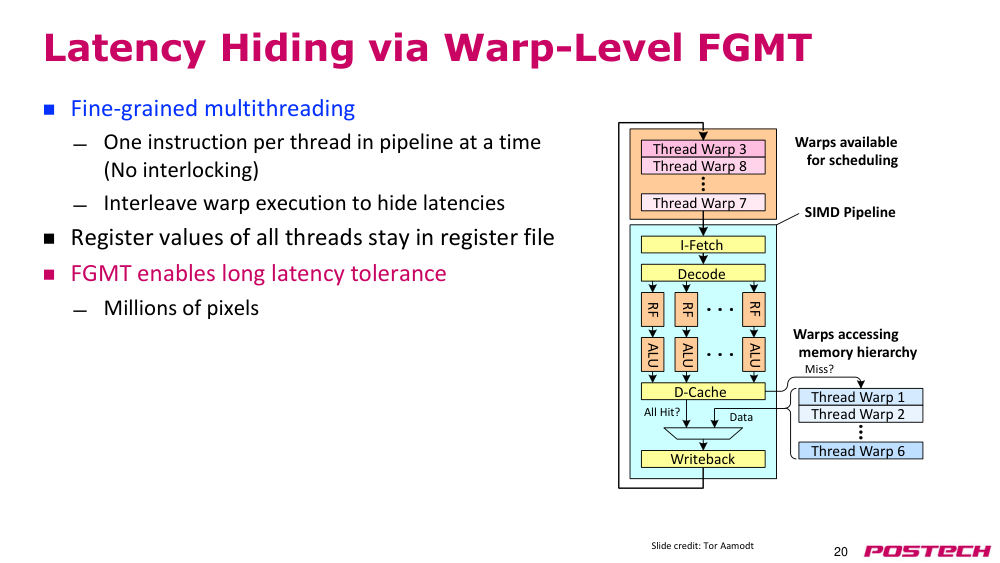
- 세밀한 다중 스레딩 (Fine-grained multithreading)
- - 파이프라인 내에서 한 thread(스레드)당 한 명령어씩 실행 (interlocking(인터로킹) 없음)
- - warp(워프) execution(실행)을 교차하여 지연 시간 숨기기
- - 모든 thread(스레드)의 register(레지스터) 값은 레지스터 파일에 유지됨
- - FGMT은 긴 지연 시간에 대한 내성을 제공함
- - 수백만 개의 픽셀
- - 디코딩
- - register(레지스터) 파일 (RF)
- - ALU
- - D-Cache
- - thread(스레드) warp(워프) 6
- - thread(스레드) warp(워프) 1
- - thread(스레드) warp(워프) 2
- - 데이터
- - 모든 히트?
- - 미스?
- - warp(워프)가 memory hierarchy(메모리 계층 구조)에 접근함
- - thread(스레드) warp(워프) 3
- - thread(스레드) warp(워프) 8
- - 쓰기 백
- - 스케줄링 가능한 warp(워프)
- - thread(스레드) warp(워프) 7
- - I-Fetch
- - SIMD 파이프라인
- - 슬라이드 출처: Tor Aamodt
p.21GPU에서의 latency hiding(지연 숨기기)
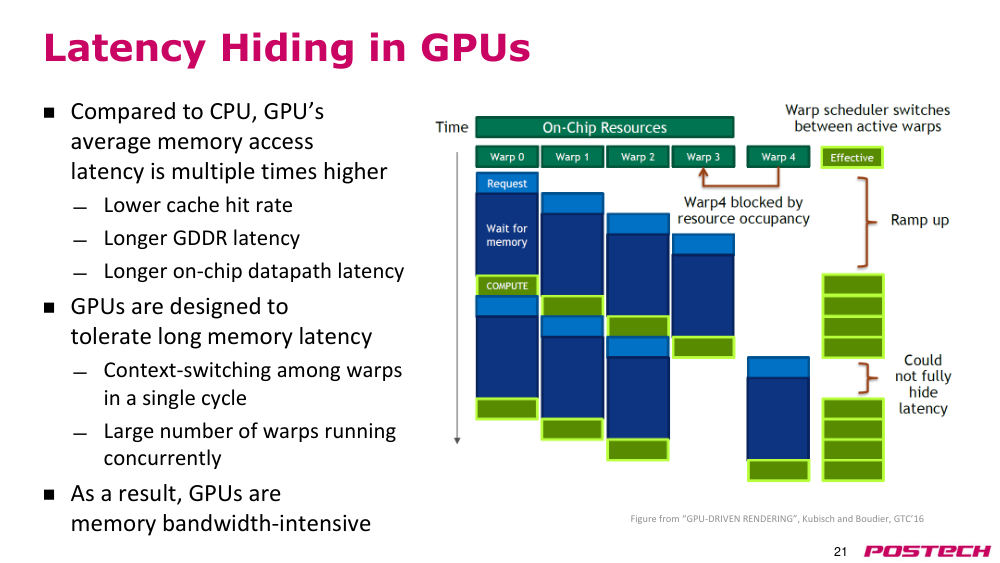
- CPU와 비교했을 때 GPU의 평균 memory access latency(메모리 접근 지연)은 여러 배 더 큼
- - 낮은 cache hit rate(캐시 히트율)
- - 긴 GDDR 지연
- - 긴 온칩 데이터 경로 지연
- GPU는 긴 메모리 지연을 견딜 수 있도록 설계됨
- - 단일 사이클 내에서 warp(워프) 간 context switch(컨텍스트 전환) 가능
- - 동시에 execute(실행)되는 warp(워프) 수가 매우 많음
- 결과적으로 GPU는 메모리 bandwidth(대역폭) 집약적임
- - 그림 출처: “GPU-DRIVEN RENDERING”, Kubisch and Boudier, GTC’16
p.22칩 면적 활용도 비교
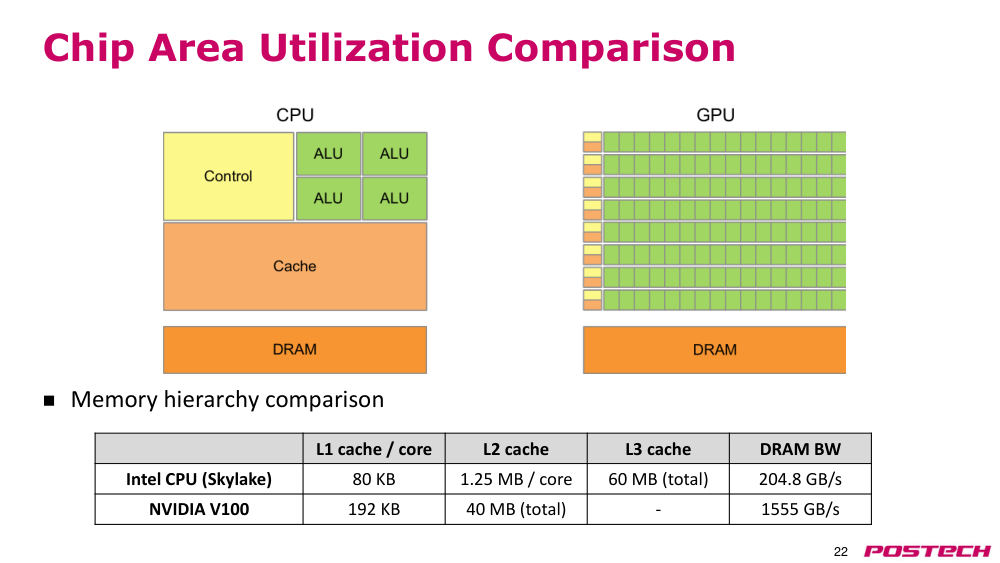
- memory hierarchy(메모리 계층 구조) 비교
- - L1 캐시 / 코어
- - L2 캐시
- - L3 캐시
- - DRAM bandwidth(대역폭)
- - Intel CPU (Skylake): 80 KB, 1.25 MB / 코어, 60 MB (총계), 204.8 GB/s
- - NVIDIA V100: 192 KB, 40 MB (총계), -, 1555 GB/s
p.23고수준 시각
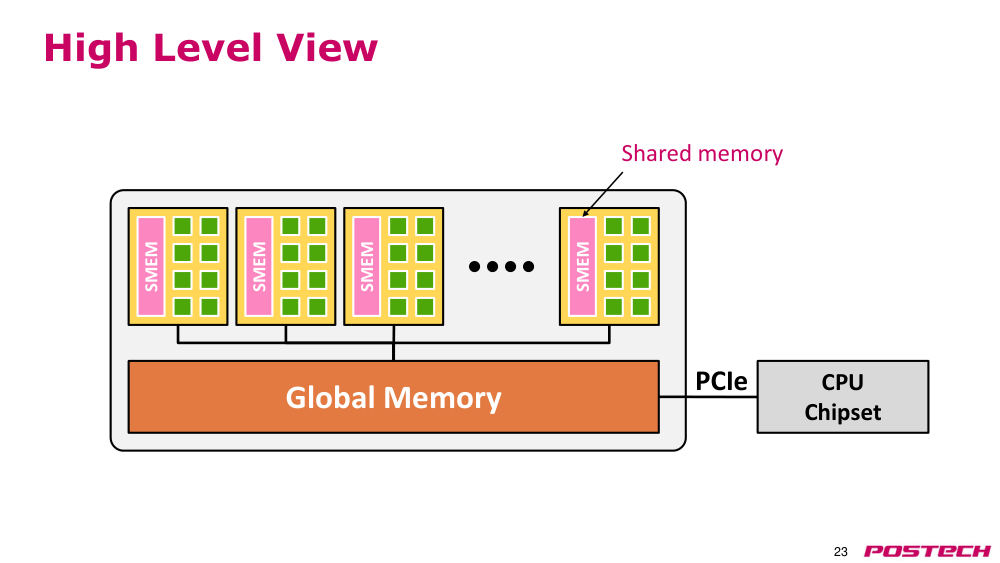
- 공유 메모리 (SMEM)
- 공유 메모리 (SMEM)
- 공유 메모리 (SMEM)
- 공유 메모리 (SMEM)
- global memory(글로벌 메모리)
- CPU
- 칩셋
- PCIe
- shared memory(공유 메모리)
p.24병렬 thread(스레드)의 계층 구조
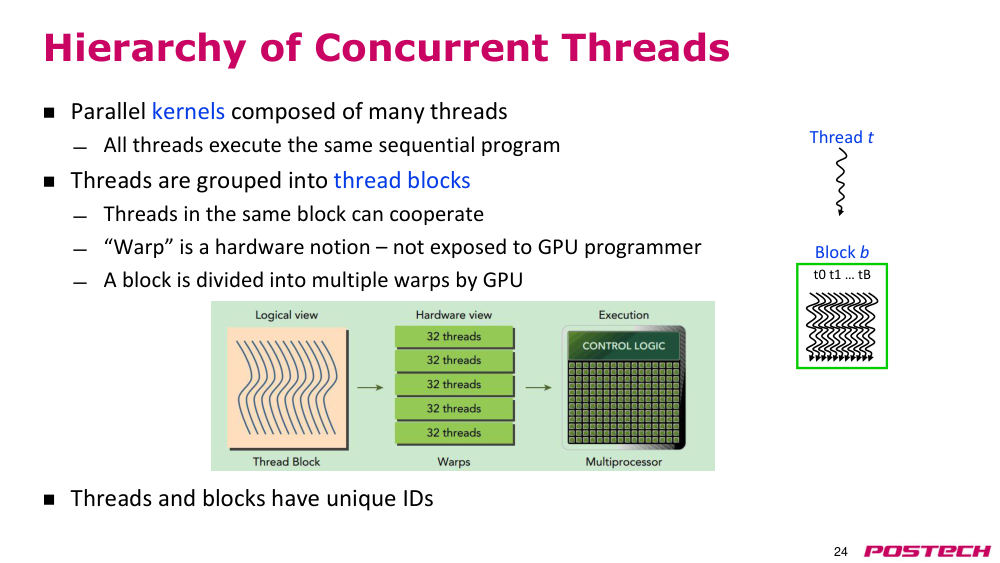
- 병렬 kernel(커널)은 많은 thread(스레드)로 구성됨
- - 모든 thread(스레드)는 동일한 순차 프로그램을 execute(실행)함
- thread(스레드)는 thread block(스레드 블록)으로 그룹화됨
- - 동일한 블록 내 thread(스레드)는 협력 가능함
- - ‘warp(워프)’는 하드웨어 개념이며 GPU 프로그래머에게 노출되지 않음
- - 블록은 GPU에 의해 여러 warp(워프)로 나뉨
- thread(스레드)와 블록은 고유한 ID를 가짐
- thread(스레드) t
- t0 t1 … tB
- 블록 b
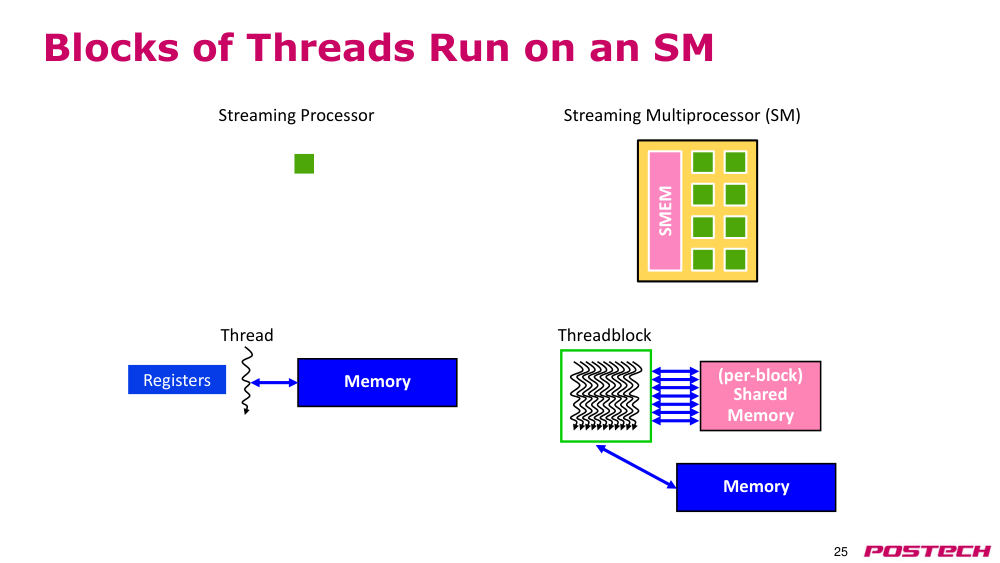
p.25thread block(스레드 블록)은 streaming multiprocessor(SM, 스트리밍 멀티프로세서)에서 execute(실행)됨
- thread(스레드)
- 메모리
- thread(스레드) 블록 (블록당)
- shared memory(공유 메모리)
- 스트리밍 프로세서
- 스트리밍 멀티프로세서 (SM)
- register(레지스터)
- 메모리
- SMEM
p.26CUDA 프로그래밍 모델
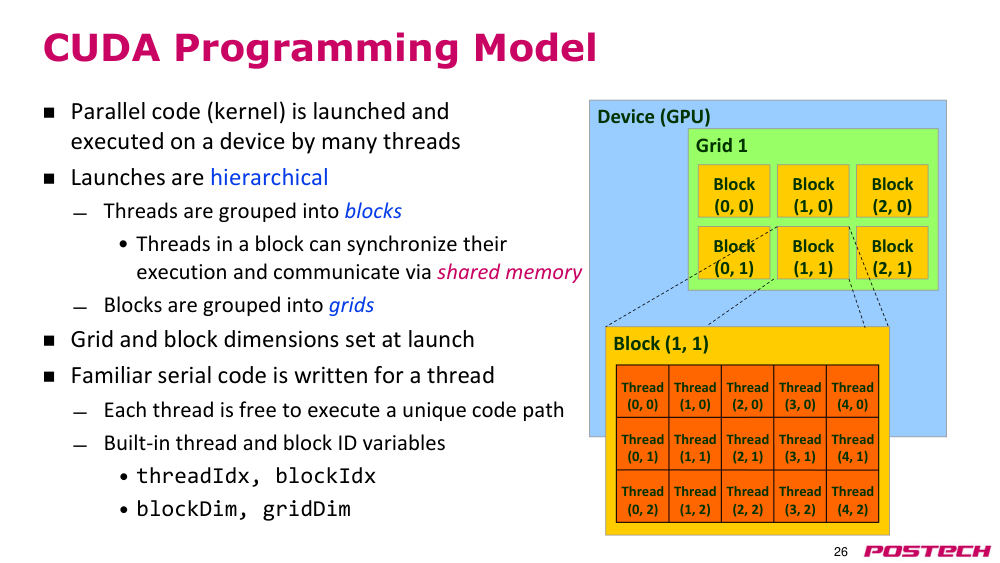
- 병렬 코드 (커널)는 많은 thread(스레드)에 의해 device(디바이스)에서 launch(실행)되며 실행됨
- launch(실행)은 계층적임
- thread(스레드)는 블록으로 그룹화됨
- • 블록 내 thread(스레드)는 execution(실행)을 synchronization(동기화)하고 shared memory(공유 메모리)를 통해 통신할 수 있음
- 블록은 grid(그리드)로 그룹화됨
- • grid(그리드)와 blockdim(블록 차원)은 launch(실행) 시 설정됨
- • thread(스레드)용으로 익숙한 시리얼 코드를 작성함
- • 각 thread(스레드)는 고유한 코드 경로를 execute(실행)할 수 있음
- • 내장된 thread(스레드) 및 블록 ID 변수 제공
- • threadIdx, blockIdx
- • blockDim, gridDim
- 디바이스 (GPU)
- grid(그리드) 1
- 블록 (0, 0)
- 블록 (1, 0)
- 블록 (2, 0)
- 블록 (0, 1)
- 블록 (1, 1)
- 블록 (2, 1)
- 블록 (1, 1)
- 스레드 (0, 1)
- 스레드 (1, 1)
- 스레드 (2, 1)
- 스레드 (3, 1)
- 스레드 (4, 1)
- 스레드 (0, 2)
- 스레드 (1, 2)
- 스레드 (2, 2)
- 스레드 (3, 2)
- 스레드 (4, 2)
- 스레드 (0, 0)
- 스레드 (1, 0)
- 스레드 (2, 0)
- 스레드 (3, 0)
- 스레드 (4, 0)
p.27thread block(스레드 블록)은 독립적이어야 함
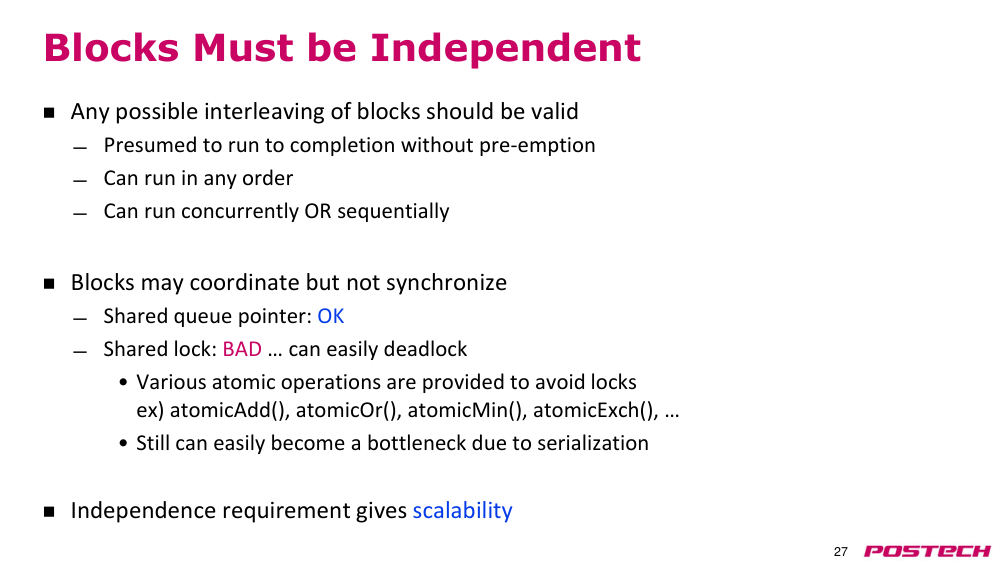
- 모든 가능한 블록의 interleaving execution(인터리빙 실행) 순서가 유효해야 함
- • launch(실행)이 중단 없이 완료될 것으로 가정함
- • 어떤 순서로든 execute(실행)될 수 있음
- • 동시에 또는 순차적으로 execute(실행)될 수 있음
- • 블록은 조율할 수는 있으나 synchronization(동기화)할 수 없음
- • 공유 큐 포인터: 허용됨
- • 공유 락: 불가능 … 쉽게 데드락 발생 가능
- • 데드락을 피하기 위해 다양한 atomic operation(원자적 연산) 제공
- ex) atomicAdd(), atomicOr(), atomicMin(), atomicExch(), …
- • 여전히 직렬화로 인해 성능 저하가 쉽게 발생할 수 있음
- • 독립성 요구사항은 확장성 제공
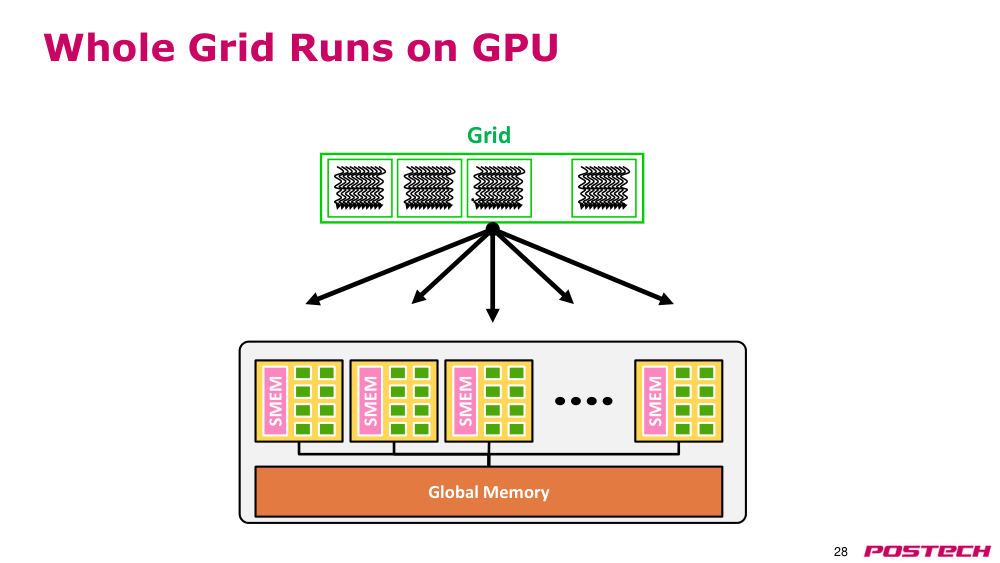
p.28전체 grid(그리드)는 GPU에서 execute(실행)됨
- grid(그리드)
- …
- SMEM
- SMEM
- SMEM
- SMEM
- global memory(글로벌 메모리)
p.29CUDA device(디바이스) 메모리 공간 개요
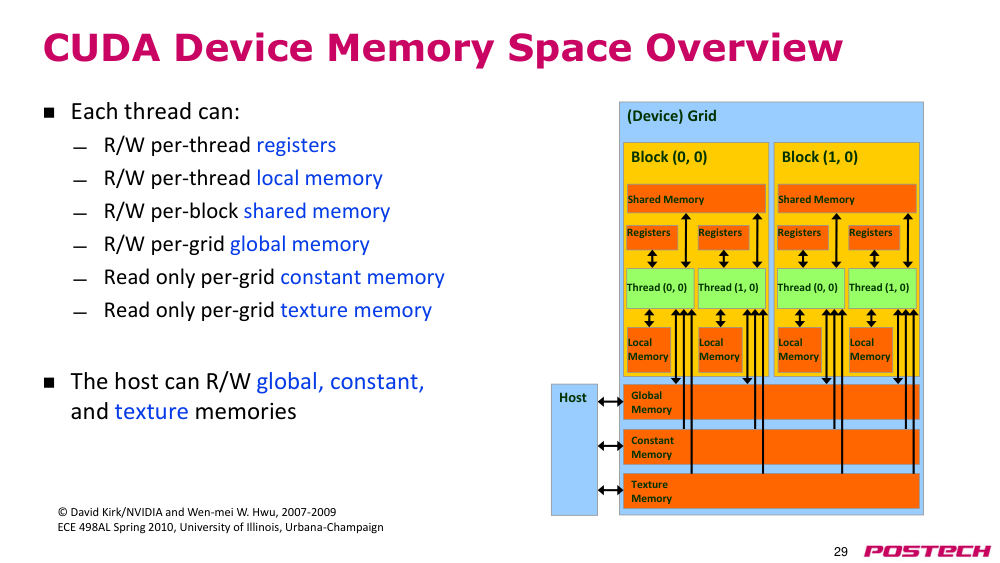
- 각 thread(스레드)는 다음을 수행할 수 있음
- • thread(스레드)별 register(레지스터) 읽기/쓰기
- • thread(스레드)별 local memory(로컬 메모리) 읽기/쓰기
- • 블록별 shared memory(공유 메모리) 읽기/쓰기
- • grid(그리드)별 global memory(글로벌 메모리) 읽기/쓰기
- • grid(그리드)별 constant memory(상수 메모리) 읽기 전용
- • grid(그리드)별 texture memory(텍스처 메모리) 읽기 전용
- • host(호스트)는 글로벌, 상수, texture memory(텍스처 메모리) 읽기/쓰기 가능
- (디바이스) grid(그리드)
- constant memory(상수 메모리)
- texture memory(텍스처 메모리)
- global memory(글로벌 메모리)
- 블록 (0, 0)
- shared memory(공유 메모리)
- local memory(로컬 메모리)
- 스레드 (0, 0)
- register(레지스터)
- local memory(로컬 메모리)
- 스레드 (1, 0)
- register(레지스터)
- 블록 (1, 0)
- shared memory(공유 메모리)
- local memory(로컬 메모리)
- 스레드 (0, 0)
- register(레지스터)
- local memory(로컬 메모리)
- 스레드 (1, 0)
- register(레지스터)
- host(호스트)
- © David Kirk/NVIDIA and Wen-mei W. Hwu, 2007-2009
- ECE 498AL Spring 2010, University of Illinois, Urbana-Champaign
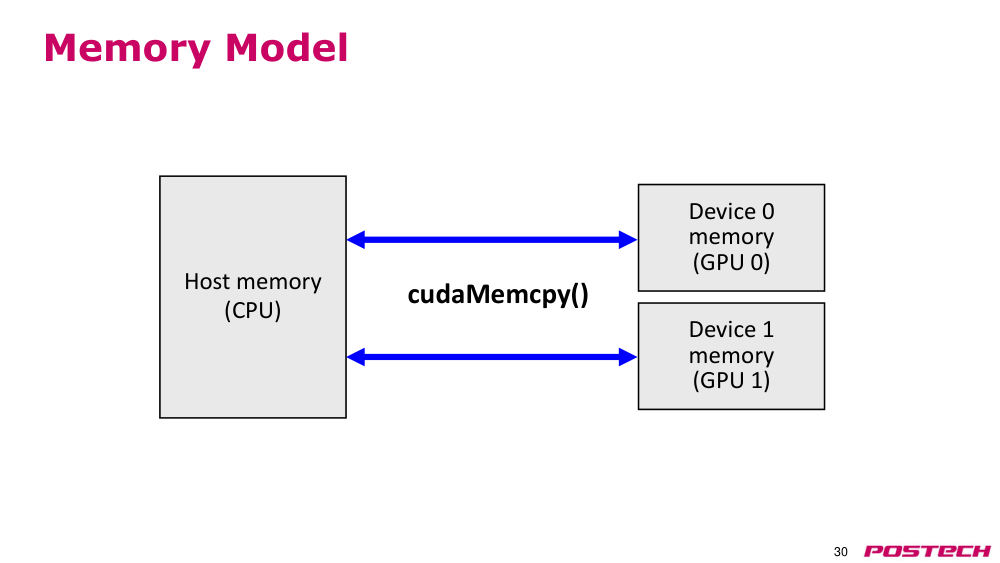
p.30메모리 모델
- device(디바이스) 0 메모리 (GPU 0)
- device(디바이스) 1 메모리 (GPU 1)
- host(호스트) 메모리 (CPU)
- cudaMemcpy()
p.31CUDA용 C
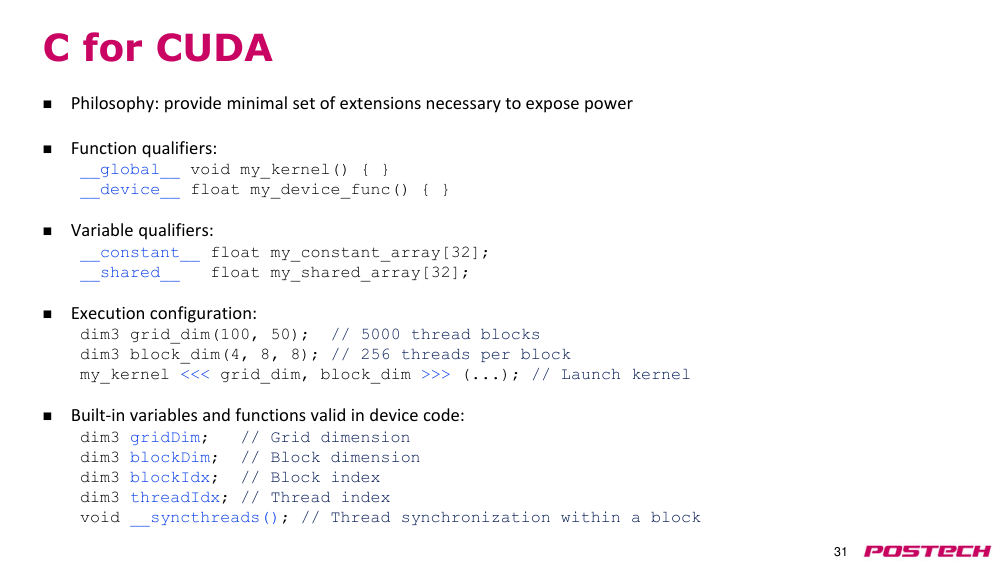
- 철학: 강력한 기능을 노출하기 위해 필요한 최소한의 확장 제공
- function qualifier(함수 한정자):
- __global__ void my_kernel() { }
- __device__ float my_device_func() { }
- variable qualifier(변수 한정자):
- __constant__ float my_constant_array[32];
- __shared__ float my_shared_array[32];
- execution configuration(실행 구성):
- dim3 grid_dim(100, 50); // 5000개의 thread block(스레드 블록)
- dim3 block_dim(4, 8, 8); // 블록당 256개의 thread(스레드)
- my_kernel <<< grid_dim, block_dim >>> (...); // 커널 launch(실행)
- device(디바이스) 코드에서 유효한 내장 변수 및 함수:
- dim3 gridDim; // 그리드 차원
- dim3 blockDim; // 블록 차원
- dim3 blockIdx; // 블록 인덱스
- dim3 threadIdx; // 스레드 인덱스
- void __syncthreads(); // 블록 내 스레드 synchronization(동기화)
p.32예제: 벡터 덧셈
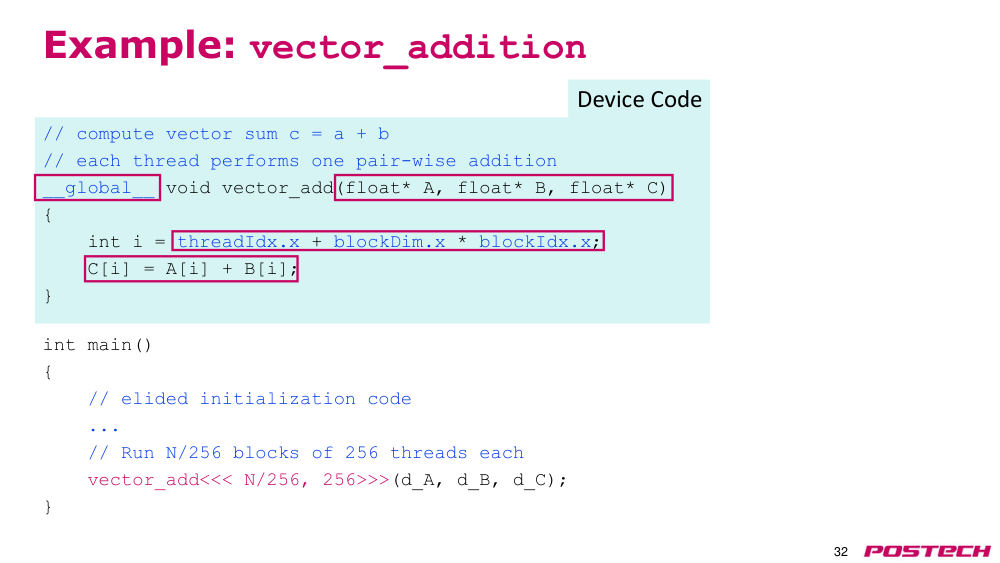
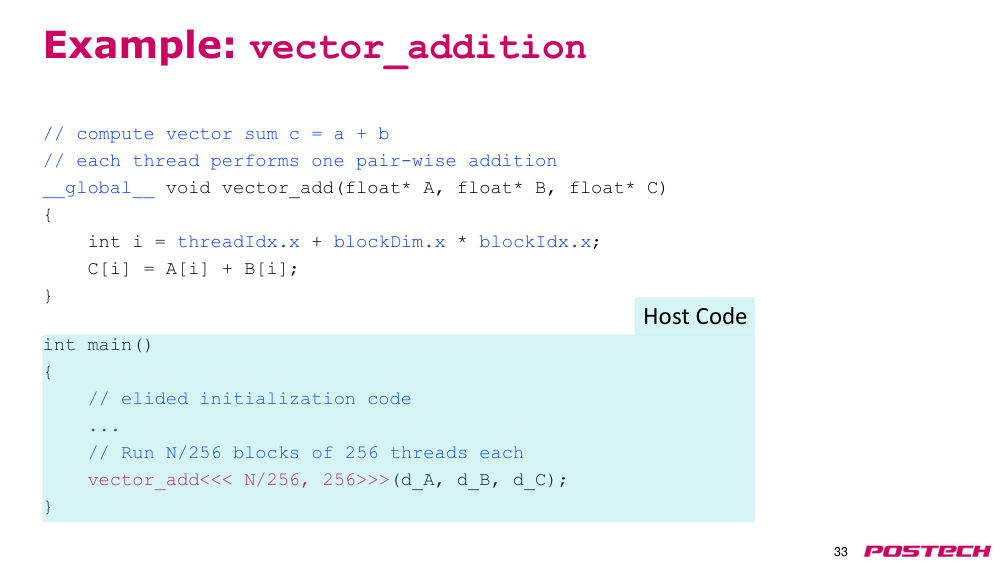
- // 벡터 합 c = a + b 계산
- // 각 thread(스레드)는 한 쌍의 덧셈을 수행
- __global__ void vector_add(float* A, float* B, float* C)
- {
- int i = threadIdx.x + blockDim.x * blockIdx.x;
- C[i] = A[i] + B[i];
- }
- int main()
- {
- // 생략된 초기화 코드
- ...
- // N/256개의 블록, 각 블록당 256개의 thread(스레드) launch(실행)
- vector_add<<< N/256, 256>>>(d_A, d_B, d_C);
- }
- device(디바이스) 코드
p.33예제: 벡터 덧셈
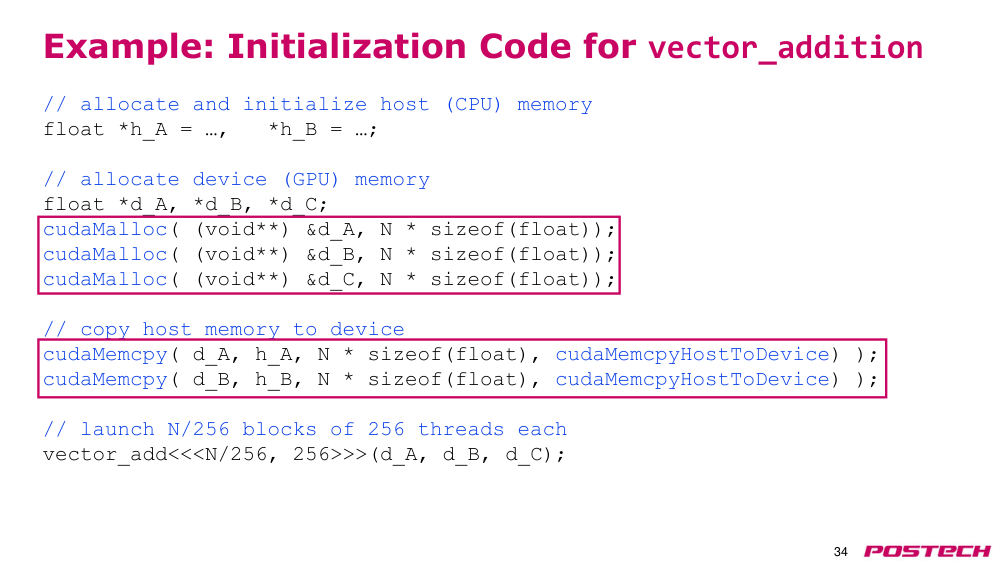
- // 벡터 합 c = a + b 계산
- // 각 thread(스레드)는 한 쌍의 덧셈을 수행
- __global__ void vector_add(float* A, float* B, float* C)
- {
- int i = threadIdx.x + blockDim.x * blockIdx.x;
- C[i] = A[i] + B[i];
- }
- int main()
- {
- // 생략된 초기화 코드
- ...
- // N/256개의 블록, 각 블록당 256개의 thread(스레드) launch(실행)
- vector_add<<< N/256, 256>>>(d_A, d_B, d_C);
- }
- host(호스트) 코드
p.34예제: 벡터 덧셈 초기화 코드
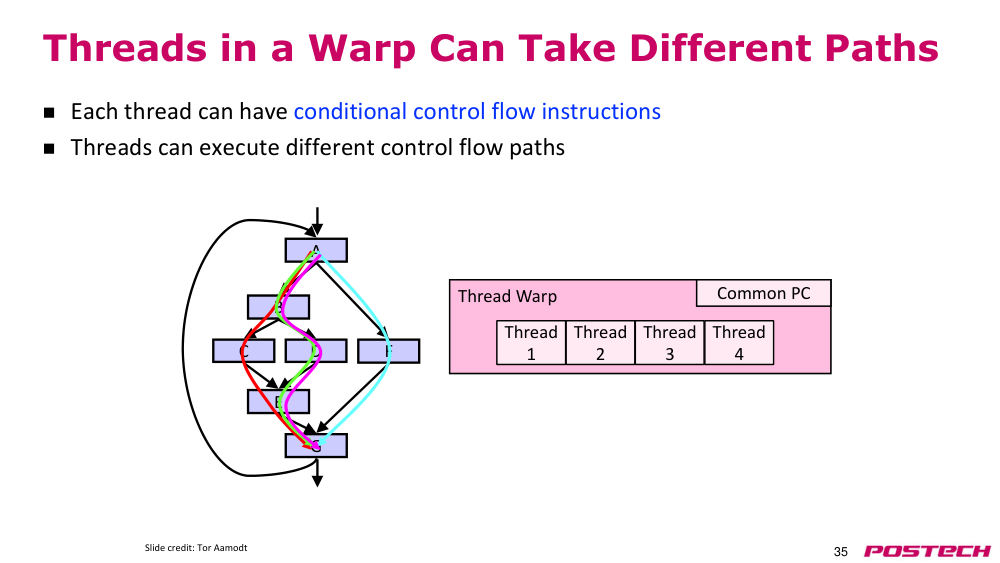
- // 호스트(CPU) 메모리 할당 및 초기화
- float *h_A = …, *h_B = …;
- // 디바이스(GPU) 메모리 할당
- float *d_A, *d_B, *d_C;
- cudaMalloc( (void**) &d_A, N * sizeof(float));
- cudaMalloc( (void**) &d_B, N * sizeof(float));
- cudaMalloc( (void**) &d_C, N * sizeof(float));
- // host(호스트) 메모리에서 device(디바이스)로 복사
- cudaMemcpy( d_A, h_A, N * sizeof(float), cudaMemcpyHostToDevice);
- cudaMemcpy( d_B, h_B, N * sizeof(float), cudaMemcpyHostToDevice);
- // N/256개의 블록, 각 블록당 256개의 thread(스레드) launch(실행)
- vector_add<<<N/256, 256>>>(d_A, d_B, d_C);
p.35warp(워프) 내 thread(스레드)는 서로 다른 경로를 취할 수 있음
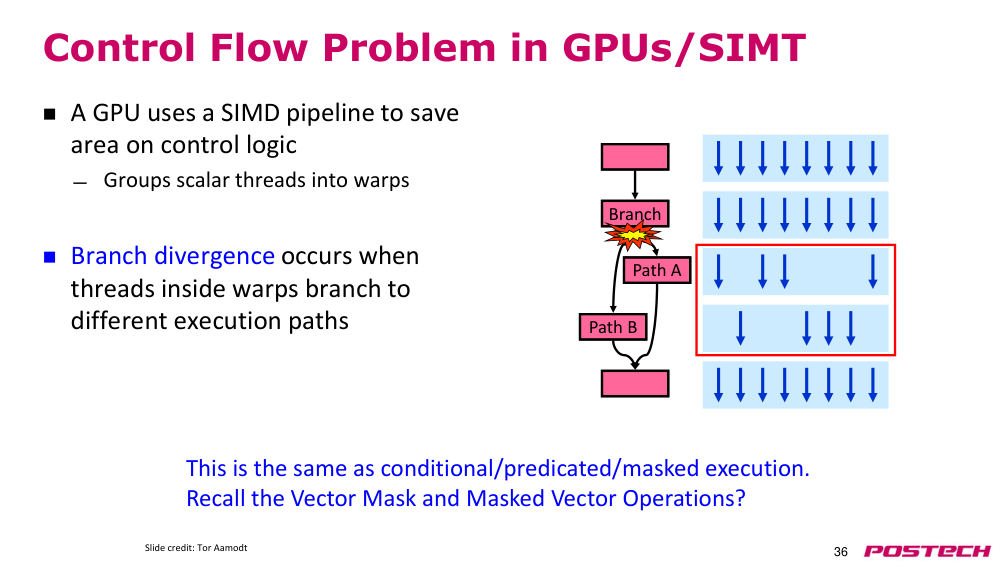
- 각 thread(스레드)는 조건부 제어 흐름 명령어를 가질 수 있음
- thread(스레드)는 서로 다른 제어 흐름 경로를 execute(실행)할 수 있음
- thread(스레드) warp(워프)
- 공통 PC
- thread(스레드) 2
- thread(스레드) 3
- thread(스레드) 4
- thread(스레드) 1
- B
- C
- D
- E
- F
- A
- G
- 슬라이드 출처: Tor Aamodt
p.36GPU/SIMT에서의 제어 흐름 문제
- GPU는 control logic(제어 논리)의 면적을 절약하기 위해 SIMD 파이프라인을 사용함
- 스칼라 thread(스레드)를 warp(워프)로 그룹화함
- warp(워프) 내 thread(스레드)가 서로 다른 execution path(실행 경로)로 분기할 때 branch divergence(분기 다이버전스)가 발생함
- 분기 경로 A
- 분기 경로 B
- 분기 경로 A
- 분기 경로 B
- 슬라이드 출처: Tor Aamodt
- 이는 conditional execution(조건부 실행)/predication(프레디케이션)/masked execution(마스크된 실행)과 동일함.
- 벡터 마스크와 마스크된 벡터 연산을 기억해보라.
p.37각 thread(스레드)는 독립적이다
- 각 thread(스레드)는 별도로 처리할 수 있다 → 즉, 어떤 유형의 스칼라 파이프라인에서도 각 스레드를 독립적으로 execute(실행)할 수 있다 → MIMD 처리
- thread(스레드)를 warp(워프)로 유연하게 그룹화할 수 있다 → 즉, 실제로 동일한 명령을 execute(실행)해야 하는 스레드를 그룹화할 수 있다 → 동적으로 SIMD 처리의 이점을 얻고 최대화할 수 있다
- thread(스레드)가 많을 경우
- 같은 PC(프로그램 카운터)에 있는 개별 thread(스레드)를 찾을 수 있다
- 그리고 이를 동적으로 하나의 warp(워프)로 그룹화할 수 있다
- 이로 인해 branch divergence(분기 다이버전스)가 감소한다 → SIMD 활용도가 향상된다
- SIMD 활용도: SIMD 레인 중 유용한 연산을 수행하는 비율 (즉, 활성 thread(스레드)를 execute(실행)하는 레인)
p.38동적 warp(워프) 형성/병합
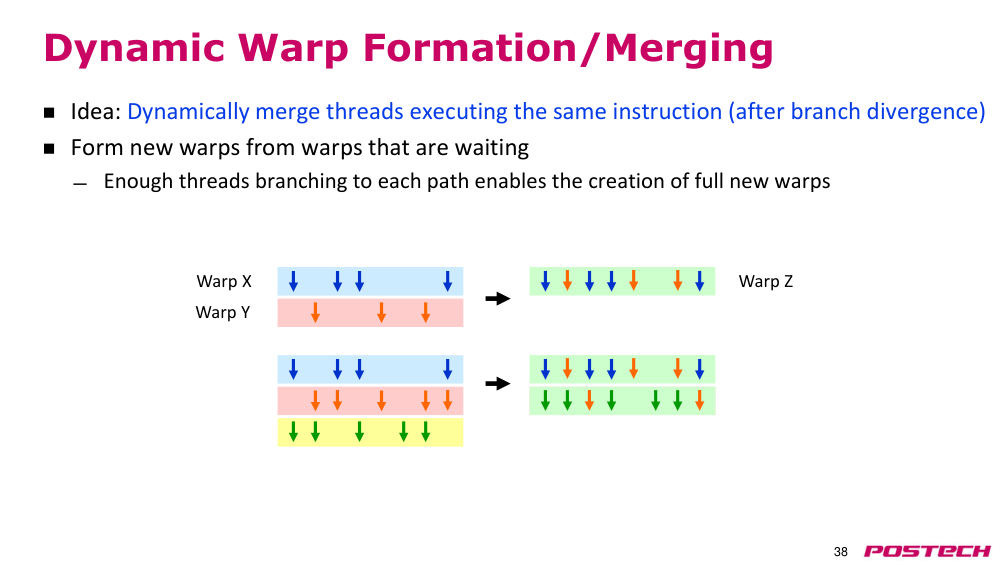
- 개념: branch divergence(분기 다이버전스) 후 동일한 명령을 execute(실행)하는 thread(스레드)를 동적으로 병합한다
- 기다리는 warp(워프)들로부터 새로운 워프를 형성한다
- 각 경로로 분기하는 충분한 thread(스레드)가 존재하면, 완전한 새로운 warp(워프)를 생성할 수 있다
- warp(워프) X
- warp(워프) Y
- warp(워프) Z
p.39동적 warp(워프) 형성/병합
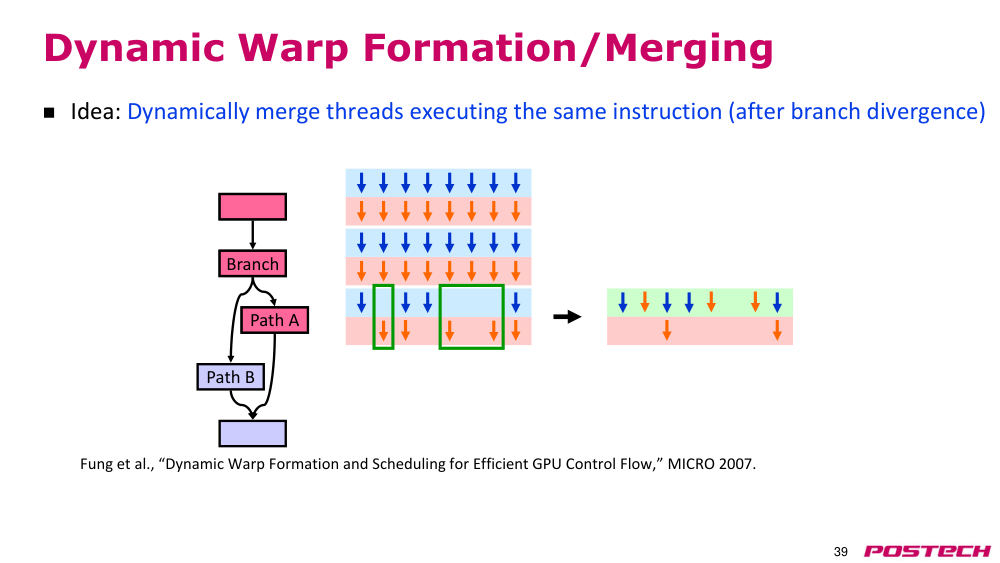
- 개념: branch divergence(분기 다이버전스) 후 동일한 명령을 execute(실행)하는 thread(스레드)를 동적으로 병합한다
- Fung et al., “Dynamic Warp Formation and Scheduling for Efficient GPU Control Flow,” MICRO 2007
- 분기
- 경로 A
- 경로 B
- 분기
- 경로 A
p.40동적 warp(워프) 형성 예시
- A
- A
- B
- B
- G
- G
- A
- A
- C
- C
- D
- D
- E
- E
- F
- F
- 시간
- A
- A
- B
- B
- G
- G
- A
- A
- C
- D
- E
- E
- F
- 시간
- A x/1111
- y/1111
- B x/1110
- y/0011
- C x/1000
- y/0010
- D x/0110
- y/0001
- F x/0001
- y/1100
- E x/1110
- y/0011
- G x/1111
- y/1111
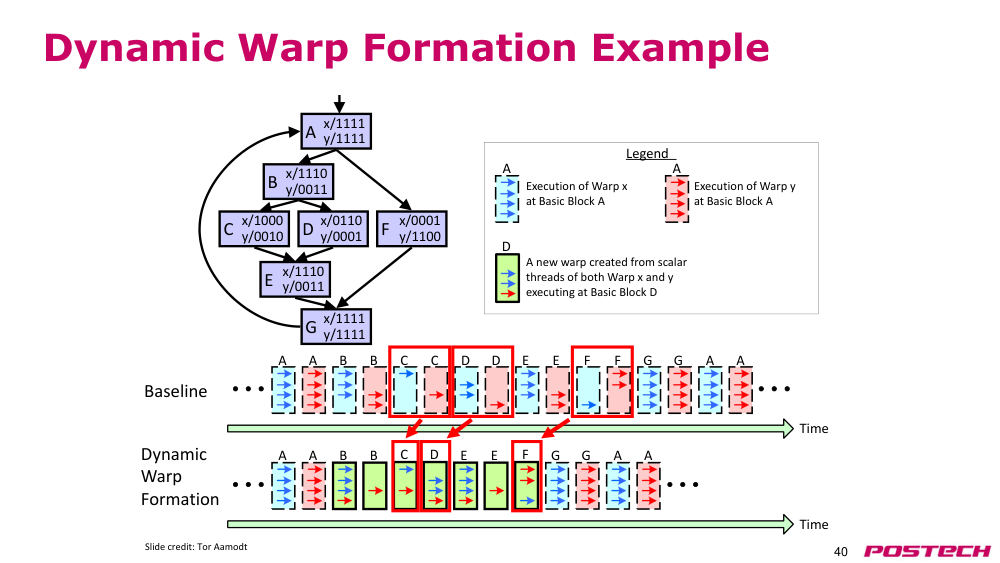
- warp(워프) x와 y의 스칼라 thread(스레드)로부터 basic block(기본 블록) D에서 execute(실행)되는 새로운 워프 생성
- warp(워프) x의 basic block(기본 블록) A execute(실행)
- warp(워프) y의 basic block(기본 블록) A execute(실행)
- 설명
- A
- A
- 기준
- 동적
- warp(워프)
- 형성
- 슬라이드 출처: Tor Aamodt
p.41질문?
- 공지사항
- - 교재 읽기: P&H Ch 6.6 – 6.7, 6.10 – 6.11, Appendix B