Lec12-advanced-CPU (updated)
한국어판 강의자료 · 50쪽
p.1
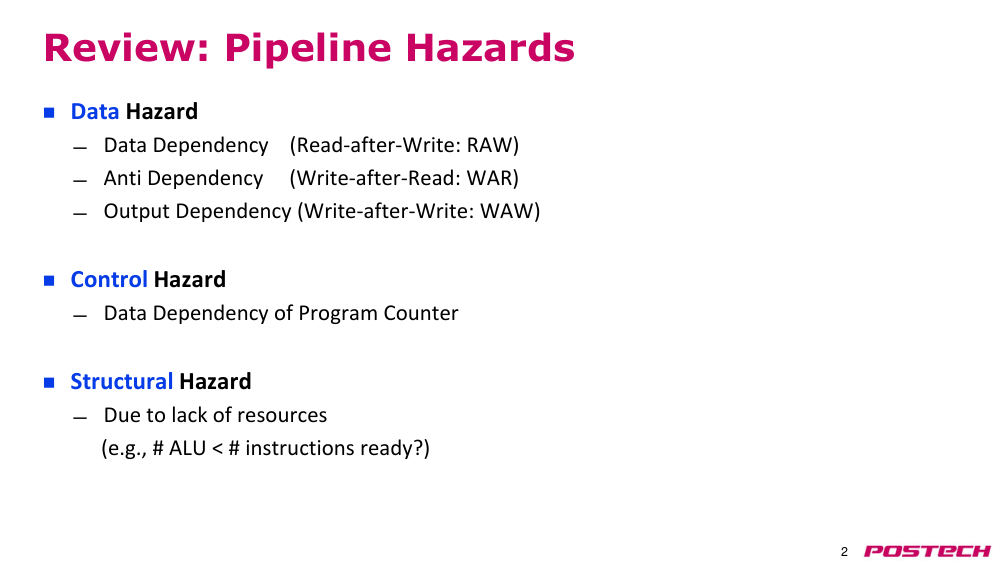
p.2리뷰: pipeline hazards(파이프라인 장애)
- - data hazard(데이터 장애)
- - 데이터 의존성 (읽기 후 쓰기: RAW)
- - 반대 의존성 (쓰기 후 읽기: WAR)
- - 출력 의존성 (쓰기 후 쓰기: WAW)
- - control hazard(제어 장애)
- - 프로그램 카운터의 데이터 의존성
- - structural hazard(구조 장애)
- - 자원 부족으로 인한 것
- (예: ALU 수 < 준비된 명령어 수?)
p.3superscalar(슈퍼스칼라) 및 superpipelined(슈퍼파이프라인) CPU
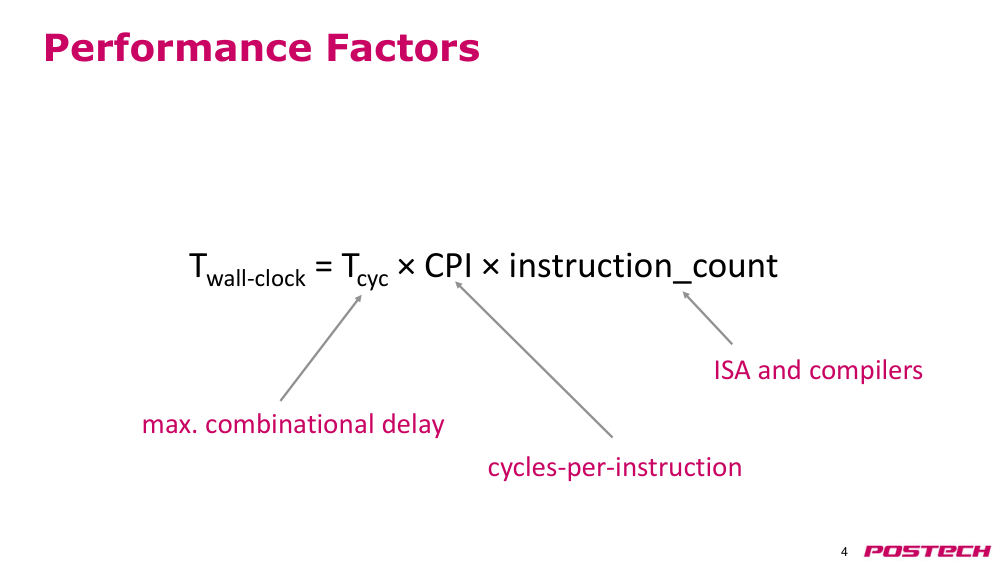
p.4성능 요인
- - Wall-clock 시간 = Tcyc × CPI × 명령어 수
- - 명령당 사이클 수 (CPI)
- - 최대 조합 지연
- - ISA 및 컴파일러
p.5명령 수준 병렬성 (ILP)
- - ILP는 프로그램 내에서 동시에 실행될 수 있는 명령어의 수를 측정하는 지표이다.
- - TLP(스레드 수준 병렬성), DLP(데이터 수준 병렬성)과 비교한다.
- - ILP는 프로세서가 아니라 프로그램의 특성이다.
- - 프로그램의 ILP에 대한 고려
- - 가정: 처리 요소(PE)가 1 사이클에 하나의 명령어를 실행할 수 있다.
- - 다수의 PE → 독립적인 명령어들이 동시에 실행될 수 있다.
- - true dependency(진짜 의존성)이 있는 명령어들은 순차적으로 실행된다.
- - 평균 ILP = (프로그램 내 명령어 수) / (무한한 PE로 실행할 때 필요한 사이클 수)
p.6ILP 예제
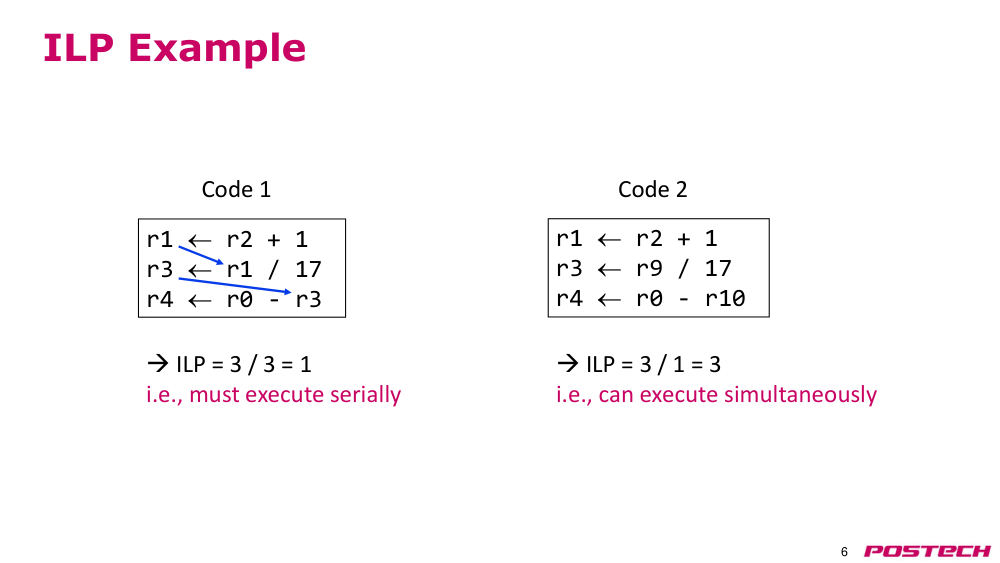
- - 코드 1
- r1 ← r2 + 1
- r3 ← r1 / 17
- r4 ← r0 - r3
- r1 ← r2 + 1
- r3 ← r9 / 17
- r4 ← r0 - r10
- → ILP = 3 / 3 = 1
- 즉, 순차적으로 실행해야 함
- - 코드 2
- → ILP = 3 / 1 = 3
- 즉, 동시에 실행 가능
p.75단계 RISC-V 머신
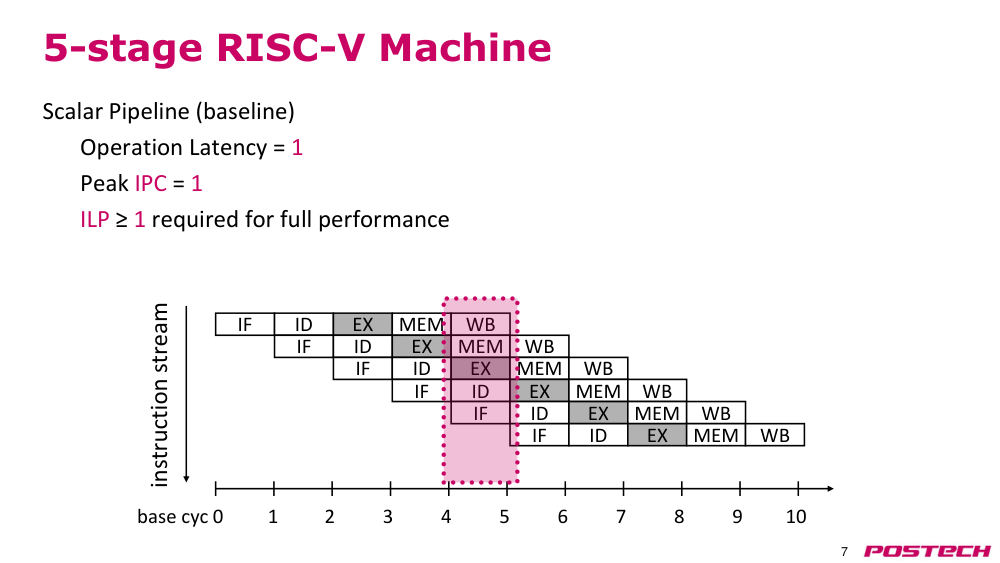
- 스칼라 파이프라인 (기준)
- 작업 지연 = 1
- peak IPC(최대 IPC) = 1
- 전체 성능을 위해 ILP ≥ 1 필요
- IF
- ID
- EX
- MEM
- WB
- IF
- ID
- EX
- MEM
- WB
- IF
- ID
- EX
- MEM
- WB
- IF
- ID
- EX
- MEM
- WB
- IF
- ID
- EX
- MEM
- WB
- IF
- ID
- EX
- MEM
- WB
- 명령어 스트림
- 기준 사이클 0
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
p.8superpipelined(슈퍼파이프라인) 머신
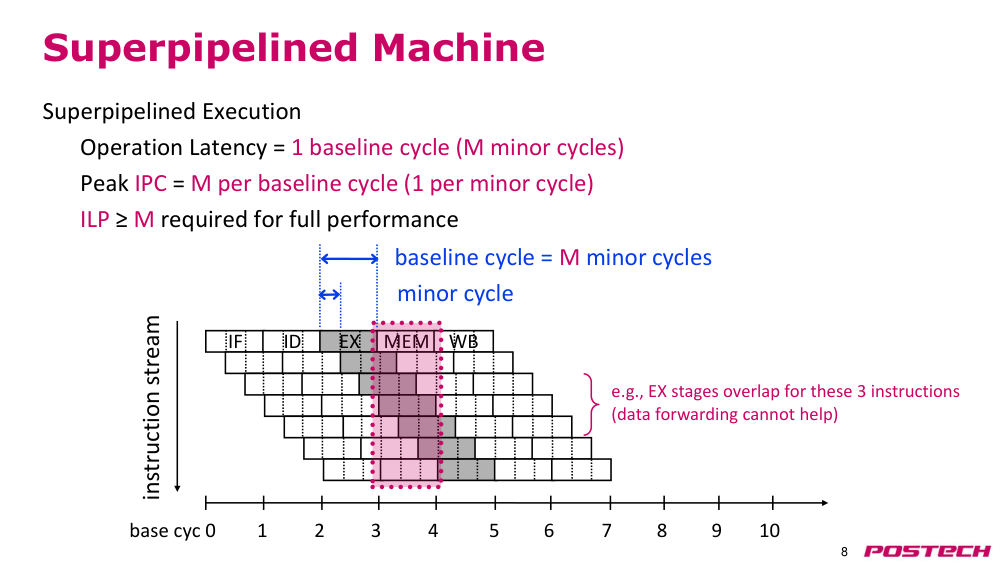
- superpipelined(슈퍼파이프라인) 실행
- 작업 지연 = 1 기준 사이클 (M 소 사이클)
- peak IPC(최대 IPC) = 기준 사이클당 M (소 사이클당 1)
- 전체 성능을 위해 ILP ≥ M 필요
- 기준 사이클 = M 소 사이클
- 소 사이클
- 명령어 스트림
- 기준 사이클 0
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- IF
- ID
- EX
- MEM
- WB
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- 예: 이 3개 명령어의 EX 단계가 겹침
- data forwarding(데이터 포워딩)은 도움이 되지 않음
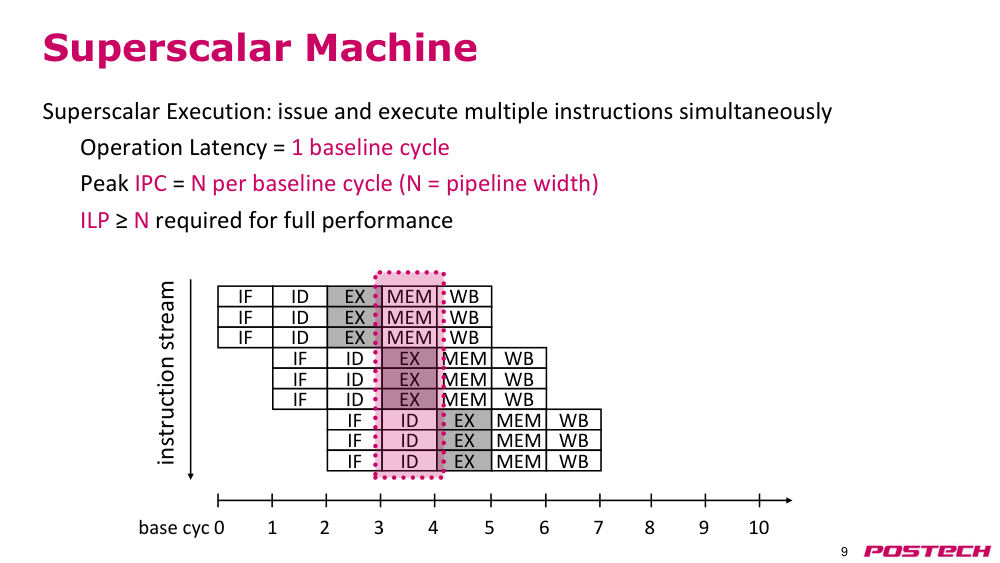
p.9superscalar(슈퍼스칼라) 머신
- superscalar(슈퍼스칼라) 실행: 동시에 다수의 명령어 발행 및 실행
- 작업 지연 = 1 기준 사이클
- peak IPC(최대 IPC) = 기준 사이클당 N (파이프라인 폭 = N)
- 전체 성능을 위해 ILP ≥ N 필요
- IF
- ID
- EX
- MEM
- WB
- IF
- ID
- EX
- MEM
- WB
- IF
- ID
- EX
- MEM
- WB
- 명령어 스트림
- 기준 사이클 0
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- IF
- ID
- EX
- MEM
- WB
- IF
- ID
- EX
- MEM
- WB
- IF
- ID
- EX
- MEM
- WB
- IF
- ID
- EX
- MEM
- WB
- IF
- ID
- EX
- MEM
- WB
- IF
- ID
- EX
- MEM
- WB
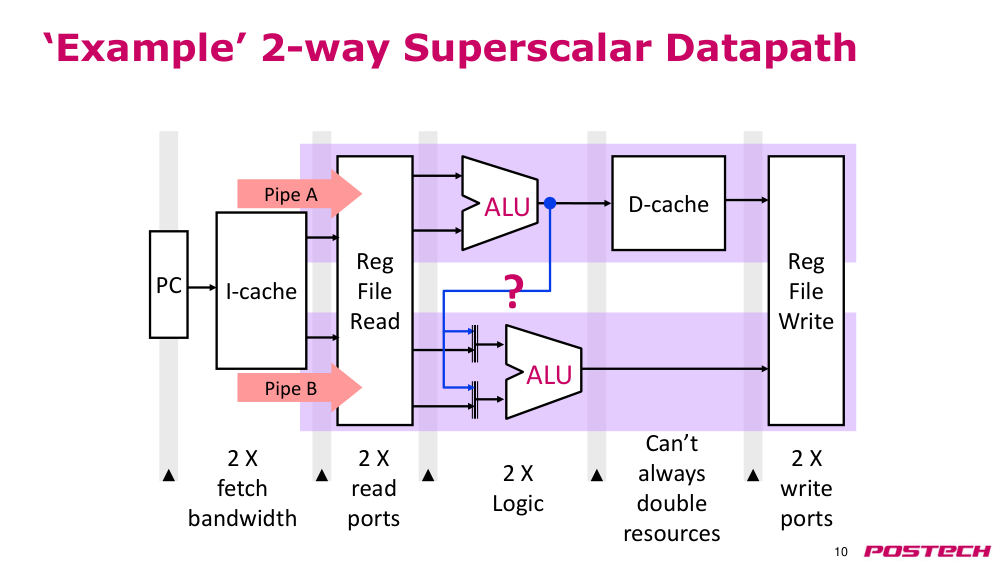
p.10'예시' 2-way superscalar(슈퍼스칼라) 데이터패스
- I-cache
- Reg File
- Read
- PC
- D-cache
- ALU
- ALU
- Reg File
- Write
- 2 X
- fetch 대역폭
- 2 X
- 읽기 포트
- 2 X
- 로직
- 항상 자원을 두 배로 늘릴 수는 없음
- 2 X
- 쓰기 포트
- Pipe A
- Pipe B
- ?
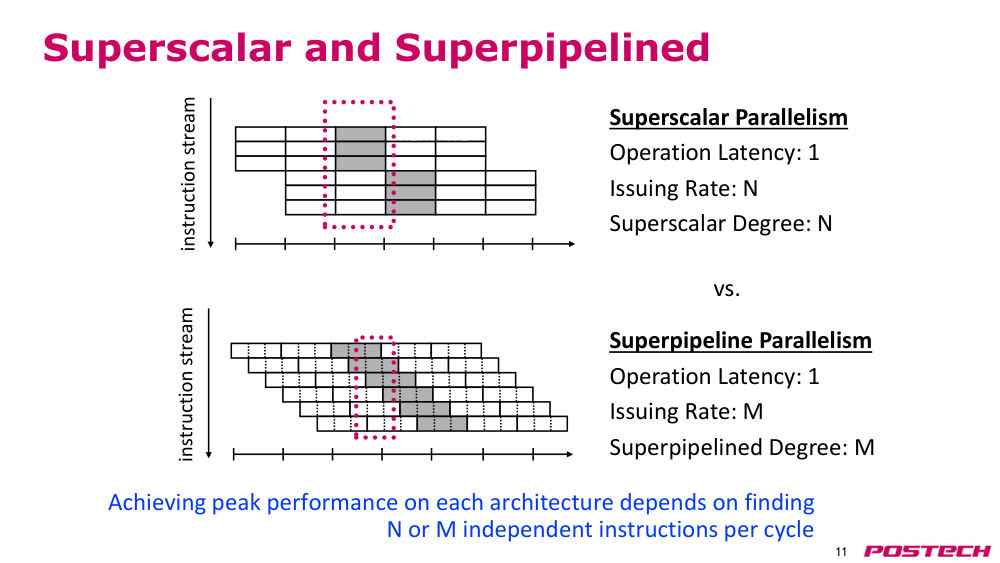
p.11superscalar(슈퍼스칼라)와 superpipelined(슈퍼파이프라인)
- 각 아키텍처에서 최대 성능을 달성하기 위해서는 각 사이클당 N 또는 M개의 독립적인 명령어를 찾아야 함
- superscalar(슈퍼스칼라) 병렬성
- 작업 지연: 1
- 발행 속도: N
- superscalar degree(슈퍼스칼라도): N
- superpipelined(슈퍼파이프라인) 병렬성
- 작업 지연: 1
- 발행 속도: M
- superpipelined degree(슈퍼파이프라인도): M
- 명령어 스트림
- ID
- MEM WB
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- IF
- MEM WB
- MEM WB
- ID
- MEM WB
- IF
- ID
- ID
- 비교
- 명령어 스트림
p.12In-Order pipeline(순서 유지 파이프라인)의 한계 (1/2)
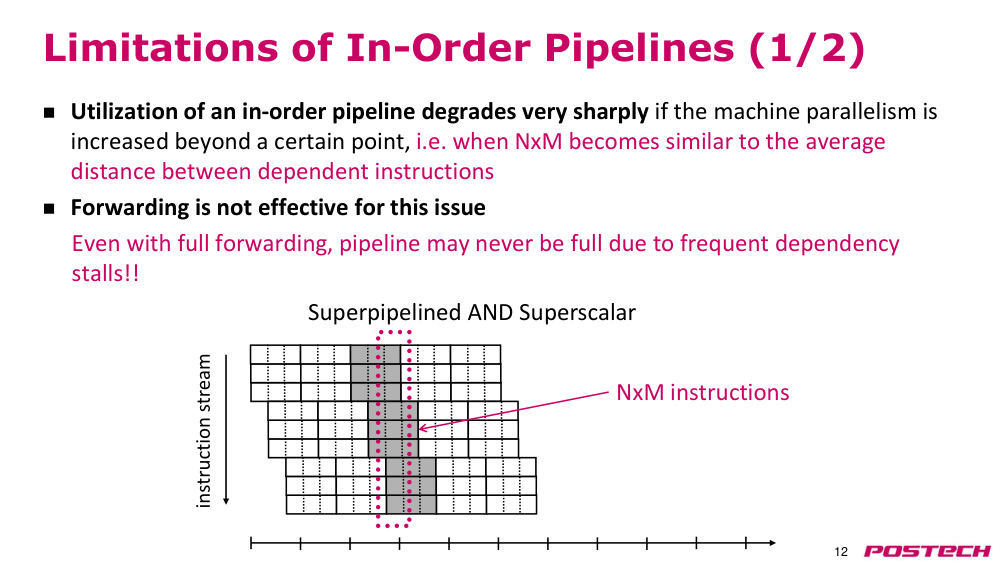
- 기계 병렬성이 특정 지점 이상으로 증가하면 In-Order pipeline(순서 유지 파이프라인)의 활용도가 매우 급격히 저하됨, 즉 NxM이 의존성 있는 명령어 간 평균 거리와 유사해질 때
- 포워딩은 이 문제에 효과적이지 않음
- 완전한 포워딩을 해도 의존성 정지가 자주 발생하여 파이프라인이 항상 꽉 차지 않을 수 있음!
- 명령어 스트림
- NxM 명령어
- superpipelined(슈퍼파이프라인) AND superscalar(슈퍼스칼라)
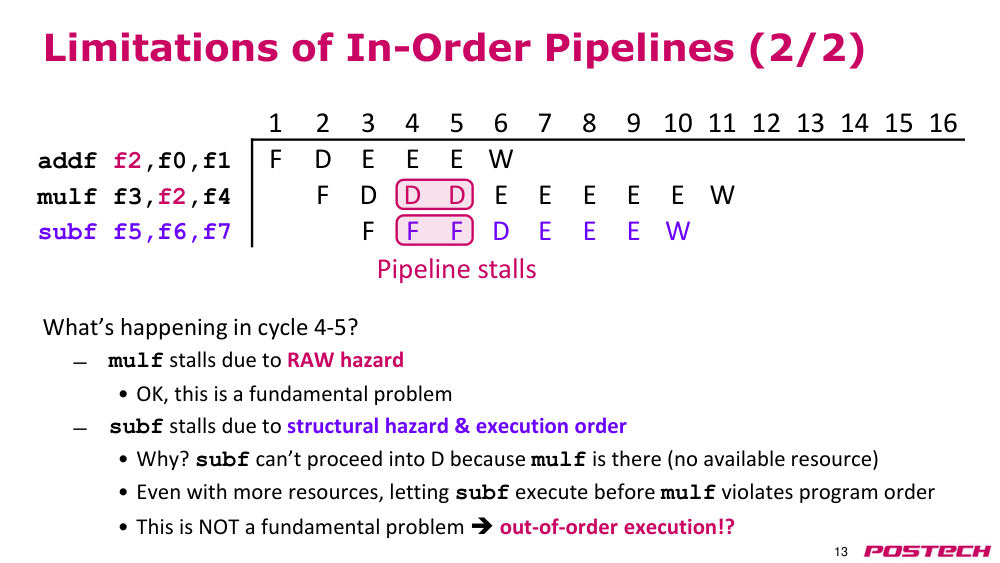
p.13In-Order pipeline(순서 유지 파이프라인)의 한계 (2/2)
- 사이클 4-5에서 발생하는 일은 무엇인가?
- mulf는 RAW 장애로 인해 정지됨
- 네, 이것은 근본적인 문제이다.
- subf는 structural hazard(구조 장애) 및 실행 순서로 인해 정지됨
- 왜냐하면 mulf가 D 단계에 있기 때문에 subf가 D 단계로 진행할 수 없기 때문이다 (사용 가능한 자원 없음)
- 더 많은 자원이 있어도, mulf보다 subf가 먼저 실행되도록 하면 프로그램 순서를 위반하게 된다.
- 이것은 근본적인 문제는 아님 → out-of-order execution(OoO)(비순차 실행)!?
p.14register renaming(레지스터 이름 바꾸기)
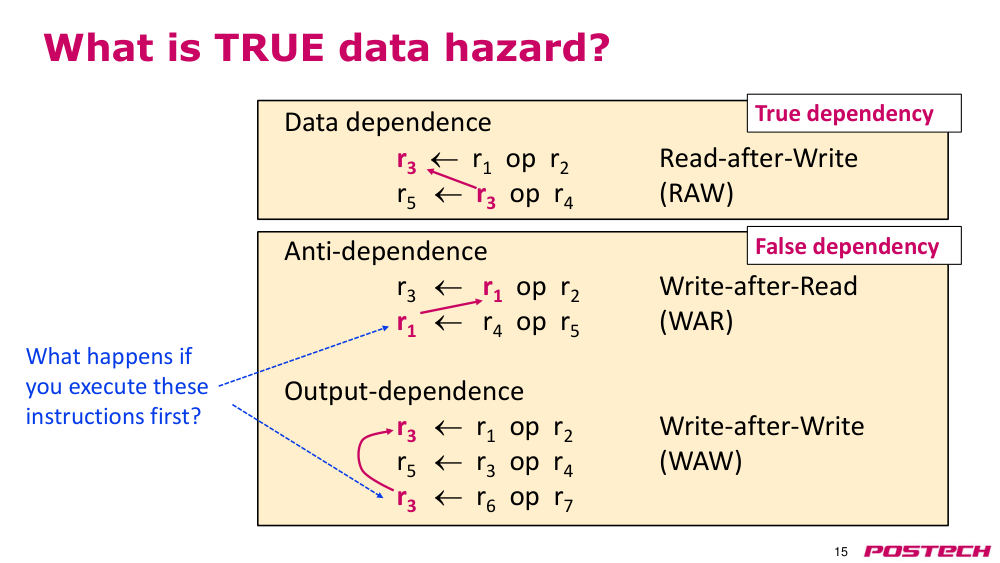
p.15false dependency(거짓 의존성) vs true dependency(진짜 의존성)
- 진짜 data hazard(데이터 장애)란 무엇인가?
- 데이터 의존성
- r3 ← r1 op r2
- 쓰기 후 읽기 (RAW)
- r5 ← r3 op r4
- 반대 의존성
- r3 ← r1 op r2
- 읽기 후 쓰기 (WAR)
- r1 ← r4 op r5
- 출력 의존성
- r3 ← r1 op r2
- 쓰기 후 쓰기 (WAW)
- r5 ← r3 op r4
- r3 ← r6 op r7
- 이 명령어들을 먼저 실행하면 어떻게 되는가?
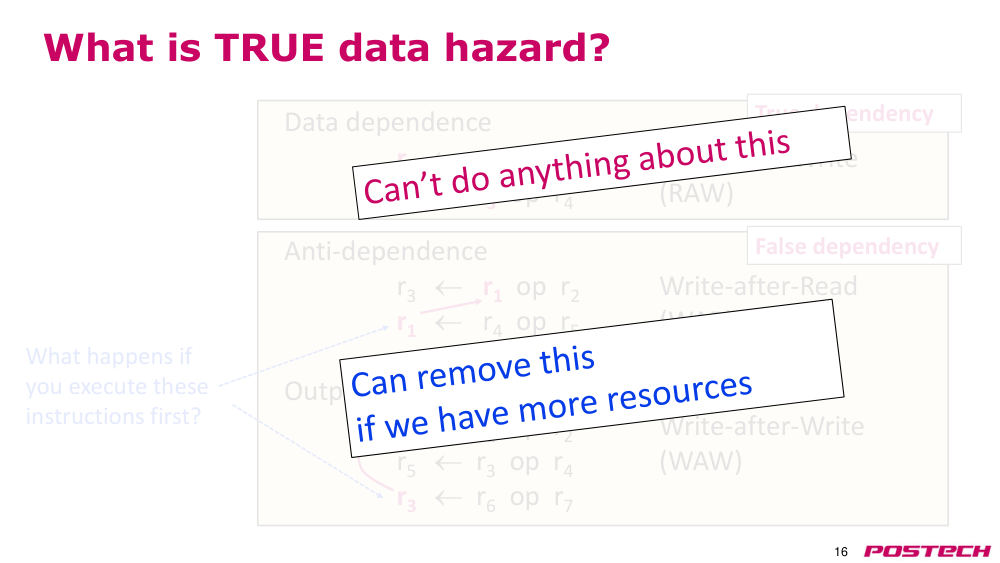
p.16false dependency(거짓 의존성) vs true dependency(진짜 의존성)
- 진짜 data hazard(데이터 장애)란 무엇인가?
- 데이터 의존성
- r3 ← r1 op r2
- 쓰기 후 읽기 (RAW)
- r5 ← r3 op r4
- 반대 의존성
- r3 ← r1 op r2
- 읽기 후 쓰기 (WAR)
- r1 ← r4 op r5
- 출력 의존성
- r3 ← r1 op r2
- 쓰기 후 쓰기 (WAW)
- r5 ← r3 op r4
- r3 ← r6 op r7
- 이 명령어들을 먼저 실행하면 어떻게 되는가?
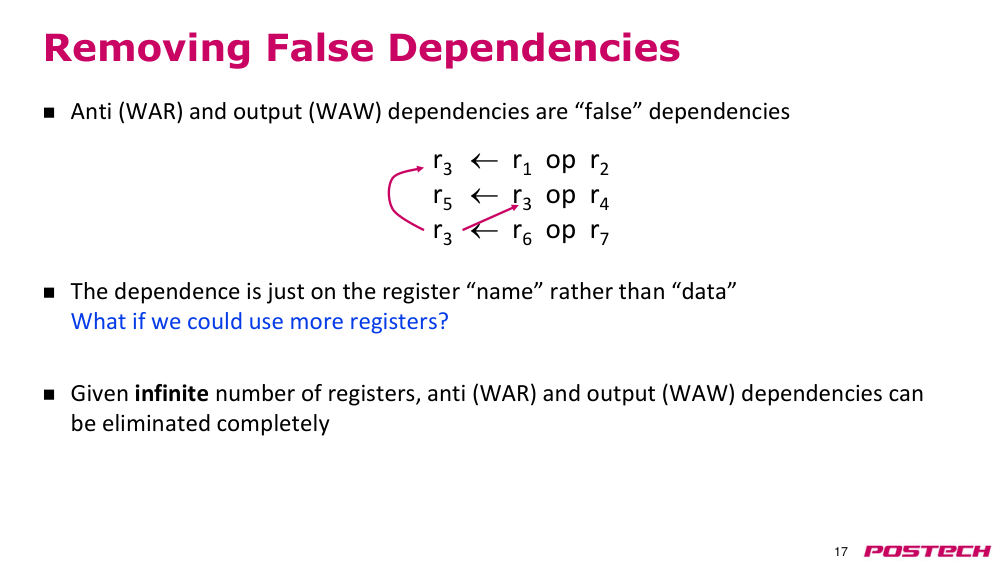
p.17false dependency(거짓 의존성) 제거
- 반대 (WAR) 및 출력 (WAW) 의존성은 '거짓' 의존성이다.
- 의존성은 '데이터'가 아니라 레지스터의 '이름'에 기반한다.
- 더 많은 레지스터를 사용할 수 있다면 어떻게 될까?
- 무한한 수의 레지스터가 있다면, 반대 (WAR) 및 출력 (WAW) 의존성은 완전히 제거될 수 있다.
- r3 ← r1 op r2
- r5 ← r3 op r4
- r3 ← r6 op r7
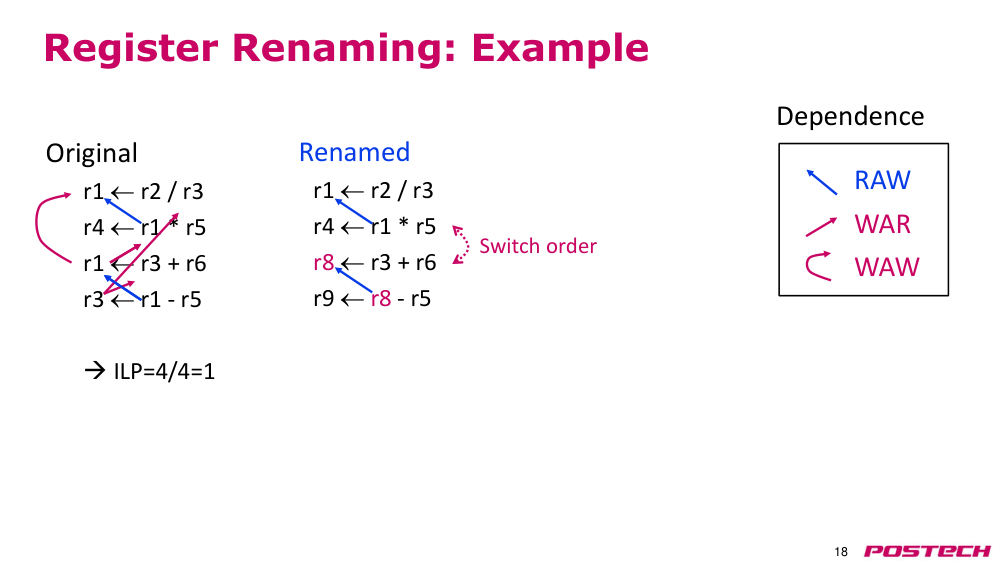
p.18register renaming(레지스터 이름 바꾸기): 예제
- 원본
- r1 ← r2 / r3
- r4 ← r1 * r5
- r1 ← r3 + r6
- r3 ← r1 - r5
- → ILP = 4/4 = 1
- 이름 바뀐 버전
- r1 ← r2 / r3
- r4 ← r1 * r5
- r8 ← r3 + r6
- r9 ← r8 - r5
- RAW
- WAR
- WAW
- 의존성
- 순서 변경
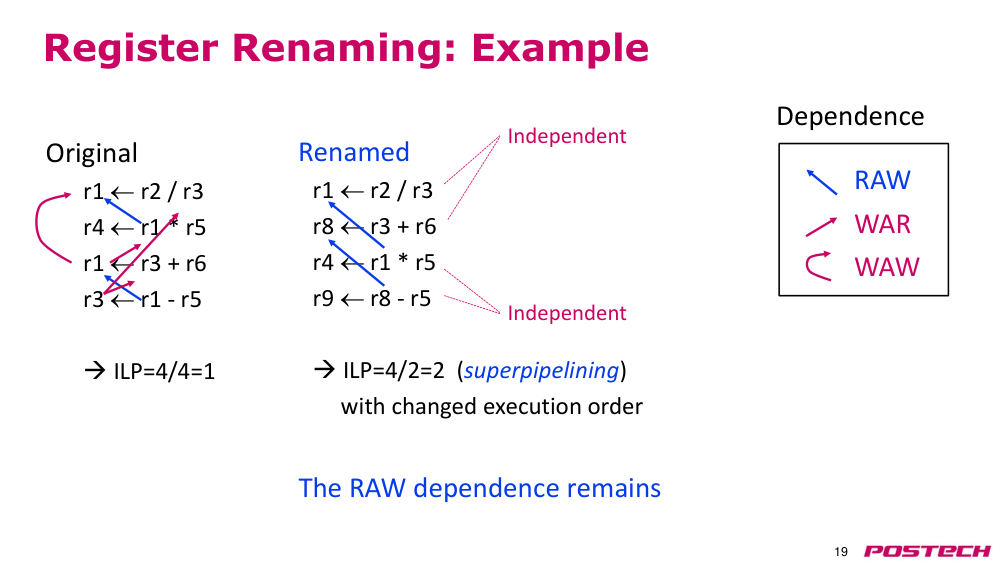
p.19register renaming(레지스터 이름 바꾸기): 예시
- 원본
- r1 ← r2 / r3
- r4 ← r1 * r5
- r1 ← r3 + r6
- r3 ← r1 - r5
- → ILP = 4/4 = 1
- 이름 바뀐 버전
- r1 ← r2 / r3
- r8 ← r3 + r6
- r4 ← r1 * r5
- r9 ← r8 - r5
- → ILP = 4/2 = 2 (슈퍼파이프라인)
- 실행 순서 변경 후
- 쓰기 후 읽기 (RAW) 의존성: 유지됨
- 읽기 후 쓰기 (WAR) 의존성: 독립적
- 쓰기 후 쓰기 (WAW) 의존성: 독립적
- 의존성: 독립적, 독립적, 유지됨
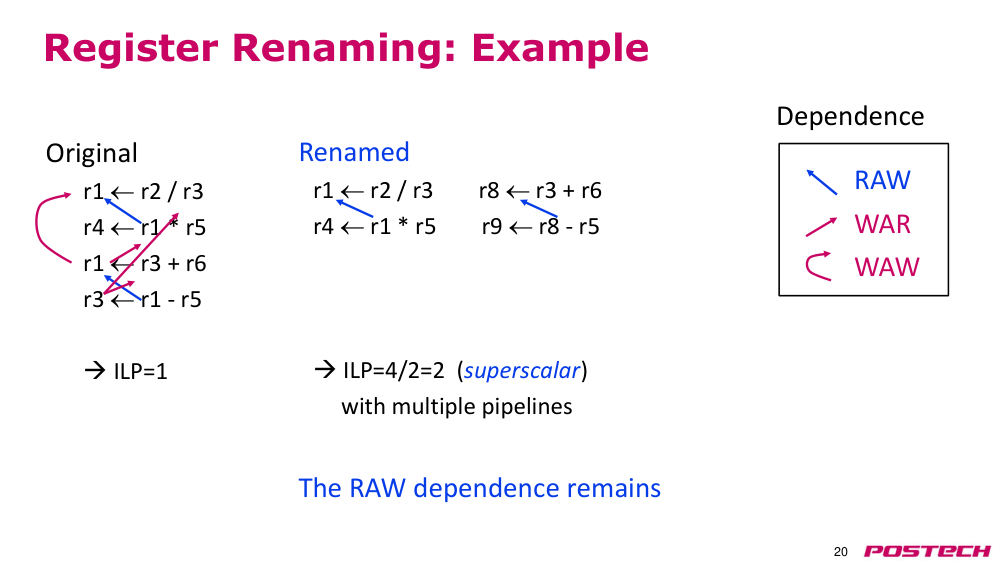
p.20register renaming(레지스터 이름 바꾸기): 예시
- 원본
- r1 ← r2 / r3
- r4 ← r1 * r5
- r1 ← r3 + r6
- r3 ← r1 - r5
- → ILP = 1
- 이름 바뀐 버전
- r1 ← r2 / r3 r8 ← r3 + r6
- r4 ← r1 * r5 r9 ← r8 - r5
- → ILP = 4/2 = 2 (슈퍼스칼라)
- 다중 파이프라인 사용 시
- 쓰기 후 읽기 (RAW) 의존성: 유지됨
- 읽기 후 쓰기 (WAR) 의존성: 독립적
- 쓰기 후 쓰기 (WAW) 의존성: 독립적
- 의존성: 유지됨
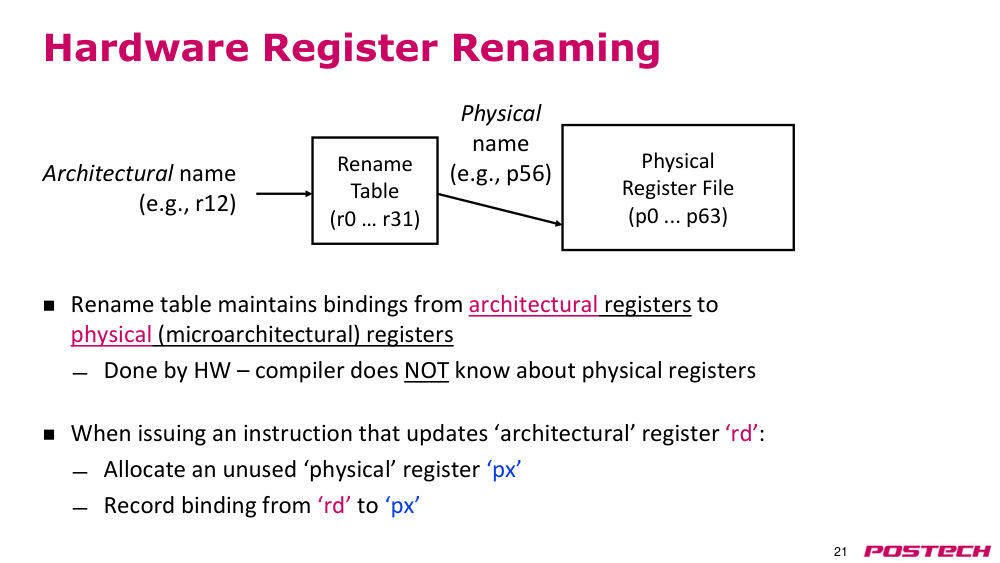
p.21하드웨어 register renaming(레지스터 이름 바꾸기)
- rename table(이름 바꾸기 테이블)은 architectural register(아키텍처 레지스터)에서 physical register(물리 레지스터)로의 바인딩을 유지함
- 하드웨어에서 수행됨 – 컴파일러는 physical register(물리 레지스터)를 알지 못함
- architectural register(아키텍처 레지스터) 'rd'를 업데이트하는 명령어를 발행할 때:
- 사용되지 않은 physical register(물리 레지스터) 'px' 할당
- 레지스터 'rd'에서 'px'로의 바인딩 기록
- physical register(물리 레지스터) 파일 (p0 ... p63)
- 이름 바꾸기 테이블 (r0 … r31)
- 아키텍처 이름 (예: r12)
- 물리 이름 (예: p56)
p.22하드웨어 register renaming(레지스터 이름 바꾸기) 예시
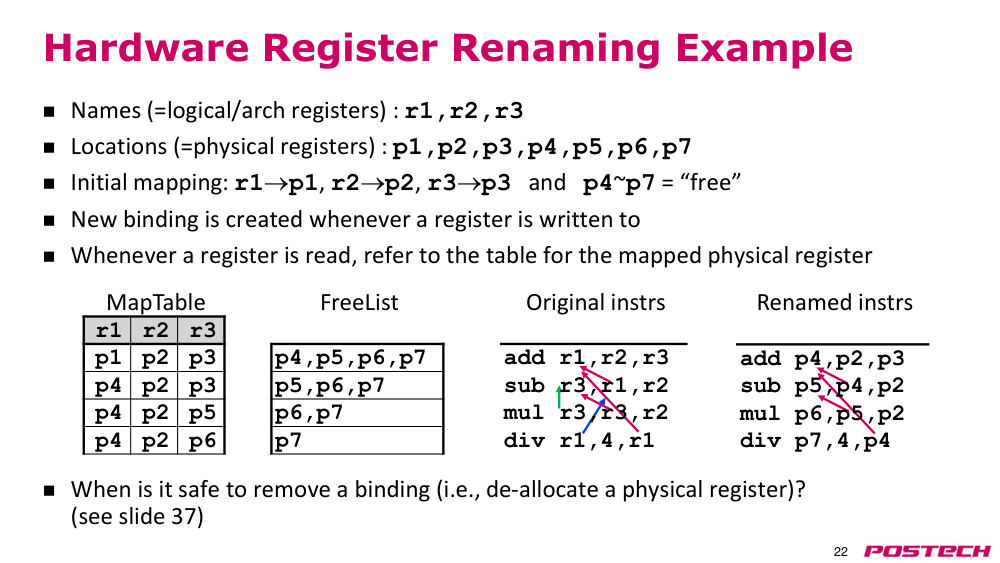
- 이름 (=논리적/아키텍처 레지스터): r1, r2, r3
- 위치 (=물리 레지스터): p1, p2, p3, p4, p5, p6, p7
- 초기 매핑: r1 → p1, r2 → p2, r3 → p3, p4~p7 = '자유'
- 레지스터를 쓸 때마다 새로운 바인딩 생성
- 레지스터를 읽을 때마다 테이블을 참조하여 매핑된 physical register(물리 레지스터) 확인
- 언제 바인딩을 제거할 수 있는가 (즉, physical register(물리 레지스터)를 해제할 수 있는가)?
- (슬라이드 37 참조)
- 원본 명령어
- add r1, r2, r3
- sub r3, r1, r2
- mul r3, r3, r2
- div r1, 4, r1
- MapTable
- FreeList
- r1
- r2
- r3
- p1
- p2
- p3
- p4, p5, p6, p7
- p4
- p2
- p3
- p5, p6, p7
- p4
- p2
- p5
- p6, p7
- p4
- p2
- p6
- p7
- 이름 바뀐 명령어
- add p4, p2, p3
- sub p5, p4, p2
- mul p6, p5, p2
- div p7, 4, p4
p.23out-of-order execution(OoO)(비순차 실행)
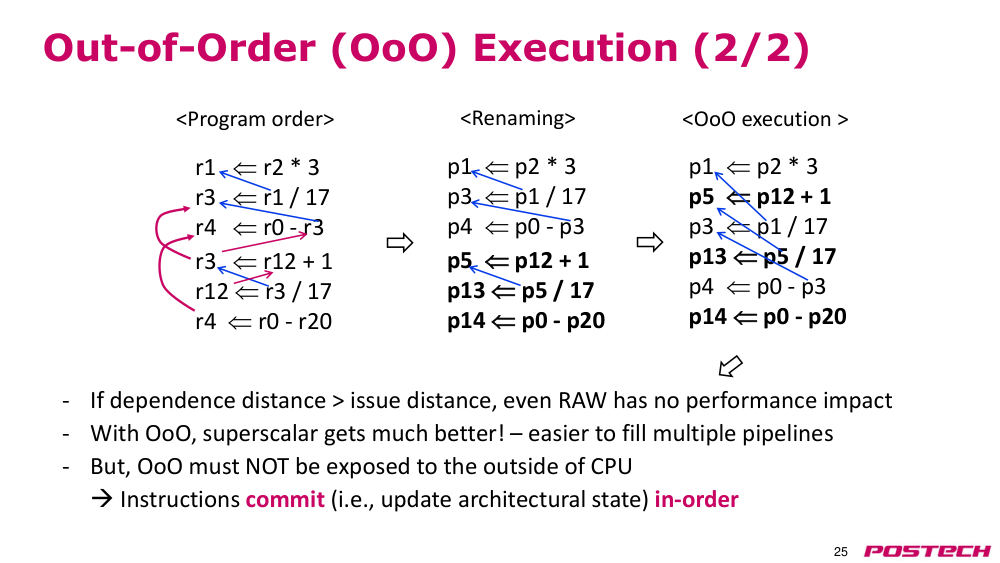
p.24out-of-order execution(OoO)(비순차 실행) (1/2)
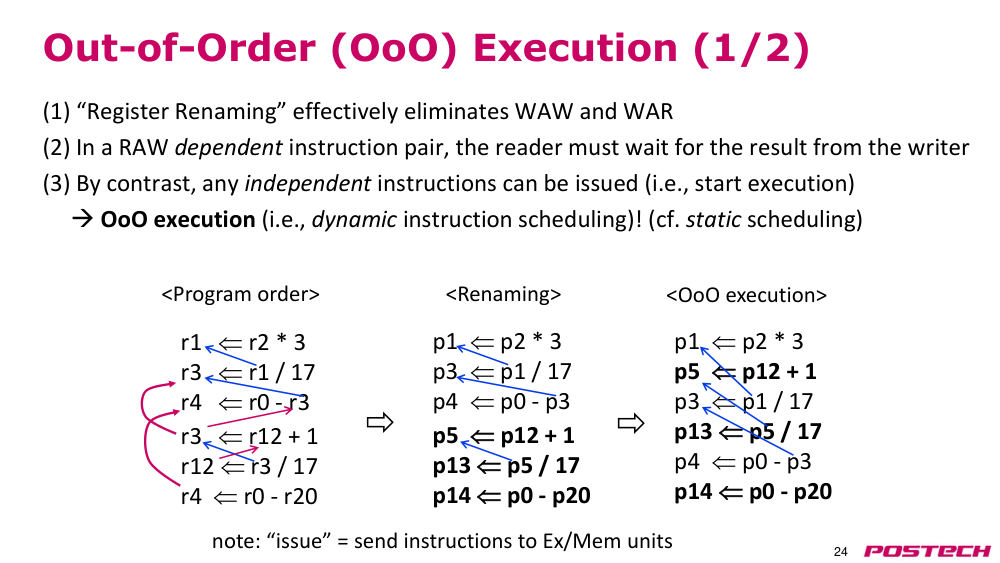
- (1) ‘register renaming(레지스터 이름 바꾸기)’는 WAW 및 WAR를 효과적으로 제거함
- (2) RAW 의존성 있는 명령어 쌍에서는, 읽는 쪽이 쓰는 쪽의 결과를 기다려야 함
- (3) 반면, 독립적인 명령어들은 발행 가능 (즉, 실행 시작 가능)
- → out-of-order execution(OoO)(비순차 실행) (즉, dynamic instruction scheduling(동적 명령어 스케줄링))! (cf. static scheduling(정적 스케줄링))
- 참고: ‘발행’ = 명령어를 실행/메모리 유닛에 전달함
- r1 ← r2 * 3
- r3 ← r1 / 17
- r4 ← r0 - r3
- r3 ← r12 + 1
- r12 ← r3 / 17
- r4 ← r0 - r20
- <프로그램 순서>
- p1 ← p2 * 3
- p3 ← p1 / 17
- p4 ← p0 - p3
- p5 ← p12 + 1
- p13 ← p5 / 17
- p14 ← p0 - p20
- <이름 바꾸기>
- <out-of-order execution(OoO)(비순차 실행)>
- p1 ← p2 * 3
- p5 ← p12 + 1
- p3 ← p1 / 17
- p13 ← p5 / 17
- p4 ← p0 - p3
- p14 ← p0 - p20
p.25out-of-order execution(OoO)(비순차 실행) (2/2)
- r1 ← r2 * 3
- r3 ← r1 / 17
- r4 ← r0 - r3
- r3 ← r12 + 1
- r12 ← r3 / 17
- r4 ← r0 - r20
- <프로그램 순서>
- p1 ← p2 * 3
- p3 ← p1 / 17
- p4 ← p0 - p3
- p5 ← p12 + 1
- p13 ← p5 / 17
- p14 ← p0 - p20
- <이름 바꾸기>
- <out-of-order execution(OoO)(비순차 실행)>
- p1 ← p2 * 3
- p5 ← p12 + 1
- p3 ← p1 / 17
- p13 ← p5 / 17
- p4 ← p0 - p3
- p14 ← p0 - p20
- dependency distance(의존성 거리) > issue distance(발행 거리)이면, 진짜 의존성(RAW)도 성능에 영향을 주지 않음
- out-of-order execution(OoO)(비순차 실행)를 사용하면, superscalar(슈퍼스칼라) 성능이 훨씬 향상됨 – 여러 파이프라인을 쉽게 채울 수 있음
- 하지만, out-of-order execution(OoO)(비순차 실행)는 CPU 외부에 노출되어서는 안 됨
- → 명령어는 순서 유지 커밋(architectural 상태 업데이트)됨
p.26현대 CPU에서의 out-of-order execution(OoO)(비순차 실행)
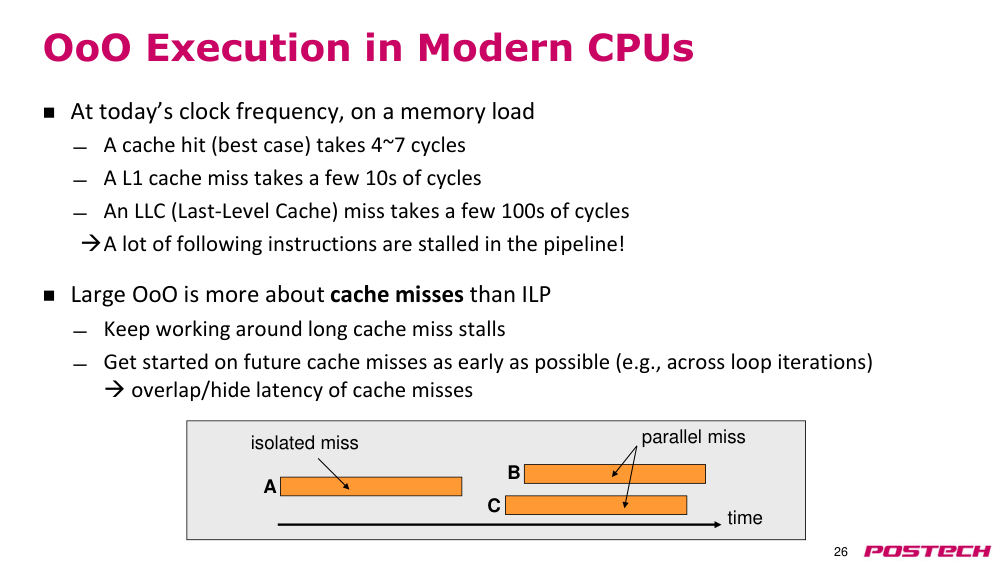
- 현재의 클럭 주파수에서 메모리 로드 시:
- 캐시 히트(최상의 경우)는 4~7 사이클 소요
- L1 cache miss(L1 캐시 미스)는 수십 사이클 소요
- LLC(마지막 레벨 캐시) 미스는 수백 사이클 소요
- → 파이프라인에 많은 후속 명령어가 정지됨!
- 대규모 out-of-order execution(OoO)(비순차 실행)는 명령 수준 병렬성(ILP)보다 cache miss(캐시 미스)에 더 큰 영향을 받음
- 긴 cache miss(캐시 미스) 정지 시간을 극복하기 위해 계속 작업 수행
- 루프 반복 간에도 가능한 한 일찍 미래의 cache miss(캐시 미스)를 시작
- → cache miss(캐시 미스) 지연을 겹치기/숨기기
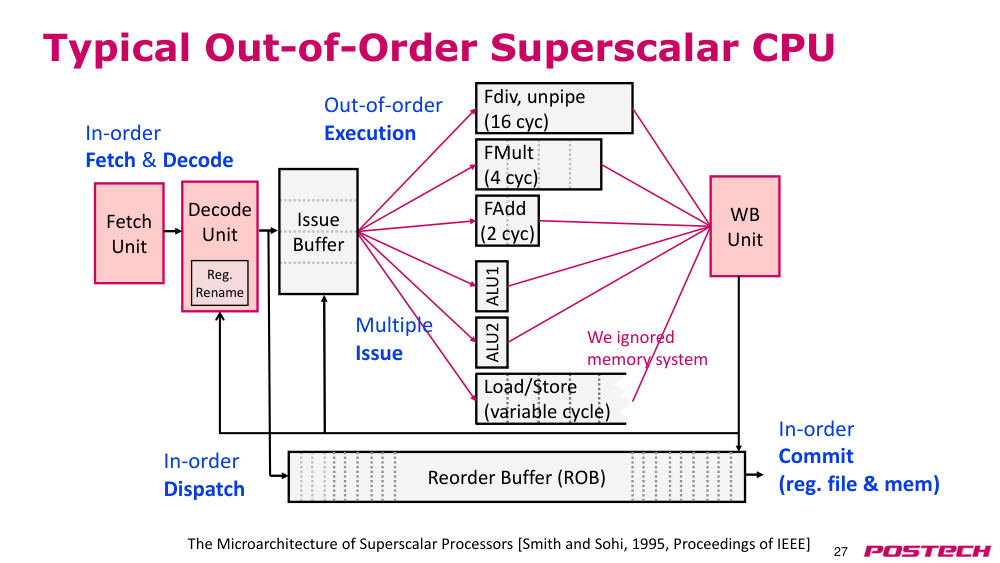
p.27일반적인 out-of-order superscalar(비순차 슈퍼스칼라) CPU
- FMult (4 cyc)
- FAdd (2 cyc)
- ALU1
- ALU2
- Load/Store (변동 사이클)
- Fdiv, unpipe (16 cyc)
- 쓰기-백 유닛(WB)
- 가져오기 유닛(Fetch Unit)
- 디코딩 유닛(Decode Unit)
- 발행 버퍼(Issue Buffer)
- 재정렬 버퍼(ROB)
- 순서 유지 가져오기 및 디코딩
- 메모리 시스템 무시
- register renaming(레지스터 이름 바꾸기)
- 순서 유지 배분
- 순서 유지 커밋(레지스터 파일 및 메모리)
- out-of-order execution(OoO)(비순차 실행)
- multiple issue(다중 발행)
- superscalar(슈퍼스칼라) 프로세서의 마이크로아키텍처 [Smith and Sohi, 1995, IEEE Proceedings]
p.28데이터 흐름 실행 순서
- 많은 미완료 명령어의 윈도우 유지 (a.k.a. 'issue buffer(발행 버퍼)' 또는 'issue queue (ISQ)(발행 큐)')
- operand ready(피연산자 준비) 상태인 명령어를 out-of-order issue(비순차 발행)
- 발행 큐(ISQ)는 새로 완료된 명령어의 결과가 ISQ에 있는 미완료 명령어의 연산자와 일치하는지 확인해야 함
- 이를 통해 RAW 의존성 위반 없이 적시에 out-of-order issue(비순차 발행) 가능
- 준비된 명령어 중 더 오래된 명령어를 발행
p.29명령어 재정렬 버퍼(ROB)
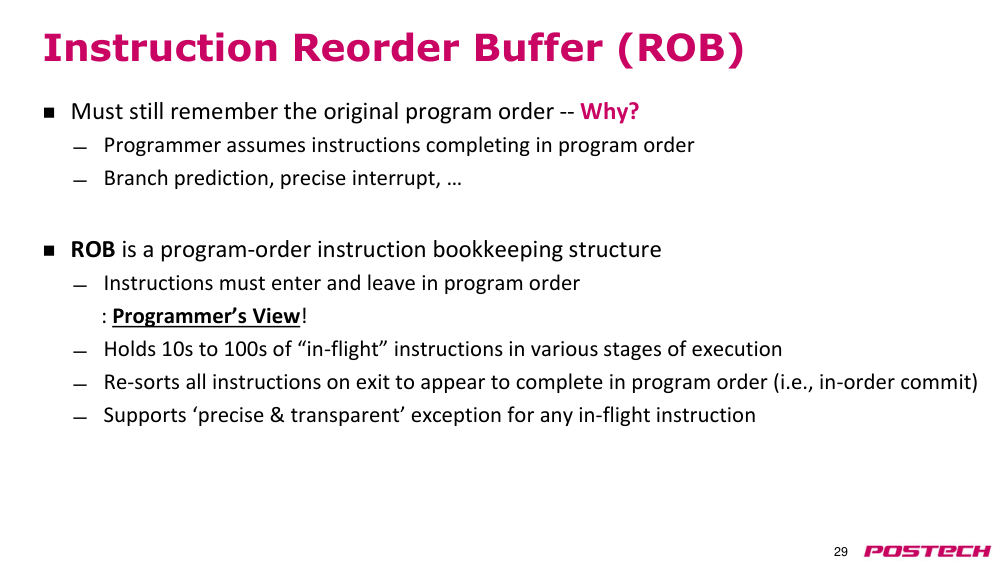
- 원래 프로그램 순서를 기억해야 하는 이유는?
- 프로그래머는 명령어가 프로그램 순서대로 완료된다고 가정함
- branch prediction(분기 예측), precise interrupt(정확한 인터럽트) 등
- ROB는 프로그램 순서 명령어 관리 구조
- 명령어는 프로그램 순서대로 입력 및 출력되어야 함
- → 프로그래머의 시각!
- 실행 중인 다양한 단계의 'In-Flight instructions(비행 중 명령어)' 10개에서 100개를 보유
- 나가는 시점에 모든 명령어를 재정렬하여 프로그램 순서대로 완료된 것처럼 보이게 함 (즉, 순서 유지 커밋)
- 모든 In-Flight instructions(비행 중 명령어)에 대해 'precise & transparent exception(정확하고 투명한 예외)' 지원
p.30로드/스토어 큐(LSQ)
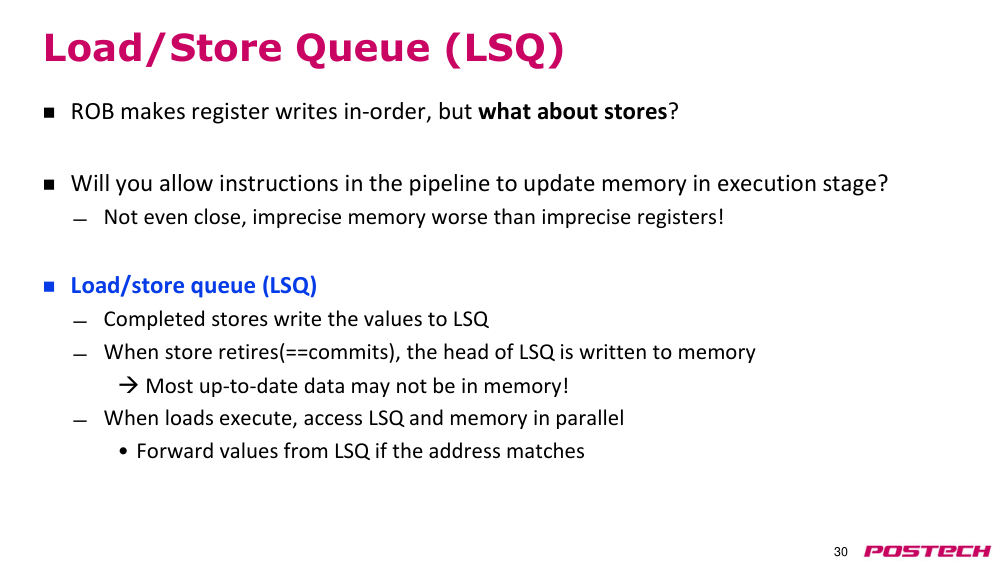
- ROB는 레지스터 쓰기를 순서 유지하지만, 스토어는 어떻게 할 것인가?
- 파이프라인 내 명령어가 실행 단계에서 메모리 업데이트를 허용할 것인가?
- 아니요, 정확하지 않은 메모리 상태는 정확하지 않은 레지스터보다 더 나쁨!
- 로드/스토어 큐(LSQ)
- 완료된 스토어는 값을 LSQ에 씀
- 스토어가 리타이어(==커밋)할 때, LSQ의 머리 부분이 메모리에 씀
- → 가장 최신 데이터가 메모리에 있을 수 없음!
- 로드가 실행될 때, LSQ와 메모리를 병렬로 접근
- 주소가 일치하면 LSQ에서 값을 포워딩
p.31out-of-order execution(OoO)(비순차 실행) CPU를 바쁘게 유지하는 도전 과제
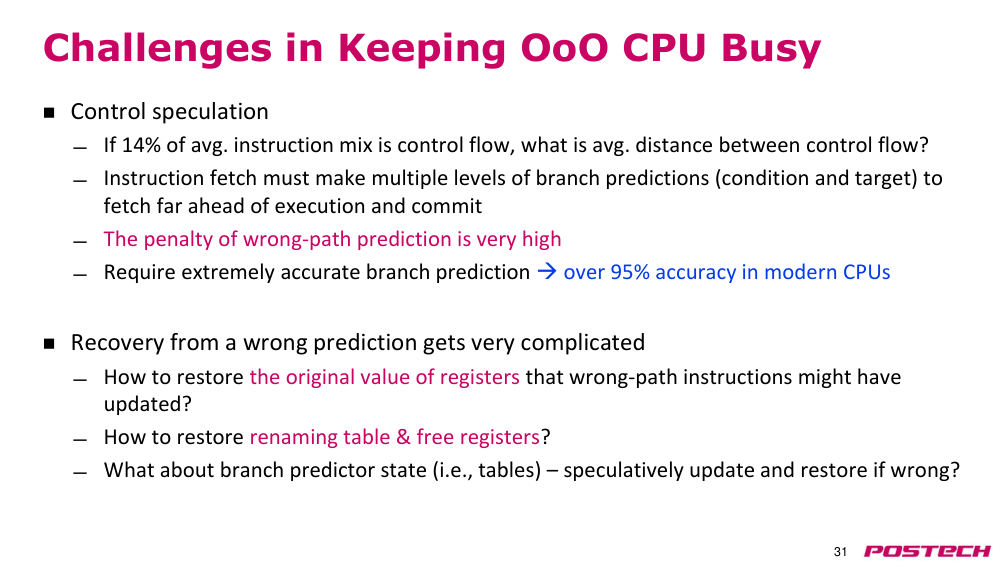
- control speculation(제어 추측)
- 평균 명령어 조합의 14%가 제어 흐름이라면, 제어 흐름 간의 평균 거리는 얼마인가?
- instruction fetch(명령어 가져오기) 단계는 실행 및 커밋보다 훨씬 앞서 가기 위해 다수의 분기 예측(조건 및 대상)을 수행해야 한다.
- Wrong-Path prediction(오류 경로 예측)의 벌점은 매우 크다.
- 현대 CPU에서는 branch prediction(분기 예측) 정확도가 95% 이상이어야 한다.
- 오류 예측에 대한 복구는 매우 복잡해진다.
- 오류 경로 명령어가 업데이트한 레지스터의 원래 값을 어떻게 복원할 것인가?
- rename table(이름 바꾸기 테이블)과 자유 레지스터는 어떻게 복원할 것인가?
- branch prediction(분기 예측)기 상태(예: 테이블)는 어떻게 처리할 것인가? – speculative execution(추측 실행)된 상태를 업데이트하고, 오류일 경우 복원해야 한다.
p.32superscalar(슈퍼스칼라)/out-of-order execution(OoO)(비순차 실행)에서의 speculative execution(추측 실행)
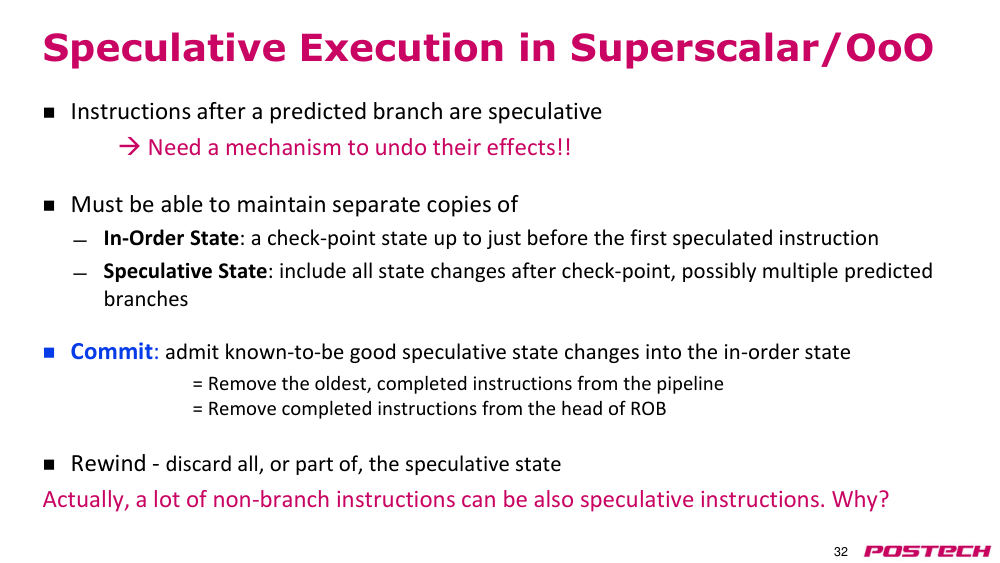
- 예측된 분기 뒤의 명령어는 speculative execution(추측 실행)된다.
- → speculative execution(추측 실행)된 명령어의 영향을 되돌릴 수 있는 메커니즘이 필요하다!
- 다음과 같은 별도의 사본을 유지해야 한다.
- 순서 유지 상태: 첫 번째 speculative execution(추측 실행) 명령어 직전까지의 체크포인트 상태
- speculative execution(추측 실행) 상태: 체크포인트 이후의 모든 상태 변화를 포함하며, 여러 개의 예측된 분기 가능
- 커밋: speculative execution(추측 실행) 상태 중 확실히 올바른 변화를 순서 유지 상태에 반영한다.
- → 파이프라인에서 가장 오래된 완료된 명령어 제거
- → ROB의 머리 부분에서 완료된 명령어 제거
- 되돌리기: speculative execution(추측 실행) 상태 전체 또는 일부를 버린다.
- 사실, 분기 명령어 외에도 많은 비분기 명령어도 speculative execution(추측 실행) 명령어가 될 수 있다. 왜일까?
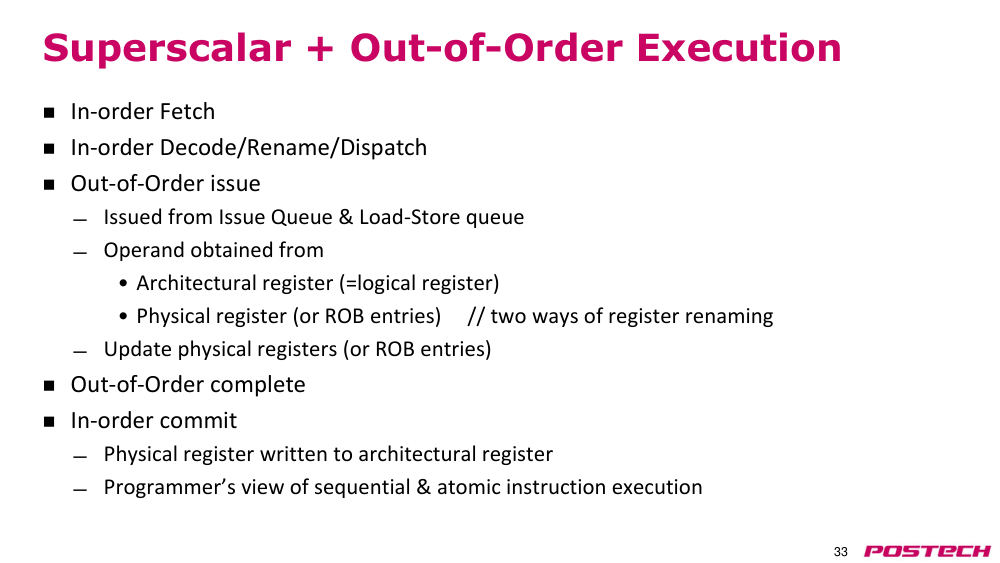
p.33superscalar(슈퍼스칼라) + out-of-order execution(OoO)(비순차 실행)
- 순서 유지 가져오기
- 순서 유지 디코딩/이름 바꾸기/배분
- out-of-order issue(비순차 발행)
- → issue queue (ISQ)(발행 큐) 및 Load/Store queue (LSQ)(로드/스토어 큐)에서 발행
- 연산자 획득 원본:
- • 아키텍처 레지스터 (=논리 레지스터)
- • 물리 레지스터(또는 ROB 항목)
- → register renaming(레지스터 이름 바꾸기)의 두 가지 방식
- 물리 레지스터(또는 ROB 항목) 업데이트
- out-of-order completion(비순차 완료)
- in-order commit(순서 유지 커밋)
- • physical register(물리 레지스터)의 값이 architectural register(아키텍처 레지스터)에 쓰임
- • 프로그래머가 보는 순차적이고 원자적인 명령어 실행
p.34실제 out-of-order execution(비순차 실행) CPU 설계 사례
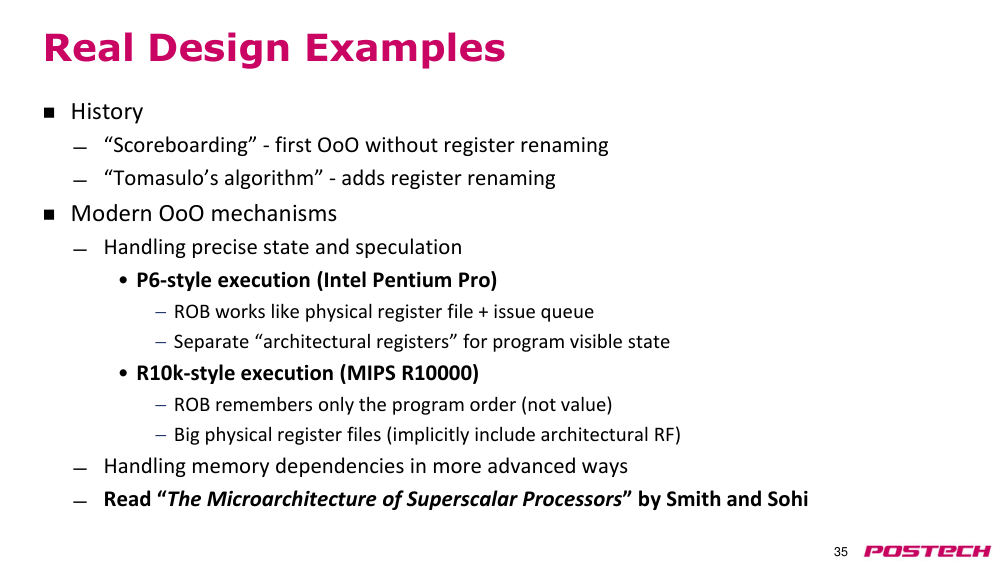
p.35실제 설계 사례
- 역사
- “Scoreboarding” – register renaming(레지스터 이름 바꾸기) 없이 처음으로 out-of-order execution(OoO)(비순차 실행)을 구현한 기법
- “Tomasulo’s algorithm” – register renaming(레지스터 이름 바꾸기)를 추가한 기법
- 현대 out-of-order execution(비순차 실행) 메커니즘
- 정확한 상태 및 speculative execution(추측 실행) 처리
- • P6 스타일 실행 (Intel Pentium Pro)
- - ROB는 physical register file(물리 레지스터 파일) + issue queue (ISQ)(발행 큐) 역할을 한다.
- - 프로그램이 보는 상태를 위한 별도의 ‘architectural register(아키텍처 레지스터)’ 사용
- • R10k 스타일 실행 (MIPS R10000)
- - ROB는 값이 아닌 프로그램 순서만 기억한다.
- - 큰 physical register file(물리 레지스터 파일) 사용 (암묵적으로 아키텍처 RF 포함)
- 메모리 의존성 처리를 더 고도로 구현
- • ‘The Microarchitecture of Superscalar Processors’ [Smith and Sohi] 참조
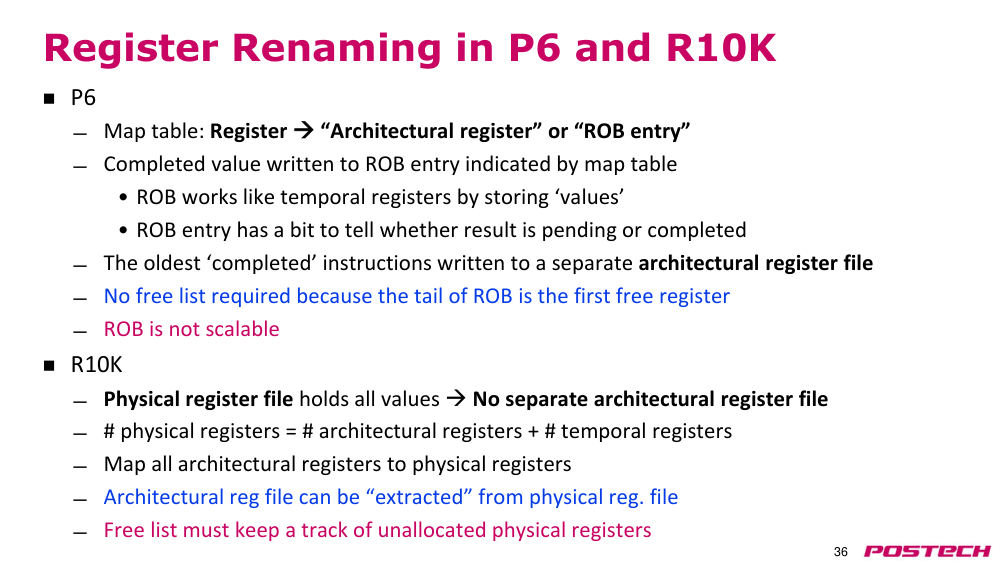
p.36P6 및 R10K의 register renaming(레지스터 이름 바꾸기)
- P6
- 매핑 테이블: 레지스터 → ‘architectural register(아키텍처 레지스터)’ 또는 ‘ROB 항목’
- 완료된 값은 매핑 테이블이 지시하는 ROB 항목에 쓰임
- • ROB는 ‘값’을 저장함으로써 시간적 레지스터처럼 작동
- • ROB 항목에는 결과가 대기 중인지 완료되었는지 여부를 나타내는 비트 포함
- 가장 오래된 ‘완료된’ 명령어는 별도의 architectural register(아키텍처 레지스터) 파일에 쓰임
- free list(자유 목록)이 필요 없음: ROB의 꼬리 부분이 첫 번째 자유 레지스터이기 때문
- ROB는 확장성이 떨어짐
- R10K
- physical register file(물리 레지스터 파일)이 모든 값을 보유 → 별도의 architectural register(아키텍처 레지스터) 파일 없음
- physical register(물리 레지스터) 수 = architectural register(아키텍처 레지스터) 수 + 시간적 레지스터 수
- 모든 architectural register(아키텍처 레지스터)를 physical register(물리 레지스터)로 매핑
- architectural register(아키텍처 레지스터) 파일은 physical register file(물리 레지스터 파일)에서 ‘추출’ 가능
- free list(자유 목록)은 할당되지 않은 physical register(물리 레지스터)를 추적해야 함
p.37P6 및 R10K에서 레지스터 해제
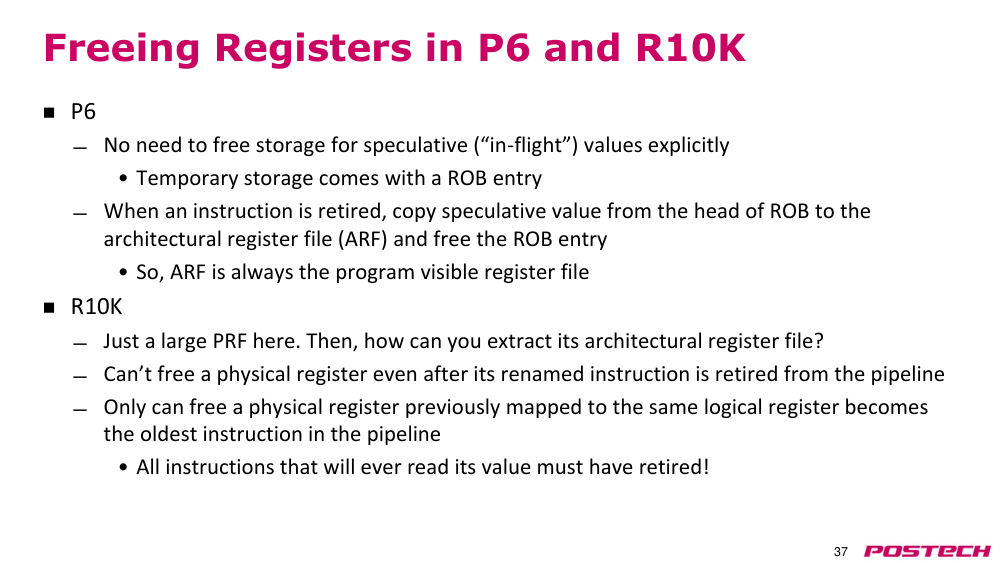
- P6
- speculative execution(추측 실행)("비행 중") 값에 대한 저장소를 명시적으로 해제할 필요 없음
- • 일시적 저장소는 ROB 항목과 함께 제공됨
- • 명령어가 retire(리타이어)될 때, ROB의 머리 부분에서 speculative execution(추측 실행) 값을 architectural register file(아키텍처 레지스터 파일, ARF)로 복사하고 ROB 항목을 해제함
- • 따라서 ARF는 항상 프로그램에서 보이는 레지스터 파일임
- R10K
- 여기에는 단지 큰 physical register(물리 레지스터) 파일(PRF)이 있음. 그러면 어떻게 architectural register(아키텍처 레지스터) 파일을 추출할 수 있는가?
- • speculative execution(추측 실행) 명령어가 파이프라인에서 완료된 후에도 physical register(물리 레지스터)를 해제할 수 없음
- • 동일한 논리 레지스터에 이전에 매핑된 physical register(물리 레지스터)만, 파이프라인에서 가장 오래된 명령어가 되었을 때에만 해제 가능함
- • 그 값이 읽힐 수 있는 모든 명령어가 이미 완료되어야 함!
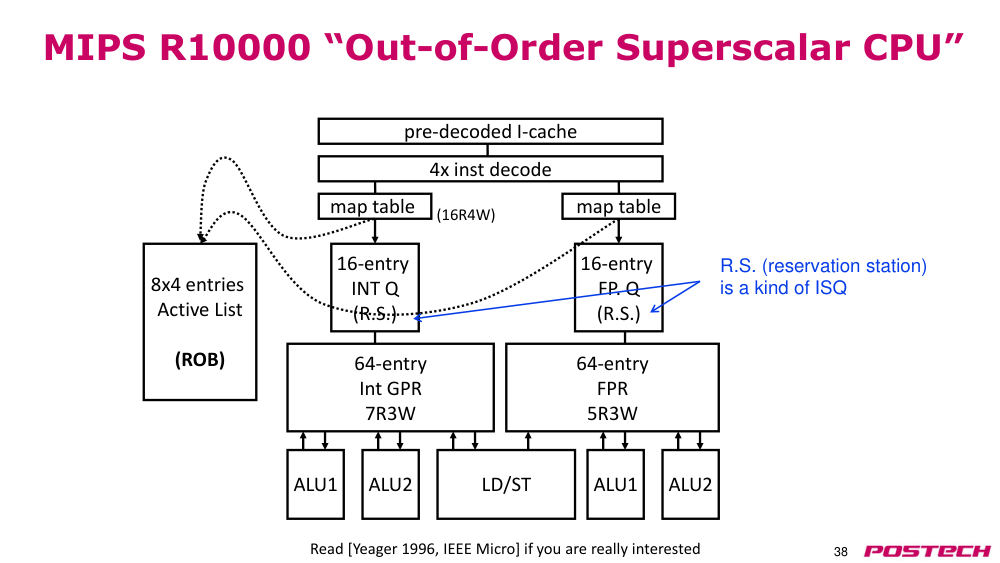
p.38MIPS R10000 "out-of-order superscalar(비순차 슈퍼스칼라) CPU"
- 4x 명령어 디코딩
- 매핑 테이블
- 사전 디코딩된 I-Cache
- 8x4 항목
- 활성 목록(Active List)
- (ROB)
- 16개 항목
- 정수 큐(INT Q)
- (R.S.)
- ALU1
- ALU2
- 64개 항목
- 정수 GPR
- 7R3W
- 로드/스토어(LD/ST)
- 64개 항목
- 부동소수점 GPR
- 5R3W
- ALU1
- ALU2
- 16개 항목
- 부동소수점 큐(FP. Q)
- (R.S.)
- 매핑 테이블
- (16R4W)
- 더 깊이 알고 싶다면 [Yeager 1996, IEEE Micro]를 읽어보세요
- R.S. (예약 스테이션)은 ISQ의 일종임
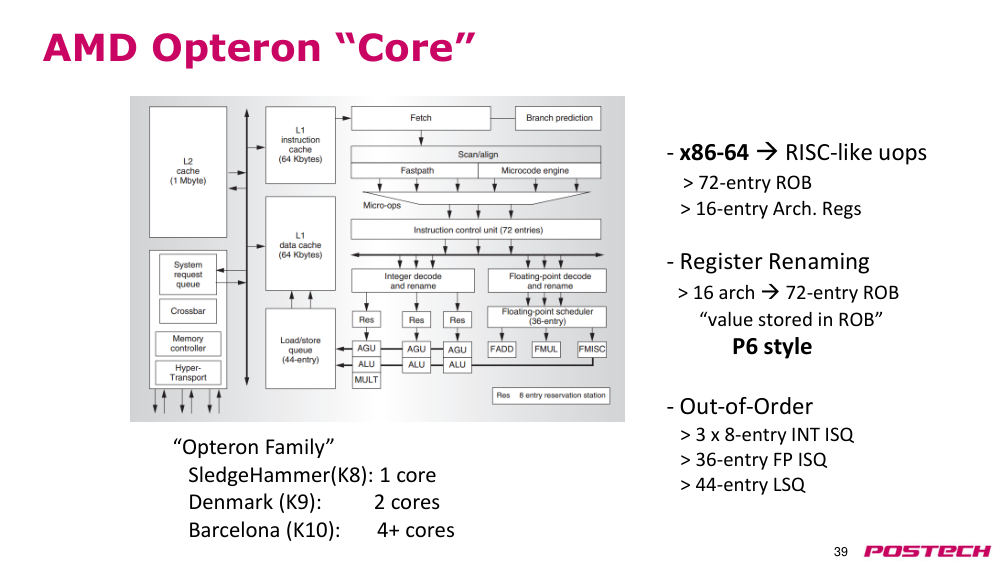
p.39"Opteron Family"
- SledgeHammer(K8): 1코어
- Denmark (K9): 2코어
- Barcelona (K10): 4+코어
- AMD Opteron "Core"
- - x86-64 → RISC 유사 uops
- > 72개 항목 ROB
- > 16개 항목 architectural register(아키텍처 레지스터)
- - register renaming(레지스터 이름 바꾸기)
- > 16개 architectural register(아키텍처 레지스터) → 72개 항목 ROB
- "ROB에 저장된 값"
- P6 스타일
- - out-of-order execution(OoO)(비순차 실행)
- > 3 x 8개 항목 정수 ISQ
- > 36개 항목 부동소수점 ISQ
- > 44개 항목 LSQ
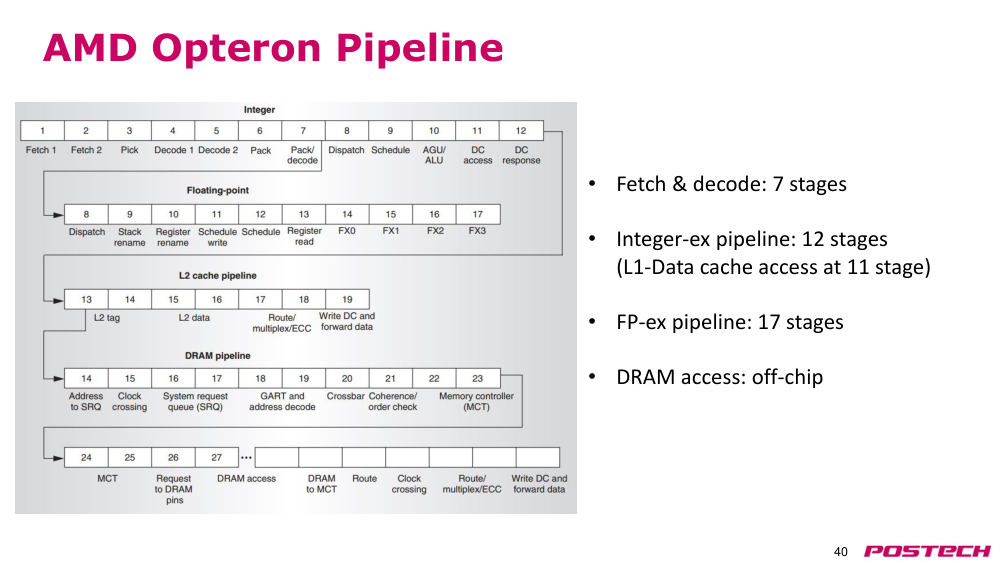
p.40AMD Opteron 파이프라인
- • instruction fetch(명령어 가져오기) 및 디코딩: 7단계
- • 정수 실행 파이프라인: 12단계
- (L1-데이터 캐시 접근은 11단계에서 수행)
- • 부동소수점 실행 파이프라인: 17단계
- • DRAM 접근: 온칩 외부
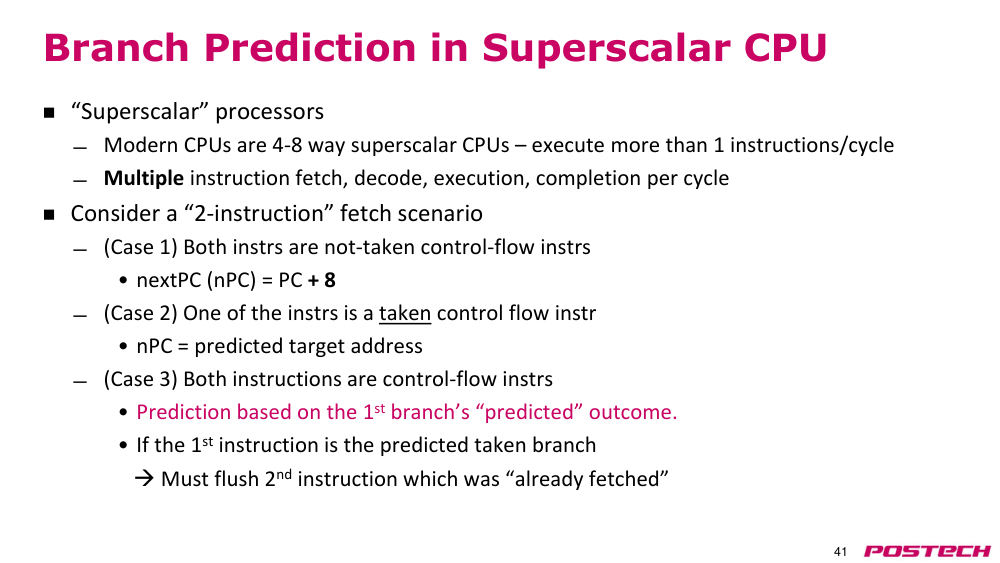
p.41superscalar(슈퍼스칼라) CPU에서의 branch prediction(분기 예측)
- "superscalar(슈퍼스칼라)" 프로세서
- 현대 CPU는 4-8방향 superscalar(슈퍼스칼라) CPU – 1사이클당 1개 이상의 명령어 실행
- 1사이클당 다수의 instruction fetch(명령어 가져오기), 디코딩, 실행, 완료
- 2명령어 가져오기 시나리오를 고려해보자
- (사례 1) 두 명령어 모두 분기되지 않은 제어 흐름 명령어
- • 다음PC(nPC) = PC + 8
- (사례 2) 명령어 중 하나가 분기된 제어 흐름 명령어
- • nPC = 예측된 대상 주소
- (사례 3) 두 명령어 모두 제어 흐름 명령어
- • 첫 번째 분기의 "예측된" 결과에 기반하여 예측
- • 첫 번째 명령어가 예측된 분기된 분기라면
- → 이미 가져온 두 번째 명령어를 버려야 함 (플러시)
p.42칩 멀티프로세서(CMP)
p.43칩 멀티프로세서 (CMP)
- 트랜지스터 스케일링은 끝나지 않았다.
- 하지만 단일 스레드 성능 향상의 수익 감소 (명령 수준 병렬성(ILP)의 한계로 인해)
- 증가하는 트랜지스터 수를 가장 효과적으로 사용하는 방법은?
- CMP(또는 멀티코어 마이크로프로세서)
- 칩에 여러 개의 더 작고 단순한 코어를 배치한다.
- 단순한 코어들을 여러 개 배치하여 쉽게 구현할 수 있다.
- 충분한 메모리 및 I/O 대역폭을 제공해야 한다.
- 응용 프로그램은 충분한 스레드 수준 병렬성(TLP)을 가져야 한다.
- 단일 스레드 응용 프로그램은 여러 개의 병렬 스레드로 나누어져야 한다.
- 동시에 여러 스레드나 프로세스를 실행할 수 없으면 CMP는 의미가 없다.
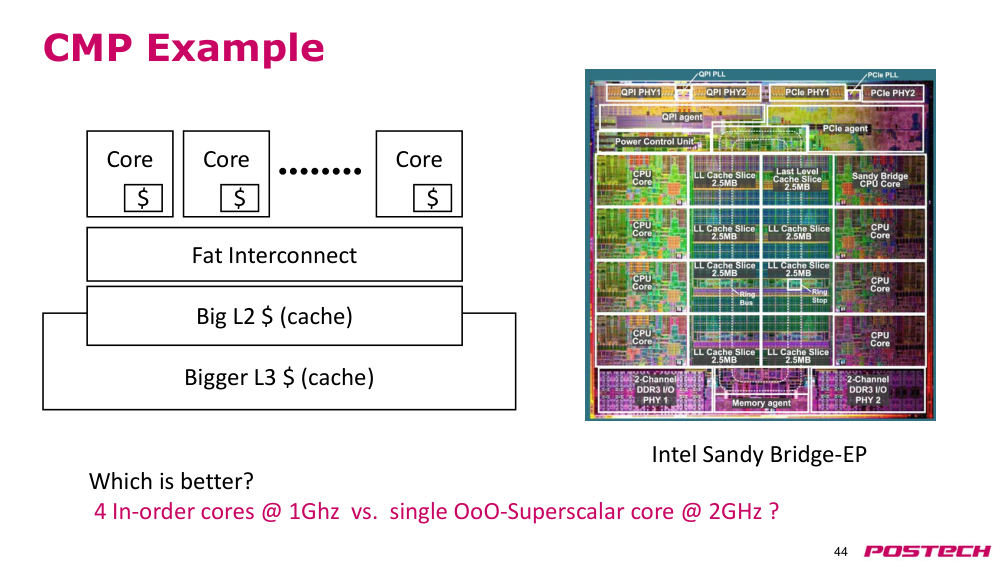
p.44CMP 예제
- 어느 쪽이 더 나은가?
- 4개의 in-order(순차 실행) 코어 @ 1GHz vs. 단일 out-of-order superscalar(비순차 슈퍼스칼라) 코어 @ 2GHz?
- 큰 L3 캐시 $ (캐시)
- 코어 $
- 코어 $
- 코어 $
- 두꺼운 인터커넥트
- 큰 L2 $ (캐시)
- Intel Sandy Bridge-EP
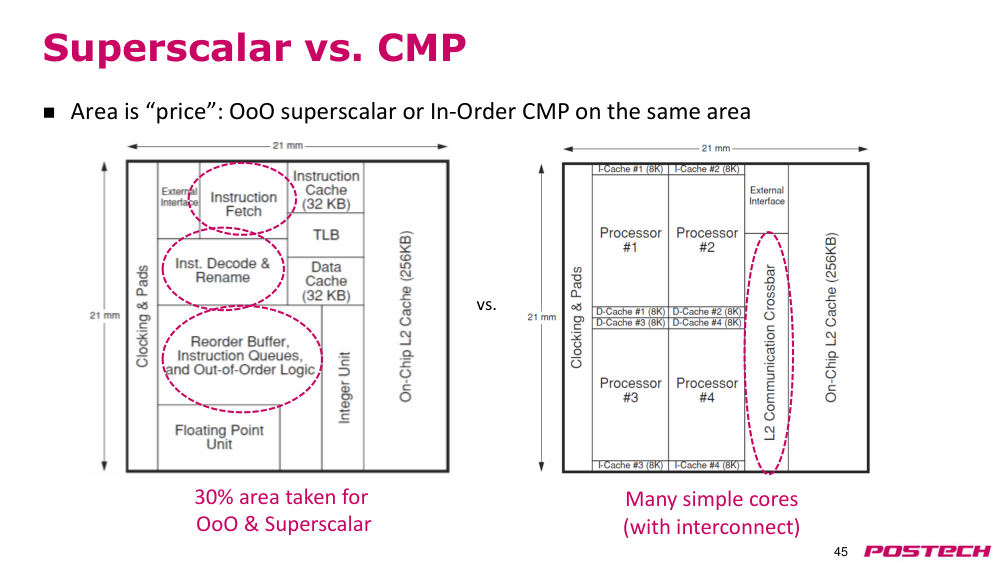
p.45
p.46superscalar(슈퍼스칼라) vs. CMP
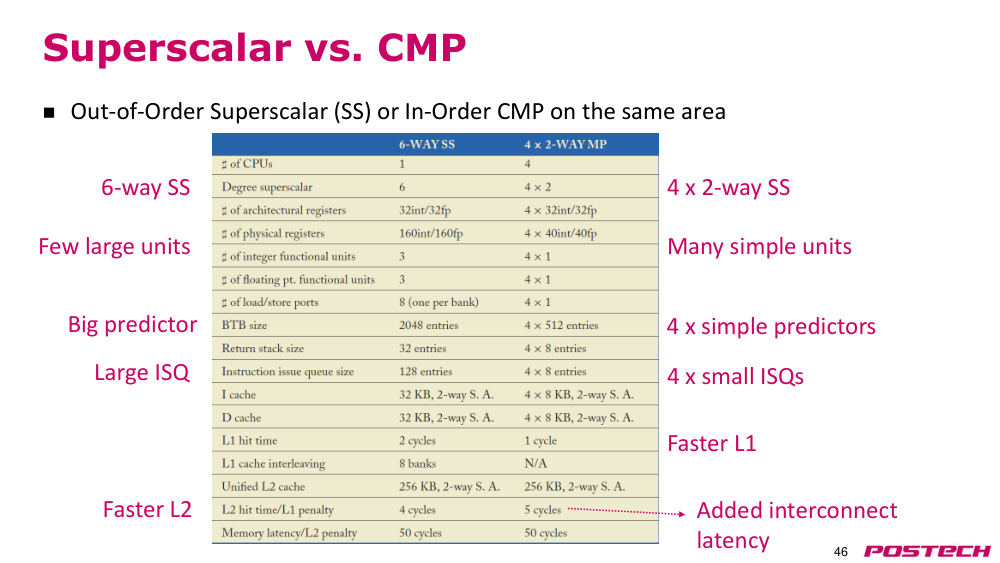
- - out-of-order superscalar(비순차 슈퍼스칼라, SS) 또는 동일한 면적에서 in-order(순차 실행) CMP
- - 더 빠른 L1
- - 더 빠른 L2
- - 6방향 SS
- - 4개의 2방향 SS
- - 4개의 간단한 예측기
- - 큰 예측기
- - 적은 크고 큰 유닛
- - 많은 간단한 유닛
- - 큰 ISQ
- - 4개의 작은 ISQ
- - 추가된 상호연결 지연
p.47superscalar(슈퍼스칼라) 발행
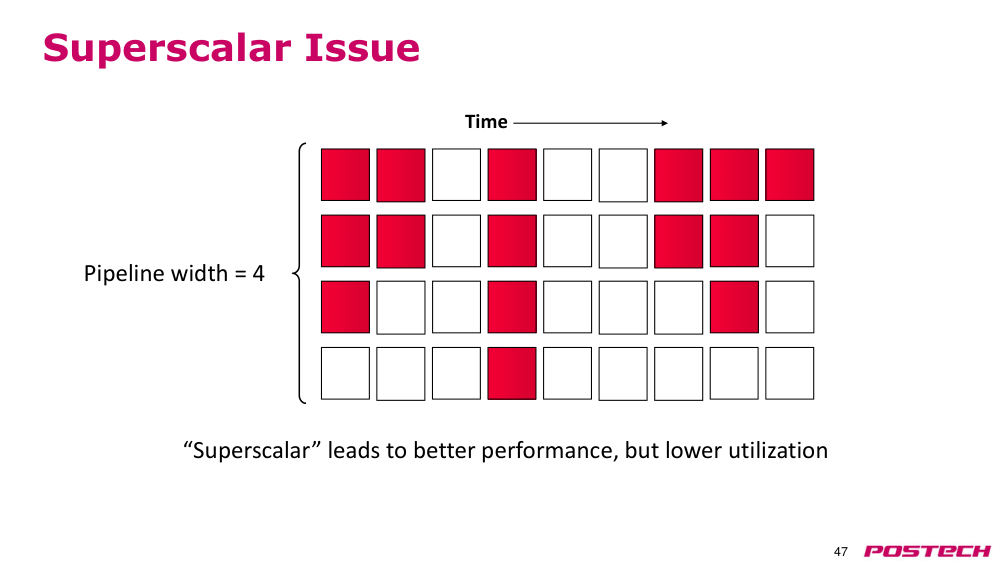
- "superscalar(슈퍼스칼라)"는 더 나은 성능을 가져오지만, 낮은 활용도를 초래한다.
- 시간
- pipeline width(파이프라인 폭) = 4
p.48칩 멀티프로세서 (CMP)
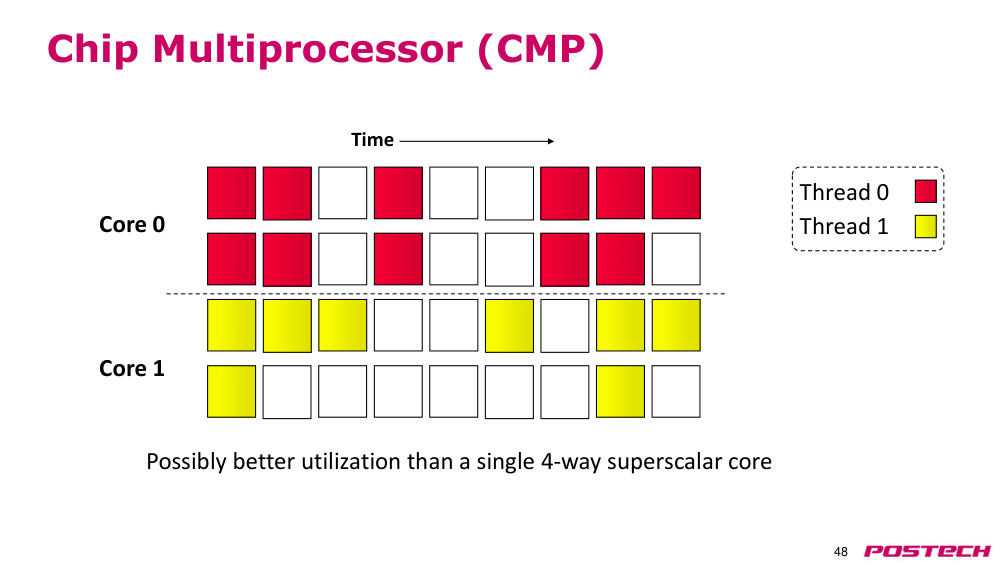
- 단일 4방향 superscalar(슈퍼스칼라) 코어보다 더 나은 자원 활용 가능
- 시간
- 코어 0
- 코어 1
- 스레드 0
- 스레드 1
p.49Intel CPU의 역사
- Intel uArchitecture
- P5 (Pentium)
- • 5단계, 2-way(2-웨이) in-order(순차 실행) superscalar(슈퍼스칼라)
- P6 (Pentium 3, Pentium Pro)
- • 10~14단계, superpipelined(슈퍼파이프라인), out-of-order superscalar(비순차 슈퍼스칼라)
- Netburst (Pentium 4)
- • 20~31단계, 적극적인 out-of-order superscalar(비순차 슈퍼스칼라), SMT
- Core (Pentium M)
- • 14단계 (실제로는 P6) + 멀티코어
- Bonnell (ATOM)
- • 16단계, 저전력용 2-way(2-웨이) in-order(순차 실행) superscalar(슈퍼스칼라)
- Nehalem (i3, i5, i7) & Sandy Bridge
- • 최대 8코어, 위의 모든 고급 기술 포함
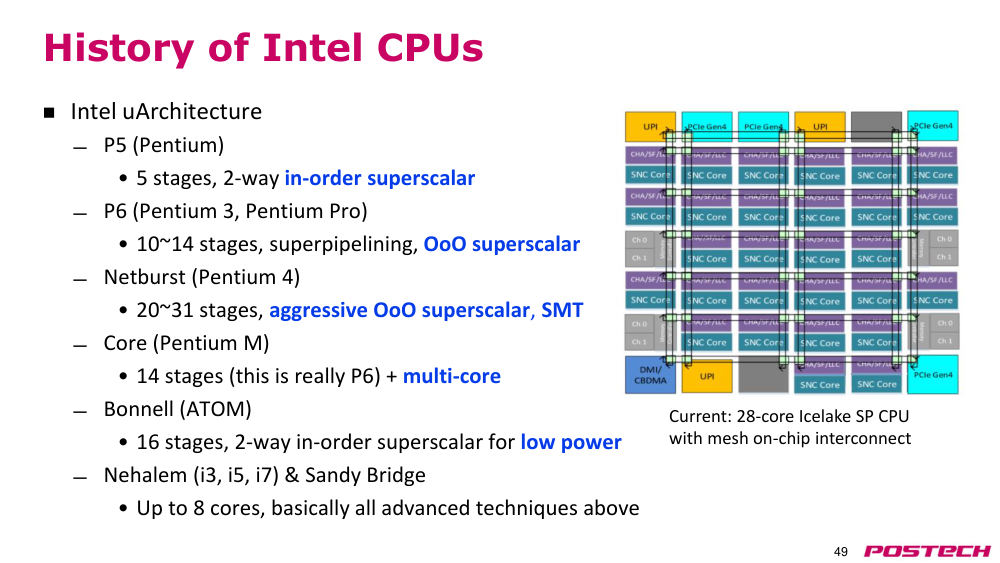
- 현재: 메시 온칩 인터커넥트를 갖춘 28코어 Icelake SP CPU
p.50질문?
- 공지사항
- • 논문 비평: Smith와 Sohi의 "The Microarchitecture of Superscalar Processors" (IEEE Proceedings, Vol. 83, No. 12, 1995년 11월)
- • 마감일: 5월 21일 (금) 23:59