이 자료를 쓰는 강의: 30 Interconnection network(상호연결망): topology 와 flow control · 31 credit flow control, routing, router microarchitecture
Lec21 - Interconnect
한국어판 강의자료 · 53쪽
p.1
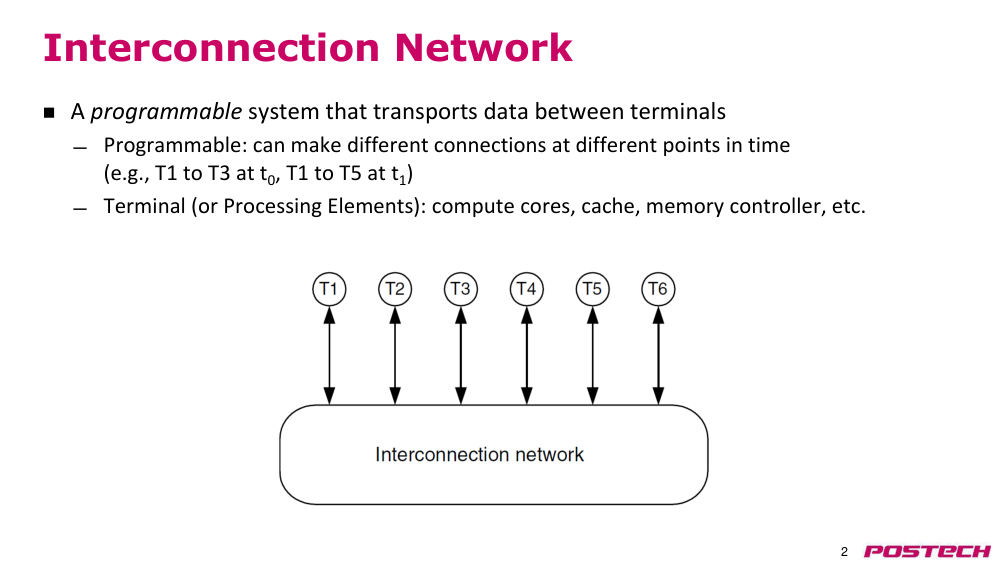
p.2interconnection network(상호연결망)
- - programmable(프로그래머블) 시스템으로, terminal(단말기) 간 데이터를 전송한다.
- - programmable(프로그래머블): 시간에 따라 다른 연결을 만들 수 있다 (예: t0에 T1에서 T3, t1에 T1에서 T5)
- - 단말기(또는 처리 요소): 계산 코어, 캐시, 메모리 컨트롤러 등
p.3interconnection network(상호연결망)
- - 병렬 컴퓨터 아키텍처의 핵심을 이루는, 병렬 시스템을 연결하는 핵심 요소
- - LAN/WAN과 기본 개념은 유사하지만, 매우 다른 시간 규모/요구사항으로 인해 매우 다른 트레이드오프를 가진다
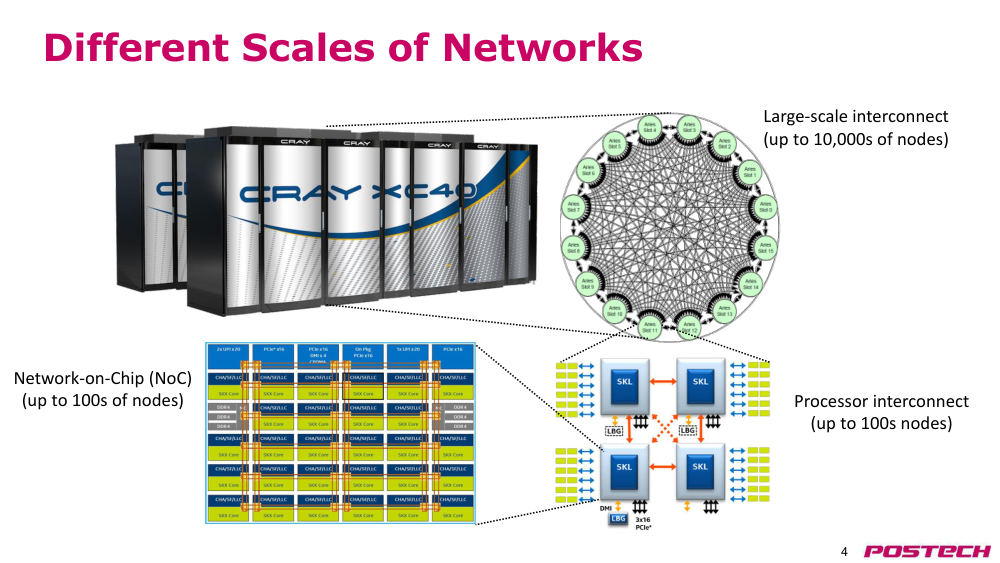
p.4네트워크의 다양한 규모
- - 네트워크온칩 (NoC)
- - 최대 수백 개의 노드
- - processor interconnect(프로세서 상호연결)
- - 최대 수백 개의 노드
- - large-scale interconnect(대규모 상호연결)
- - 최대 수천 개의 노드
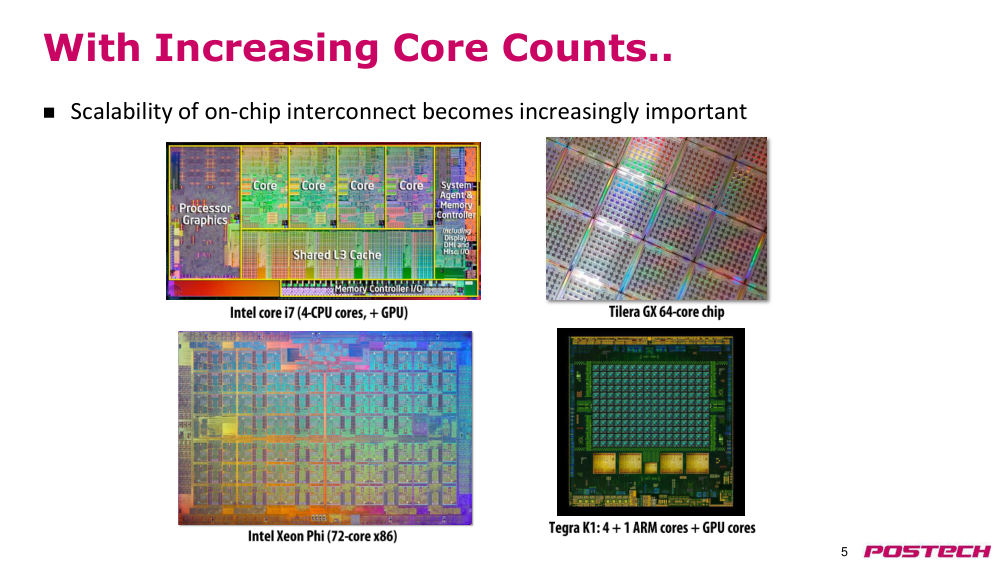
p.5코어 수 증가에 따라...
- - on-chip(온칩) interconnection network(상호연결망)의 scalability(확장성)이 점점 더 중요해진다
p.6Terminology(용어 정리)
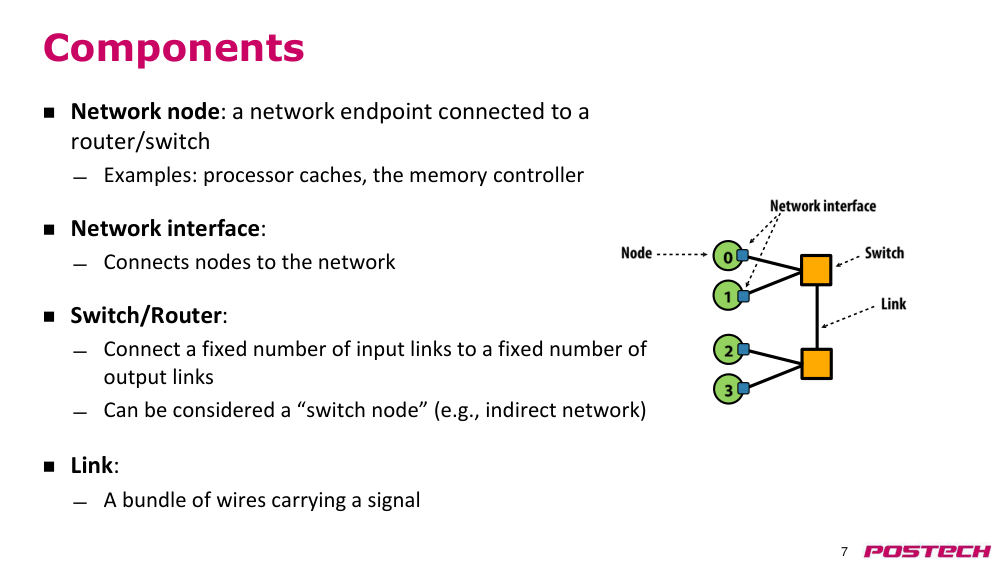
p.7구성 요소
- network node(네트워크 노드): 라우터/스위치에 연결된 네트워크 종단점
- 예: 프로세서 캐시, 메모리 컨트롤러
- network interface(네트워크 인터페이스):
- 노드를 네트워크에 연결함
- Switch/Router(스위치/라우터):
- 고정된 수의 입력 link(링크)를 고정된 수의 출력 링크에 연결함
- 간접형 네트워크의 경우 '스위치 노드'로 간주할 수 있음
- link(링크):
- 신호를 전달하는 와이어의 묶음
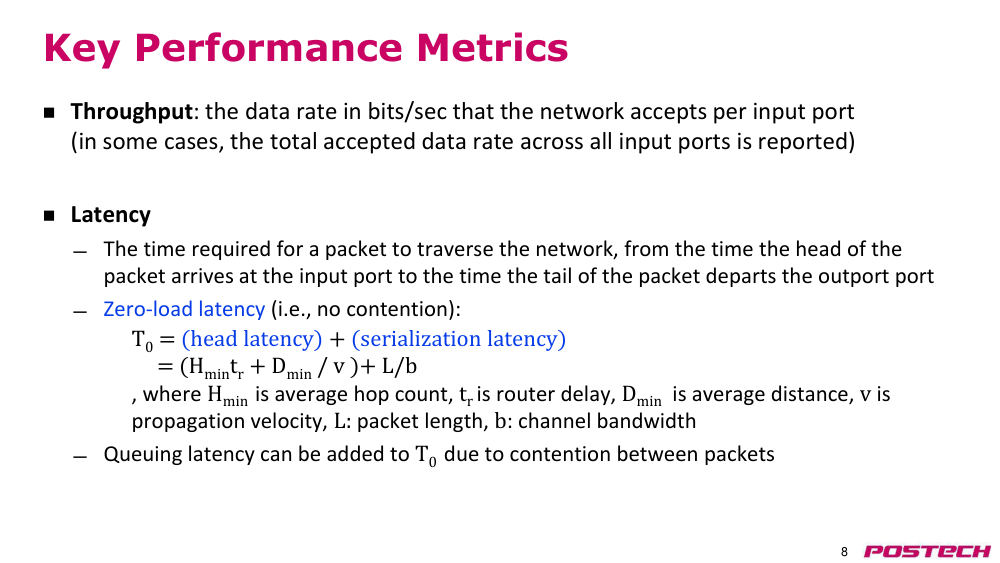
p.8핵심 성능 지표
- throughput(처리량): 네트워크가 입력 포트당 초당 수용하는 데이터 속도 (비트/초)
- 일부 경우 전체 입력 포트를 통한 총 수용 데이터 속도가 보고됨
- latency(지연시간):
- packet(패킷)이 네트워크를 통과하는 데 소요되는 시간. 패킷의 헤드가 입력 포트에 도착한 시점부터 패킷의 테일이 출력 포트를 떠나는 시점까지
- zero-load latency(무부하 지연시간) (즉, contention(경합) 없음):
- T0 = (헤드 지연시간) + (시리얼화 지연시간)
- = (Hmintr + Dmin / v) + L/b
- 여기서 Hmin은 평균 홉 수, tr은 router delay(라우터 지연), Dmin은 평균 거리, v는 propagation velocity(전파 속도), L: packet length(패킷 길이), b: channel bandwidth(채널 대역폭)
- 경쟁으로 인해 대기열 지연을 T0에 추가할 수 있음
p.9핵심 성능 지표 (계속)
- path diversity(경로 다양성):
- 대부분의 노드 쌍 사이에 여러 개의 minimal path(최소 경로)를 가진 네트워크는 노드 간 단일 경로만을 가진 네트워크보다 더 견고함
- channel(채널)에 걸쳐 load(부하)를 균형 있게 분산시켜 네트워크의 견고성을 높이며, 고장난 채널과 노드를 견딜 수 있도록 함
p.10네트워크의 latency(지연시간)-throughput(처리량) 특성
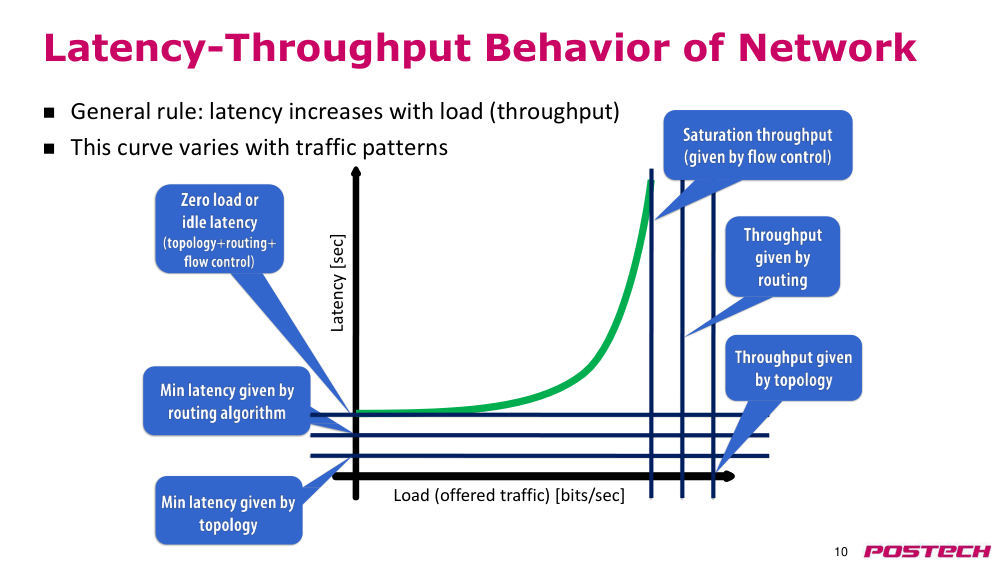
- 일반적인 규칙: latency(지연시간)은 load(부하), 즉 throughput(처리량)가 증가할수록 증가함
- 이 곡선은 traffic pattern(트래픽 패턴)에 따라 달라짐
- load(offered traffic)(제공 트래픽) [비트/초]
- latency(지연시간) [초]
p.11ICN의 주요 측면
- 토폴로지:
- 네트워크 내 channel(채널)과 노드의 정적 배치
- 라우팅:
- message(메시지)/packet(패킷)이 따라갈 수 있는 경로 집합을 결정함
- flow control(플로우 제어):
- packet(패킷)에 대해 네트워크 자원(채널, buffer(버퍼) 등)을 할당하고 경쟁을 관리함
- switch microarchitecture(스위치 마이크로아키텍처):
- 네트워크 스위치의 내부 아키텍처
- network interface(네트워크 인터페이스):
- terminal(단말기)를 스위치에 연결하는 방법
- link architecture(링크 아키텍처):
- channel(채널)에서의 신호 전달 기술과 data representation(데이터 표현) 방식
p.12토폴로지 유형
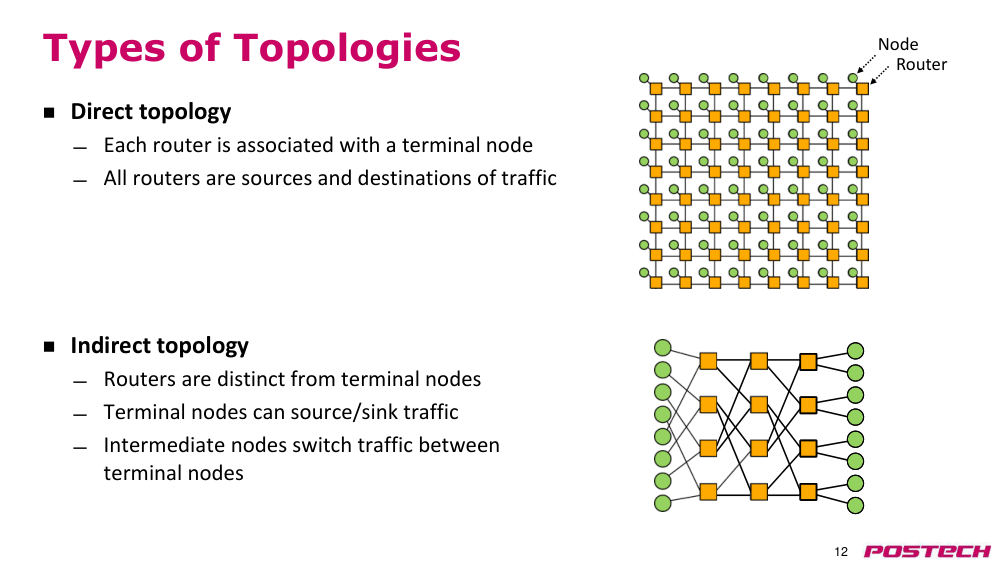
- direct topology(직접형 토폴로지):
- 각 라우터는 terminal(단말기) 노드와 연결됨
- 모든 라우터는 트래픽의 원천이자 목적지임
- indirect topology(간접형 토폴로지):
- 라우터는 terminal(단말기) 노드와 구분됨
- terminal(단말기) 노드는 트래픽을 생성하거나 수신할 수 있음
- 중간 노드는 terminal(단말기) 노드 간 트래픽을 스위칭함
- 라우터
- 노드
p.13상호연결 토폴로지의 특성
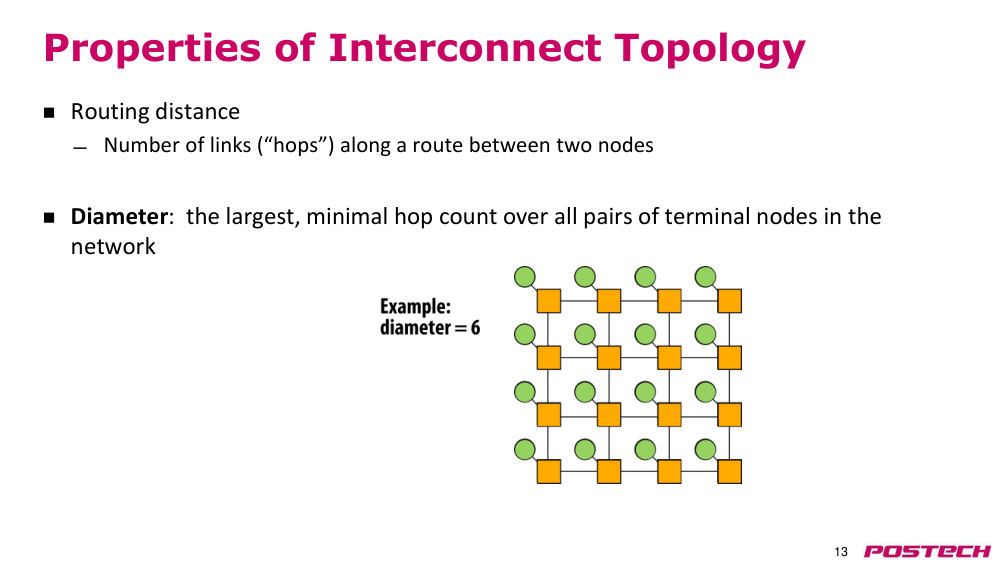
- routing distance(라우팅 거리): 두 노드 사이 경로를 따라가는 link(링크)(hop(홉))의 수
- diameter(지름): 네트워크 내 모든 terminal(단말기) 노드 쌍에 대한 최소 호프 수 중 최대값
p.14컷과 bisection(이등분)
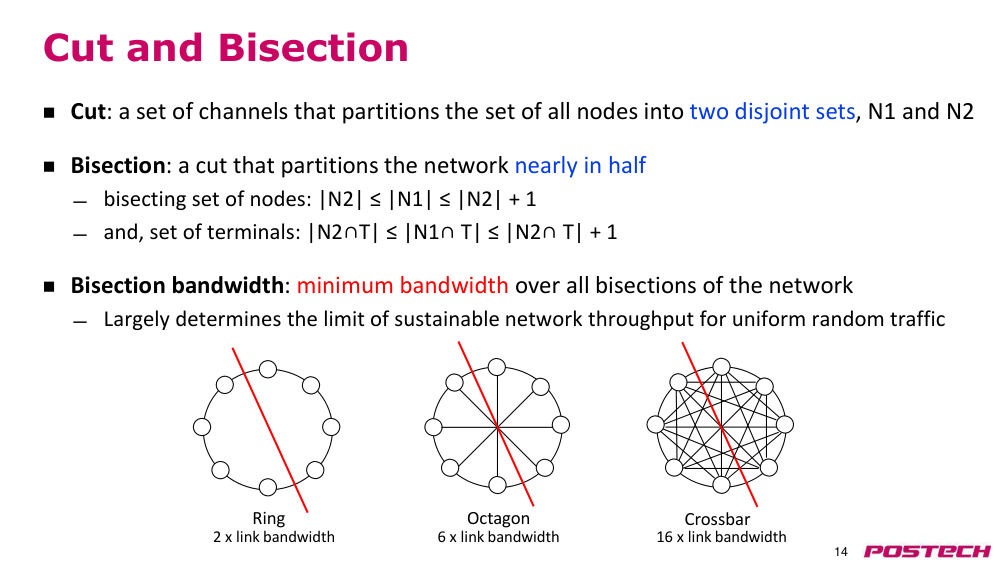
- cut(컷): 모든 노드 집합을 두 개의 서로소 집합 N1과 N2로 분할하는 channel(채널)의 집합
- bisection(이등분): 네트워크를 거의 반으로 나누는 컷
- bisection(이등분) 노드 집합: |N2| ≤ |N1| ≤ |N2| + 1
- bisection(이등분) terminal(단말기) 집합: |N2∩T| ≤ |N1∩T| ≤ |N2∩ T| + 1
- bisection bandwidth(이등분 대역폭): 네트워크의 모든 bisection(이등분)에 대한 최소 대역폭
- uniform random traffic(균일한 무작위 트래픽)에 대한 지속 가능한 네트워크 throughput(처리량)의 한계를 주로 결정함
- crossbar(크로스바): 2 x link(링크) 대역폭
- ring(링): 6 x link(링크) 대역폭
- octagon(옥타곤): 16 x link(링크) 대역폭
p.15토폴로지
p.16토폴로지 유형
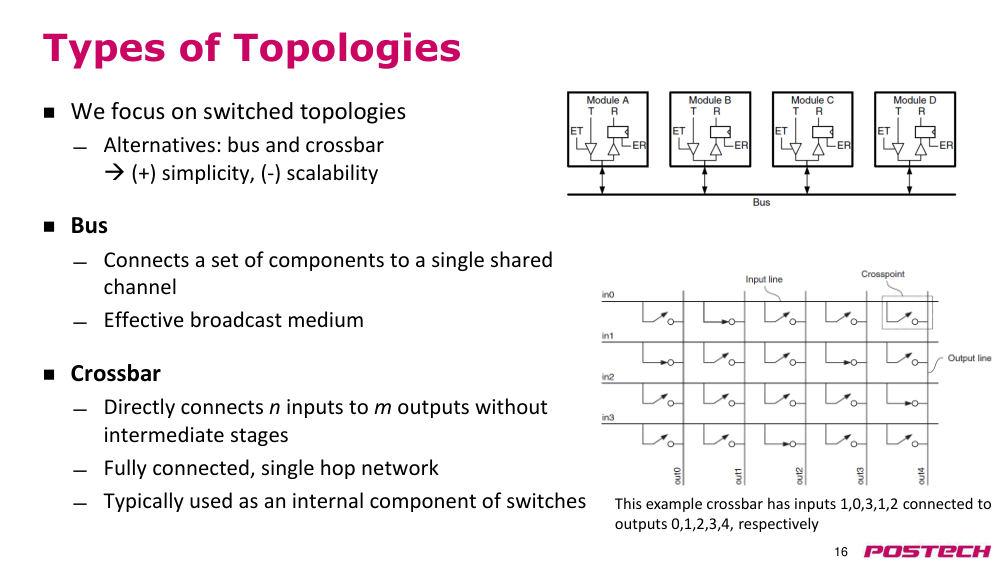
- 우리는 스위치형 토폴로지를 중심으로 다룬다
- 대안: 버스와 크로스바
- → (+) 단순성, (-) scalability(확장성)
- 버스: 여러 구성 요소를 단일 공유 channel(채널)에 연결
- 효과적인 브로드캐스트 매체
- 크로스바: 중간 단계 없이 n개의 입력을 m개의 출력에 직접 연결
- 완전 연결, 단일 호프 네트워크
- 일반적으로 스위치의 내부 구성 요소로 사용됨
- 이 예시 크로스바는 입력 1,0,3,1,2가 각각 출력 0,1,2,3,4에 연결됨
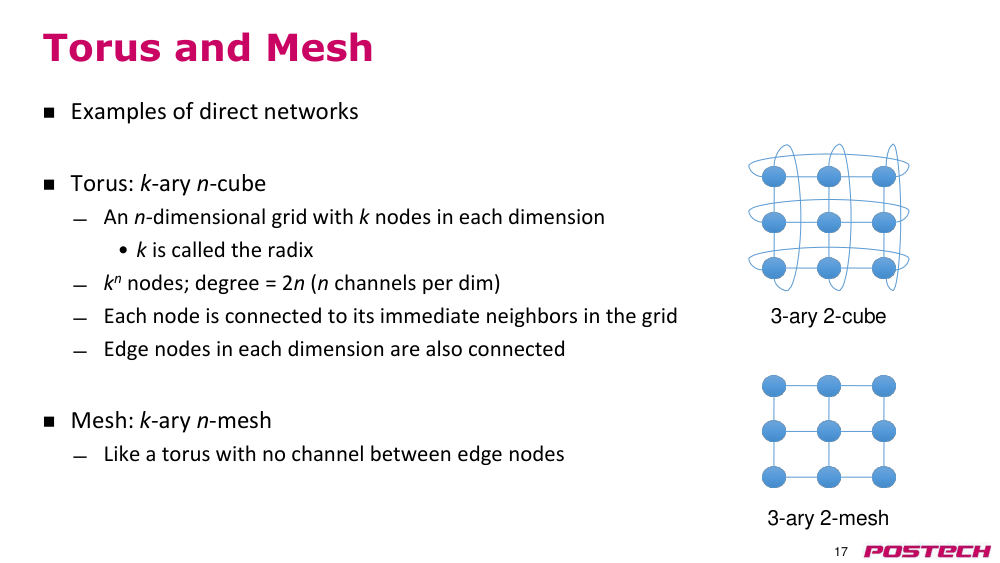
p.17torus(토러스)와 mesh(메시)
- 직접형 네트워크의 예
- torus(토러스): k-ary n-cube(k-ary n-큐브)
- 각 차원에 k개의 노드를 가진 n차원 격자
- • k는 radix(기수)라 불림
- kn개의 노드; 차수 = 2n (각 차원당 n개의 채널)
- 각 노드는 격자 내 인접한 노드들과 연결됨
- 각 차원의 가장자리 노드들 간에도 연결됨
- mesh(메시): k-ary n-mesh(k-ary n-메시)
- 가장자리 노드들 간의 channel(채널)이 없는 torus(토러스)와 유사
p.18torus(토러스)와 mesh(메시)
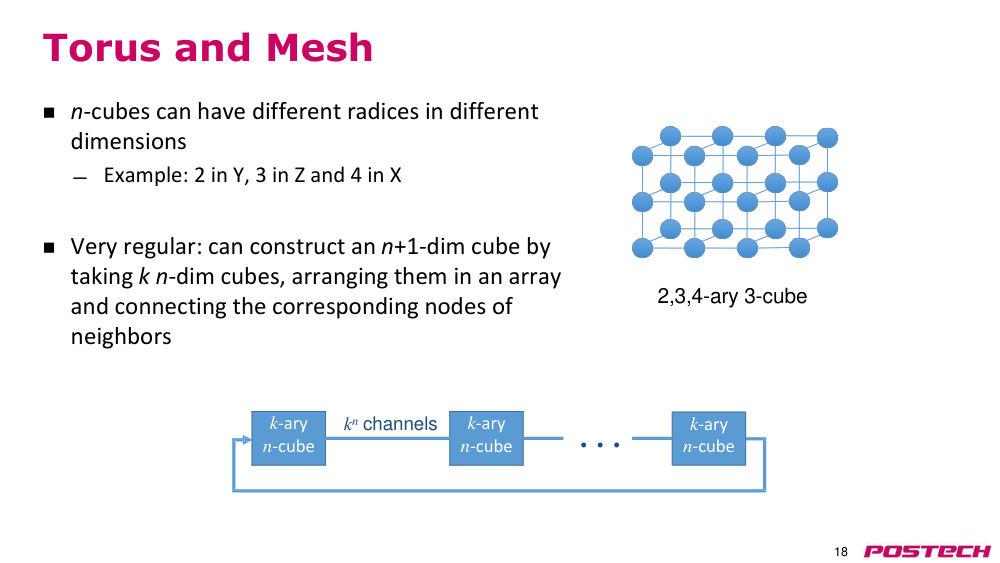
- n-큐브는 서로 다른 차원에서 서로 다른 radix(기수)를 가질 수 있음
- 예: Y차원에 2, Z차원에 3, X차원에 4
- 매우 규칙적: k개의 n-차원 큐브를 배열하여 (n+1)-차원 큐브를 구성할 수 있음
- 이웃하는 노드들의 대응 노드들을 연결함
- 2,3,4-ary 3-큐브
- k-ary n-cube(k-ary n-큐브)
- ...
- k-ary n-cube(k-ary n-큐브)
- kn개의 channel(채널)
- k-ary n-cube(k-ary n-큐브)
p.19torus(토러스)와 mesh(메시)
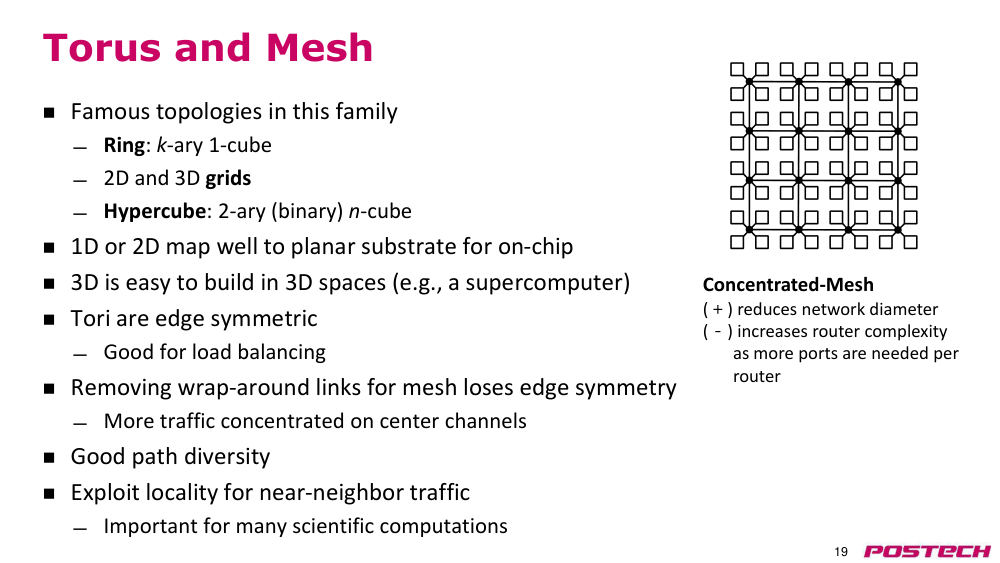
- 이 가족에 속한 유명한 토폴로지들:
- • 링: k-ary 1-큐브
- • 2D 및 3D 격자
- • hypercube(하이퍼큐브): 2-ary (이진) n-큐브
- • 1D 또는 2D는 on-chip(온칩) 평면 기판에 잘 매핑됨
- • 3D는 3D 공간(예: supercomputer(슈퍼컴퓨터))에서 구축하기 쉬움
- • torus(토러스)는 모서리 대칭성(edge symmetry)을 가짐
- • load balancing(로드 밸런싱)에 유리
- • mesh(메시)에서 래핑된 link(링크)를 제거하면 edge symmetry(모서리 대칭성) 상실
- • 중심 channel(채널)에 더 많은 트래픽 집중
- • 좋은 경로 다양성(path diversity) 제공
- • 근접 이웃 트래픽을 위한 locality(지역성) 활용
- • 많은 과학 계산에 중요
- • 집중형 메시 (Concentrated-Mesh)
- (+) 네트워크 지름(diameter) 감소
- (−) 라우터 복잡성 증가
- (라우터당 더 많은 포트 필요)
p.20folded torus(접힌 토러스) 구현
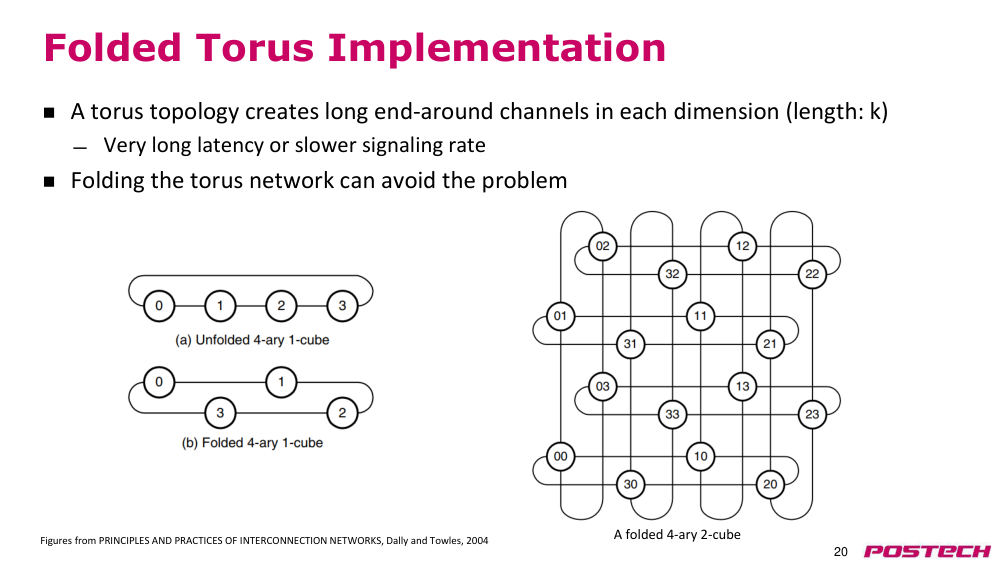
- • torus(토러스) 토폴로지는 각 차원에 긴 엔드어라운드 채널(길이: k)을 생성함
- • 매우 긴 latency(지연시간) 또는 느린 신호 전달 속도
- • torus(토러스) 네트워크를 접는(folding) 방식으로 문제 해결 가능
- • 그림 출처: PRINCIPLES AND PRACTICES OF INTERCONNECTION NETWORKS, Dally and Towles, 2004
- • 접힌 4-ary 2-큐브
p.21hierarchical ring(계층형 링)
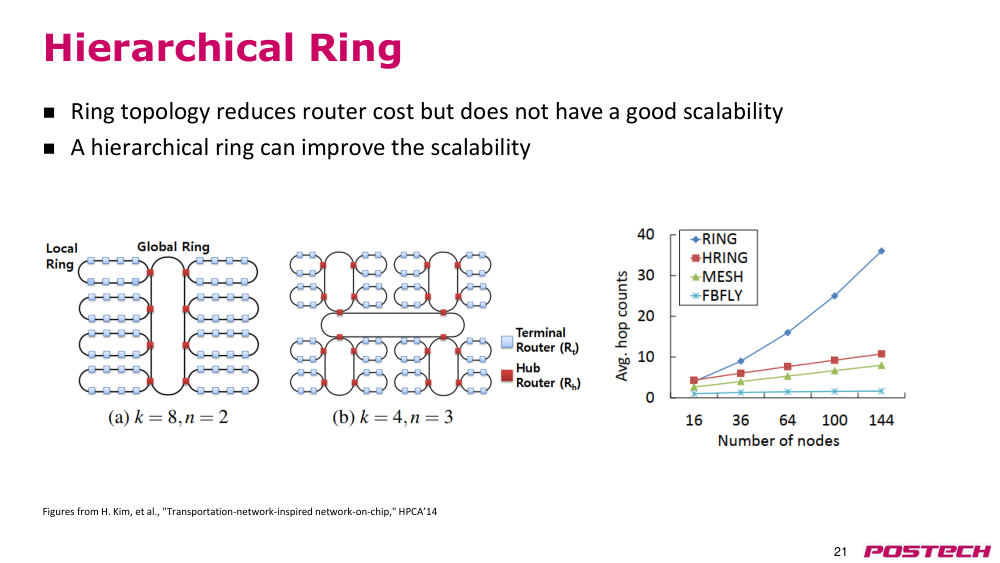
- • 링 토폴로지는 라우터 비용을 줄이지만 확장성(scalability)이 좋지 않음
- • hierarchical ring(계층형 링)은 scalability(확장성)을 개선할 수 있음
- • 그림 출처: H. Kim, et al., "Transportation-network-inspired network-on-chip," HPCA’14
p.22ring(링), mesh(메시), torus(토러스)의 실제 사례
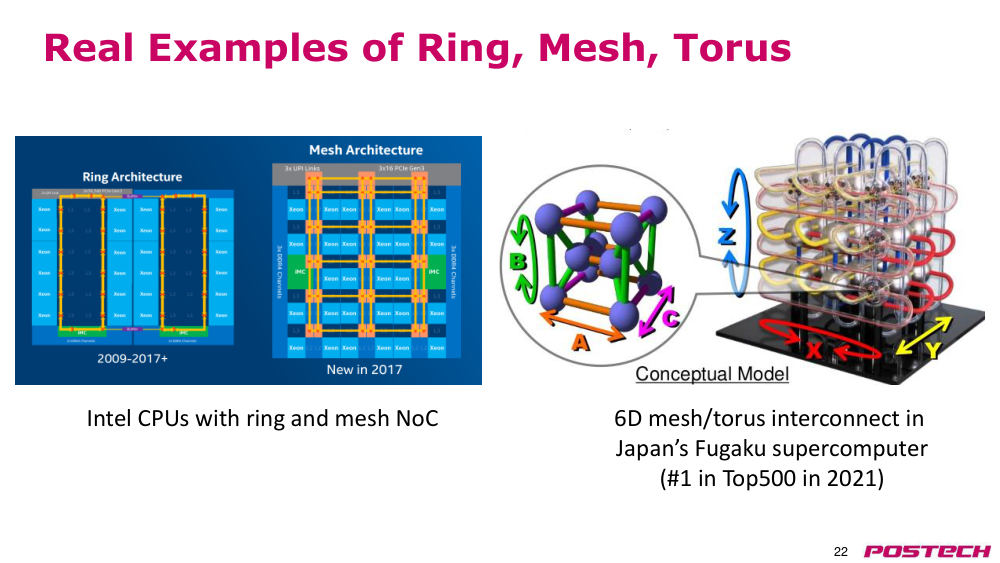
- • Intel CPU의 ring(링) 및 mesh(메시) NoC
- • Japan의 Fugaku supercomputer(후가쿠 슈퍼컴퓨터)의 6D mesh(메시)/torus(토러스) 상호연결
- • 2021년 Top500 1위
p.23tree(트리)
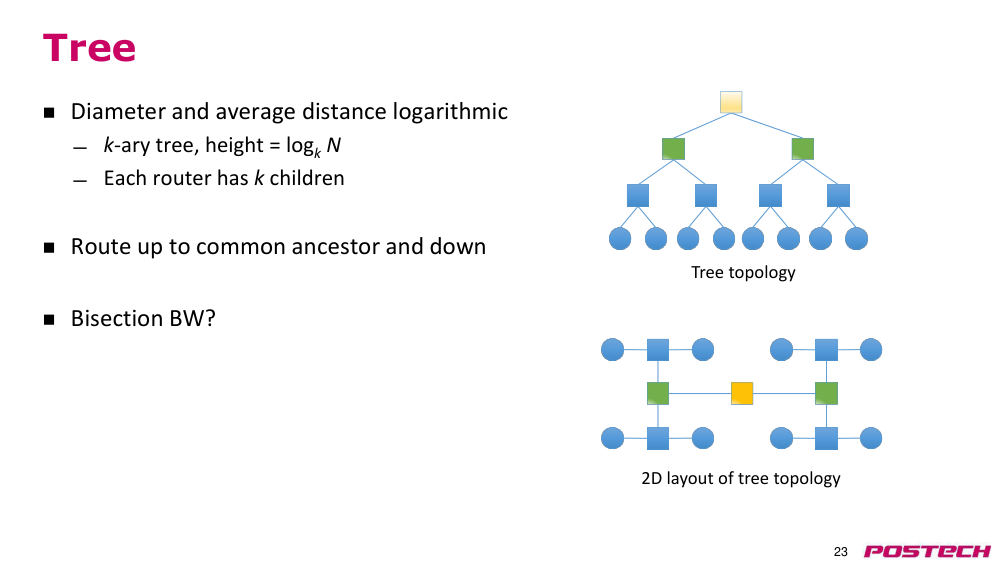
- • diameter(지름)과 평균 거리는 로그 단위
- • k-ary tree(트리), 높이 = logk N
- • 각 라우터는 k개의 자식을 가짐
- • 공통 조상까지 올라간 후 다시 내려감
- • 이등분 대역폭(bisection bandwidth)은?
- • 2D 레이아웃의 tree(트리) 토폴로지
- • tree(트리) 토폴로지
p.24fat tree(팻 트리)
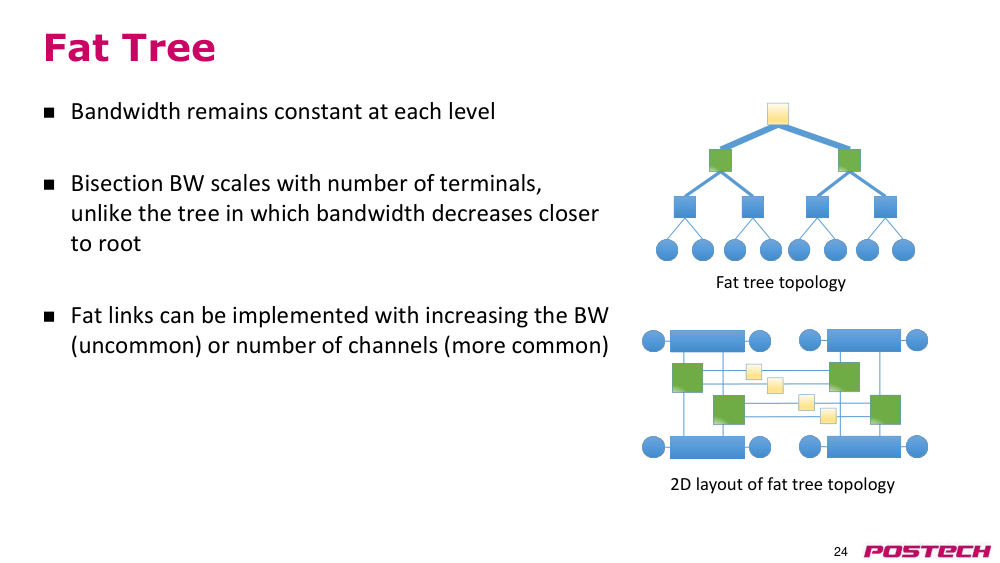
- • 각 레벨에서 대역폭이 일정 유지
- • tree(트리)와 달리 루트에 가까워질수록 대역폭이 감소하지 않음
- • fat link(팻 링크)는 대역폭 증가(희귀) 또는 channel(채널) 수 증가(더 흔함)로 구현 가능
- • 2D 레이아웃의 fat tree(팻 트리) 토폴로지
- • fat tree(팻 트리) 토폴로지
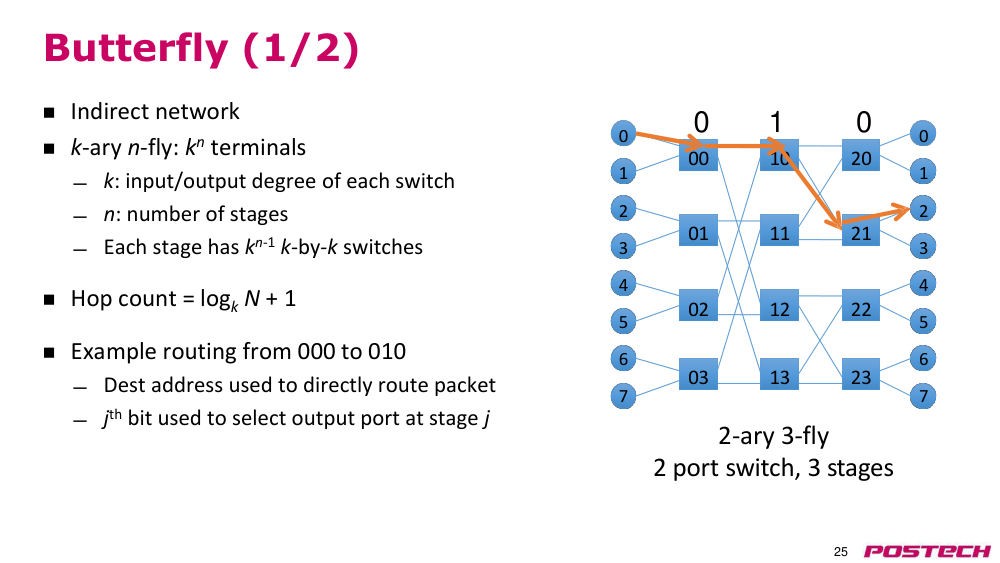
p.25Butterfly(버터플라이) (1/2)
- 간접형 네트워크
- k-ary n-fly(k-ary n-플라이): kn개의 terminal(단말기)
- k: 각 스위치의 입력/출력 degree(차수)
- n: 단계 수
- 각 단계에는 kn-1개의 k×k 스위치 존재
- 호프 수 = logk N + 1
- 예: 000에서 010으로의 라우팅
- 목적지 주소를 사용하여 packet(패킷)을 직접 라우팅
- j번째 비트를 사용하여 단계 j에서 출력 포트 선택
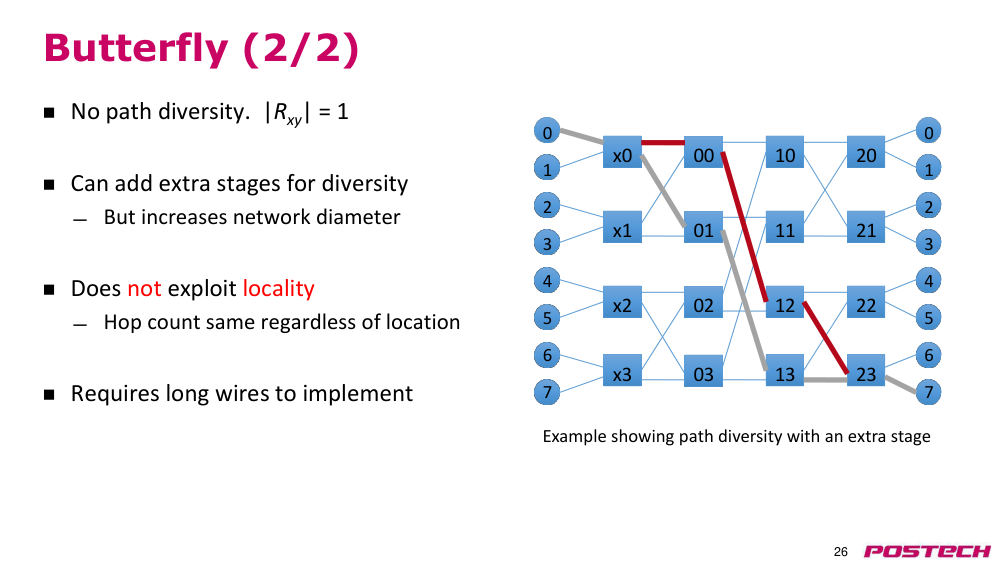
p.26Butterfly(버터플라이) (2/2)
- path diversity(경로 다양성) 없음. |Rxy| = 1
- 다양성을 위해 추가 단계를 추가할 수 있으나, 네트워크 diameter(지름) 증가
- locality(지역성)를 활용하지 않음
- 위치에 관계없이 호프 수 동일
- 구현을 위해 긴 배선 필요
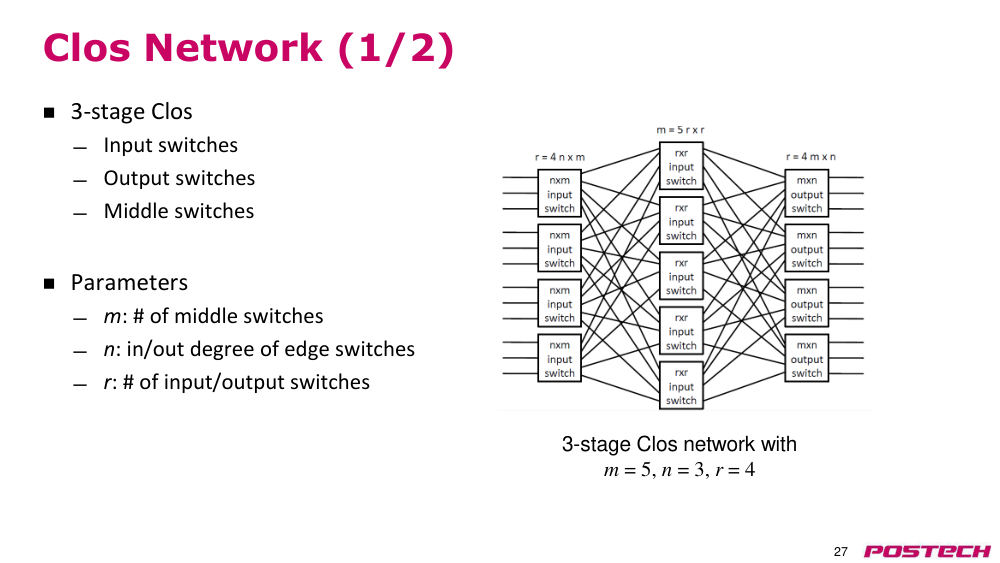
p.27Clos Network(클로스 네트워크) (1/2)
- 3-stage Clos Network(3단계 클로스 네트워크)
- 입력 스위치
- 출력 스위치
- 중간 스위치
- 파라미터
- m: 중간 스위치 수
- n: 가장자리 스위치의 입력/출력 도수
- r: 입력/출력 스위치 수
- 3-stage Clos Network(3단계 클로스 네트워크) (m = 5, n = 3, r = 4)
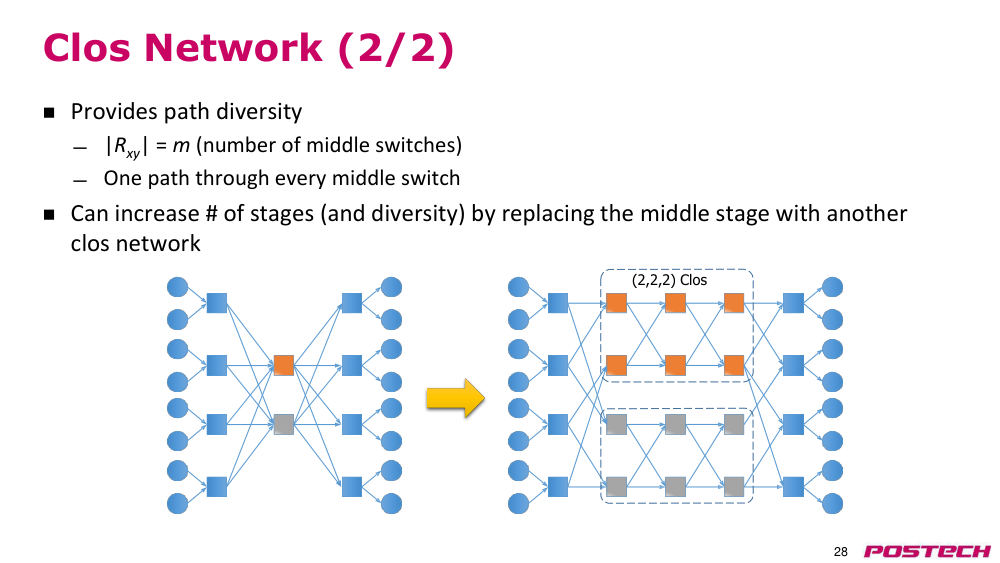
p.28Clos Network(클로스 네트워크) (2/2)
- path diversity(경로 다양성) 제공
- |Rxy| = m (중간 스위치 수)
- 모든 중간 스위치를 통과하는 경로 하나씩 존재
- 중간 단계를 다른 Clos Network(클로스 네트워크)로 대체함으로써 단계 수(및 다양성) 증가 가능
- (2,2,2) 클로스
p.29Folded Clos Network(접힌 클로스 네트워크)
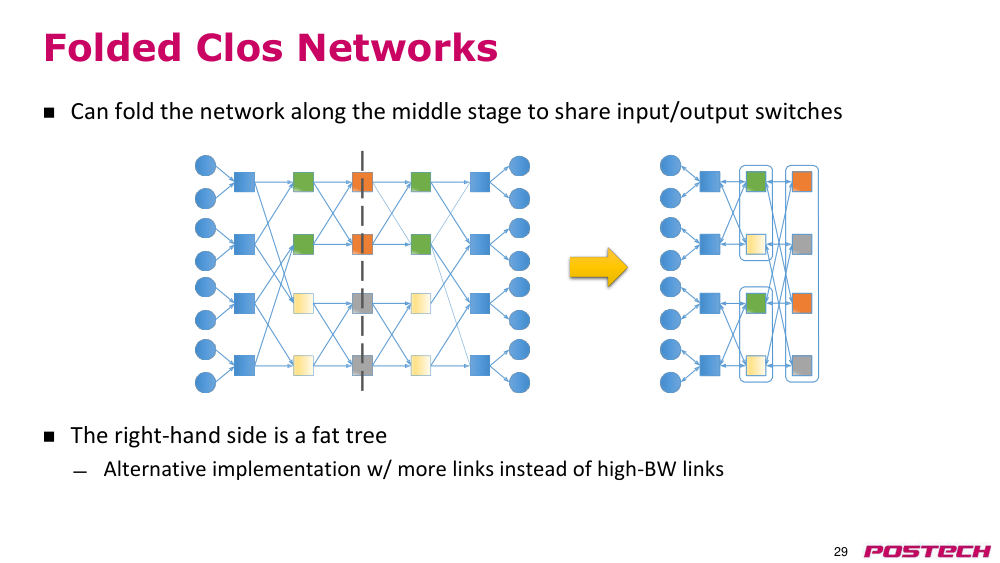
- 중간 단계를 따라 네트워크를 접어 입력/출력 스위치 공유 가능
- 오른쪽 부분은 fat tree(팻 트리)
- 고대역폭 link(링크) 대신 더 많은 링크를 사용하는 대안 구현
p.30그 외 토폴로지들…
- 문헌에서 다루어진 다양한 특성을 가진 기타 토폴로지 존재
- omega network(오메가 네트워크)
- benes network(베네스 네트워크)
- bitonic network(비토닉 네트워크)
- flattened butterfly(평탄화된 버터플라이)
- dragonfly(드래곤파이)
- cube-connected cycles(큐브 연결 사이클)
- HyperX(하이퍼엑스)
- …
- 그러나 이러한 일부는 일반 목적 하드웨어에서 사용되지 않는 특수 목적용인 경우가 많음
p.31irregular topology(비정형 토폴로지)
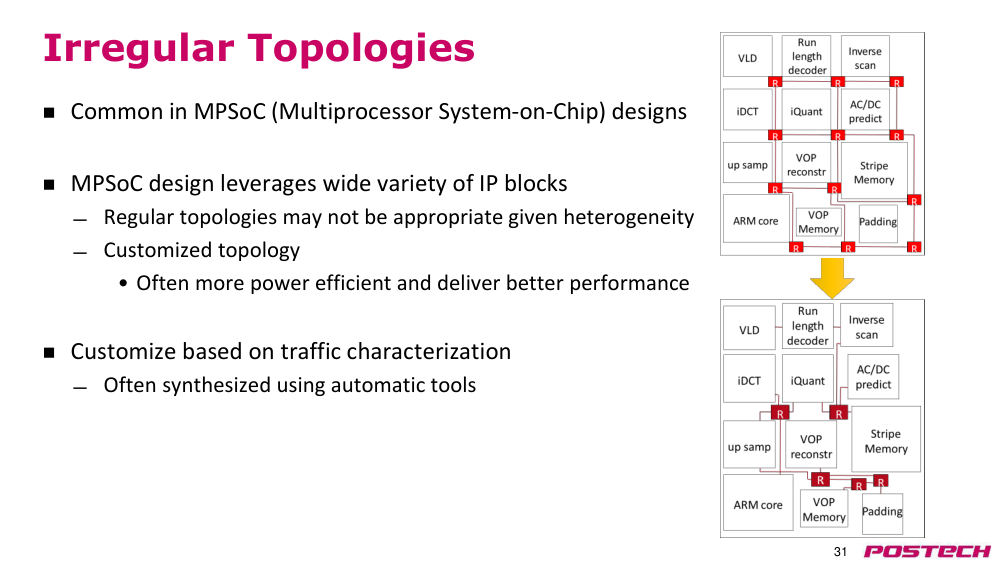
- MPSoC(다중프로세서 시스템온칩) 설계에서 흔함
- MPSoC 설계는 다양한 IP 블록을 활용함 — 이로 인해 이질성으로 인해 정형 토폴로지가 적절하지 않을 수 있음
- 맞춤형 토폴로지
- 일반적으로 더 높은 전력 효율성과 더 나은 성능을 제공함
- traffic characterization(트래픽 특성 분석)을 기반으로 맞춤형 설계함
- 일반적으로 automatic tool(자동 도구)를 사용하여 합성됨
p.32flow control(플로우 제어)
p.33flow control(플로우 제어) 개요
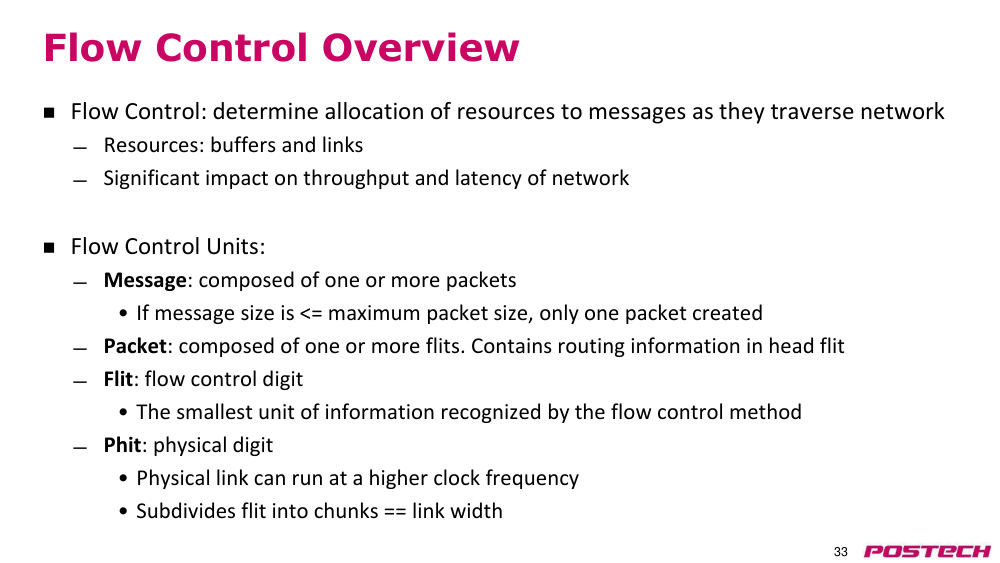
- flow control(플로우 제어): message(메시지)가 네트워크를 통과할 때 resource allocation(자원 할당)을 결정함
- 자원: buffer(버퍼)와 link(링크)
- 네트워크의 throughput(처리량)과 latency(지연시간)에 큰 영향을 미침
- flow control(플로우 제어) 단위:
- message(메시지): 하나 이상의 packet(패킷)으로 구성됨
- • message size(메시지 크기)가 maximum packet size(최대 packet(패킷) 크기) 이하이면 단일 패킷만 생성됨
- packet(패킷): 하나 이상의 flit(플릿)으로 구성됨. head flit(헤드 플릿)에 routing information(라우팅 정보) 포함됨
- flit(플릿): flow control(플로우 제어) 단위
- • flow control(플로우 제어) 방법이 인식하는 정보의 최소 단위
- phit(피트): physical digit(물리 디지트)
- • 물리적 link(링크)는 더 높은 클럭 주파수로 동작할 수 있음
- • flit(플릿)을 조각들로 나누어 link width(링크 폭)과 동일하게 함
p.34flow control(플로우 제어) 개요
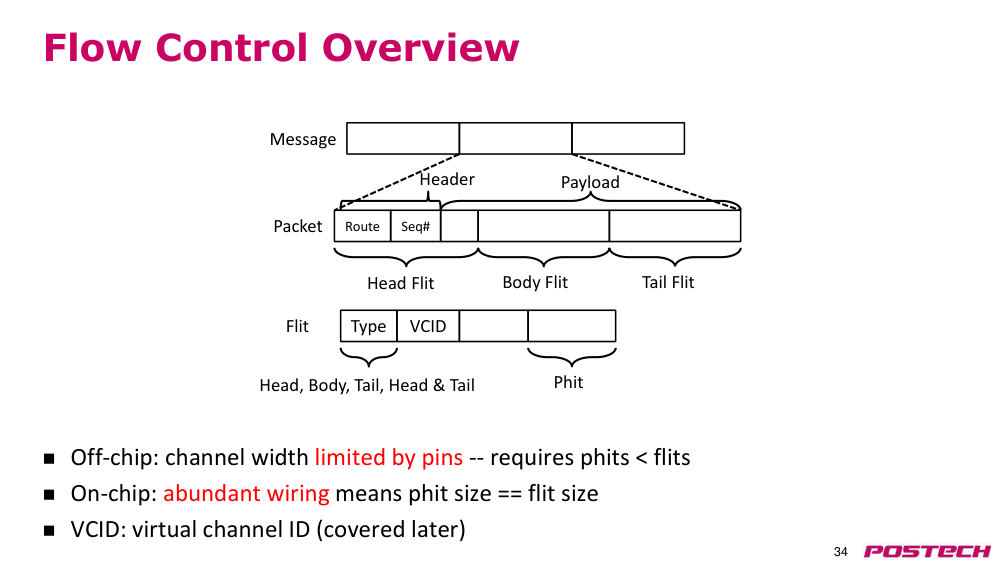
- off-chip(오프칩): 핀의 제한으로 인해 channel(채널) 폭이 제한됨 — phit(피트) < flit(플릿)이 필요함
- on-chip(온칩): abundant wiring(풍부한 배선)으로 인해 phit(피트) 크기 == flit(플릿) 크기
- VCID: virtual channel ID(가상 채널 ID) (나중에 다룸)
- 경로
- 순서번호
- 유형
- VCID
- packet(패킷)
- flit(플릿)
- 헤드, 바디, 테일, 헤드 및 테일
- phit(피트)
- 헤더
- 페이로드
- head flit(헤드 플릿)
- body flit(바디 플릿)
- tail flit(테일 플릿)
- message(메시지)
p.35packet(패킷) 예시
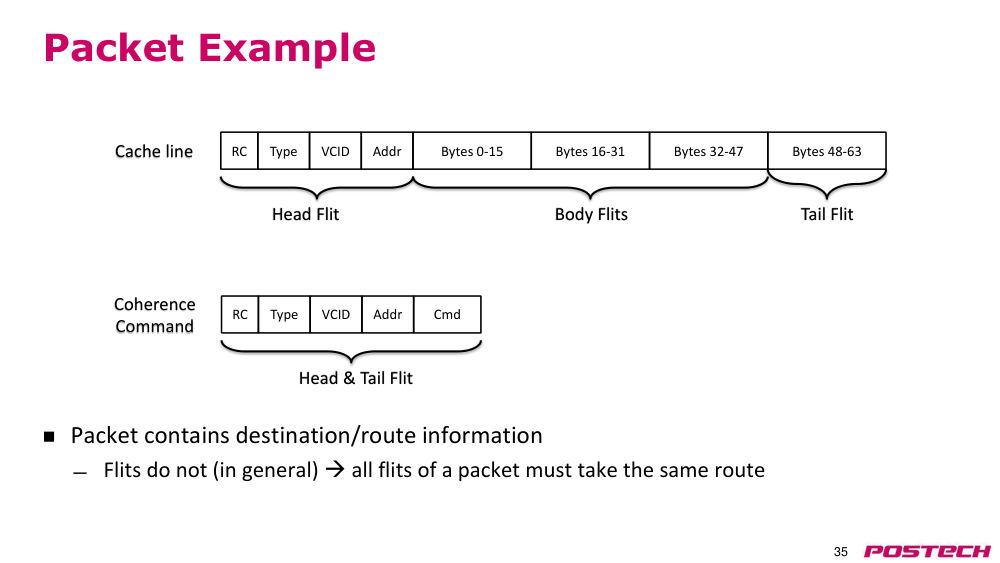
- packet(패킷)은 목적지/경로 정보를 포함함
- flit(플릿)은 일반적으로 포함하지 않음 — packet(패킷)의 모든 플릿은 동일한 경로를 따라야 함
- RC
- cache line(캐시 라인)
- 유형
- VCID
- 주소
- head flit(헤드 플릿)
- 바이트 0-15
- 바이트 16-31
- 바이트 32-47
- 바이트 48-63
- body flit(바디 플릿)
- tail flit(테일 플릿)
- RC
- coherence(코히어런스)
- command(명령)
- 유형
- VCID
- 주소
- head & tail flit(헤드 앤 테일 플릿)
- command(명령)
p.36스위칭
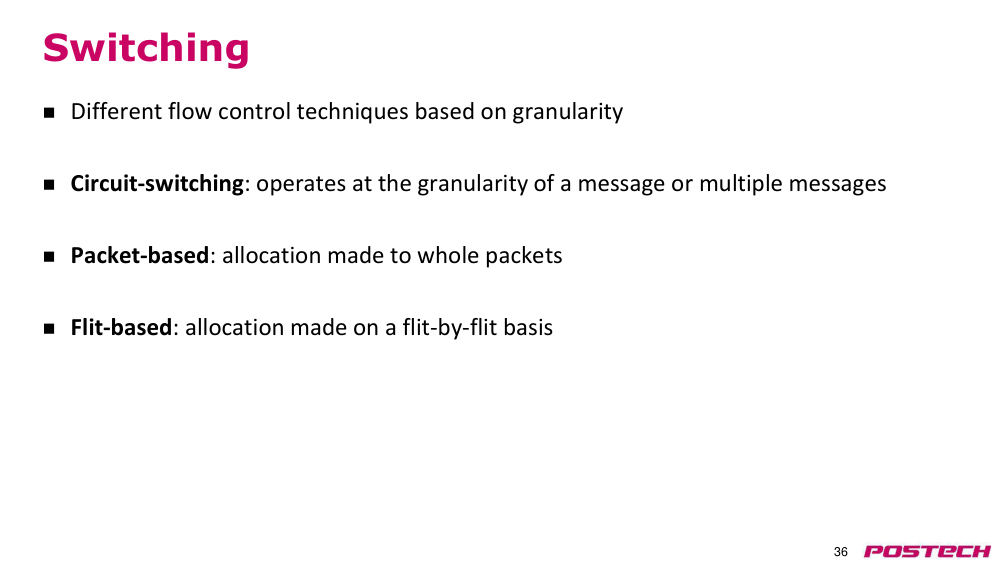
- 다양한 흐름 제어 기법은 세분화 수준에 따라 다름
- circuit-switching(회로 스위칭): message(메시지) 또는 여러 message(메시지) 단위로 작동함
- packet(패킷) 기반: 전체 패킷에 대해 할당함
- flit(플릿) 기반: 플릿 단위로 할당함
p.37message(메시지) 기반 flow control(플로우 제어)
- 가장 큰 granularity(세분화 수준)
- circuit-switching(회로 스위칭)
- 여러 홉에 걸쳐 자원을 사전 할당
- • 소스에서 목적지까지
- • 자원 = 링크 (버퍼는 필요 없음)
- • 예: 고정선 전화 서비스
- 네트워크에 probe(프로브)를 보내어 자원을 예약
- probe(프로브)가 회로를 설정한 후 message(메시지)는 각 홉에서 라우팅이나 할당이 필요 없음
- 대량의 data transfer(데이터 전송)에 적합
- 전송이 완료될 때까지 예약된 자원을 다른 message(메시지)가 사용할 수 없음
- 회로의 설정 및 유지 시간으로 인해 throughput(처리량)이 저하될 수 있음
- 설정이 완료될 때까지 link(링크)가 비활성 상태
p.38Time-Space diagram(시간-공간 다이어그램): circuit-switching(회로 스위칭)
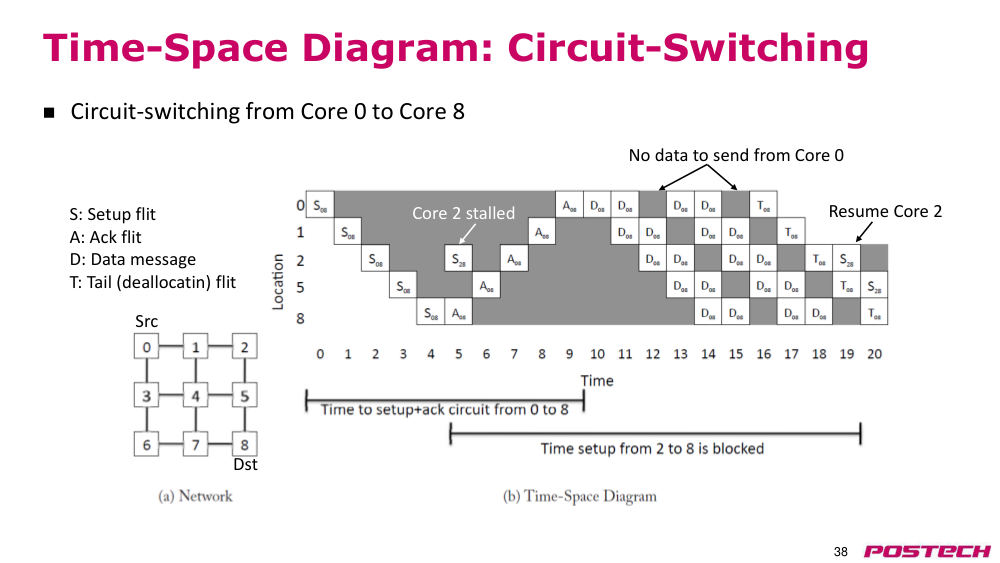
- 코어 0에서 코어 8로의 circuit-switching(회로 스위칭)
- S: setup flit(설정 플릿)
- A: ack flit(확인 플릿)
- D: 데이터 message(메시지)
- T: tail deallocation flit(테일 할당 해제 플릿)
- 코어 2 정지
- 코어 2 resume(재개)
- 코어 0에서 전송할 데이터 없음
- Src
- Dst
p.39packet(패킷) 기반 flow control(플로우 제어)
- message(메시지)를 packet(패킷)으로 분할
- link(링크)에서 packet(패킷)을 interleave(인터리브)함
- 더 나은 자원 활용
- 비행 중인 packet(패킷)을 저장하기 위해 각 노드의 buffer(버퍼)가 필요
- packet(패킷) 기반 기법의 두 가지 유형
- store & forward(스토어 앤 포워드)
- virtual Cut-Through(가상 컷스루)
p.40Store & Forward(스토어 앤 포워드) (S&F)
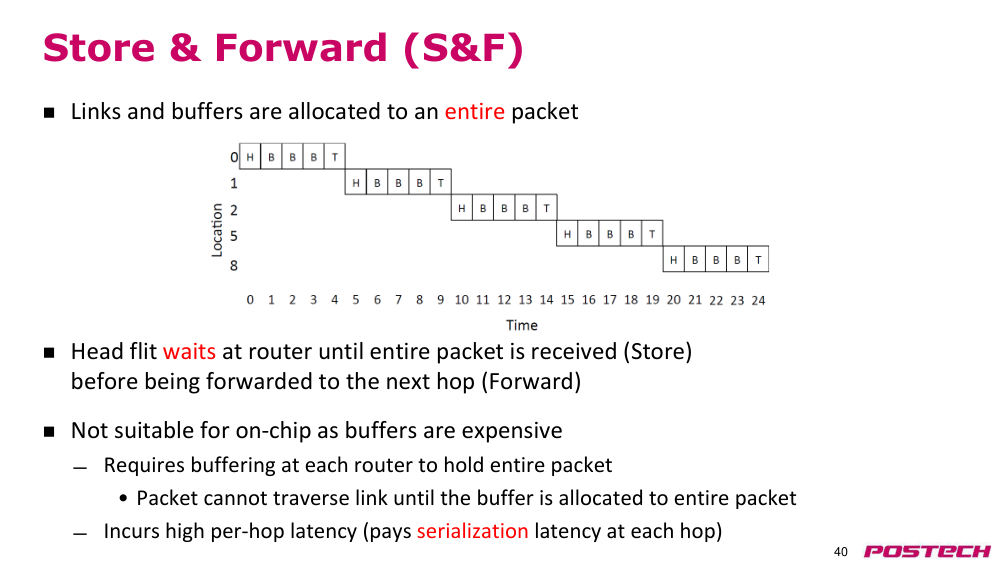
- link(링크)와 buffer(버퍼)가 전체 packet(패킷)에 대해 할당됨
- head flit(헤드 플릿)은 전체 packet(패킷)이 수신될 때까지 라우터에서 대기 (스토어)
- 그 후 다음 홉으로 포워딩 (포워드)
- buffer(버퍼)가 비싸기 때문에 on-chip(온칩)에는 적합하지 않음
- 각 라우터에서 전체 packet(패킷)을 보관하기 위한 buffer(버퍼)가 필요
- buffer(버퍼)가 전체 packet(패킷)에 대해 할당될 때까지 패킷이 link(링크)를 통과할 수 없음
- 각 홉에서 시리얼화 지연을 지불하므로 높은 홉당 지연 발생
p.41Virtual Cut-Through(가상 컷스루) (VCT)
- link(링크)와 buffer(버퍼)가 전체 packet(패킷)에 대해 할당됨
- 현재 라우터에서 tail flit(테일 플릿)이 수신되기 전에도 flit(플릿)이 다음 홉으로 진행될 수 있음
- 다음 라우터가 전체 packet(패킷)을 저장할 수 있는 충분한 buffer(버퍼) 공간을 가질 경우에 한함
- store & forward(스토어 앤 포워드)에 비해 지연 시간을 크게 감소
- 여전히 큰 buffer(버퍼)가 필요함
- on-chip(온칩)에는 부적합
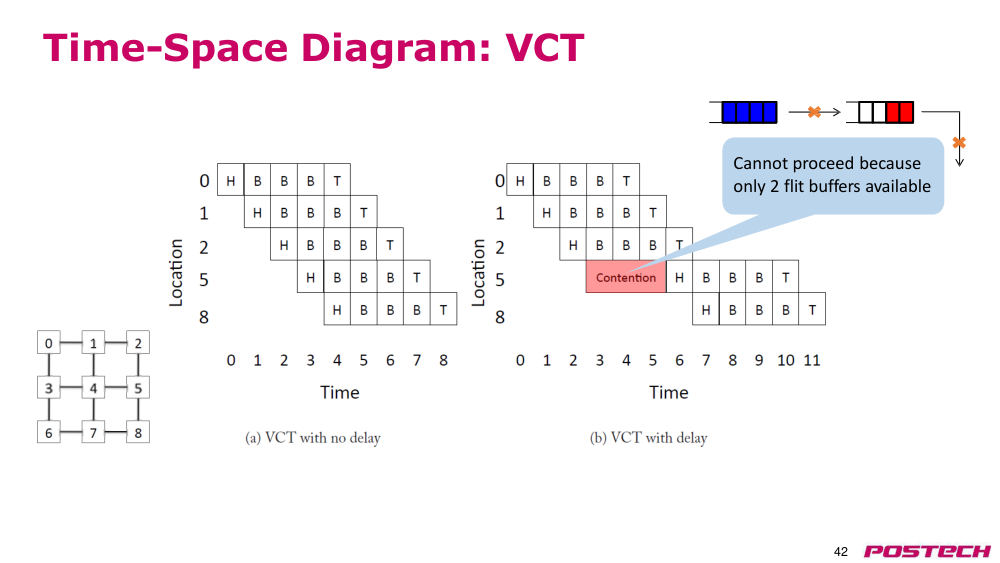
p.42Time-Space diagram(시간-공간 다이어그램): VCT
- buffer(버퍼) 공간 부족으로 인해 진행 불가
- 현재 2개의 flit(플릿) buffer(버퍼)만 사용 가능
p.43flit(플릿) 수준의 flow control(플로우 제어)
- flit(플릿)이 다음 라우터로 진행할 수 있는 조건은 해당 플릿을 위한 buffer(버퍼) 공간이 확보되었을 때이다.
- 스토어 앤 포워드(S&F) 및 가상 컷스루(VCT)보다 flit(플릿) 단위로 buffer(버퍼)를 할당함으로써 개선된다.
- 라우터의 좁은 면적/전력 제약을 충족하는 데 도움이 된다.
- 이 방식을 Wormhole Flow Control(웜홀 플로우 제어)이라고 한다.
- (+) 더 효율적인 buffer(버퍼) 활용도 (온칩 환경에 적합)
- (+) 낮은 latency(지연시간)
- (-) 낮은 link(링크) 활용도: head flit(헤드 플릿)이 차단되면 packet length(패킷 길이)에 걸쳐 있는 모든 링크가 비활성 상태가 된다.
- 다른 packet(패킷)에 의해 재할당될 수 없다.
- head-of-line(HOL) blocking(헤드 오브 라인 차단)에 취약하다.
p.44웜홀 예시 (HOL)
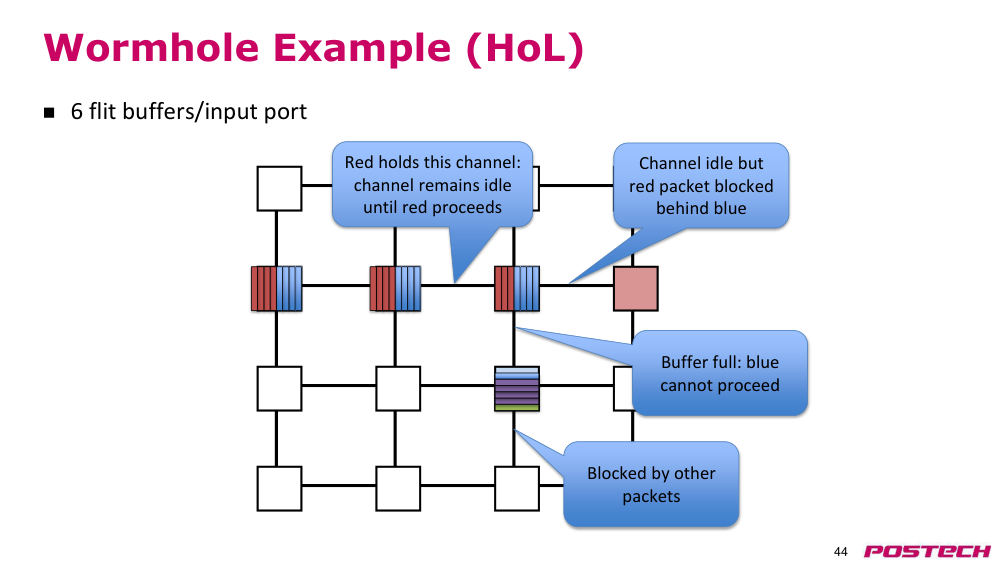
- 입력 포트당 6개의 flit(플릿) buffer(버퍼)
- 다른 packet(패킷)에 의해 차단됨
- channel(채널)은 비어 있지만 빨간 packet(패킷)은 파란 패킷 뒤에 차단됨
- buffer(버퍼)가 가득 차서 파란 packet(패킷)은 진행할 수 없음
- 빨간 packet(패킷)이 이 channel(채널)을 점유하고 있으므로, 빨간 패킷이 진행하기 전까지 채널은 비활성 상태로 유지된다.
p.45Time-Space diagram(시간-공간 다이어그램): 웜홀
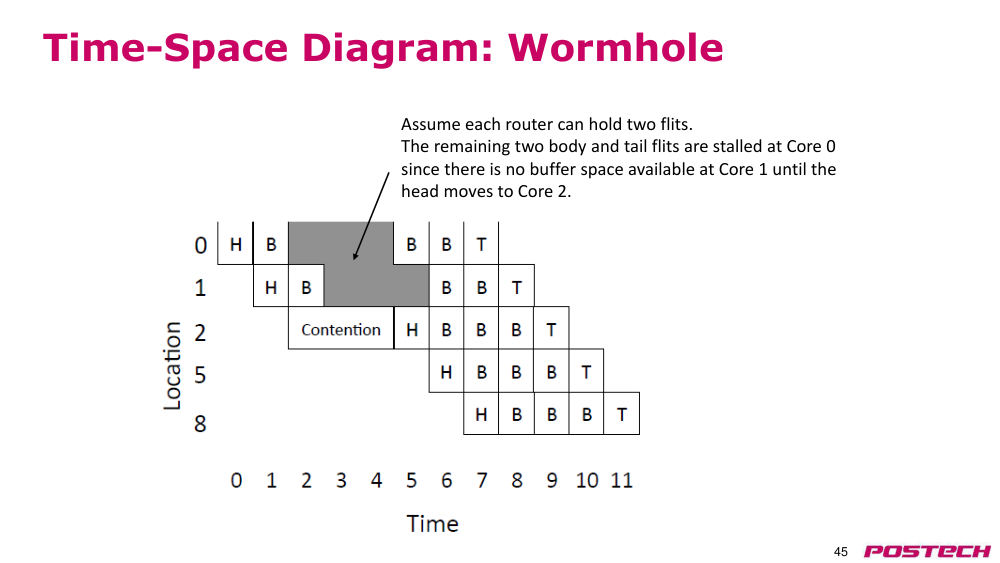
- 각 라우터는 두 개의 flit(플릿)을 저장할 수 있다고 가정한다.
- head flit(헤드 플릿)이 코어 2로 이동할 때까지 코어 1에 buffer(버퍼) 공간이 없기 때문에, 나머지 두 개의 바디 및 tail flit(테일 플릿)은 코어 0에서 stalled(정지된)다.
p.46가상 channel(채널) flow control(플로우 제어)
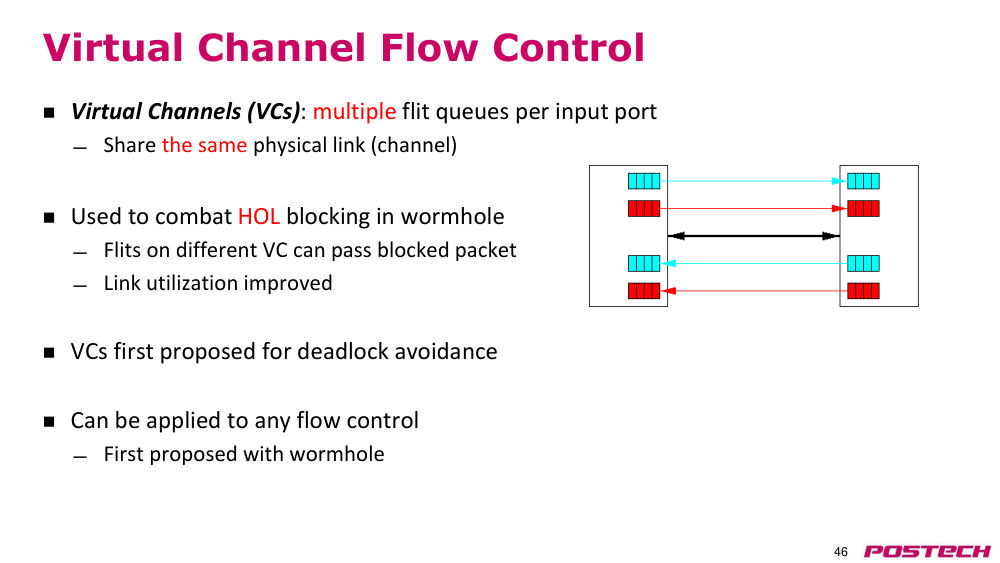
- 가상 채널(VC): 입력 포트당 여러 개의 flit(플릿) 큐
- 동일한 물리적 링크(채널)를 공유한다.
- 웜홀에서의 헤드 오브 라인(HOL) 차단을 완화하기 위해 사용된다.
- 다른 VC에 있는 flit(플릿)은 차단된 packet(패킷)을 통과시킬 수 있다.
- link(링크) 활용도가 향상된다.
- VC는 처음에 deadlock avoidance(교착 상태 회피)를 위해 제안되었다.
- 모든 flow control(플로우 제어)에 적용 가능하다.
- 처음에는 웜홀과 함께 제안되었다.
p.47가상 channel(채널) 예시
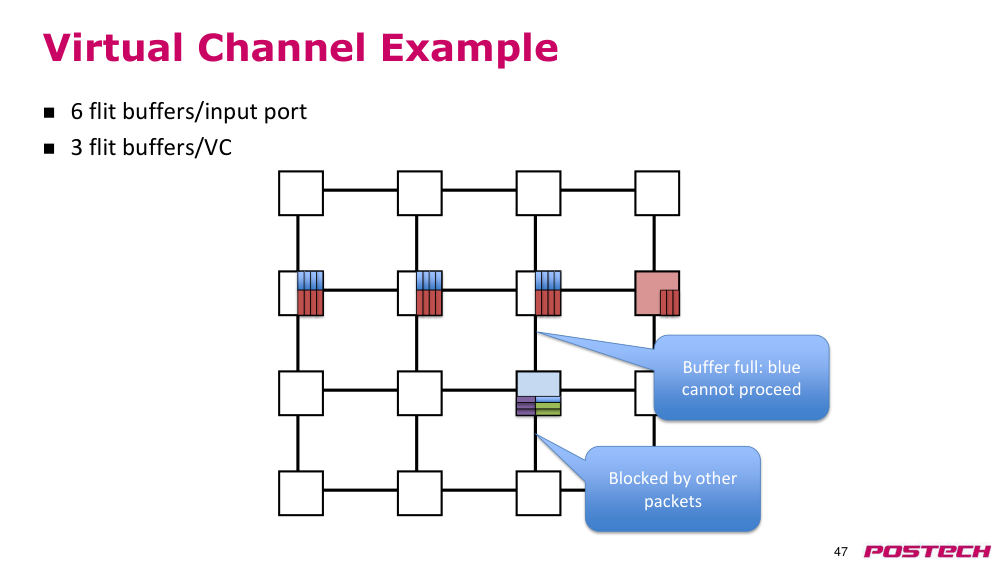
- 입력 포트당 6개의 flit(플릿) buffer(버퍼)
- 가상 channel(채널)당 3개의 flit(플릿) buffer(버퍼)
- 다른 packet(패킷)에 의해 차단됨
- buffer(버퍼)가 가득 차서 파란 packet(패킷)은 진행할 수 없음
p.48기법 요약
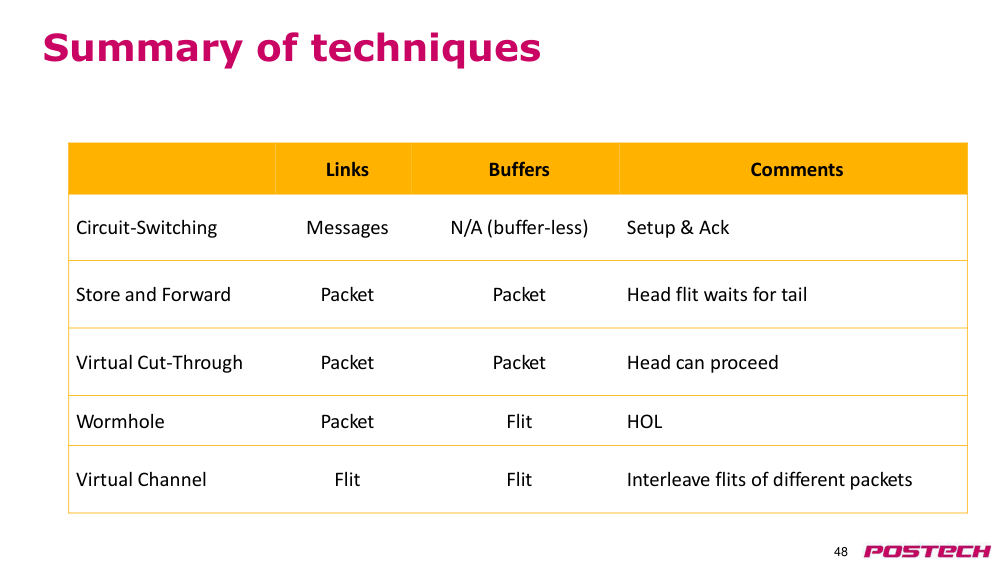
- link(링크)
- buffer(버퍼)
- 비고
- circuit-switching(회로 스위칭)
- message(메시지)
- N/A (버퍼 없음)
- 설정 및 확인
- store & forward(스토어 앤 포워드)
- packet(패킷)
- packet(패킷)
- head flit(헤드 플릿)은 테일이 도착할 때까지 대기
- virtual Cut-Through(가상 컷스루)
- packet(패킷)
- packet(패킷)
- 헤드는 진행 가능
- Wormhole(웜홀)
- packet(패킷)
- flit(플릿)
- HOL
- virtual channel(가상 채널)
- flit(플릿)
- flit(플릿)
- 다른 packet(패킷)의 flit(플릿)을 교차 배치
p.49buffer(버퍼) 백프레셔
- buffer(버퍼) 오버플로우를 방지하기 위한 메커니즘이 필요하다.
- packet(패킷) 드롭을 방지함(lossless network(무손실 네트워크))
- 상류 라우터는 하류 라우터의 buffer(버퍼) 가용성을 알아야 한다.
- flow control(플로우 제어)가 달성하는 throughput(처리량)에 큰 영향을 미친다.
- 두 가지 일반적인 메커니즘:
- 크레딧
- 온오프(여기서는 다루지 않음)
p.50크레딧 기반 flow control(플로우 제어)
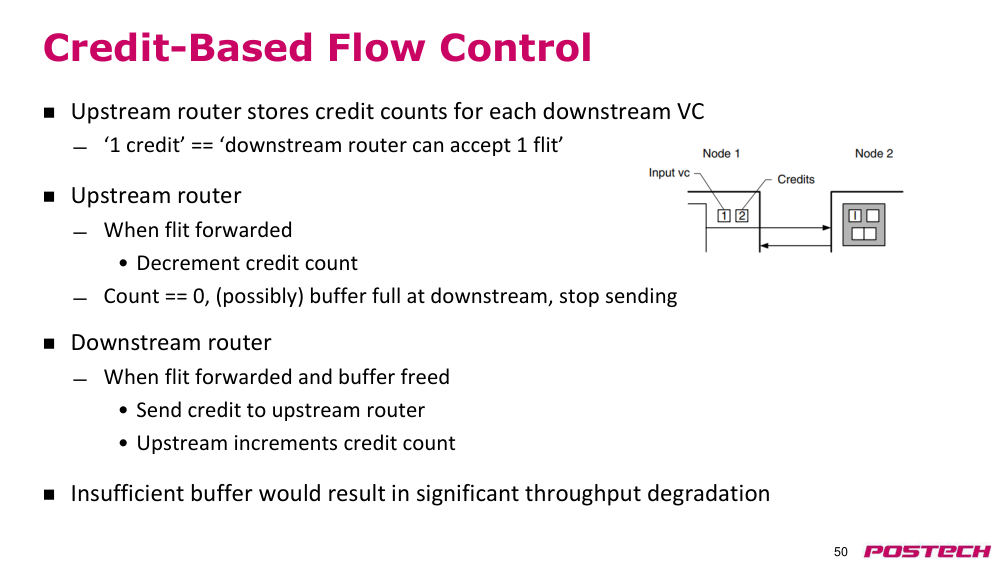
- 상류 라우터는 각 하류 VC에 대한 크레딧 카운트를 저장한다.
- '1 크레딧' == '하류 라우터가 1 flit(플릿)을 수락할 수 있다.'
- 상류 라우터:
- flit(플릿) 전달 시
- • 크레딧 카운트 감소
- • 카운트 == 0, 하류에서 buffer(버퍼)가 가득 찰 가능성이 있으므로 전송 중단
- 하류 라우터:
- flit(플릿) 전달 및 buffer(버퍼) 해제 시
- • 상류 라우터로 크레딧 전송
- • 상류 라우터는 크레딧 카운트 증가
- buffer(버퍼)가 충분하지 않으면 throughput(처리량)이 크게 저하된다.
p.51크레딧 기반 flow control(플로우 제어) 예시
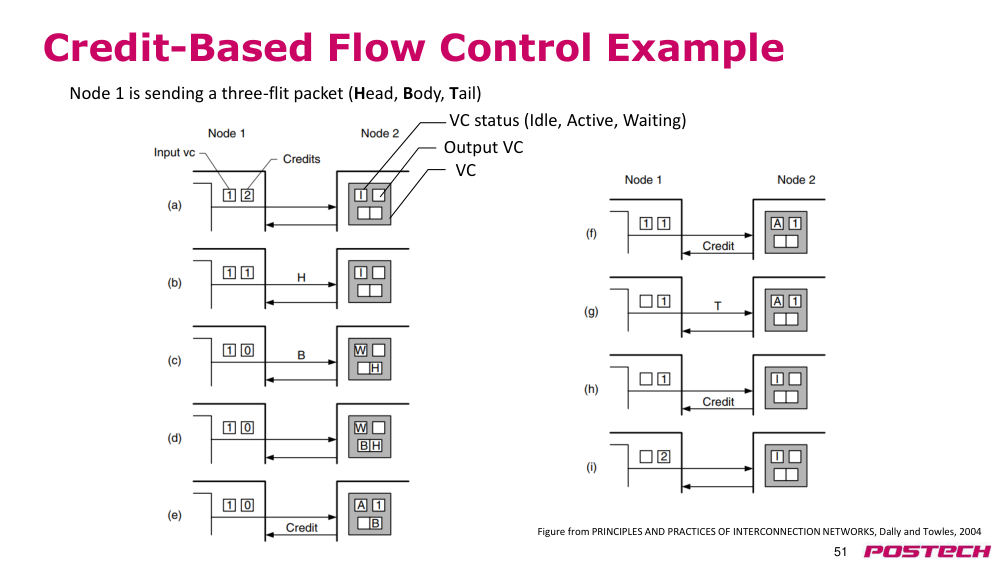
- PRINCIPLES AND PRACTICES OF INTERCONNECTION NETWORKS, Dally and Towles, 2004에서 인용한 그림
- 노드 1이 세 flit(플릿) 패킷(헤드, 바디, 테일)을 전송 중이다.
- VC
- 출력 VC
- VC status(유휴, 활성, 대기)
p.52크레딧 타임라인
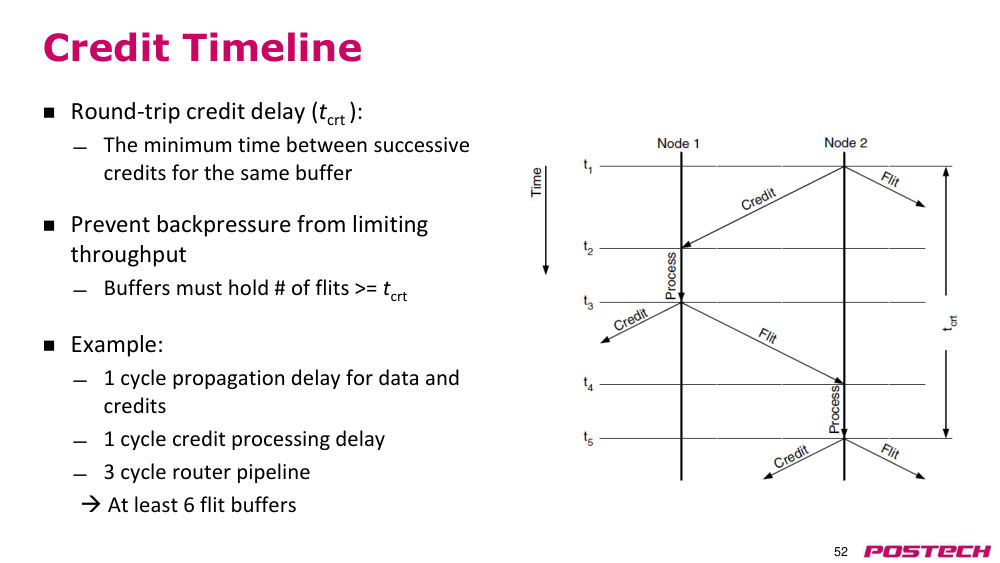
- 라운드트립 크레딧 지연(tcrt):
- 동일한 buffer(버퍼)에 대해 연속적인 크레딧 사이의 최소 시간
- 백프레셔가 throughput(처리량)을 제한하지 않도록 한다.
- buffer(버퍼)는 tcrt 이상의 flit(플릿)을 보유해야 한다.
- 예시:
- 데이터 및 크레딧의 전파 지연: 1 사이클
- 크레딧 처리 지연: 1 사이클
- 라우터 파이프라인: 3 사이클
- → 최소 6 flit(플릿) buffer(버퍼) 필요
p.53질문?
- 더 깊이 이해하고 싶다면 다음 책들을 참고하세요.
- 인터커넥션 네트워크에 대해 더 배우고 싶다면 이 책들을 참조하세요