이 자료를 쓰는 강의: 28 GPU Architecture (SIMT, warp, CUDA programming model, shared memory) · 29 GPU Architecture (2): shared memory tiling, bank conflict, coalescing
Lec20 - GPU Architecture
한국어판 강의자료 · 82쪽
p.1CSED503 고급 컴퓨터 구조 – 강의 20
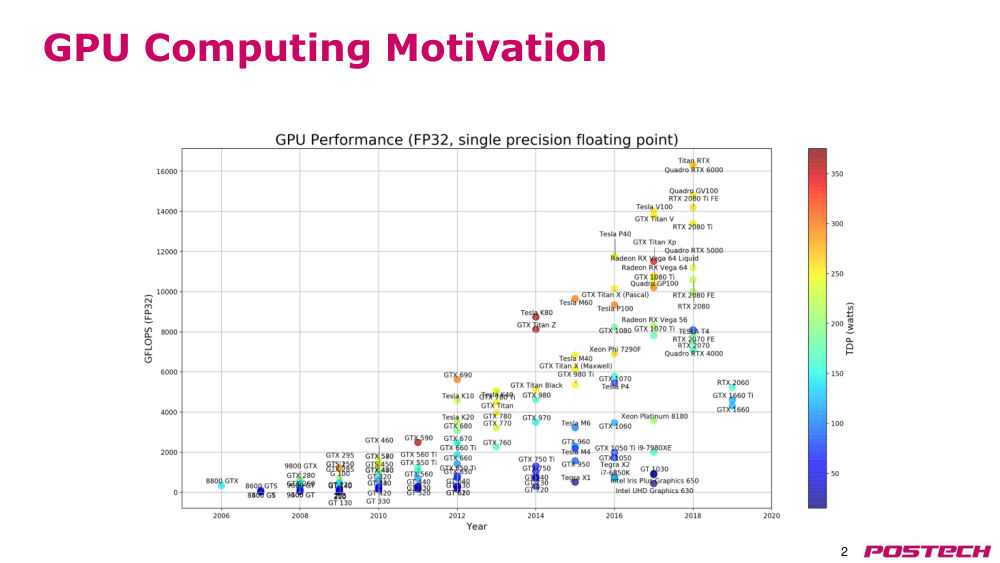
p.2GPU 컴퓨팅 동기
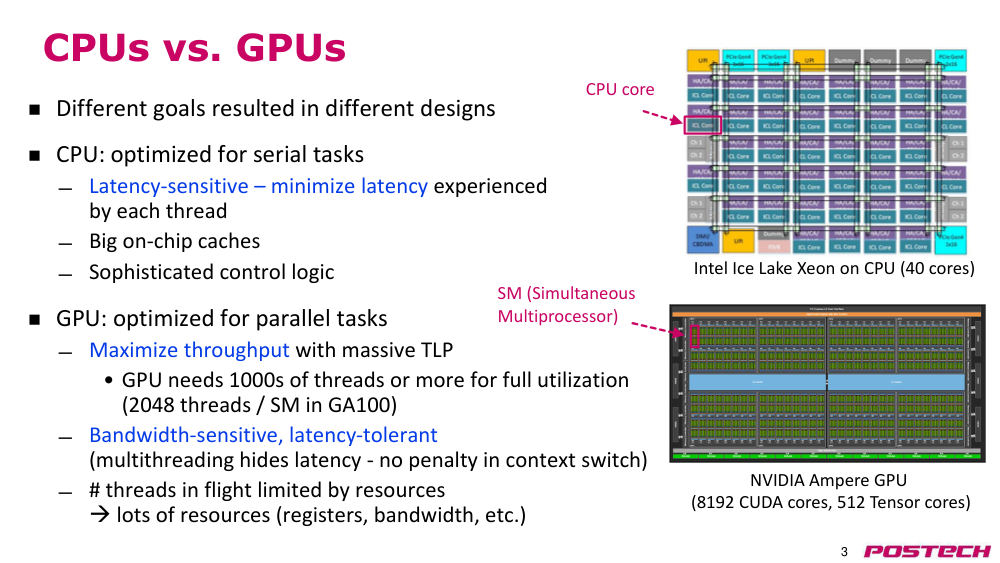
p.3CPU vs. GPU
- 다른 목적이 다른 설계를 초래함
- CPU: 시리얼 작업 최적화
- • latency(지연 시간) 민감 – 각 thread(스레드)가 경험하는 지연 시간 최소화
- • on-chip cache(온칩 캐시) 크기가 큼
- • 정교한 control logic(제어 논리)
- GPU: 병렬 작업 최적화
- • 막대한 TLP을 통해 throughput(처리량) 최대화
- • GPU는 전체 활용을 위해 1,000개 이상의 thread(스레드) 필요 (GA100에서 2,048 thread(스레드)/SM)
- • bandwidth(대역폭) 민감, latency(지연 시간)을 견딜 수 있음 (다중 스레딩이 지연 시간을 숨김 – context switch(컨텍스트 전환)에 비용 없음)
- • 비행 중 thread(스레드) 수는 자원에 의해 제한됨
- → 많은 자원 필요 (레지스터, bandwidth(대역폭) 등)
- Intel Ice Lake Xeon CPU (40 cores)
- NVIDIA Ampere GPU (8,192 CUDA cores, 512 Tensor cores)
- SM (동시 다중처리장치)
- CPU 코어
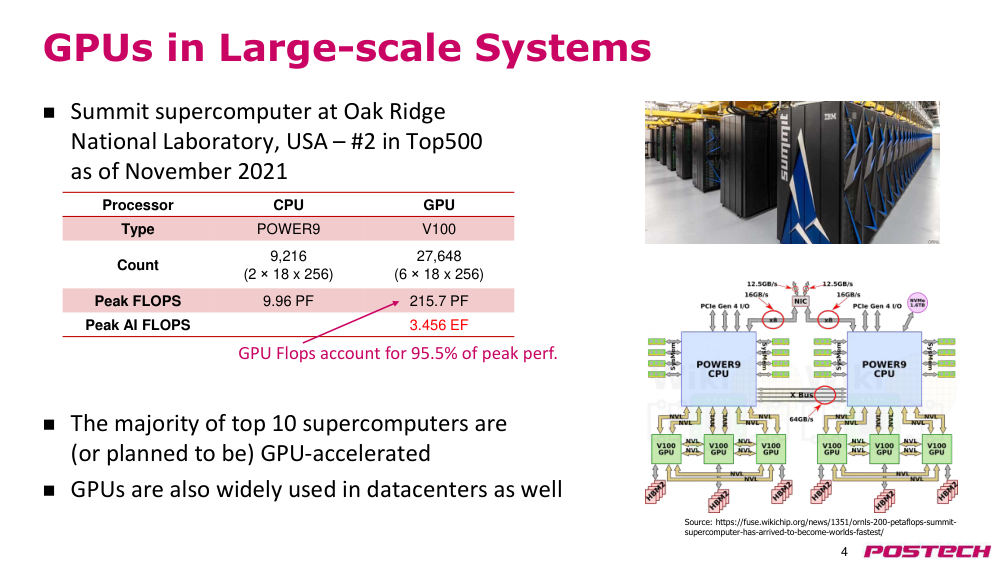
p.4대규모 시스템에서의 GPU
- Oak Ridge National Laboratory의 Summit supercomputer(슈퍼컴퓨터), USA – 2021년 11월 기준 Top500 2위
- 상위 10대 supercomputer(슈퍼컴퓨터)의 대부분은 (또는 계획 중인) GPU 가속화
- GPU는 datacenter(데이터센터)에서도 널리 사용됨
- 출처: https://fuse.wikichip.org/news/1351/ornls-200-petaflops-summit-supercomputer-has-arrived-to-become-worlds-fastest/
- 프로세서
- CPU
- GPU
- 유형
- POWER9
- V100
- 수량
- 9,216 (2 × 18 × 256)
- 27,648 (6 × 18 × 256)
- peak FLOPS(피크 FLOPS)
- 9.96 PF
- 215.7 PF
- peak AI FLOPS(피크 AI FLOPS)
- 3.456 EF
- GPU FLOPS는 피크 성능의 95.5% 차지
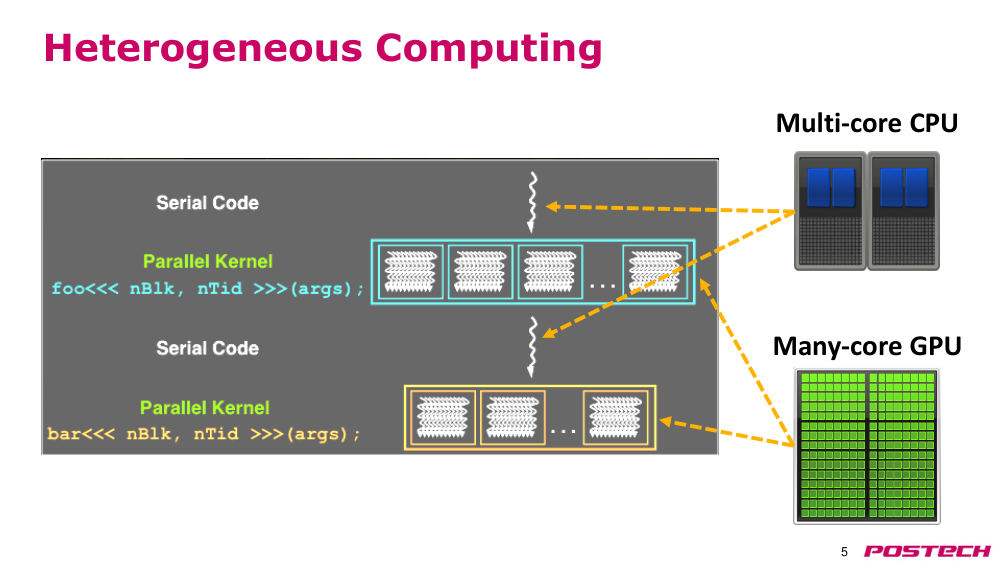
p.5heterogeneous computing(이질적 컴퓨팅)
- 다중 코어 CPU
- many-core GPU(매니코어 GPU)
p.6GPU 아키텍처 개요
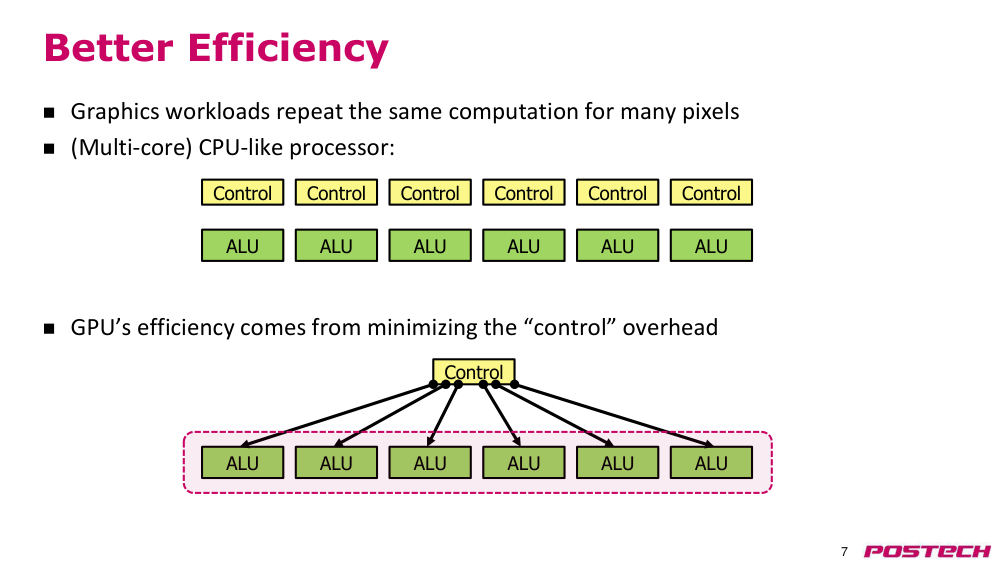
p.7더 높은 효율성
- 그래픽 워크로드는 많은 픽셀에 대해 동일한 계산을 반복한다.
- (다중 코어) CPU와 유사한 프로세서:
- GPU의 효율성은 '제어' 오버헤드를 최소화함으로써 얻어진다.
- ALU
- control logic(제어 논리)
- ALU
- control logic(제어 논리)
- ALU
- control logic(제어 논리)
- ALU
- control logic(제어 논리)
- ALU
- control logic(제어 논리)
- ALU
- control logic(제어 논리)
- ALU
- ALU
- ALU
- control logic(제어 논리)
- ALU
- ALU
- ALU
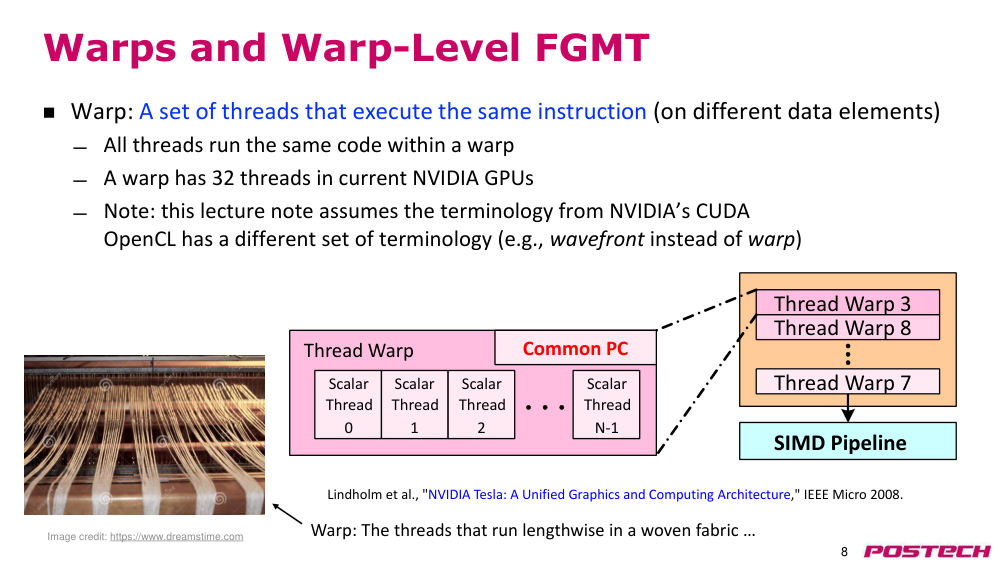
p.8warp(워프)와 워프 수준의 FGMT
- warp(워프): 동일한 명령을 실행하는 thread(스레드)의 집합 (다른 데이터 요소에서).
- warp(워프) 내 모든 thread(스레드)는 동일한 코드를 실행한다.
- 현재 NVIDIA GPU에서는 warp(워프)에 32개의 thread(스레드)가 있다.
- 참고: 이 강의 노트는 NVIDIA의 CUDA 용어를 가정한다.
- OpenCL은 다른 용어 체계를 사용한다 (예: warp(워프) 대신 웨이브프론트).
- thread(스레드) warp(워프) 3
- thread(스레드) warp(워프) 8
- thread(스레드) warp(워프) 7
- thread(스레드) warp(워프)
- 스칼라 thread(스레드)
- 0
- 스칼라 thread(스레드)
- 1
- 스칼라 thread(스레드)
- 2
- 스칼라 thread(스레드)
- N-1
- 공통 PC
- SIMD pipeline(파이프라인)
- Lindholm 등, "NVIDIA Tesla: A Unified Graphics and Computing Architecture", IEEE Micro 2008.
- 이미지 출처: https://www.dreamstime.com
- warp(워프): 직조된 천의 길이 방향으로 움직이는 thread(스레드)들 …
p.9GPU는 SIMD(SIMT) 기계이다
- 단, SIMD 명령어를 사용하여 프로그래밍하지는 않는다.
- thread(스레드)를 사용하여 프로그래밍한다 – SPMD(단일 프로그램 다중 데이터) 모델.
- 각 thread(스레드)는 동일한 코드를 실행하지만, 다른 데이터 조각을 처리한다.
- 각 thread(스레드)는 자체 컨텍스트를 가진다 (즉, 독립적으로 처리/재시작/실행 가능).
- SIMT(단일 명령 다중 스레드) 실행:
- thread(스레드)는 32개로 구성된 그룹인 warp(워프) 단위로 실행된다.
- warp(워프) 내 thread(스레드)는 명령 단위(IU)를 공유한다.
- hardware multithreading(하드웨어 다중 스레딩):
- 하드웨어 resource allocation(자원 할당) 및 thread(스레드) 스케줄링 (CPU의 OS와 대조).
- 하드웨어는 thread(스레드)가 메모리 접근 latency(지연 시간)을 숨기는 데 의존한다.
- thread(스레드)는 실행에 필요한 모든 자원을 갖춘다.
- 무엇인가를 기다리지 않는 warp(워프)는 언제든지 실행 가능하다.
- context switch(컨텍스트 전환)은 (기본적으로) 무료이다.
p.10SIMD vs. SIMT 실행 모델
- SIMD: 단일 순차 명령 스트림의 SIMD 명령어 → 각 명령어는 다수의 데이터 입력을 지정한다.
- [VLD, VLD, VADD, VST], VLEN
- SIMT: 다수의 스칼라 명령 스트림 → thread(스레드)는 동적으로 warp(워프)로 그룹화된다.
- [LD, LD, ADD, ST], NumThreads
- SIMT의 두 가지 주요 장점:
- 각 thread(스레드)를 별도로 처리할 수 있다 → 즉, 각 스레드를 독립적으로 실행 가능 (어떤 유형의 scalar pipeline(스칼라 파이프라인)에서도 가능) → 필요 시 MIMD와 유사한 작업 수행 가능.
- thread(스레드)를 유연하게 warp(워프)로 그룹화할 수 있다 → 즉, 실제로 동일한 명령을 실행해야 하는 스레드를 그룹화할 수 있다 → 동적으로 SIMD 처리의 이점을 얻고 최대화할 수 있다.
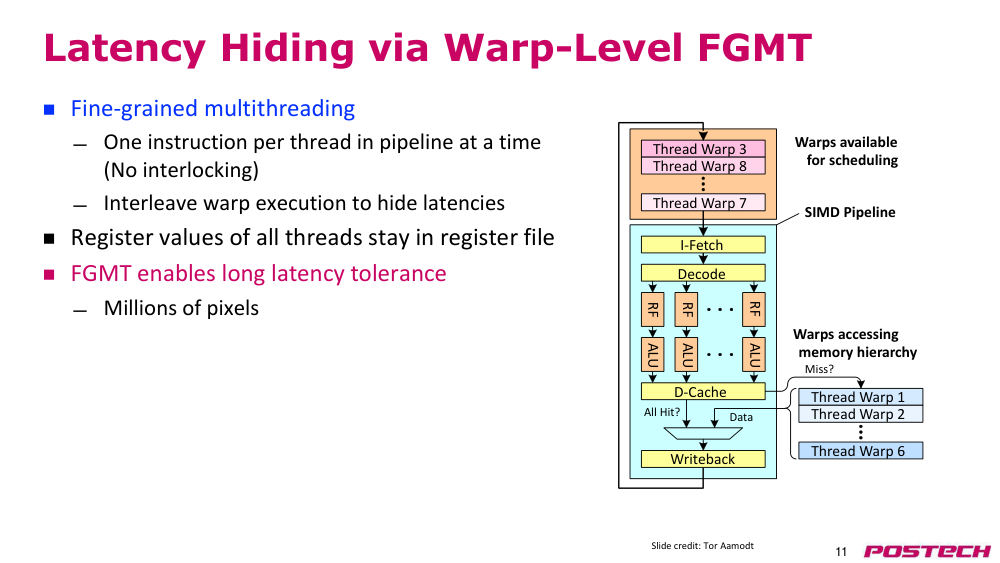
p.11warp(워프) 수준의 FGMT을 통한 latency hiding(지연 시간 숨기기)
- 세밀한 다중 스레딩(FGMT):
- pipeline(파이프라인) 내 한 thread(스레드)당 하나의 명령어만 존재 (상호 잠금 없음).
- warp(워프) 실행을 교차하여 latency(지연 시간)을 숨긴다.
- 모든 thread(스레드)의 register(레지스터) 값은 register file(레지스터 파일)에 유지된다.
- FGMT는 긴 latency(지연 시간)에 대한 내성을 가능하게 한다.
- 수백만 개의 픽셀
- 디코딩
- RF
- RF
- RF
- ALU
- ALU
- ALU
- D-Cache
- thread(스레드) warp(워프) 6
- thread(스레드) warp(워프) 1
- thread(스레드) warp(워프) 2
- 데이터
- 모든 히트?
- 미스?
- memory hierarchy(메모리 계층 구조)에 접근하는 warp(워프)
- thread(스레드) warp(워프) 3
- thread(스레드) warp(워프) 8
- 쓰기 백
- 스케줄링 가능한 warp(워프)
- thread(스레드) warp(워프) 7
- I-Fetch
- SIMD pipeline(파이프라인)
- 슬라이드 출처: Tor Aamodt
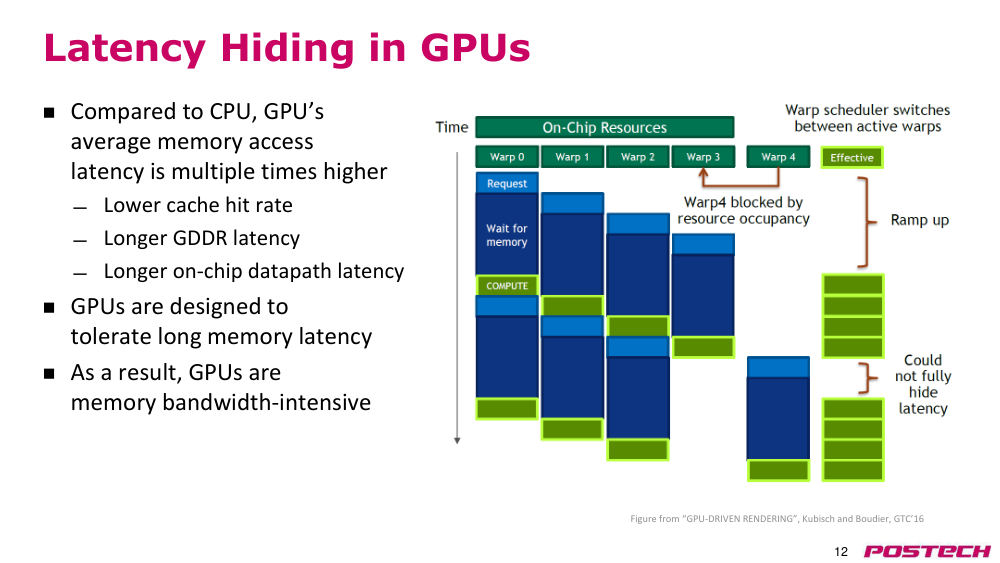
p.12GPU에서의 latency hiding(지연 시간 숨기기)
- CPU와 비교했을 때 GPU의 평균 메모리 접근 latency(지연 시간)은 수 배 더 높다.
- 낮은 cache hit(캐시 히트)율.
- 긴 GDDR latency(지연 시간).
- 긴 on-chip datapath(온칩 데이터 경로) latency(지연 시간).
- GPU는 긴 메모리 latency(지연 시간)을 견딜 수 있도록 설계되어 있다.
- 결과적으로 GPU는 memory bandwidth-intensive(메모리 bandwidth(대역폭) 집약적)이다.
- 출처: "GPU-DRIVEN RENDERING", Kubisch and Boudier, GTC’16
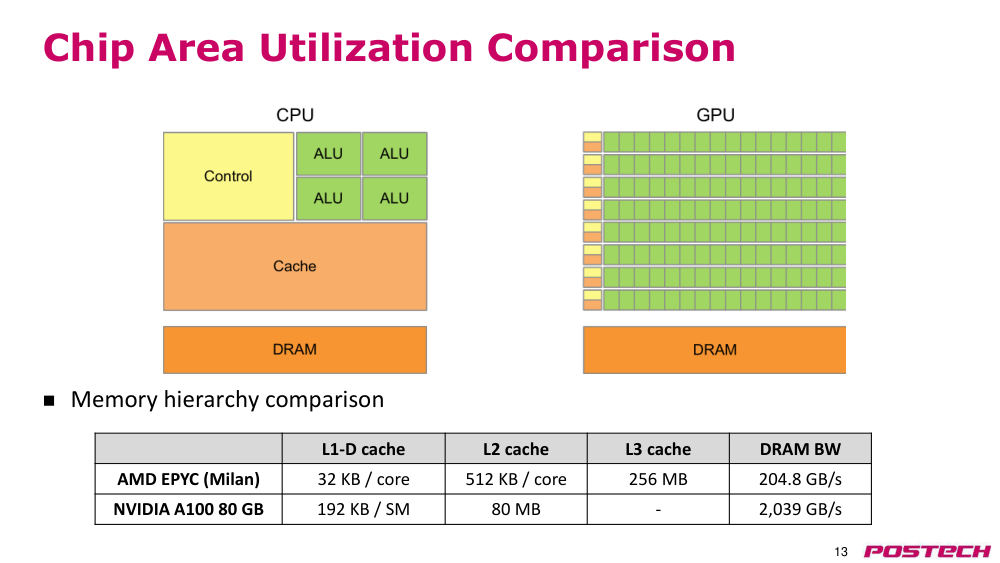
p.13chip area utilization(칩 면적 활용도) 비교
- memory hierarchy(메모리 계층 구조) 비교
- L1-D 캐시: AMD EPYC (Milan) - 32 KB / 코어, NVIDIA A100 80 GB - 192 KB / SM
- L2 cache(L2 캐시): AMD EPYC (Milan) - 512 KB / 코어, NVIDIA A100 80 GB - 80 MB
- L3 cache(L3 캐시): AMD EPYC (Milan) - 256 MB, NVIDIA A100 80 GB - -
- DRAM bandwidth(대역폭): AMD EPYC (Milan) - 204.8 GB/s, NVIDIA A100 80 GB - 2,039 GB/s
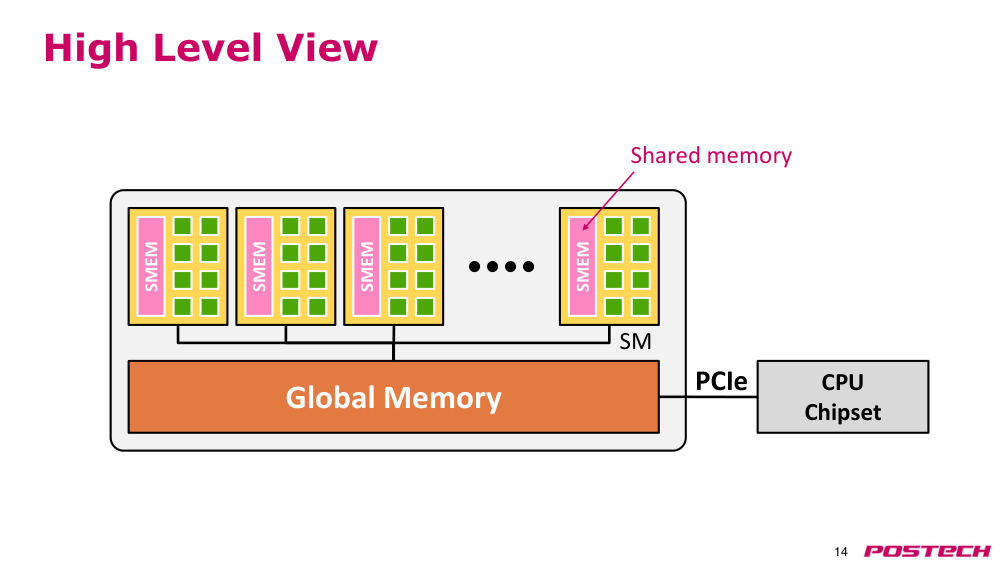
p.14고수준 시각화
- 공유 메모리 (SMEM)
- 공유 메모리 (SMEM)
- 공유 메모리 (SMEM)
- 공유 메모리 (SMEM)
- global memory(글로벌 메모리)
- 중앙처리장치 (CPU)
- 칩셋
- PCIe
- shared memory(공유 메모리)
- 스트리밍 멀티프로세서 (SM)
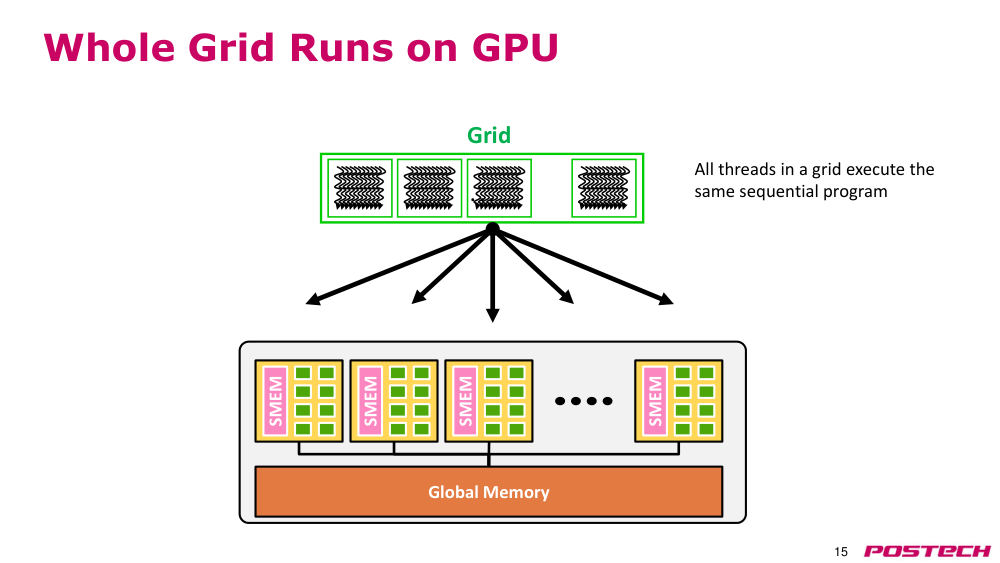
p.15전체 grid(그리드)가 GPU에서 실행됨
- grid(그리드)
- …
- 공유 메모리 (SMEM)
- 공유 메모리 (SMEM)
- 공유 메모리 (SMEM)
- 공유 메모리 (SMEM)
- global memory(글로벌 메모리)
- grid(그리드) 내 모든 thread(스레드)는 동일한 순차 프로그램을 실행함
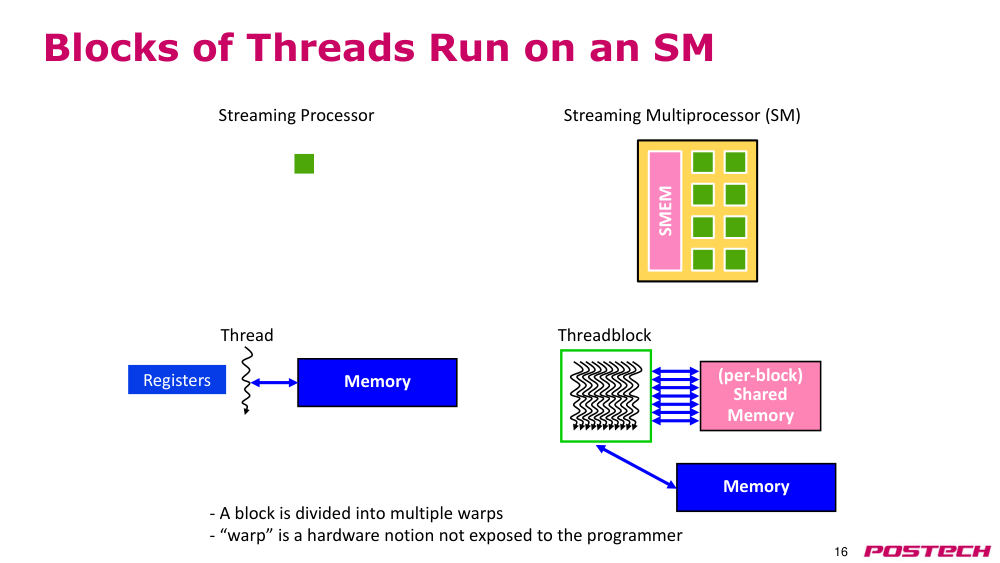
p.16thread block(스레드 블록)이 SM에서 실행됨
- thread(스레드)
- 메모리
- thread(스레드) 블록 (블록당)
- shared memory(공유 메모리)
- 스트리밍 프로세서
- 스트리밍 멀티프로세서 (SM)
- register(레지스터)
- 메모리
- 공유 메모리 (SMEM)
- block(블록)은 여러 warp(워프)로 나누어짐
- warp(워프)는 프로그래머에게 노출되지 않는 하드웨어 개념임
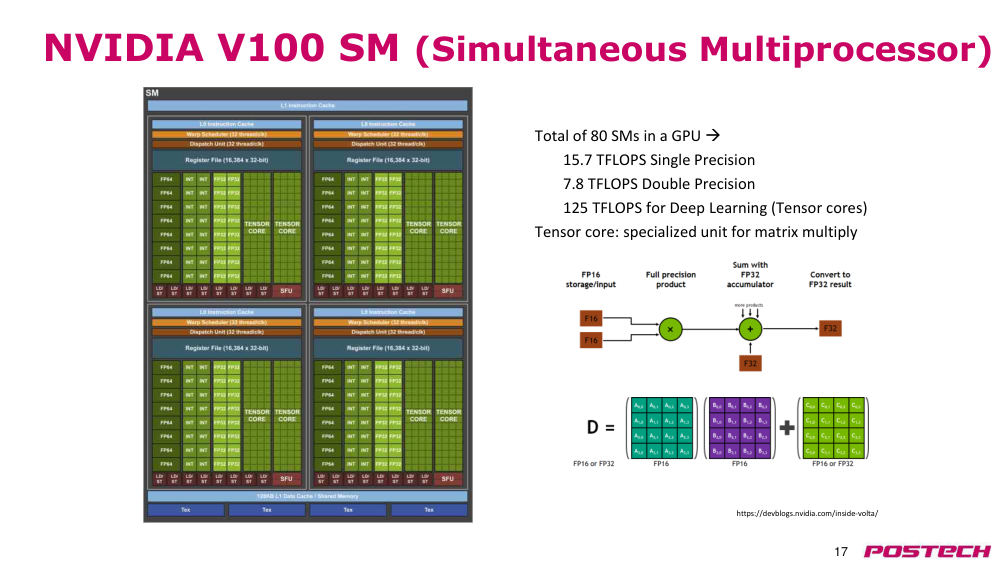
p.17NVIDIA V100 SM (동시 멀티프로세서)
- GPU 내 총 80개의 SM →
- 단정밀도: 15.7 TFLOPS
- 이중정밀도: 7.8 TFLOPS
- 딥러닝용: 125 TFLOPS (텐서 코어)
- tensor core(텐서 코어): 행렬 곱셈을 위한 전용 단위
- https://devblogs.nvidia.com/inside-volta/
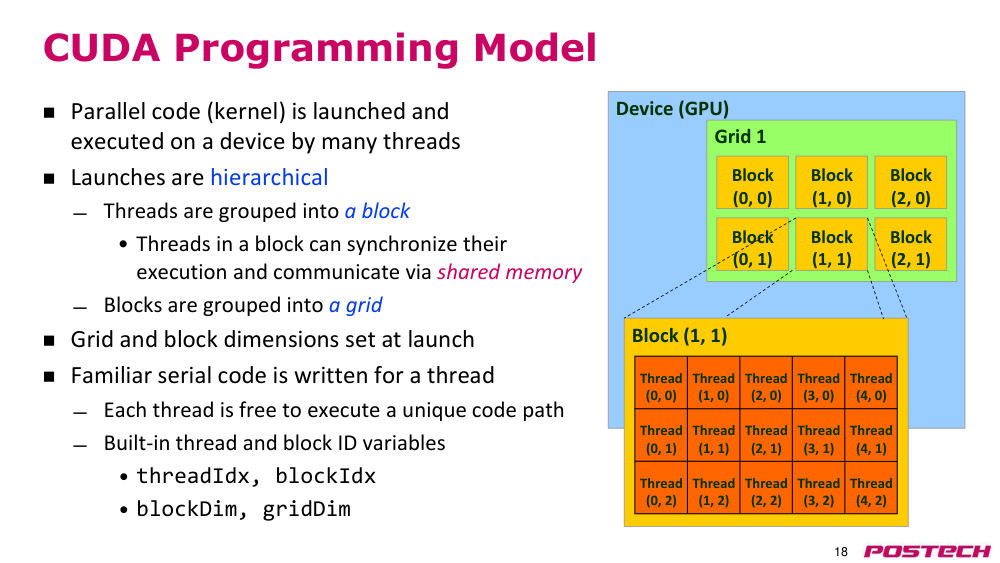
p.18CUDA 프로그래밍 모델
- 병렬 코드(커널)는 많은 thread(스레드)에 의해 장치에서 실행됨
- 실행은 계층적임
- thread(스레드)는 block(블록)으로 그룹화됨
- • block(블록) 내 thread(스레드)는 실행을 synchronization(동기화)하고 shared memory(공유 메모리)를 통해 통신할 수 있음
- block(블록)은 grid(그리드)로 그룹화됨
- • grid(그리드) 및 block dimensions(블록 차원)은 실행 시 설정됨
- • thread(스레드)용으로 익숙한 순차 코드를 작성함
- • 각 thread(스레드)는 고유한 코드 경로를 실행할 수 있음
- 내장된 thread(스레드) 및 block(블록) ID 변수
- • threadIdx, blockIdx
- • blockDim, gridDim
- 장치 (GPU)
- grid(그리드) 1
- 블록 (0, 0)
- 블록 (1, 0)
- 블록 (2, 0)
- 블록 (0, 1)
- 블록 (1, 1)
- 블록 (2, 1)
- 블록 (1, 1)
- 스레드 (0, 1)
- 스레드 (1, 1)
- 스레드 (2, 1)
- 스레드 (3, 1)
- 스레드 (4, 1)
- 스레드 (0, 2)
- 스레드 (1, 2)
- 스레드 (2, 2)
- 스레드 (3, 2)
- 스레드 (4, 2)
- 스레드 (0, 0)
- 스레드 (1, 0)
- 스레드 (2, 0)
- 스레드 (3, 0)
- 스레드 (4, 0)
p.19block(블록)은 독립적이어야 한다
- 모든 block(블록)의 가능한 교차 실행 순서가 유효해야 한다
- 중단 없이 완료될 것으로 가정한다
- 어떤 순서로든 실행될 수 있다
- 병렬로 또는 순차적으로 실행될 수 있다
- block(블록)은 상호 조율할 수 있지만 synchronization(동기화)할 수는 없다
- 공유 큐 포인터: 허용됨
- 공유 락: 비허용됨 … 쉽게 데드락이 발생할 수 있음
- 락을 피하기 위해 다양한 atomic operation(원자적 연산)이 제공된다
- 예: atomicAdd(), atomicOr(), atomicMin(), atomicExch(), …
- 여전히 직렬화로 인해 쉽게 성능 저하가 발생할 수 있다
- 독립성 요구 조건은 확장성 제공
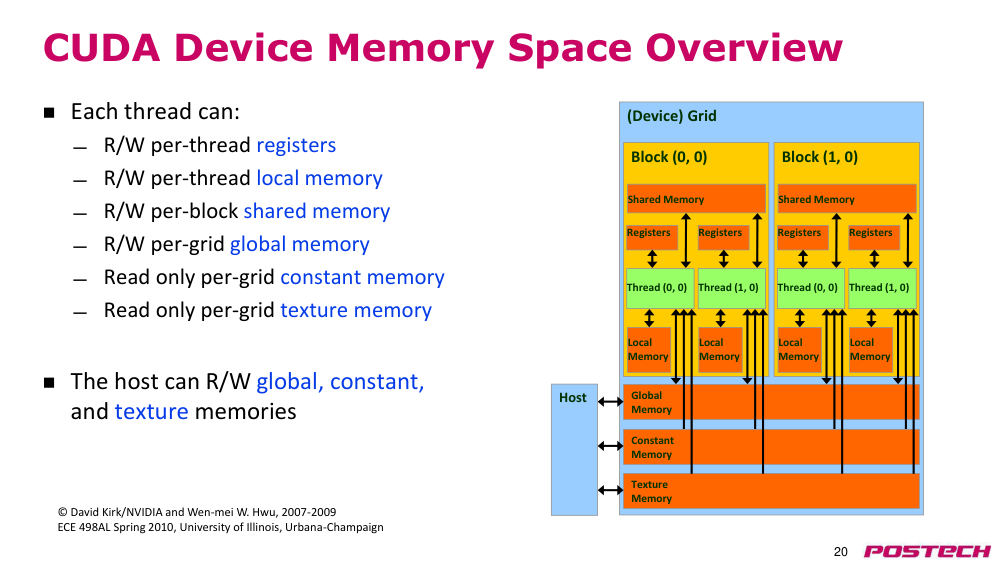
p.20CUDA 장치 메모리 공간 개요
- 각 thread(스레드)는 다음을 읽고 쓸 수 있다:
- thread(스레드)별 register(레지스터)
- thread(스레드)별 local memory(로컬 메모리)
- block(블록)별 shared memory(공유 메모리)
- grid(그리드)별 global memory(글로벌 메모리)
- grid(그리드)별 상수 메모리 (읽기 전용)
- grid(그리드)별 텍스처 메모리 (읽기 전용)
- 호스트는 global memory(글로벌 메모리), constant memory(상수 메모리), texture memory(텍스처 메모리)를 읽고 쓸 수 있다
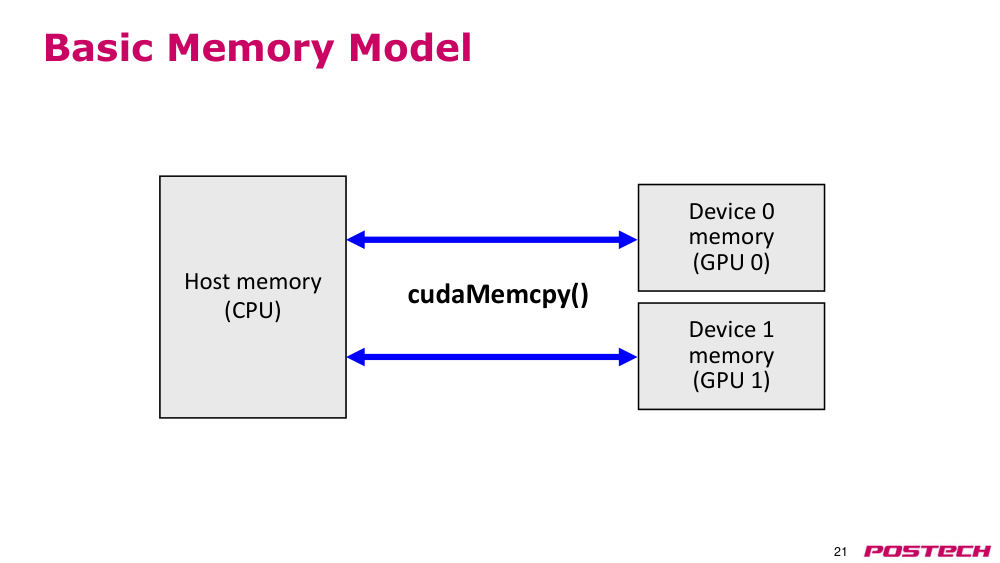
p.21기본 메모리 모델
- 장치 0 메모리 (GPU 0)
- 장치 1 메모리 (GPU 1)
- 호스트 메모리 (CPU)
- cudaMemcpy()
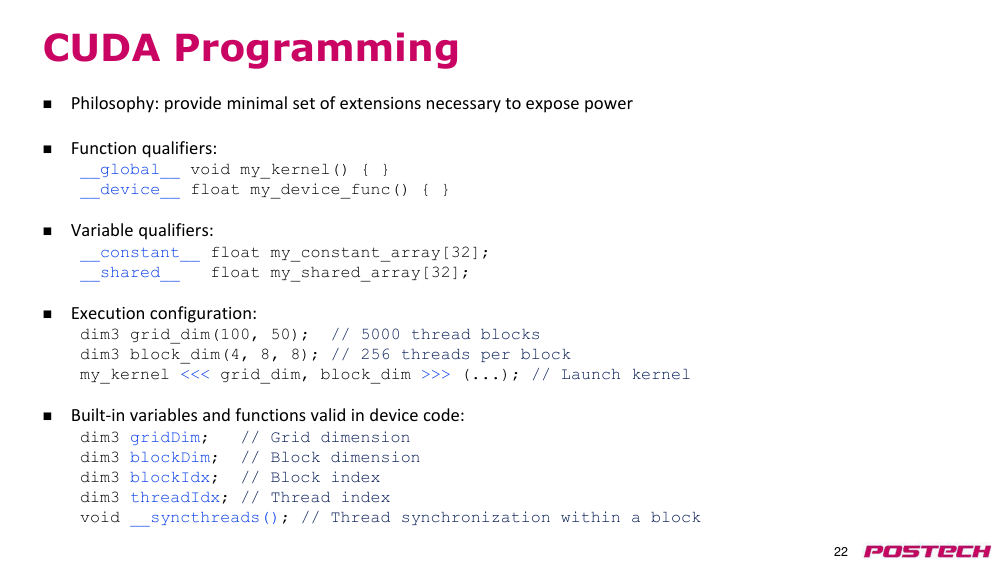
p.22CUDA 프로그래밍
- 철학: 강력한 기능을 노출하기 위해 필요한 최소한의 확장 제공
- function qualifier(함수 한정자):
- __global__ void my_kernel() { }
- __device__ float my_device_func() { }
- variable qualifier(변수 한정자):
- __constant__ float my_constant_array[32];
- __shared__ float my_shared_array[32];
- execution configuration(실행 구성):
- dim3 grid_dim(100, 50); // 5000개의 thread block(스레드 블록)
- dim3 block_dim(4, 8, 8); // 블록당 256개의 thread(스레드)
- my_kernel <<< grid_dim, block_dim >>> (...); // 커널 실행
- 장치 코드에서 유효한 내장 변수 및 함수:
- dim3 gridDim; // 그리드 차원
- dim3 blockDim; // 블록 차원
- dim3 blockIdx; // 블록 인덱스
- dim3 threadIdx; // 스레드 인덱스
- void __syncthreads(); // block(블록) 내 스레드 synchronization(동기화)
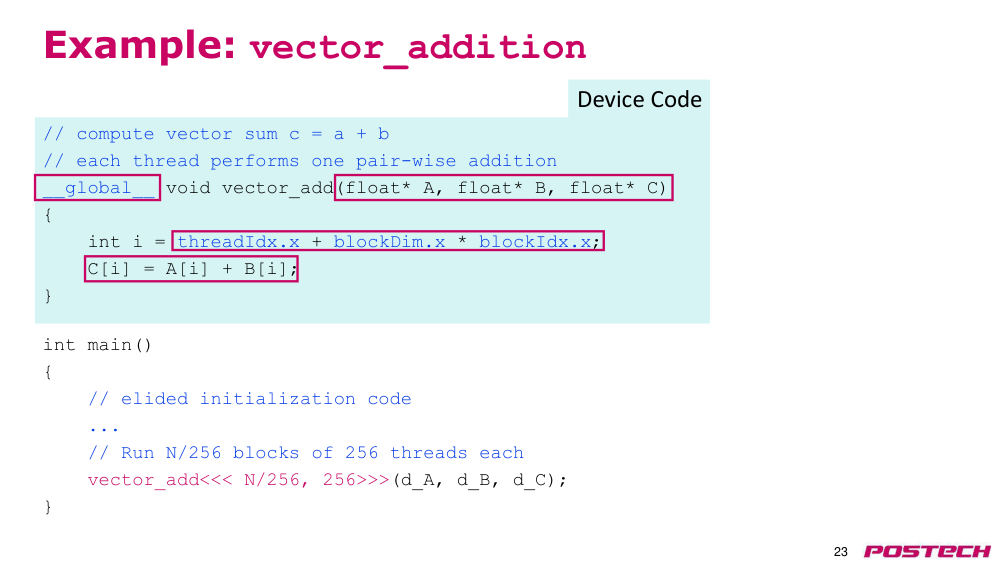
p.23예제: 벡터 덧셈 (장치 코드)
- // 벡터 합 c = a + b 계산
- // 각 thread(스레드)는 한 쌍의 덧셈을 수행
- __global__ void vector_add(float* A, float* B, float* C)
- {
- int i = threadIdx.x + blockDim.x * blockIdx.x;
- C[i] = A[i] + B[i];
- }
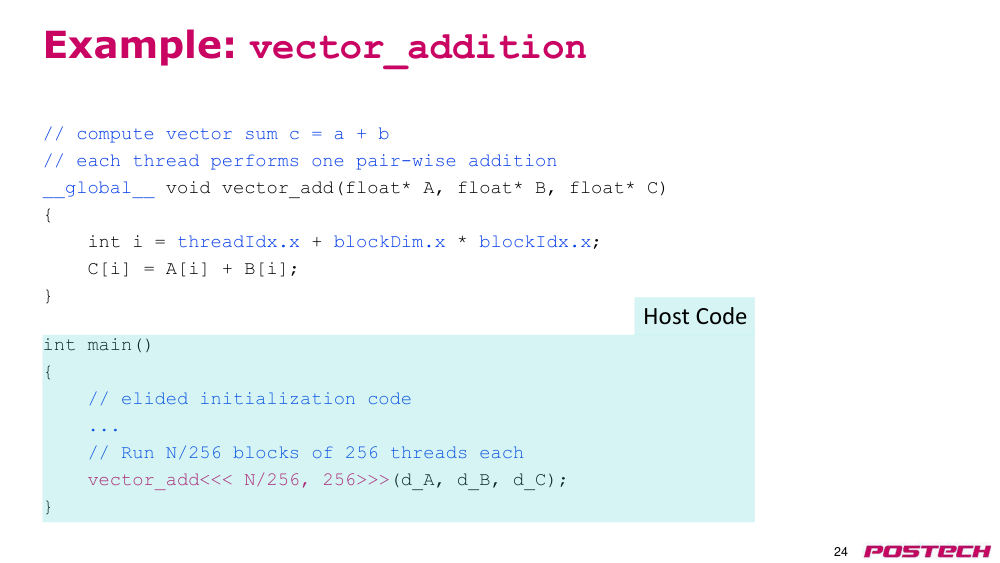
p.24예제: 벡터 덧셈 (호스트 코드)
- // 벡터 합 c = a + b 계산
- // 각 thread(스레드)는 한 쌍의 덧셈을 수행
- __global__ void vector_add(float* A, float* B, float* C)
- {
- int i = threadIdx.x + blockDim.x * blockIdx.x;
- C[i] = A[i] + B[i];
- }
- int main()
- {
- // 초기화 코드 생략
- ...
- // N/256개의 block(블록), 각 블록당 256개의 thread(스레드) 실행
- vector_add<<< N/256, 256>>>(d_A, d_B, d_C);
- }
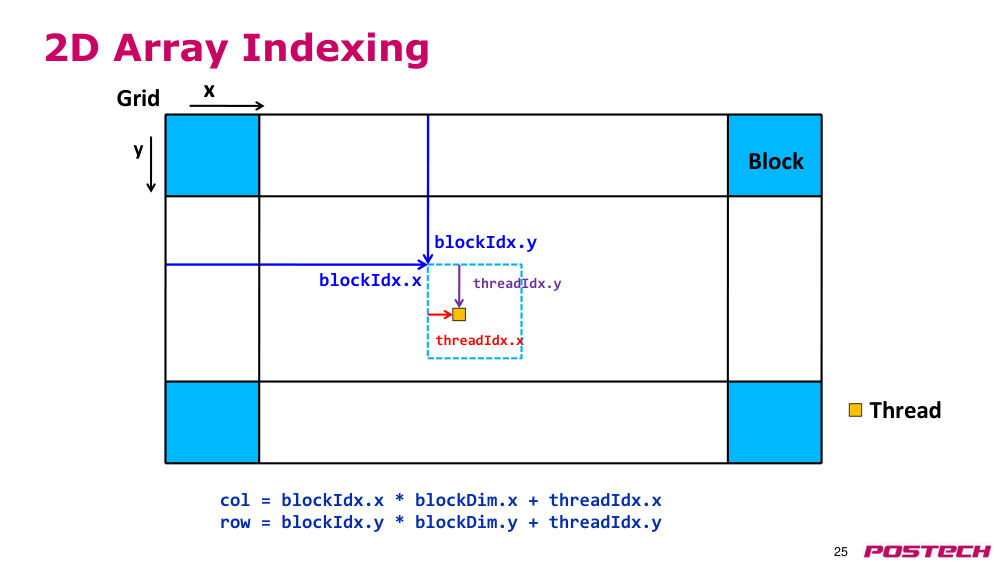
p.252D 배열 인덱싱
- 각 thread(스레드)는 다음과 같은 인덱스를 사용하여 2D 배열에 접근한다.
- col = blockIdx.x * blockDim.x + threadIdx.x
- row = blockIdx.y * blockDim.y + threadIdx.y
- 이를 통해 grid(그리드) 내의 각 block(블록)과 thread(스레드)의 위치를 계산할 수 있다.
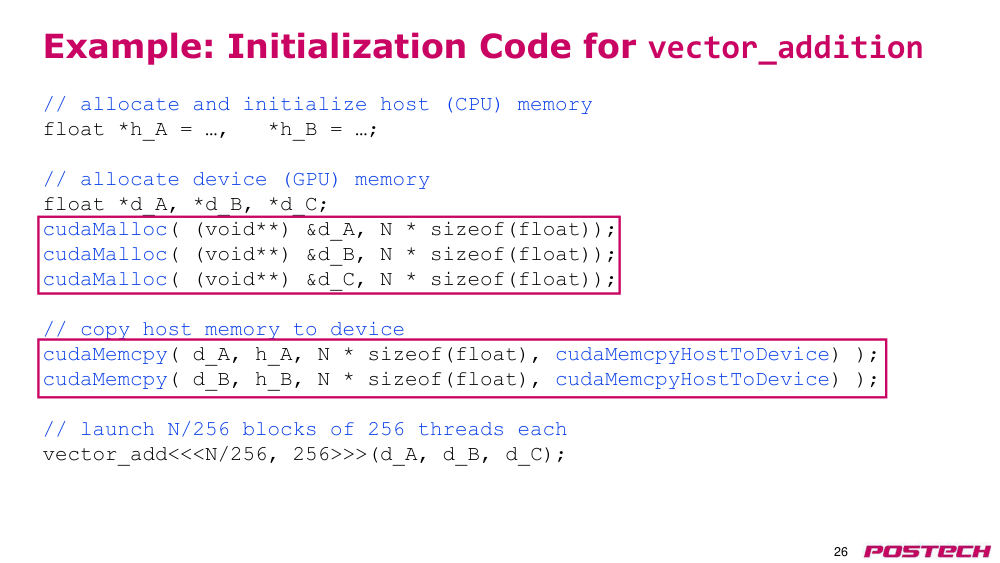
p.26벡터 덧셈 예제: 초기화 코드
- 호스트(CPU) 메모리 할당 및 초기화
- float *h_A = …, *h_B = …;
- 디바이스(GPU) 메모리 할당
- float *d_A, *d_B, *d_C;
- cudaMalloc((void**) &d_A, N * sizeof(float));
- cudaMalloc((void**) &d_B, N * sizeof(float));
- cudaMalloc((void**) &d_C, N * sizeof(float));
- 호스트 메모리에서 디바이스로 데이터 복사
- cudaMemcpy(d_A, h_A, N * sizeof(float), cudaMemcpyHostToDevice);
- cudaMemcpy(d_B, h_B, N * sizeof(float), cudaMemcpyHostToDevice);
- 256개의 thread(스레드)를 가진 N/256개의 block(블록)을 실행하여 kernel(커널) 시작
- vector_add<<<N/256, 256>>>(d_A, d_B, d_C);
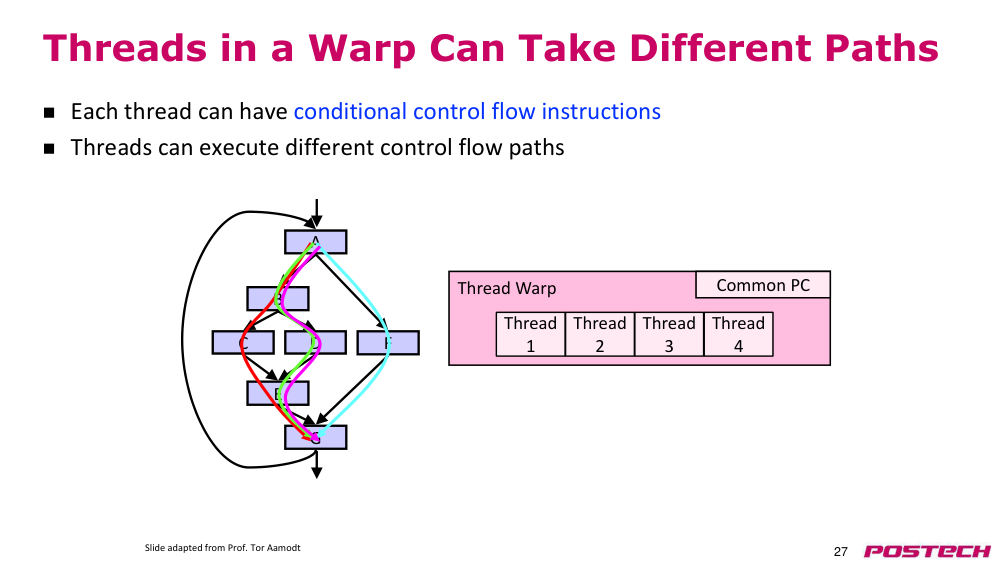
p.27warp(워프) 내 thread(스레드)는 서로 다른 경로를 취할 수 있다
- 각 thread(스레드)는 조건부 control flow(제어 흐름) 명령어를 가질 수 있다.
- warp(워프) 내 thread(스레드)는 서로 다른 control flow(제어 흐름) 경로를 실행할 수 있다.
- 모든 thread(스레드)는 동일한 명령어 포인터(PC)를 공유하지만, 실행 경로는 다를 수 있다.
- 예: thread(스레드) 1~4가 각각 A, B, C, D 경로를 따라 실행될 수 있음.
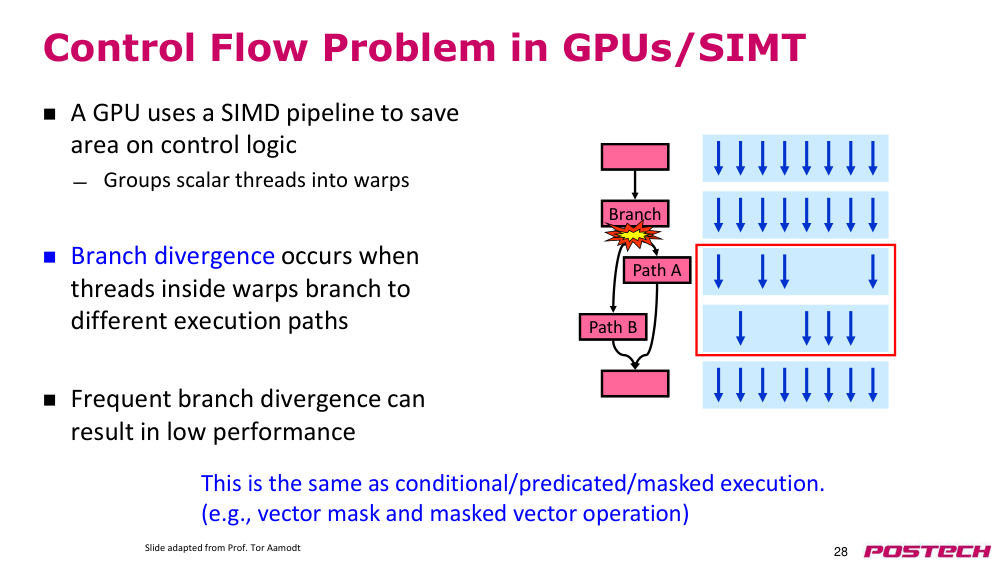
p.28GPU/SIMT의 control flow(제어 흐름) 문제
- GPU는 control logic(제어 논리)를 절약하기 위해 SIMD pipeline(파이프라인)을 사용한다.
- 스칼라 thread(스레드)를 warp(워프) 단위로 그룹화한다.
- warp(워프) 내 thread(스레드)가 서로 다른 실행 경로로 분기할 때 브랜치 분기(branch divergence)가 발생한다.
- 빈번한 branch divergence(브랜치 분기)는 성능 저하를 초래할 수 있다.
- 이 문제는 conditional(조건부)/predication(프레디케이션)/masked execution(마스크 실행)과 동일한 원리로 해결된다.
- (예: 벡터 마스크 및 마스크 벡터 연산)
p.29shared memory(공유 메모리)
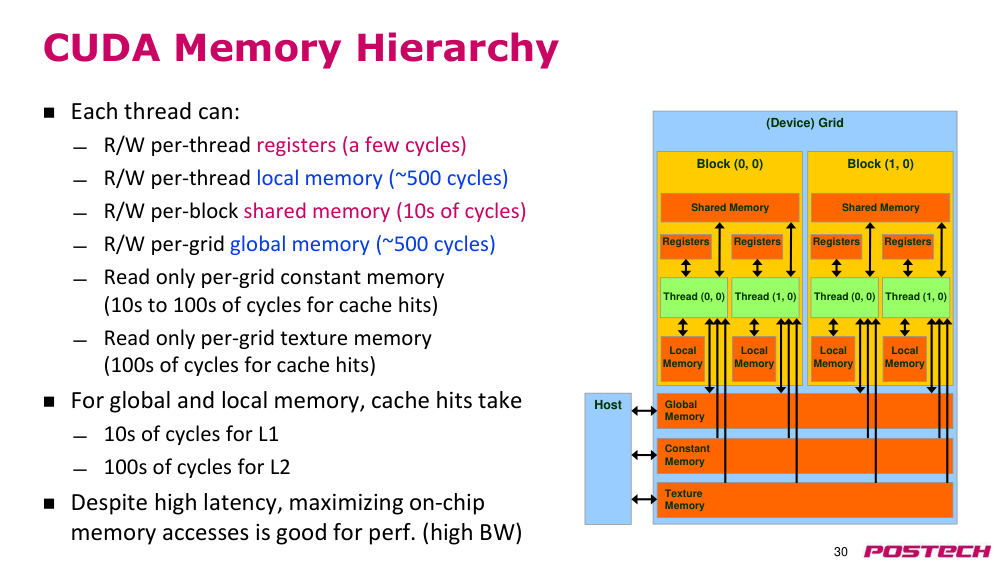
p.30CUDA memory hierarchy(메모리 계층 구조)
- 각 thread(스레드)는 다음을 읽거나 쓸 수 있다:
- thread(스레드)별 레지스터 (몇 사이클)
- thread(스레드)별 로컬 메모리 (~500 사이클)
- block(블록)별 공유 메모리 (10~수십 사이클)
- grid(그리드)별 글로벌 메모리 (~500 사이클)
- grid(그리드)별 constant memory(상수 메모리) 읽기 전용 (캐시 히트 시 10~100 사이클)
- grid(그리드)별 texture memory(텍스처 메모리) 읽기 전용 (캐시 히트 시 100 사이클 이상)
- global memory(글로벌 메모리) 및 local memory(로컬 메모리)의 cache hit(캐시 히트) 시:
- L1 cache(L1 캐시): 10~수십 사이클
- L2 cache(L2 캐시): 100~수백 사이클
- 높은 latency(지연 시간)에도 불구하고, 온칩 메모리 접근을 최대화하는 것이 성능에 유리하다 (고대역폭).
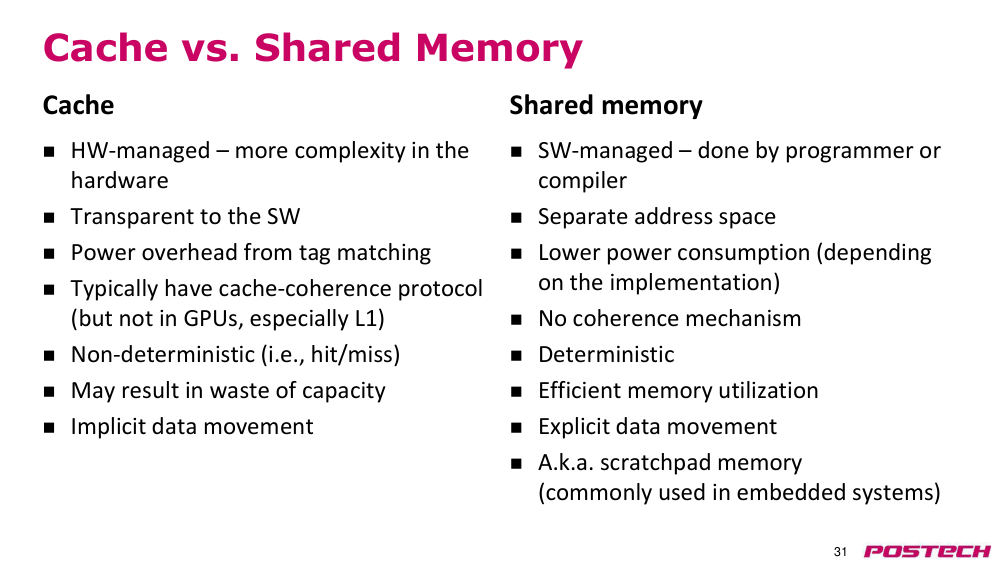
p.31캐시
- 캐시 vs. shared memory(공유 메모리)
- • 하드웨어에 의해 관리됨 – 하드웨어의 복잡성 증가
- • 소프트웨어에 대해 투명함
- • 태그 매칭으로 인한 전력 과부하
- • 일반적으로 cache coherence(캐시 일관성) 프로토콜을 갖지만, GPU에서는 특히 L1 cache(L1 캐시)에 해당하지 않음
- • 비결정적 (즉, 히트/미스)
- • 용량 낭비 가능성 있음
- • 암시적 데이터 이동
- • 소프트웨어에 의해 관리됨 – 프로그래머 또는 컴파일러가 수행
- • 별도의 주소 공간
- • 구현에 따라 전력 소비가 낮음
- • 일관성 메커니즘이 없음
- • 결정적
- • 메모리 활용 효율이 높음
- • 명시적 데이터 이동
- • 별칭: 스크래치패드 메모리 (주로 임베디드 시스템에서 사용됨)
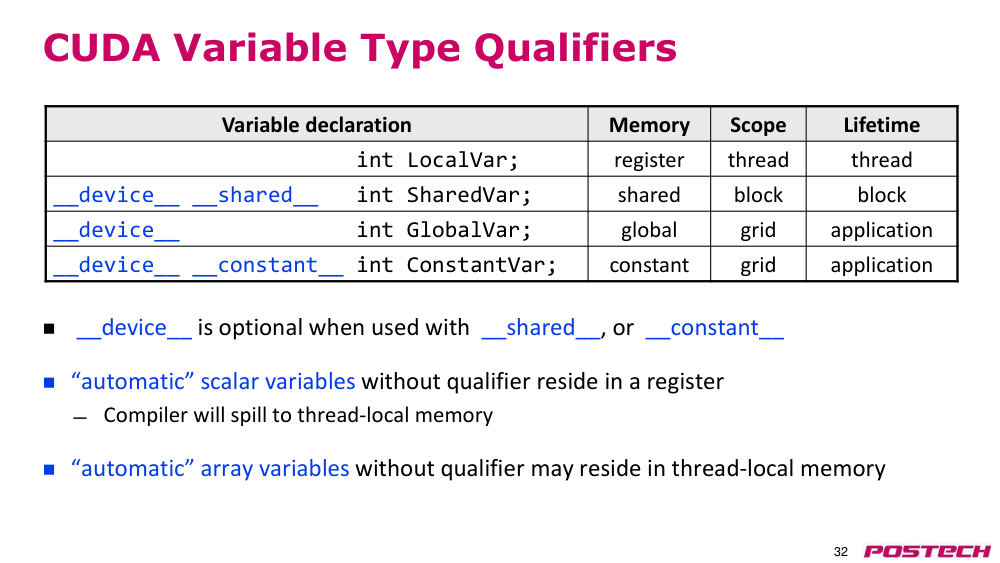
p.32CUDA 변수 유형 qualifier(한정자)
- • __shared__ 또는 __constant__와 함께 사용할 때 __device__는 선택 사항임
- • qualifier(한정자) 없이 선언된 '자동' 스칼라 변수는 register(레지스터)에 위치함
- • 컴파일러는 thread(스레드) local memory(로컬 메모리)로 spill(스필)함
- • qualifier(한정자) 없이 선언된 '자동' 배열 변수는 thread(스레드) local memory(로컬 메모리)에 위치할 수 있음
- 변수 선언
- 메모리
- 범위
- 수명
- int LocalVar;
- register(레지스터)
- thread(스레드)
- thread(스레드)
- __device__ __shared__ int SharedVar;
- 공유
- block(블록)
- block(블록)
- __device__ int GlobalVar;
- 글로벌
- grid(그리드)
- 응용 프로그램
- __device__ __constant__ int ConstantVar;
- 상수
- grid(그리드)
- 응용 프로그램
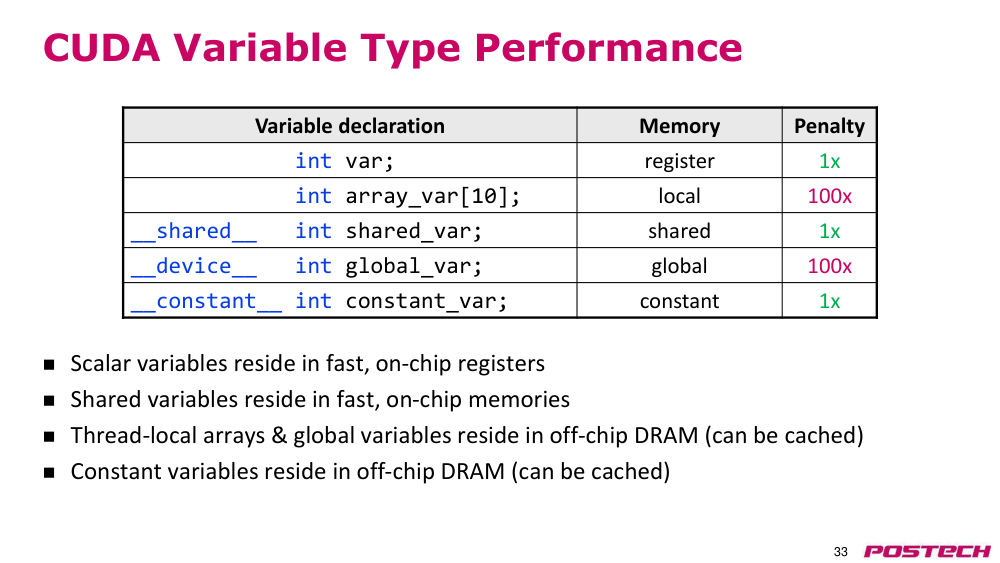
p.33CUDA 변수 유형 성능
- • 스칼라 변수는 빠르고 온칩 register(레지스터)에 위치함
- • 공유 변수는 빠르고 온칩 메모리에 위치함
- • thread(스레드) 로컬 배열 및 글로벌 변수는 오프칩 DRAM에 위치함 (캐시 가능)
- • 상수 변수는 오프칩 DRAM에 위치함 (캐시 가능)
- 변수 선언
- 메모리
- 패널티
- int var;
- register(레지스터)
- 1x
- int array_var[10];
- 로컬
- 100x
- __shared__ int shared_var;
- 공유
- 1x
- __device__ int global_var;
- 글로벌
- 100x
- __constant__ int constant_var;
- 상수
- 1x
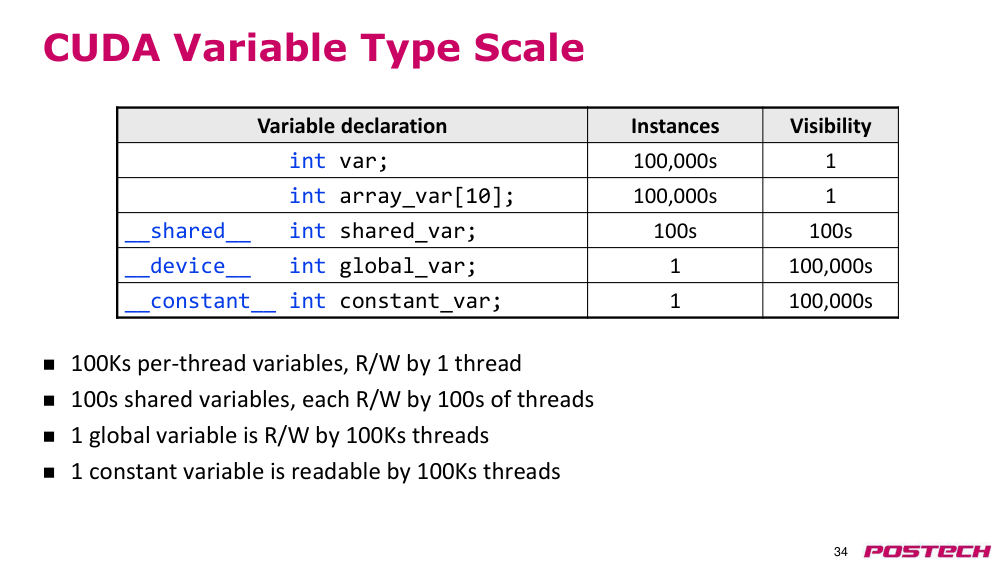
p.34CUDA 변수 유형 규모
- • thread(스레드)당 10만 개 이상의 변수, 1개 스레드가 읽고 씀
- • 수백 개의 공유 변수, 각각 수백 개의 thread(스레드)가 읽고 씀
- • 1개의 글로벌 변수, 10만 개 이상의 thread(스레드)가 읽고 씀
- • 1개의 상수 변수, 10만 개 이상의 thread(스레드)가 읽을 수 있음
- 변수 선언
- 인스턴스 수
- 가시성
- int var;
- 100,000s
- 1
- int array_var[10];
- 100,000s
- 1
- __shared__ int shared_var;
- 100s
- 100s
- __device__ int global_var;
- 1
- 100,000s
- __constant__ int constant_var;
- 1
- 100,000s
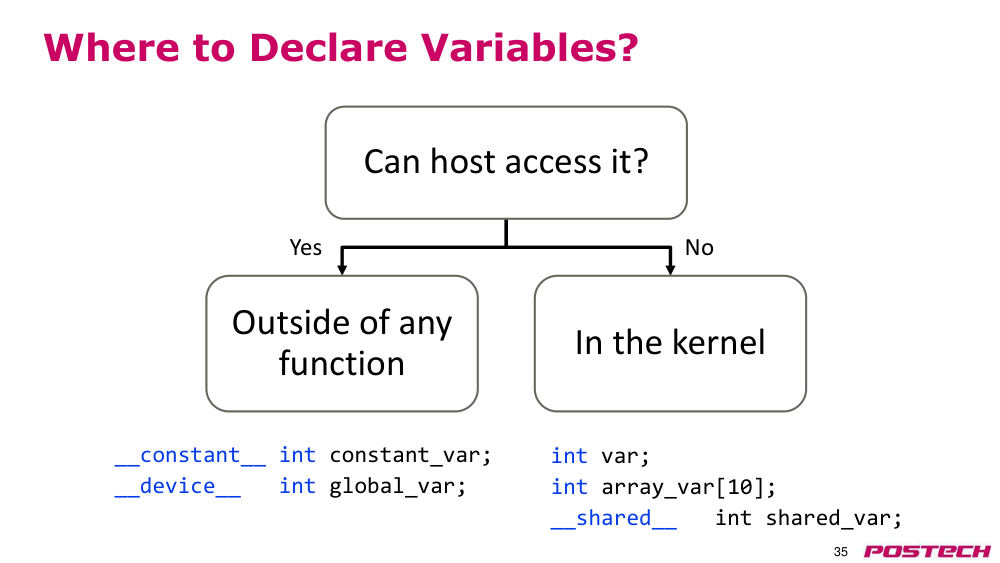
p.35변수를 어디에 선언할 것인가?
- 호스트가 접근할 수 있나요?
- 함수 외부
- kernel(커널) 내부
- 예
- 아니오
- __constant__ int constant_var;
- __device__ int global_var;
- int var;
- int array_var[10];
- __shared__ int shared_var;
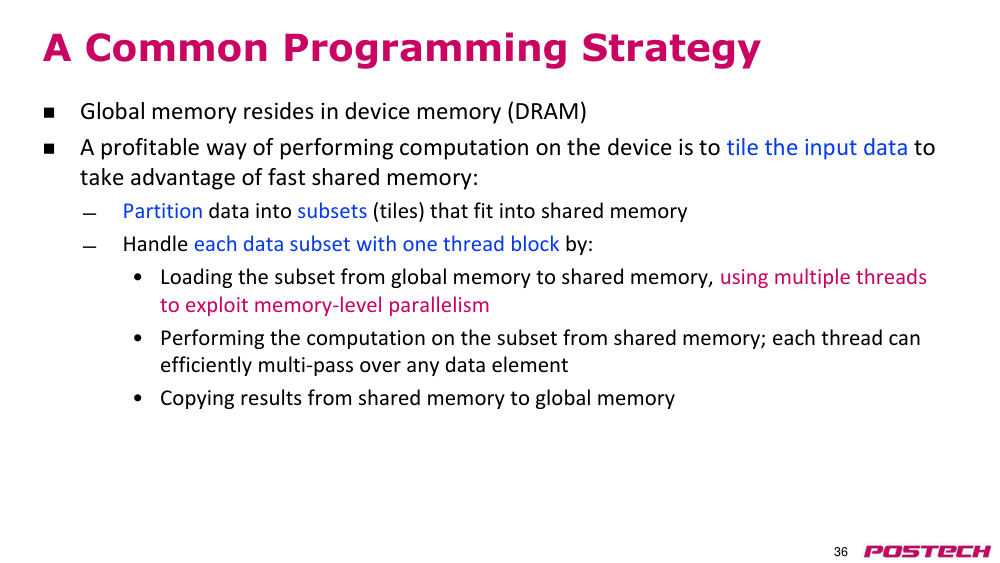
p.36일반적인 프로그래밍 전략
- • global memory(글로벌 메모리)는 장치 메모리(DRAM)에 위치함
- • 장치에서 계산을 효율적으로 수행하는 방법은 입력 데이터를 타일링하여 빠른 shared memory(공유 메모리)를 활용하는 것임:
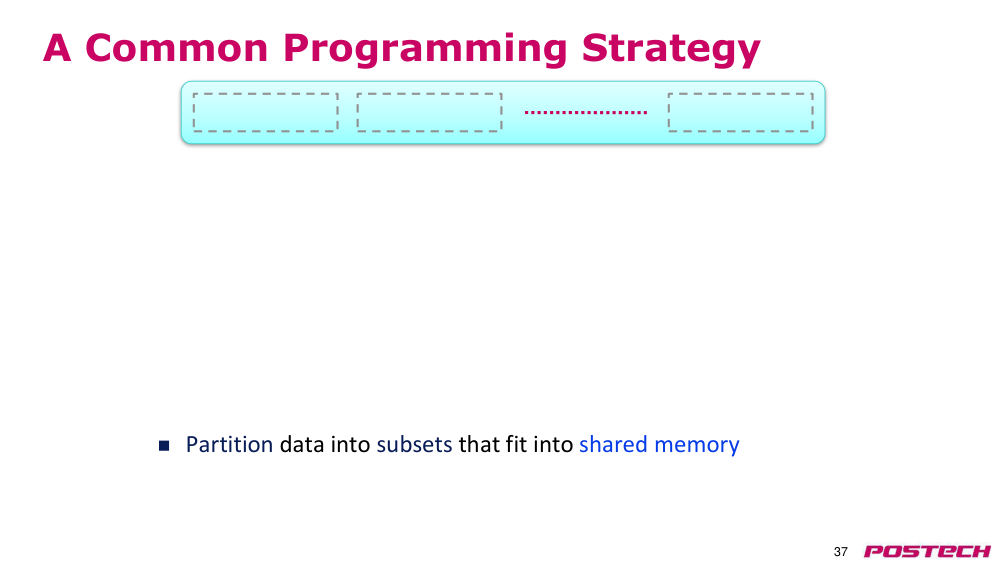
- • 데이터를 shared memory(공유 메모리)에 맞는 부분집합(타일)으로 분할함
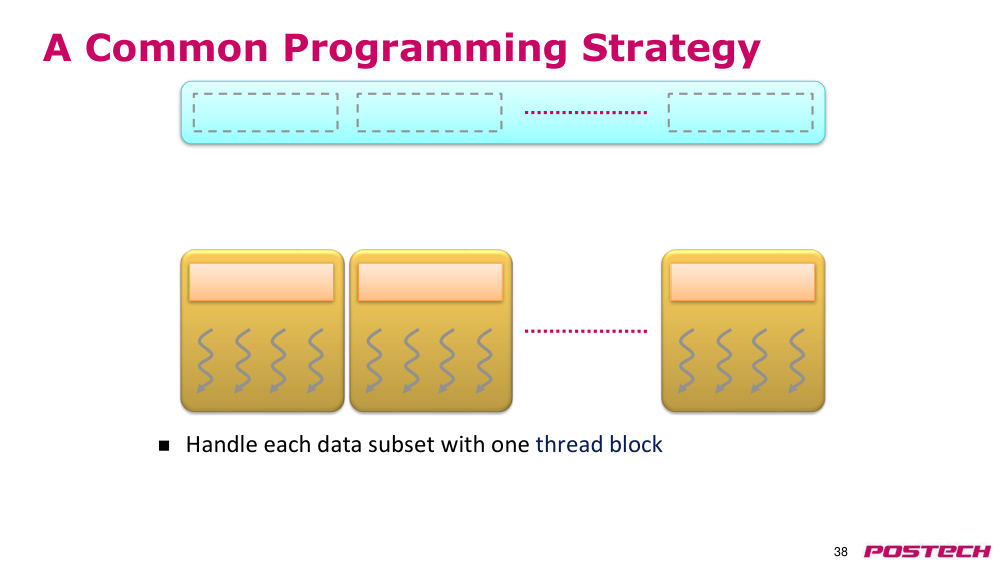
- • 각 데이터 부분집합을 하나의 thread block(스레드 블록)으로 처리함:
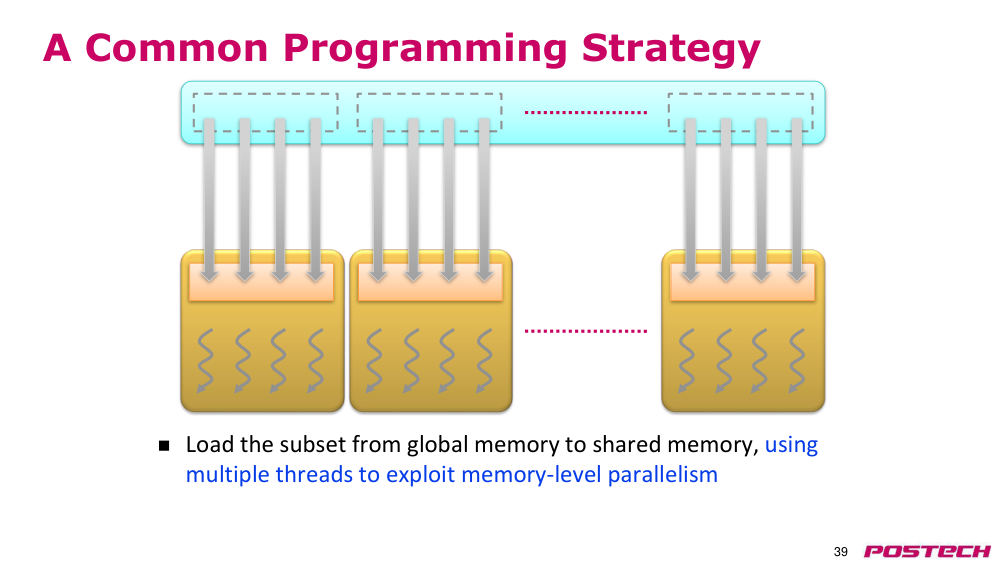
- • 복수의 thread(스레드)를 사용하여 메모리 수준 병렬성을 활용해 부분집합을 global memory(글로벌 메모리)에서 shared memory(공유 메모리)로 로드함
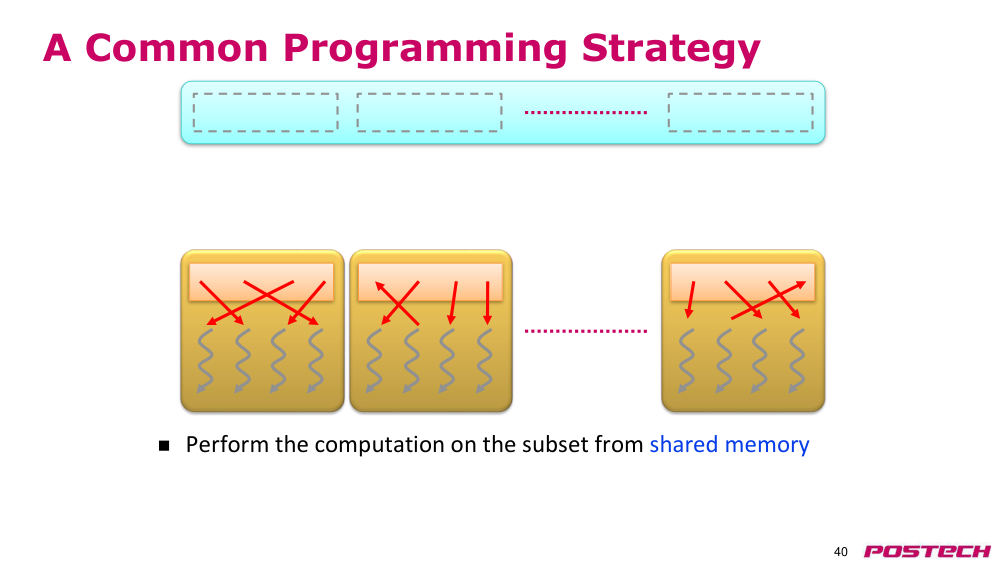
- • shared memory(공유 메모리)에서 부분집합에 대해 계산을 수행함; 각 thread(스레드)는 데이터 요소를 효율적으로 다중 패스로 처리할 수 있음
- • 결과를 shared memory(공유 메모리)에서 global memory(글로벌 메모리)로 복사함
p.37일반적인 프로그래밍 전략
- global memory(글로벌 메모리)에서 shared memory(공유 메모리)에 맞는 데이터 부분집합으로 데이터를 분할한다.
p.38일반적인 프로그래밍 전략
- 각 데이터 부분집합을 하나의 thread block(스레드 블록)으로 처리한다.
p.39일반적인 프로그래밍 전략
- 다중 thread(스레드)를 사용하여 메모리 수준의 병렬성을 활용해 부분집합을 global memory(글로벌 메모리)에서 shared memory(공유 메모리)로 로드한다.
p.40일반적인 프로그래밍 전략
- shared memory(공유 메모리)에서 부분집합에 대한 계산을 수행한다.
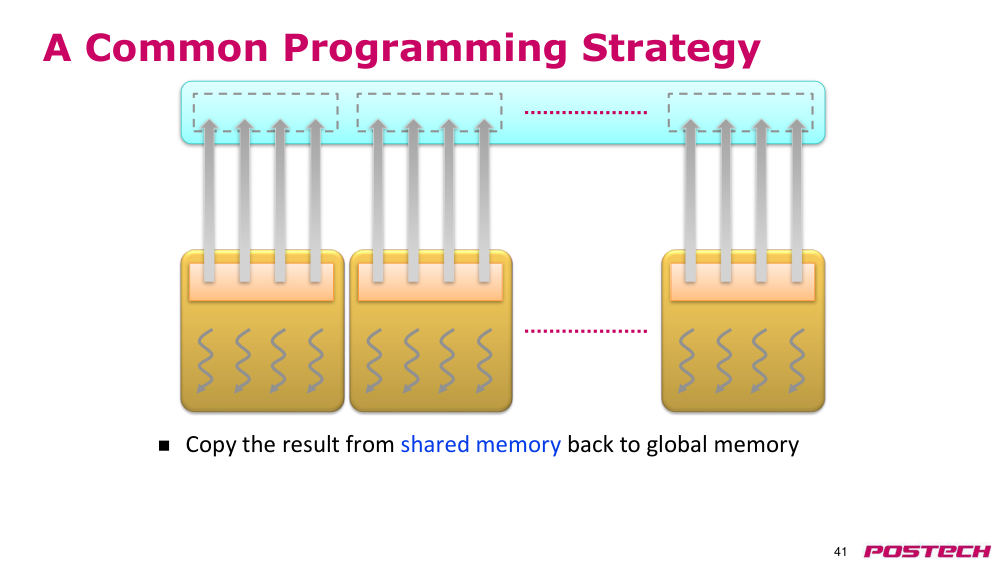
p.41일반적인 프로그래밍 전략
- 결과를 shared memory(공유 메모리)에서 다시 global memory(글로벌 메모리)로 복사한다.
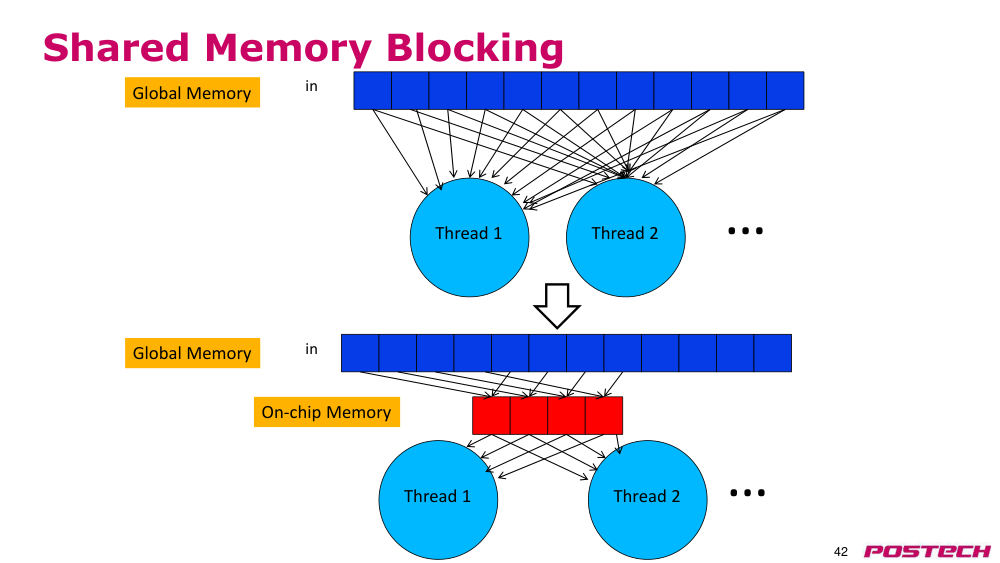
p.42shared memory(공유 메모리) 블로킹
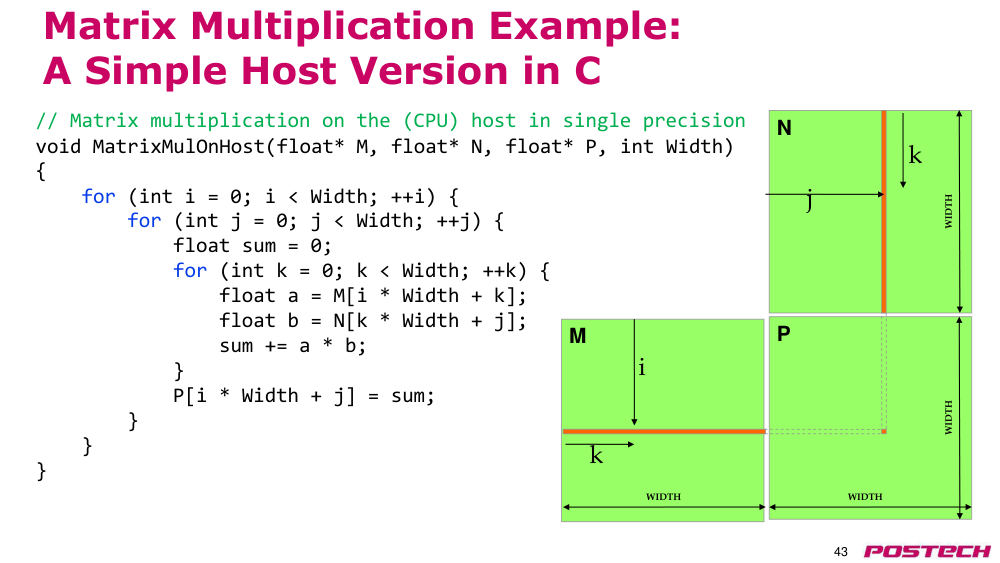
p.43행렬 곱셈 예제: 간단한 호스트 버전 (C 언어)
- 행렬 곱셈을 (CPU) 호스트에서 단정밀도로 수행
- void MatrixMulOnHost(float* M, float* N, float* P, int Width)
- {
- for (int i = 0; i < Width; ++i) {
- for (int j = 0; j < Width; ++j) {
- float sum = 0;
- for (int k = 0; k < Width; ++k) {
- float a = M[i * Width + k];
- float b = N[k * Width + j];
- sum += a * b;
- }
- P[i * Width + j] = sum;
- }
- }
- }
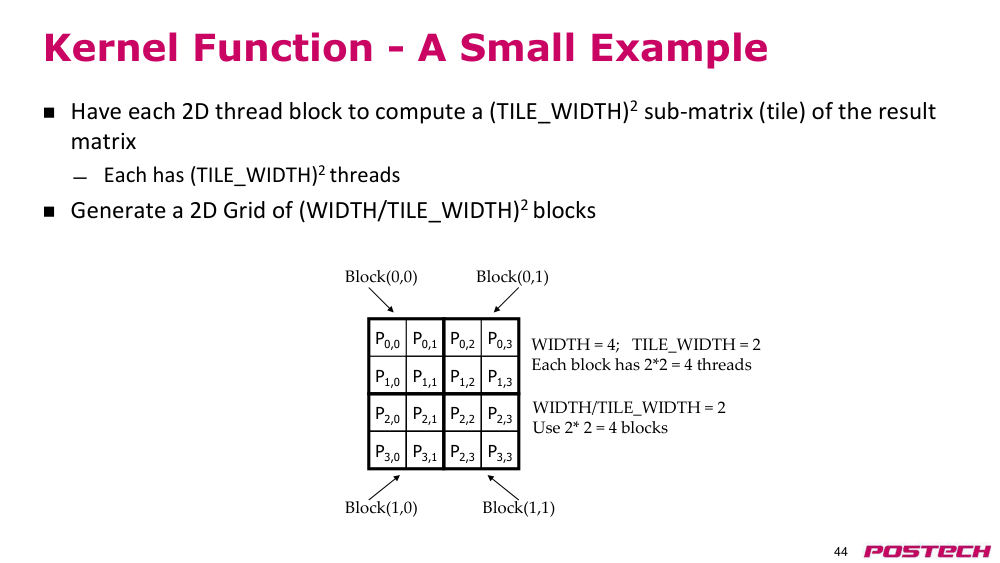
p.44kernel(커널) 함수 - 간단한 예제
- 각 2차원 thread block(스레드 블록)이 결과 행렬의 (TILE_WIDTH)² 부분 행렬(타일)을 계산
- 각 block(블록)은 (TILE_WIDTH)²개의 thread(스레드)를 가짐
- 크기 WIDTH/TILE_WIDTH의 2차원 grid(그리드)를 생성
- P0,1 P0,0 P1,0 P0,2 P0,3
- P1,1 P2,0 P2,2 P2,3 P2,1
- P1,3 P1,2 P3,0 P2,3 P3,3
- P3,1
- WIDTH = 4; TILE_WIDTH = 2
- 각 block(블록)은 2*2 = 4개의 thread(스레드)를 가짐
- WIDTH/TILE_WIDTH = 2
- 2*2 = 4개의 block(블록) 사용
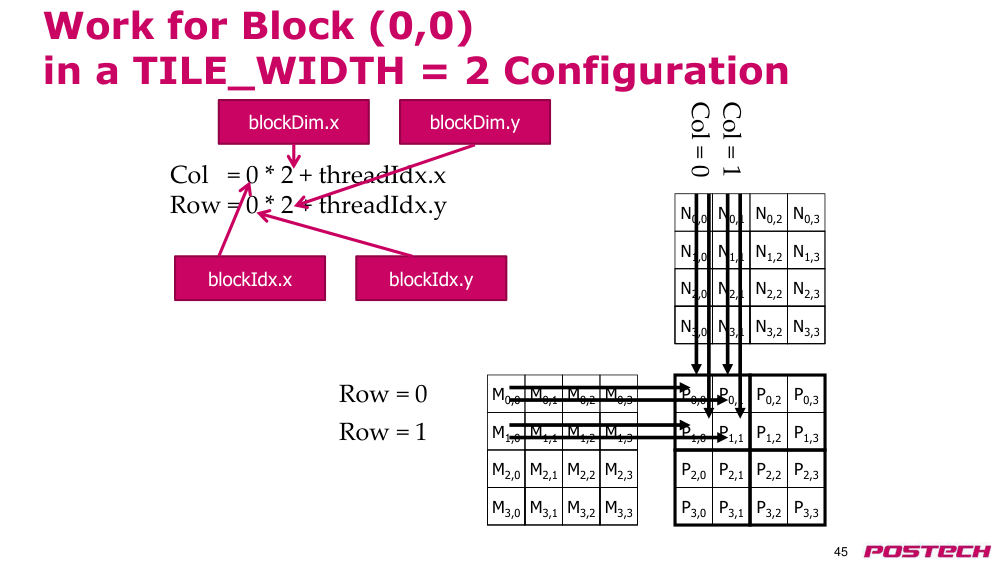
p.45블록 (0,0)에서의 작업 (TILE_WIDTH = 2 구성)
- Col = 0 * 2 + threadIdx.x
- Row = 0 * 2 + threadIdx.y
- Col = 0
- Col = 1
- Row = 0
- Row = 1
- blockIdx.x
- blockIdx.y
- blockDim.x
- blockDim.y
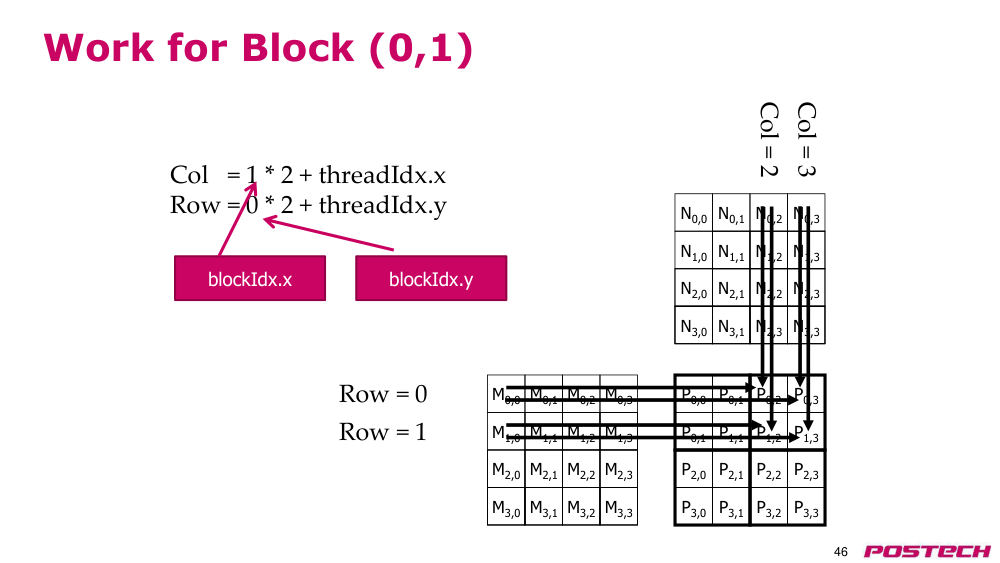
p.46블록 (0,1)에서의 작업
- Col = 1 * 2 + threadIdx.x
- Row = 0 * 2 + threadIdx.y
- Col = 2
- Col = 3
- Row = 0
- Row = 1
- blockIdx.x
- blockIdx.y
- M0,1 M0,0 M1,0 M0,2 M0,3
- M1,1 M2,0 M2,2 M2,3 M2,1
- M1,3 M1,2 M3,0 M3,2 M3,3
- M3,1
- N0,1 N0,0 N1,0 N0,2 N0,3
- N1,1 N2,0 N2,2 N2,3 N2,1
- N1,3 N1,2 N3,0 N2,3 N3,3
- N3,1
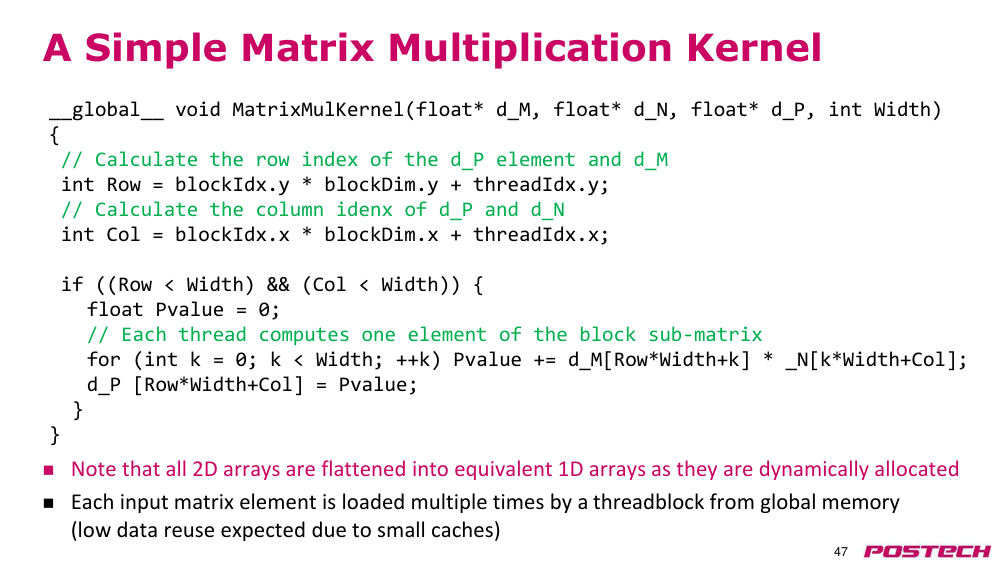
p.47간단한 행렬 곱셈 kernel(커널)
- 모든 2차원 배열은 동적으로 할당되므로 1차원 배열로 평탄화됨
- 각 입력 행렬 요소는 thread block(스레드 블록)에 의해 global memory(글로벌 메모리)에서 여러 번 로드됨
- (작은 캐시로 인해 데이터 재사용이 낮을 것으로 예상됨)
- __global__ void MatrixMulKernel(float* d_M, float* d_N, float* d_P, int Width)
- {
- // d_P 요소와 d_M의 행 인덱스 계산
- int Row = blockIdx.y * blockDim.y + threadIdx.y;
- // d_P와 d_N의 열 인덱스 계산
- int Col = blockIdx.x * blockDim.x + threadIdx.x;
- if ((Row < Width) && (Col < Width)) {
- float Pvalue = 0;
- // 각 thread(스레드)는 block(블록) 부분 행렬의 한 요소를 계산
- for (int k = 0; k < Width; ++k)
- Pvalue += d_M[Row*Width+k] * d_N[k*Width+Col];
- d_P[Row*Width+Col] = Pvalue;
- }
- }
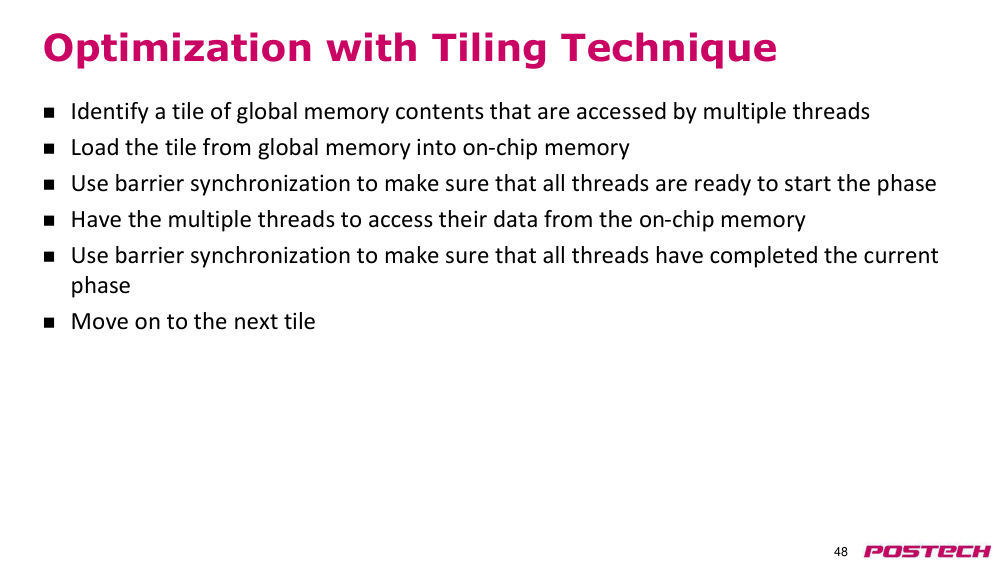
p.48타일링 기법을 통한 최적화
- 여러 thread(스레드)가 접근하는 global memory(글로벌 메모리) 내용의 타일 식별
- 타일을 global memory(글로벌 메모리)에서 온칩 메모리로 로드
- 모든 thread(스레드)가 다음 단계를 시작하기 전에 준비되었는지 확인하기 위해 장벽 synchronization(동기화) 사용
- 여러 thread(스레드)가 온칩 메모리에서 데이터에 접근하도록 함
- 모든 thread(스레드)가 현재 단계를 완료했는지 확인하기 위해 장벽 synchronization(동기화) 사용
- 다음 타일로 이동
p.49타일링 곱셈
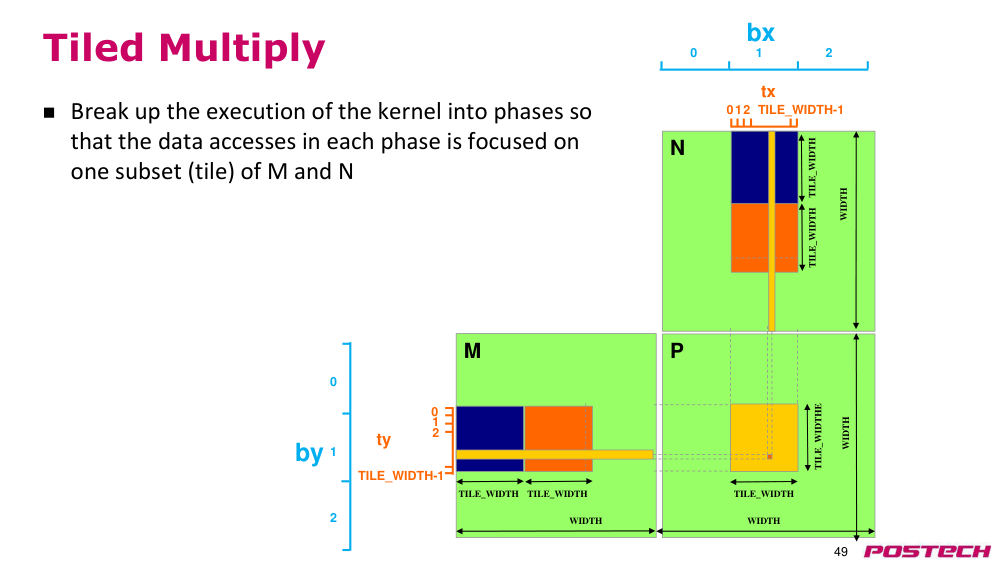
- kernel(커널)의 실행을 여러 단계로 나누어, 각 단계에서 M과 N의 한 부분 집합(타일)에 대한 데이터 접근을 집중시킨다.
- 타일의 크기는 TILE_WIDTH로 정의되며, M과 N의 각 차원은 WIDTH로 나누어 타일로 분할된다.
- 각 thread block(스레드 블록)은 타일을 기준으로 작업을 수행하며, threadidx(스레드 인덱스) tx와 ty는 타일 내의 위치를 나타낸다.
- blockidx(블록 인덱스) bx와 by는 block(블록)의 위치를 나타내며, 전체 grid(그리드) 내에서 타일의 배치를 결정한다.
p.50타일 로딩
- block(블록) 내 모든 thread(스레드)가 참여한다.
- 기준 타일링 코드에서는 각 thread(스레드)가 하나의 M 요소와 하나의 N 요소를 로딩한다.
- 각 thread(스레드)에 로딩된 요소를 할당할 때, 각 warp(워프) 내의 접근이 coalescing(병합)되도록 구성한다 (나중에 자세히 설명).
p.51블록 (0,0)의 0단계 로딩
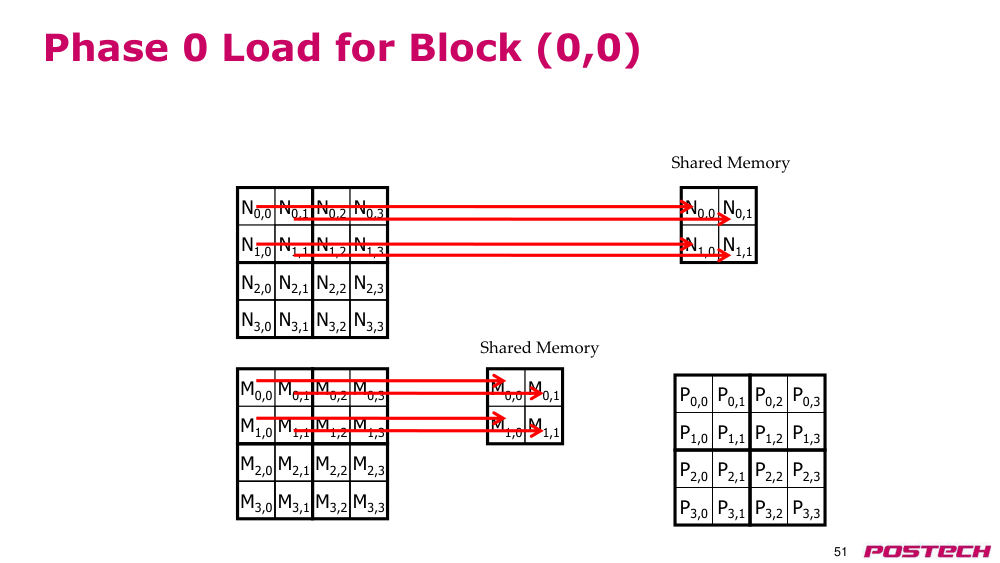
- 블록 (0,0)의 0단계 로딩에서, M과 N의 타일이 shared memory(공유 메모리)에 로딩된다.
- M0,0부터 M3,3까지의 요소와 N0,0부터 N3,3까지의 요소가 shared memory(공유 메모리)에 저장된다.
- 결과적으로 P 행렬의 일부인 P0,0부터 P3,3까지의 위치에 대한 계산을 위한 데이터가 준비된다.
- shared memory(공유 메모리)에 로딩된 데이터는 이후 단계에서 재사용되어 성능을 향상시킨다.
p.52블록 (0,0)의 0단계 사용 (반복 0)
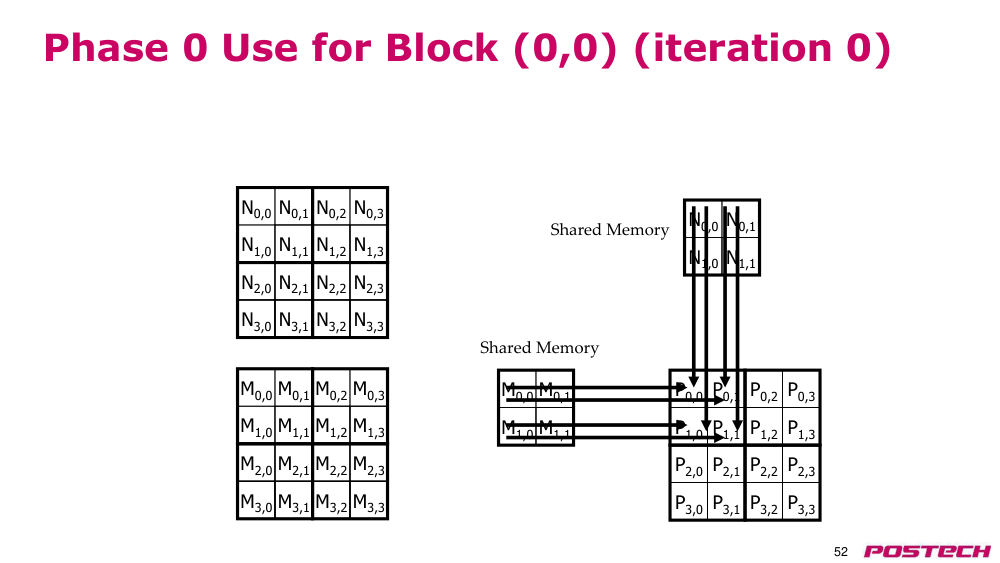
- shared memory(공유 메모리)에 로딩된 M과 N의 타일을 사용하여 P 행렬의 일부를 계산한다.
- P0,0부터 P3,3까지의 요소를 계산하기 위해 M과 N의 요소를 곱하고 누적한다.
- 이 단계에서는 M과 N의 타일이 shared memory(공유 메모리)에 이미 존재하므로, global memory(글로벌 메모리) 접근이 최소화된다.
- shared memory(공유 메모리)의 사용은 데이터 재사용을 통해 성능을 향상시킨다.
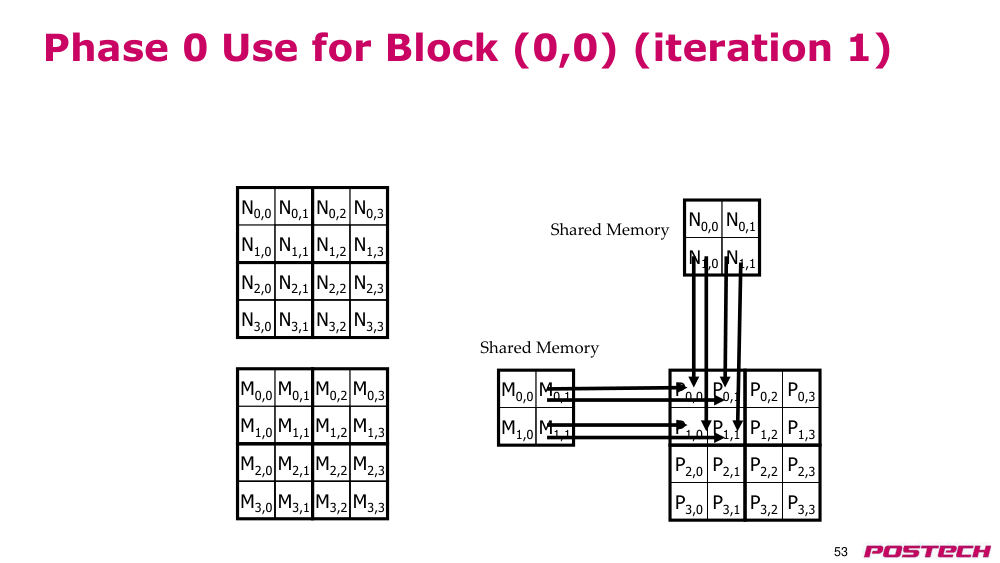
p.53블록 (0,0)의 0단계 사용 (반복 1)
- 이 단계는 0단계 사용의 반복이며, shared memory(공유 메모리)에 저장된 M과 N의 타일을 다시 사용한다.
- P 행렬의 다른 요소들을 계산하기 위해 M과 N의 다른 요소 조합을 활용한다.
- shared memory(공유 메모리)에 데이터가 이미 존재하므로, 추가적인 global memory(글로벌 메모리) 접근이 필요하지 않다.
- 이러한 반복적 사용은 타일링 기법의 핵심적인 성능 이점이다.
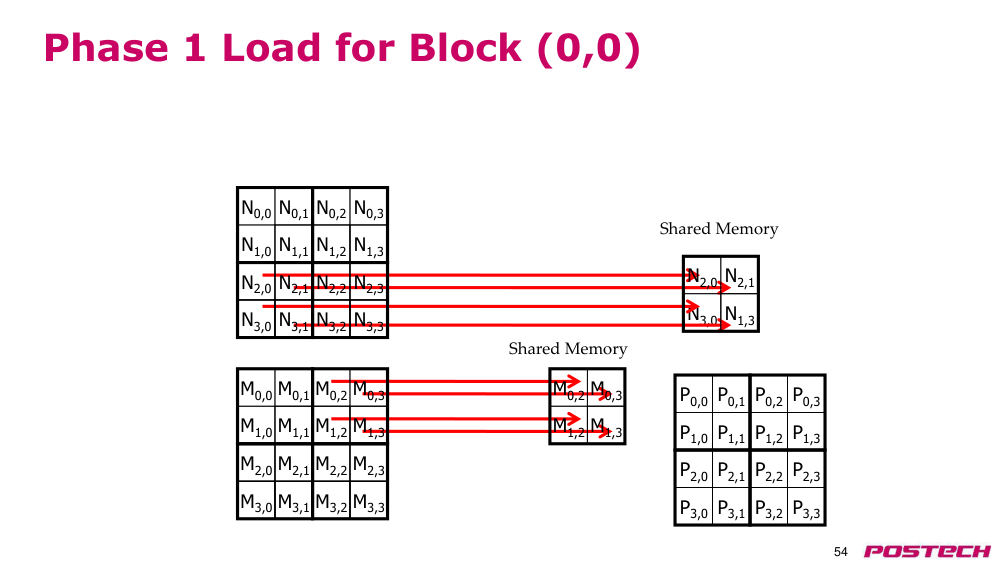
p.54블록 (0,0)의 1단계 로딩
- 1단계 로딩에서는 다음 타일을 shared memory(공유 메모리)에 로딩한다.
- M 행렬의 M0,2와 M0,3, M1,2와 M1,3 요소가 로딩되며, N 행렬의 N2,0과 N2,1, N1,3 요소가 로딩된다.
- 이러한 로딩은 다음 반복에서 사용할 데이터를 준비한다.
- shared memory(공유 메모리)에 새로운 타일이 로딩되면서, 이전 타일은 더 이상 필요하지 않게 된다.
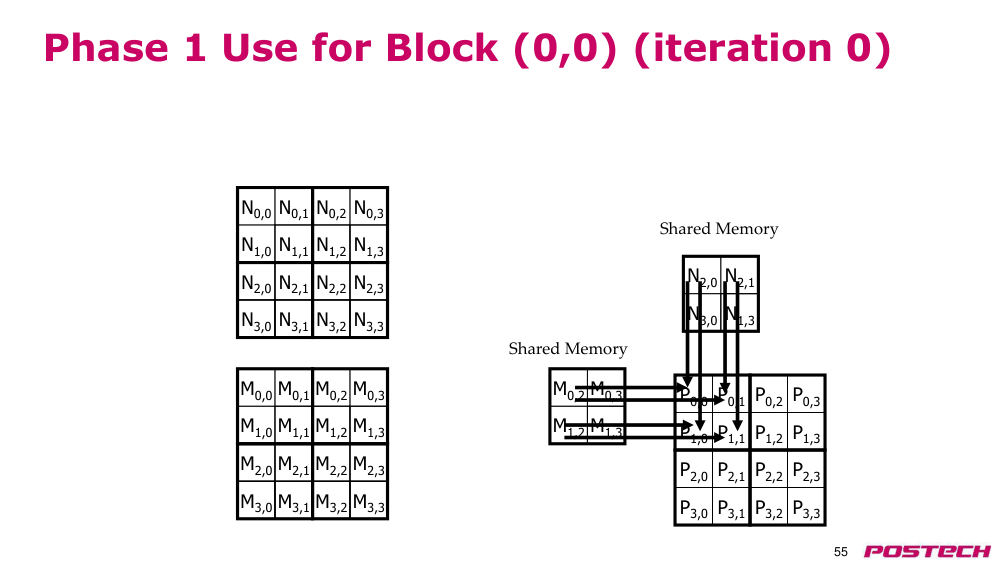
p.55블록 (0,0)의 1단계 사용 (반복 0)
- M0,1
- M0,0
- M1,0
- M0,2 M0,3
- M1,1
- M2,0
- M2,2 M2,3
- M2,1
- M1,3
- M1,2
- M3,0
- M3,2 M3,3
- M3,1
- N0,1
- N0,0
- N1,0
- N0,2 N0,3
- N1,1
- N2,0
- N2,2 N2,3
- N2,1
- N1,3
- N1,2
- N3,0
- N3,2 N3,3
- N3,1
- P0,1
- P0,0
- P1,0
- P0,2 P0,3
- P1,1
- P2,0
- P2,2 P2,3
- P2,1
- P1,3
- P1,2
- P3,0
- P3,2 P3,3
- P3,1
- N3,0
- M0,3
- M0,2
- M1,2 M1,3
- N2,1
- N2,0
- N1,3
- shared memory(공유 메모리)
- shared memory(공유 메모리)
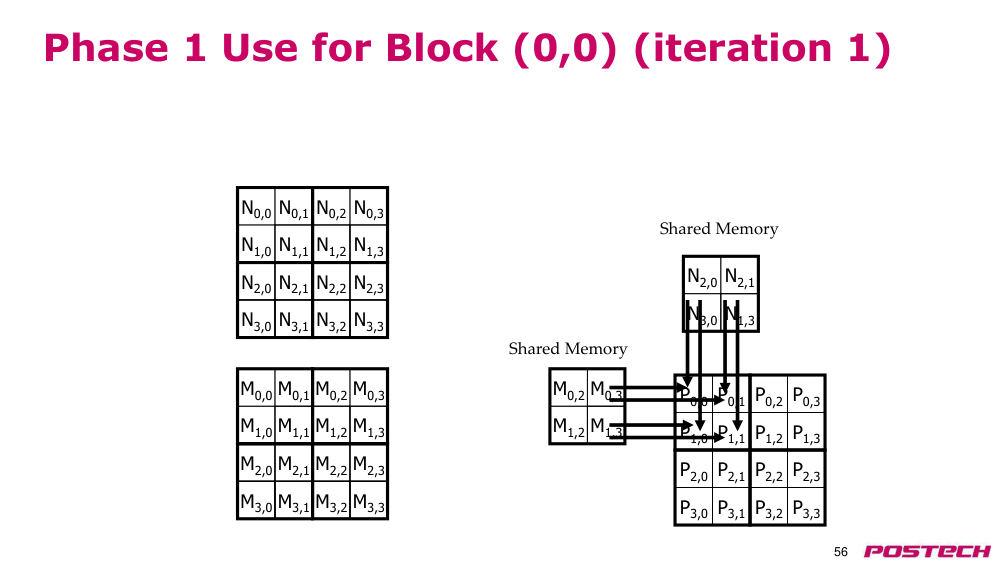
p.56블록 (0,0)의 1단계 사용 (반복 1)
- M0,1
- M0,0
- M1,0
- M0,2 M0,3
- M1,1
- M2,0
- M2,2 M2,3
- M2,1
- M1,3
- M1,2
- M3,0
- M3,2 M3,3
- M3,1
- N0,1
- N0,0
- N1,0
- N0,2 N0,3
- N1,1
- N2,0
- N2,2 N2,3
- N2,1
- N1,3
- N1,2
- N3,0
- N3,2 N3,3
- N3,1
- P0,1
- P0,0
- P1,0
- P0,2 P0,3
- P1,1
- P2,0
- P2,2 P2,3
- P2,1
- P1,3
- P1,2
- P3,0
- P3,2 P3,3
- P3,1
- N3,0
- M0,3
- M0,2
- M1,2 M1,3
- N2,1
- N2,0
- N1,3
- shared memory(공유 메모리)
- shared memory(공유 메모리)
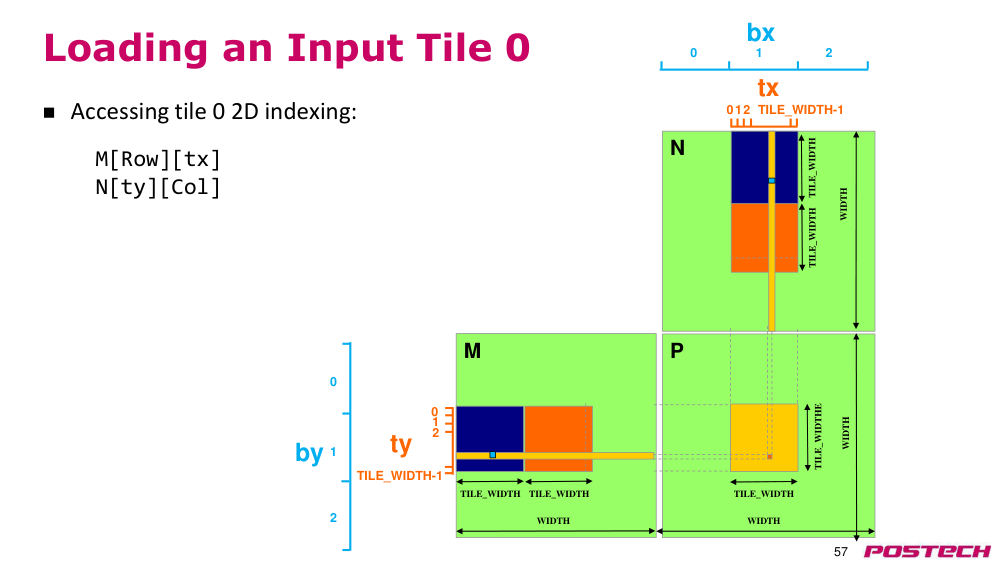
p.57입력 타일 0 로딩
- 타일 0에 대한 2차원 인덱싱 접근:
- M
- N
- P
- TILE_WIDTH
- TILE_WIDTH
- TILE_WIDTH
- tx
- 01
- TILE_WIDTH-1
- 2
- 2
- 1
- 0
- TILE_WIDTH
- TILE_WIDTH
- TILE_WIDTHE
- M[Row][tx]
- N[ty][Col]
- WIDTH
- WIDTH
- WIDTH
- WIDTH
- bx
- 0
- 1
- 2
- by
- 2
- 1
- 0
- ty
- TILE_WIDTH-1
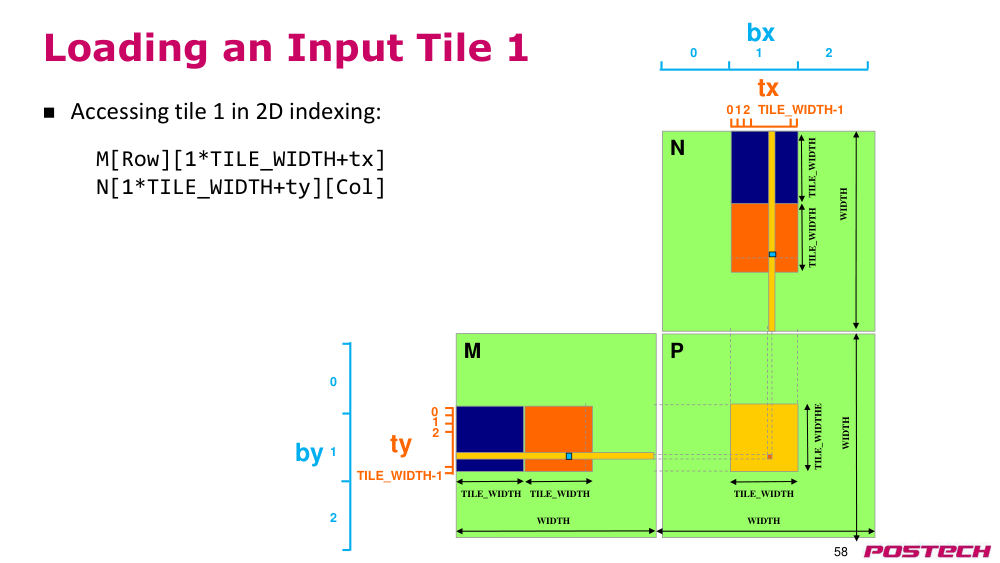
p.58입력 타일 1 로딩
- 2차원 인덱싱에서 타일 1에 대한 접근:
- M
- N
- P
- TILE_WIDTH
- TILE_WIDTH
- TILE_WIDTH
- 01
- TILE_WIDTH-1
- 2
- 2
- 1
- 0
- TILE_WIDTH
- TILE_WIDTH
- TILE_WIDTHE
- WIDTH
- WIDTH
- M[Row][1*TILE_WIDTH+tx]
- N[1*TILE_WIDTH+ty][Col]
- WIDTH
- WIDTH
- bx
- 0
- 1
- 2
- by
- 2
- 1
- 0
- ty
- TILE_WIDTH-1
- tx
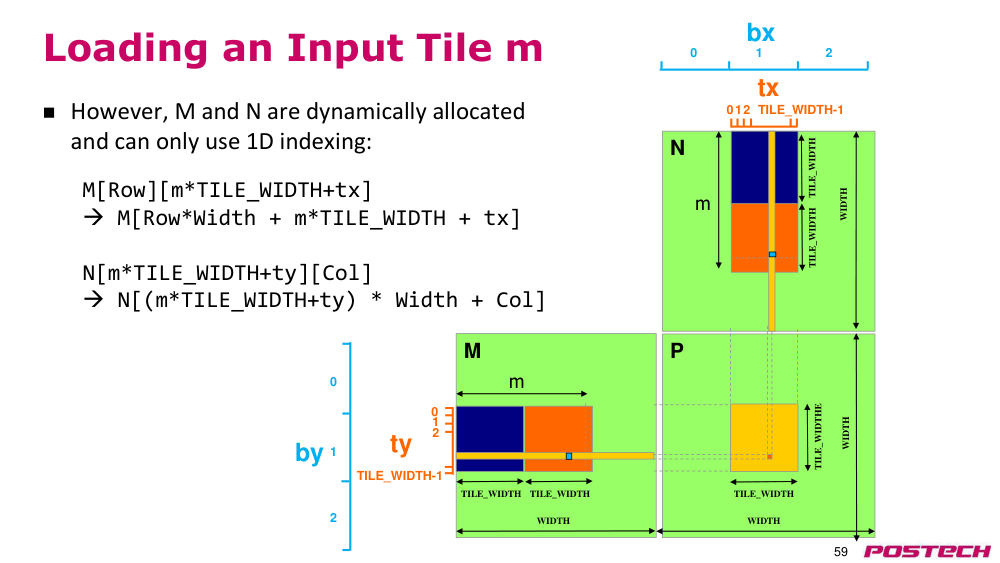
p.59입력 타일 m 로딩
- 그러나 M과 N은 동적으로 할당되며 1차원 인덱싱만 사용 가능:
- M
- N
- P
- TILE_WIDTH
- WIDTH
- WIDTH
- TILE_WIDTH
- TILE_WIDTH
- bx
- 01
- TILE_WIDTH-1
- 2
- 0
- 1
- 2
- by
- ty
- 2
- 1
- 0
- TILE_WIDTH-1
- 2
- 1
- 0
- TILE_WIDTH
- TILE_WIDTH
- TILE_WIDTHE
- WIDTH
- WIDTH
- M[Row][m*TILE_WIDTH+tx]
- →M[Row*Width + m*TILE_WIDTH + tx]
- N[m*TILE_WIDTH+ty][Col]
- →N[(m*TILE_WIDTH+ty) * Width + Col]
- m
- m
- tx
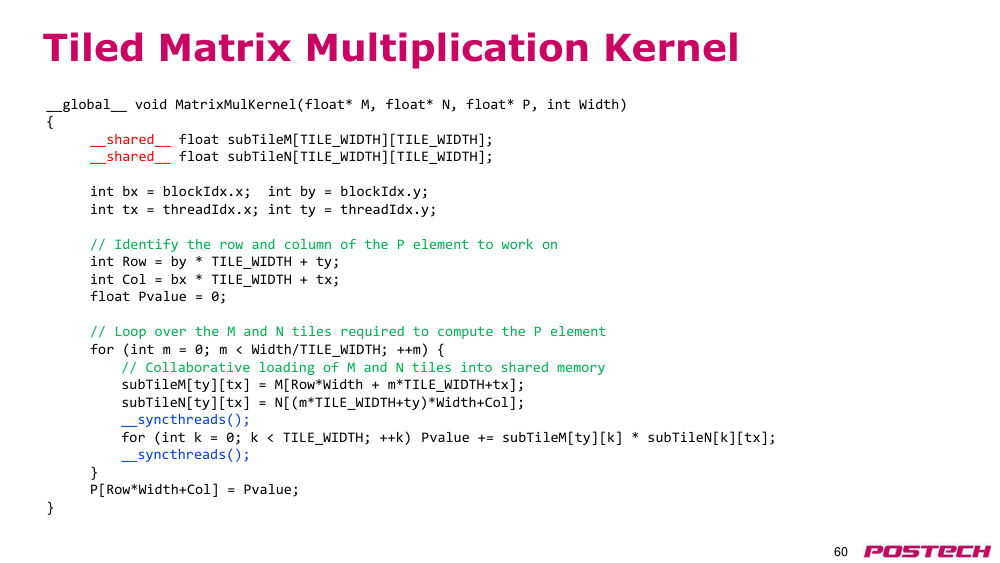
p.60타일 행렬 곱셈 kernel(커널)
- __global__ void MatrixMulKernel(float* M, float* N, float* P, int Width)
- {
- __shared__ float subTileM[TILE_WIDTH][TILE_WIDTH];
- __shared__ float subTileN[TILE_WIDTH][TILE_WIDTH];
- int bx = blockIdx.x; int by = blockIdx.y;
- int tx = threadIdx.x; int ty = threadIdx.y;
- // P 요소를 계산할 행과 열 식별
- int Row = by * TILE_WIDTH + ty;
- int Col = bx * TILE_WIDTH + tx;
- float Pvalue = 0;
- // P 요소를 계산하기 위해 필요한 M과 N 타일을 반복
- for (int m = 0; m < Width/TILE_WIDTH; ++m) {
- // M과 N 타일을 shared memory(공유 메모리)로 협동적으로 로딩
- subTileM[ty][tx] = M[Row*Width + m*TILE_WIDTH+tx];
- subTileN[ty][tx] = N[(m*TILE_WIDTH+ty)*Width+Col];
- __syncthreads();
- // 행렬 곱셈 수행
- for (int k = 0; k < TILE_WIDTH; ++k) Pvalue += subTileM[ty][k] * subTileN[k][tx];
- __syncthreads();
- }
- P[Row*Width+Col] = Pvalue;
- }
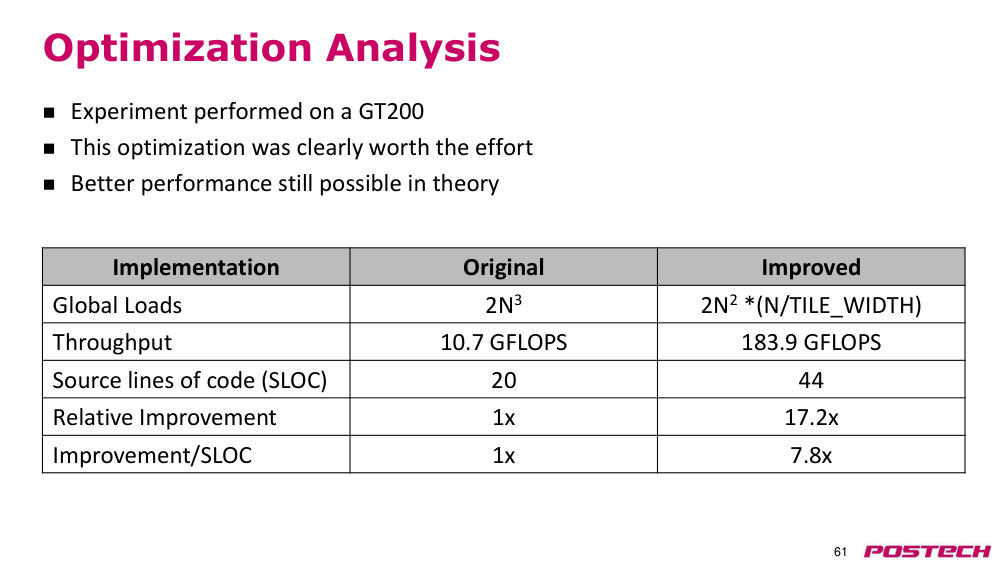
p.61최적화 분석
- GT200에서 수행된 실험
- 이 최적화는 분명한 노력의 가치가 있었다
- 이론적으로는 더 나은 성능이 가능하다
- 구현
- 원본: 글로벌 로드 = 2N³, throughput(처리량) = 10.7 GFLOPS, 소스 줄 수(SLOC) = 20
- 개선된 버전: 글로벌 로드 = 2N² × (N/TILE_WIDTH), throughput(처리량) = 183.9 GFLOPS, 소스 줄 수(SLOC) = 44
- 상대적 개선: 1x → 17.2x
- 개선/줄 수: 1x → 7.8x
p.62shared memory(공유 메모리)를 활용한 더 많은 최적화
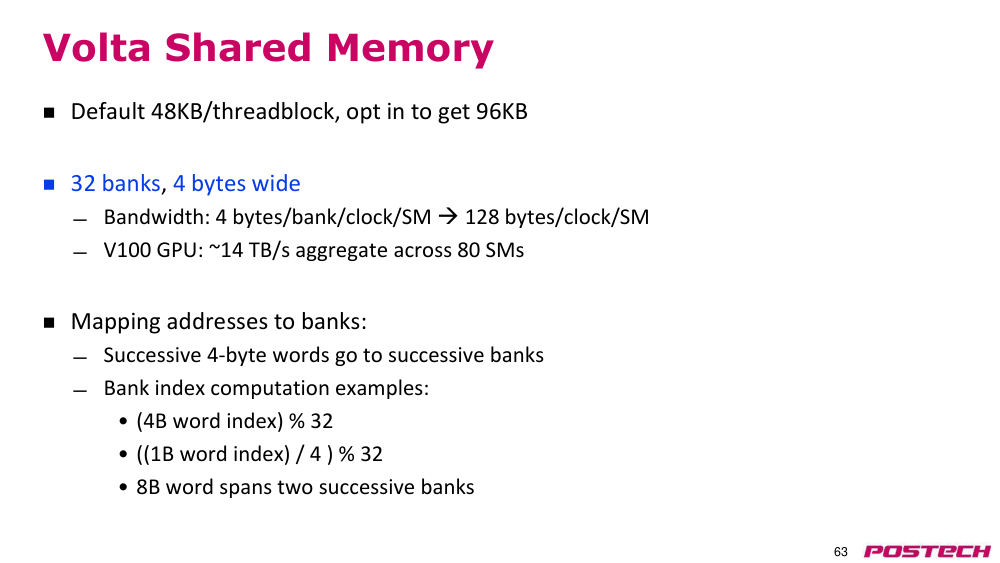
p.63Volta shared memory(공유 메모리)
- 기본값: thread block(스레드 블록)당 48KB, 96KB 사용을 위해 옵트인 필요
- 32개의 bank(뱅크), 4바이트 너비
- bandwidth(대역폭): 4바이트/bank(뱅크)/클럭/SM → 128바이트/클럭/SM
- V100 GPU: 80개의 SM을 통해 약 14 TB/s의 집계 bandwidth(대역폭)
- 주소를 bank(뱅크)에 매핑하는 방식:
- 연속적인 4바이트 단위는 연속적인 bank(뱅크)에 할당됨
- bank(뱅크) 인덱스 계산 예시:
- • (4바이트 단어 인덱스) % 32
- • ((1바이트 단어 인덱스) / 4) % 32
- • 8바이트 단어는 두 개의 연속 bank(뱅크)를 가로지름
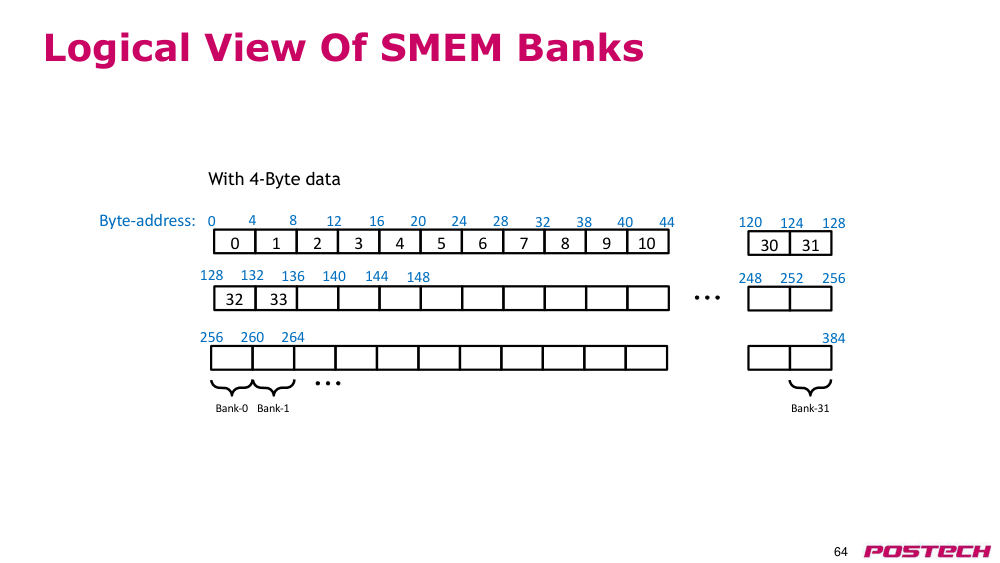
p.64shared memory(공유 메모리) bank(뱅크)의 논리적 보기
- bank(뱅크)-0 bank(뱅크)-1
- bank(뱅크)-31
- 384
- 128
- 132
- 136
- 140
- 144
- 256
- 260
- 264
- 30
- 31
- 바이트 주소: 0
- 4
- 8
- 12
- 16
- 20
- 24
- 28
- 32
- 38
- 40
- 44
- 120
- 124
- 128
- 148
- 248
- 252
- 256
- 4-바이트 데이터를 가진 경우
- 0
- 1
- 2
- 3
- 4
- 5
- 8
- 9
- 10
- 6
- 7
- 32
- 33
- 논리적 보기
p.65shared memory(공유 메모리) bank(뱅크) 충돌
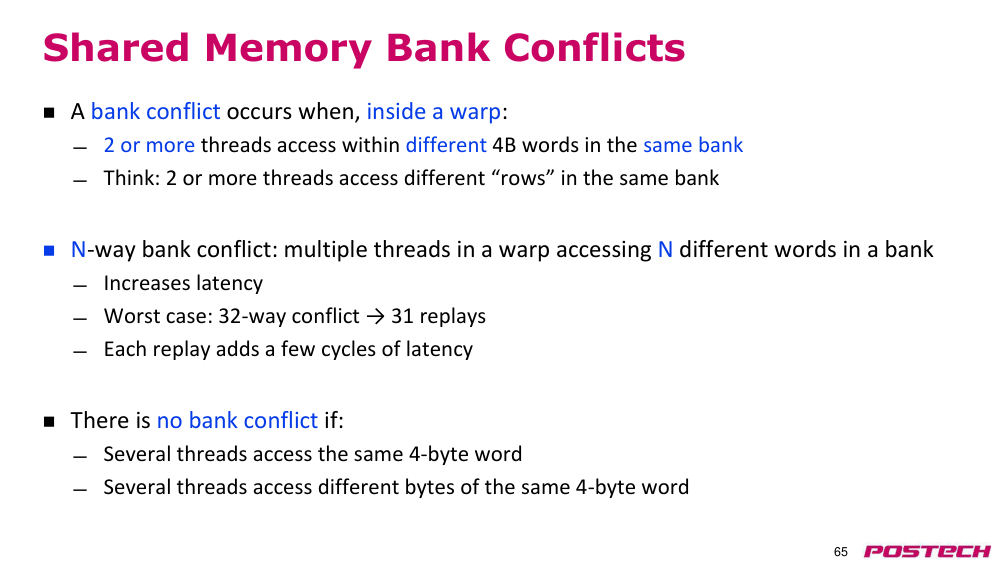
- warp(워프) 내에서 다음 조건이 발생할 때 bank(뱅크) 충돌이 발생함:
- • 동일한 bank(뱅크) 내에서 서로 다른 4바이트 단어에 접근하는 2개 이상의 thread(스레드)
- • 동일한 bank(뱅크) 내에서 서로 다른 '행'에 접근하는 것으로 생각할 수 있음
- • N-way bank(뱅크) 충돌: warp(워프) 내 여러 thread(스레드)가 동일한 bank(뱅크)의 N개의 서로 다른 단어에 접근
- • latency(지연 시간) 증가
- • 최악의 경우: 32-way bank(뱅크) 충돌 → 31회 재시도
- • 각 재시도는 몇 사이클의 latency(지연 시간)을 추가
- • 다음 조건에서는 bank(뱅크) 충돌이 발생하지 않음:
- • 여러 thread(스레드)가 동일한 4바이트 단어에 접근
- • 여러 thread(스레드)가 동일한 4바이트 단어의 서로 다른 바이트에 접근
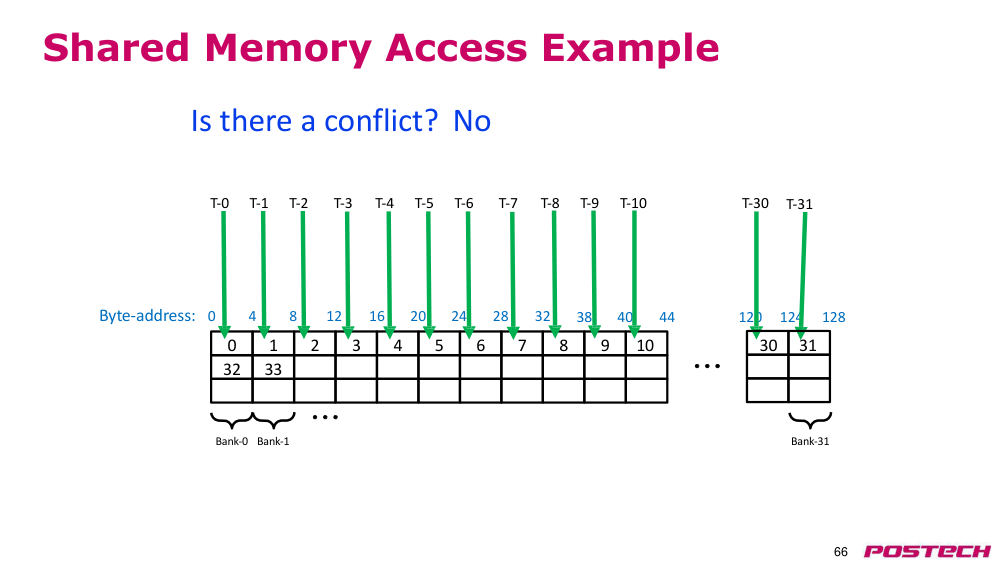
p.66shared memory(공유 메모리) 접근 예제
- 0
- 1
- 32
- 33
- bank(뱅크)-0 bank(뱅크)-1
- 2
- 3
- 4
- 5
- 8
- 9
- 10
- 6
- 7
- 바이트 주소: 0
- 4
- 8
- 12
- 16
- 20
- 24
- 28
- 32
- 44
- bank(뱅크)-31
- 38
- 40
- 120
- 124
- 128
- T-0
- T-1
- T-2
- T-3
- T-4
- T-5
- T-6
- T-7
- T-8
- T-9
- T-10
- T-30
- T-31
- 30
- 31
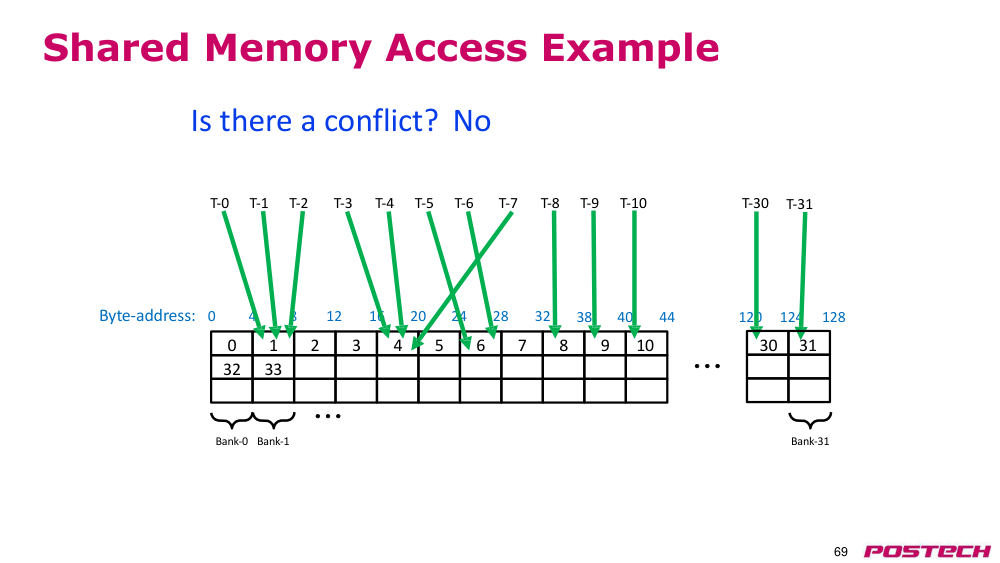
- 충돌이 발생하는가? 아니요
p.67shared memory(공유 메모리) 접근 예제
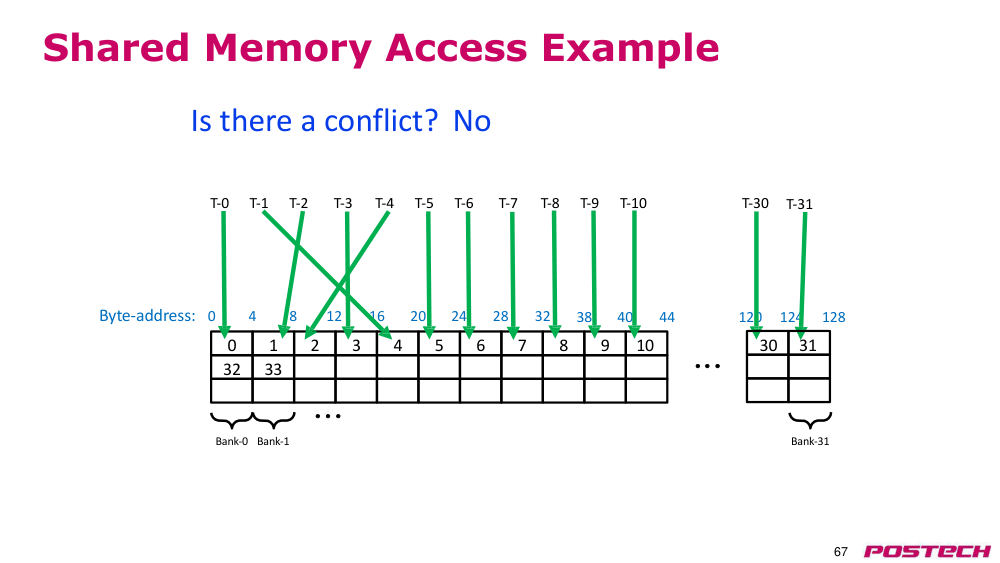
- 각 thread(스레드)가 shared memory(공유 메모리)의 서로 다른 bank(뱅크)에 접근하고 있습니다.
- T-0는 bank(뱅크) 0에 접근하고, T-1은 bank(뱅크) 1에 접근합니다.
- 이 접근은 동시에 발생할 수 있으므로 충돌이 없습니다.
- 결과: 충돌 없음
p.68shared memory(공유 메모리) 접근 예제
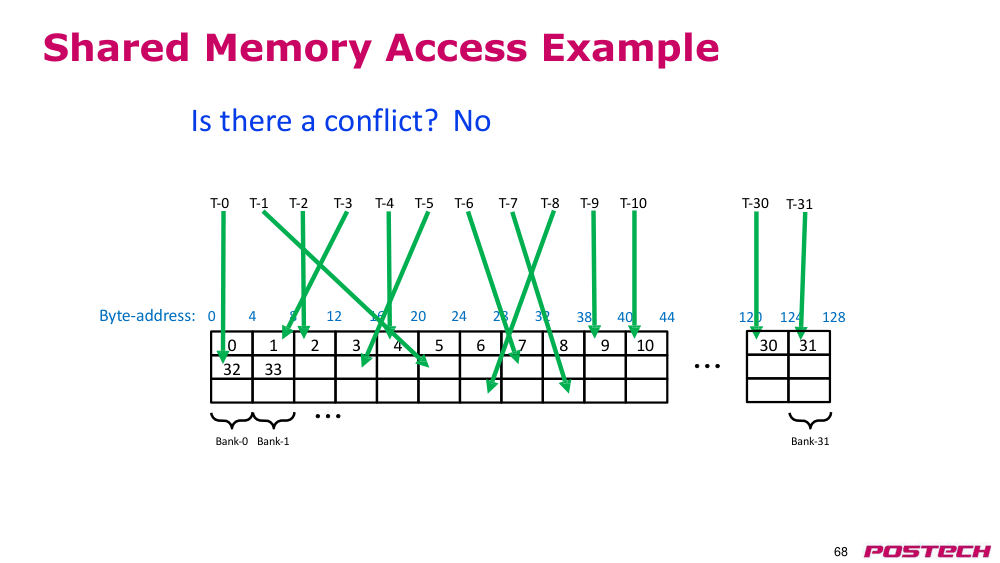
- 각 thread(스레드)가 shared memory(공유 메모리)의 서로 다른 bank(뱅크)에 접근하고 있습니다.
- T-0는 bank(뱅크) 0에 접근하고, T-1은 bank(뱅크) 1에 접근합니다.
- 이 접근은 동시에 발생할 수 있으므로 충돌이 없습니다.
- 결과: 충돌 없음
p.69shared memory(공유 메모리) 접근 예제
- 각 thread(스레드)가 shared memory(공유 메모리)의 서로 다른 bank(뱅크)에 접근하고 있습니다.
- T-0는 bank(뱅크) 0에 접근하고, T-1은 bank(뱅크) 1에 접근합니다.
- 이 접근은 동시에 발생할 수 있으므로 충돌이 없습니다.
- 결과: 충돌 없음
p.70shared memory(공유 메모리) 접근 예제
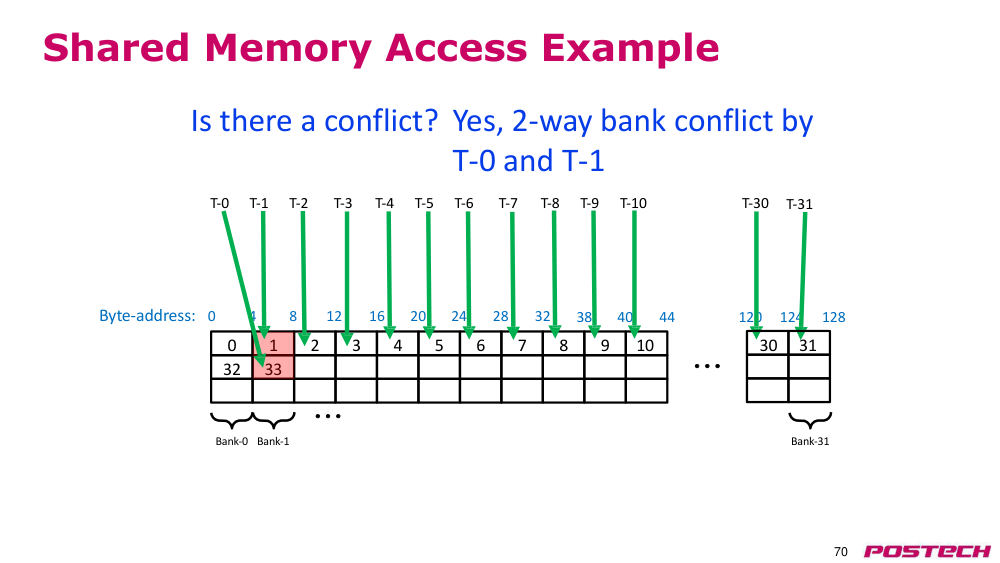
- T-0과 T-1이 동일한 bank(뱅크) 0에 동시에 접근하고 있습니다.
- 이로 인해 2-way bank(뱅크) 충돌이 발생합니다.
- 결과: 충돌 있음 (T-0과 T-1에 의한 2-way bank(뱅크) 충돌)
p.71shared memory(공유 메모리) 접근 예제
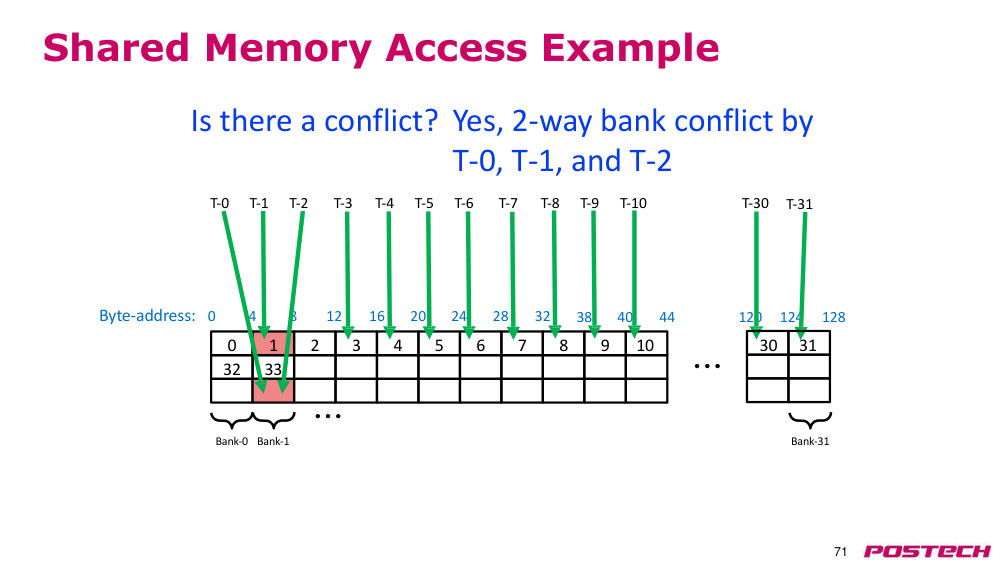
- T-0, T-1, T-2가 동일한 bank(뱅크) 0에 동시에 접근하고 있습니다.
- 이로 인해 2-way bank(뱅크) 충돌이 발생합니다.
- 결과: 충돌 있음 (T-0, T-1, T-2에 의한 2-way bank(뱅크) 충돌)
p.72shared memory(공유 메모리) 접근 예제
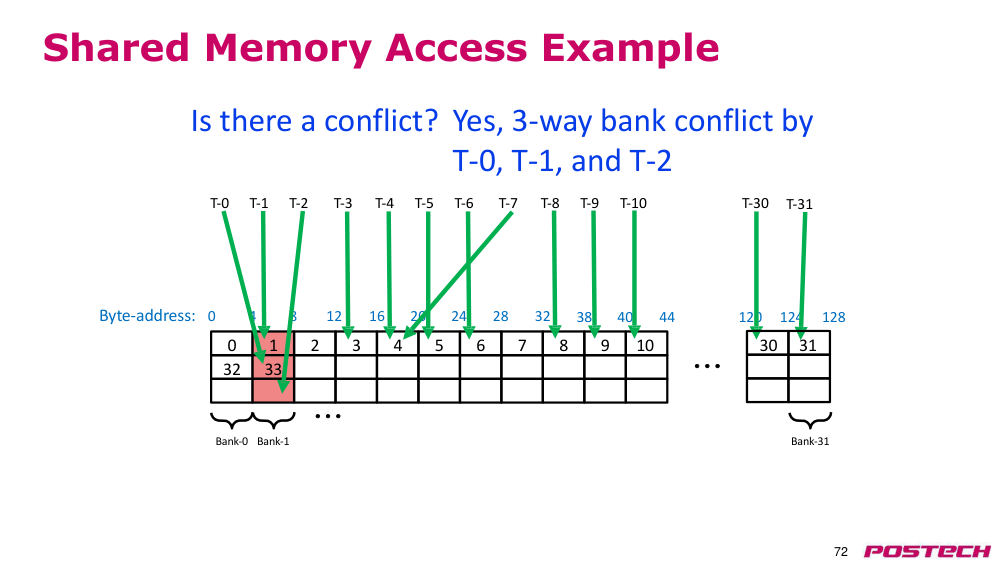
- T-0, T-1, T-2가 동일한 bank(뱅크) 0에 동시에 접근하고 있습니다.
- 이로 인해 3-way bank(뱅크) 충돌이 발생합니다.
- 결과: 충돌 있음 (T-0, T-1, T-2에 의한 3-way bank(뱅크) 충돌)
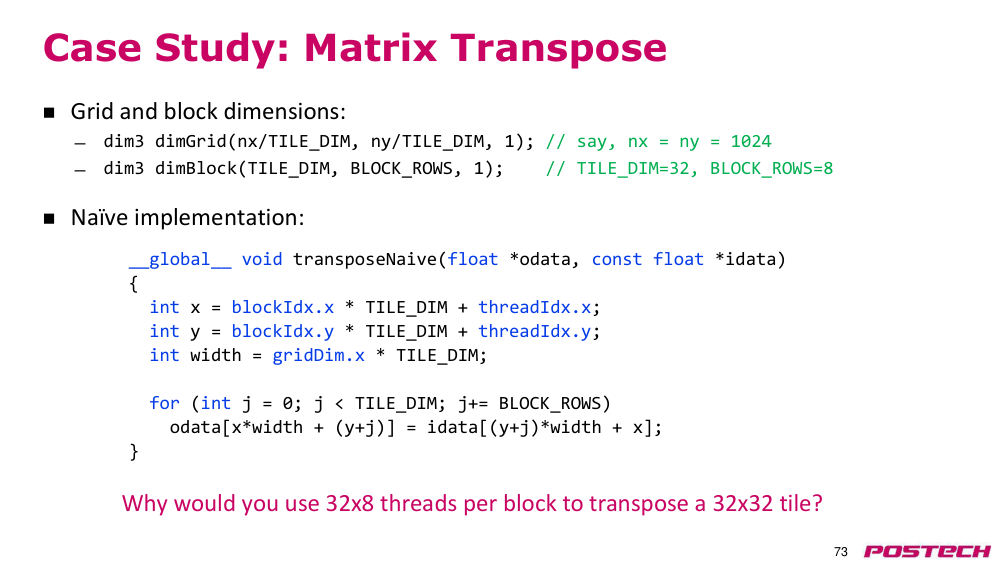
p.73사례 연구: 행렬 전치
- grid(그리드) 및 block dimensions(블록 차원):
- dim3 dimGrid(nx/TILE_DIM, ny/TILE_DIM, 1); // 예: nx = ny = 1024
- dim3 dimBlock(TILE_DIM, BLOCK_ROWS, 1); // TILE_DIM=32, BLOCK_ROWS=8
- 비효율적인 구현:
- __global__ void transposeNaive(float *odata, const float *idata)
- {
- int x = blockIdx.x * TILE_DIM + threadIdx.x;
- int y = blockIdx.y * TILE_DIM + threadIdx.y;
- int width = gridDim.x * TILE_DIM;
- for (int j = 0; j < TILE_DIM; j+= BLOCK_ROWS)
- odata[x*width + (y+j)] = idata[(y+j)*width + x];
- }
- 32x8 thread(스레드)를 block(블록)당 사용하여 32x32 타일을 전치하는 이유는 무엇인가요?
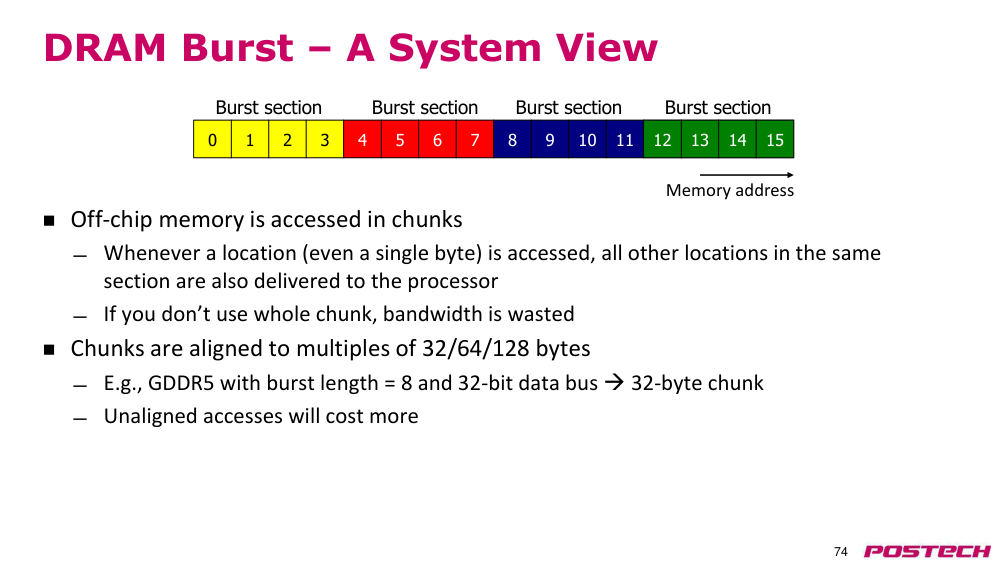
p.74DRAM 버스트 – 시스템 관점
- 온칩 외부 메모리는 청크 단위로 접근됩니다.
- 어떤 위치(단일 바이트라도)에 접근할 때, 해당 섹션 내 모든 위치의 데이터도 프로세서로 전달됩니다.
- 전체 청크를 사용하지 않으면 bandwidth(대역폭)이 낭비됩니다.
- 청크는 32/64/128바이트의 배수로 정렬됩니다.
- 예: GDDR5, 버스트 길이 = 8, 32비트 데이터 버스 → 32바이트 청크
- 비정렬 접근은 더 높은 비용을 수반합니다.
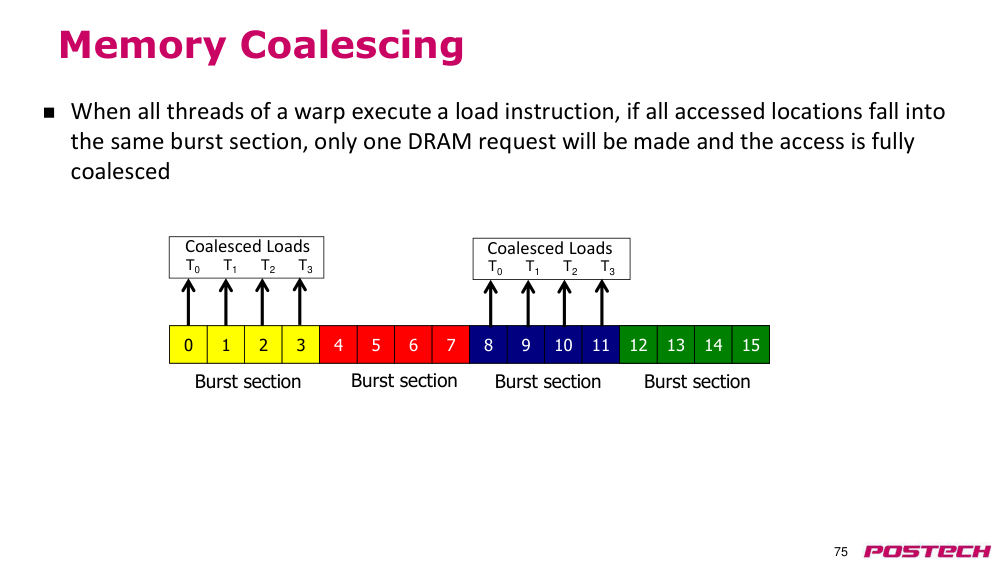
p.75memory coalescing(메모리 병합)
- warp(워프)의 모든 thread(스레드)가 로드 명령을 실행할 때, 접근한 위치들이 동일한 버스트 섹션에 속하면, DRAM 요청은 단 하나만 발생하며 접근은 완전히 coalescing(병합)됩니다.
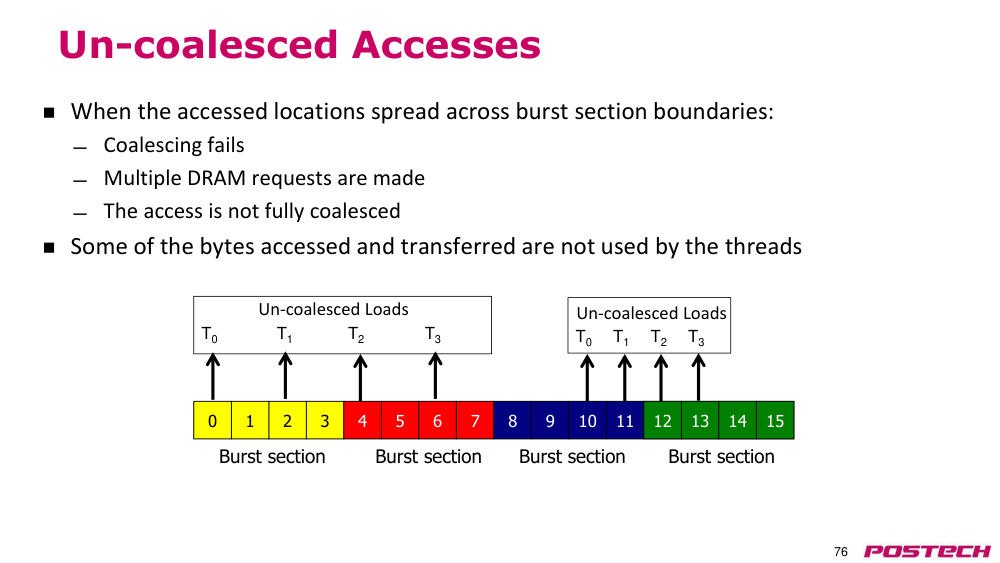
p.76uncoalesced access(비병합 접근)
- 접근 위치들이 버스트 섹션 경계를 넘어서 퍼져 있을 경우:
- coalescing(병합)이 실패합니다.
- 여러 개의 DRAM 요청이 발생합니다.
- 접근은 완전히 coalescing(병합)되지 않습니다.
- thread(스레드)가 사용하지 않는 일부 바이트도 접근 및 전송됩니다.
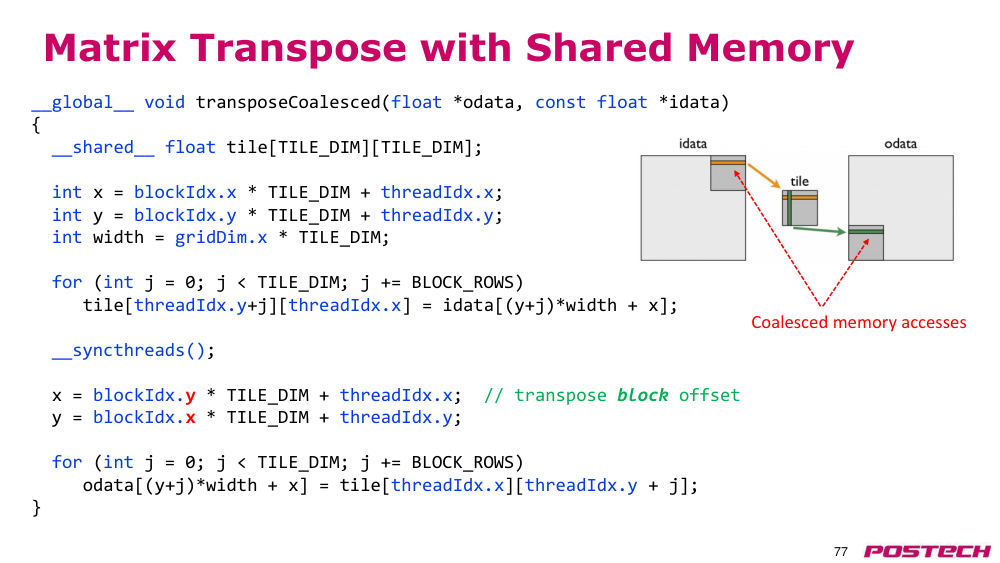
p.77shared memory(공유 메모리)를 사용한 행렬 전치
- __global__ void transposeCoalesced(float *odata, const float *idata)
- {
- __shared__ float tile[TILE_DIM][TILE_DIM];
- int x = blockIdx.x * TILE_DIM + threadIdx.x;
- int y = blockIdx.y * TILE_DIM + threadIdx.y;
- int width = gridDim.x * TILE_DIM;
- for (int j = 0; j < TILE_DIM; j += BLOCK_ROWS)
- tile[threadIdx.y+j][threadIdx.x] = idata[(y+j)*width + x];
- __syncthreads();
- x = blockIdx.y * TILE_DIM + threadIdx.x; // 전치 블록 오프셋
- y = blockIdx.x * TILE_DIM + threadIdx.y;
- for (int j = 0; j < TILE_DIM; j += BLOCK_ROWS)
- odata[(y+j)*width + x] = tile[threadIdx.x][threadIdx.y + j];
- }
- coalesced memory access(병합된 메모리 접근)
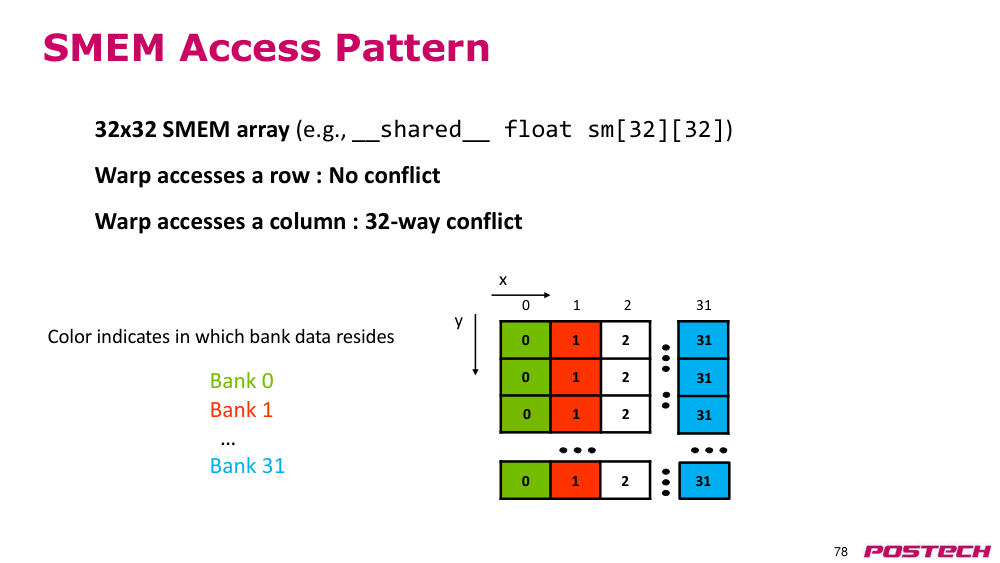
p.7832x32 SMEM 배열 (예: __shared__ float sm[32][32])
- warp(워프)가 행에 접근: 충돌 없음
- warp(워프)가 열에 접근: 32-way bank(뱅크) 충돌
- bank(뱅크) 0
- bank(뱅크) 1
- ...
- bank(뱅크) 31
- x
- y
- SMEM 접근 패턴
- 색상은 데이터가 저장된 bank(뱅크)를 나타냅니다.
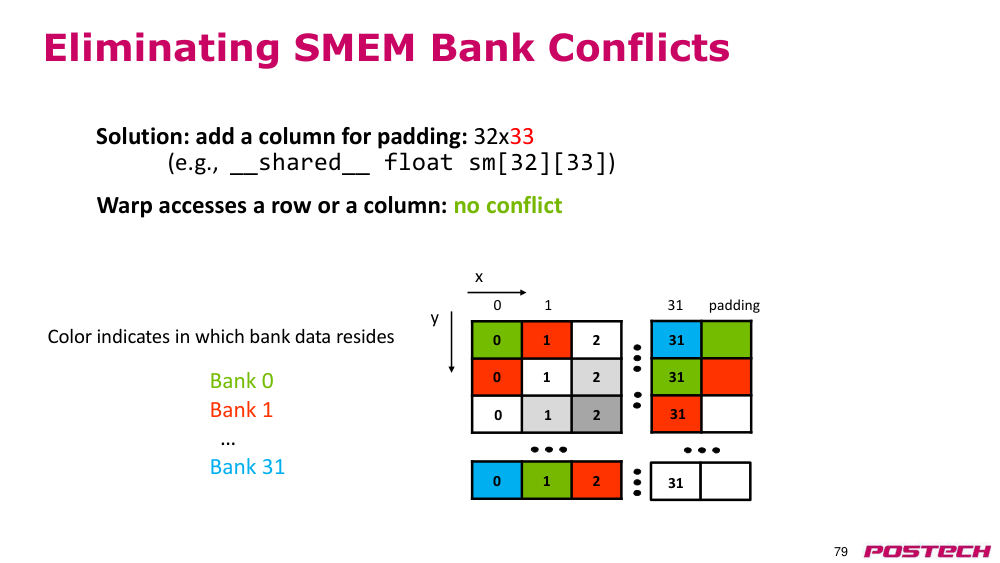
p.79shared memory(공유 메모리) bank(뱅크) 충돌 제거
- 패딩을 위한 열 추가: 32x33 (예: __shared__ float sm[32][33])
- warp(워프)는 행 또는 열에 접근: 충돌 없음
- bank(뱅크) 0
- bank(뱅크) 1
- ...
- bank(뱅크) 31
- 색은 데이터가 어느 bank(뱅크)에 존재하는지 나타냄
- 패딩
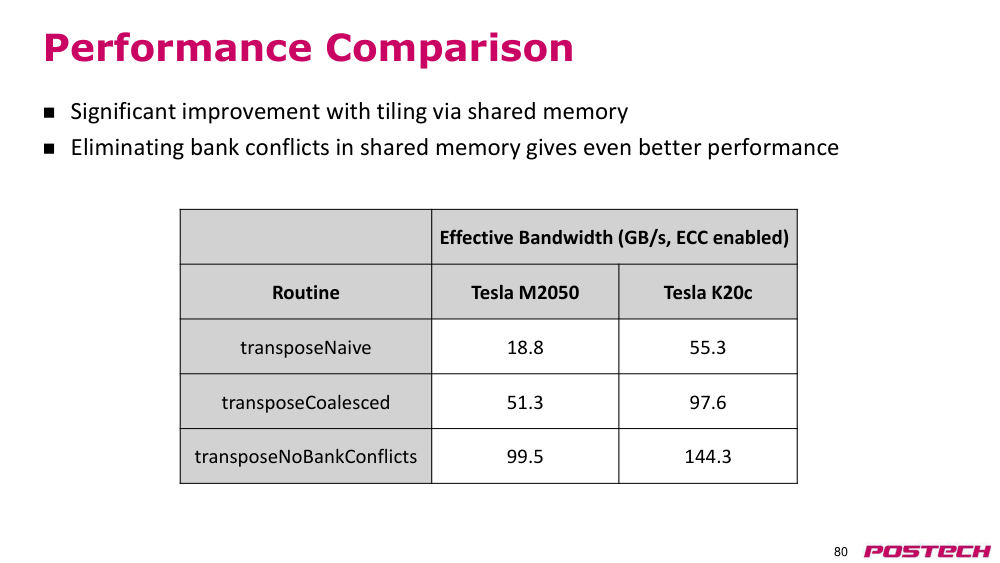
p.80성능 비교
- shared memory(공유 메모리)의 타일링을 통해 큰 성능 향상
- shared memory(공유 메모리)의 bank(뱅크) 충돌 제거 시 더 나은 성능
- 효율적 대역폭 (GB/s, ECC 활성화)
- Routine
- Tesla M2050
- Tesla K20c
- transposeNaive
- 18.8
- 55.3
- transposeCoalesced
- 51.3
- 97.6
- transposeNoBankConflicts
- 99.5
- 144.3
p.81shared memory(공유 메모리) 요약
- shared memory(공유 메모리)는 놀라운 자원
- 매우 높은 대역폭 (14 TB/s)
- global memory(글로벌 메모리)보다 훨씬 낮은 latency(지연 시간)
- 데이터는 프로그래머가 직접 관리, 하드웨어에 의한 제거 없음
- Volta: thread block(스레드 블록)당 최대 96KB의 shared memory(공유 메모리)
- 성능 문제 고려 사항:
- bank(뱅크) 충돌은 latency(지연 시간)을 증가시키고 throughput(처리량)을 감소시킴
- bank(뱅크) 충돌을 식별하기 위해 프로파일링 도구 사용
p.82질문?
- 추천 독서:
- 교재 4.4-4.9 장