이 자료를 쓰는 강의: 20 Cache Coherence: snoopy MSI·MESI·MOESI, false sharing, directory · 21 Directory 마무리·Shared cache·NUCA, Virtual Memory(base&bound·paging·TLB·virtual cache)
Lec13 - Coherence
한국어판 강의자료 · 52쪽
p.1CSED503 고급 컴퓨터 구조 – 강의 13
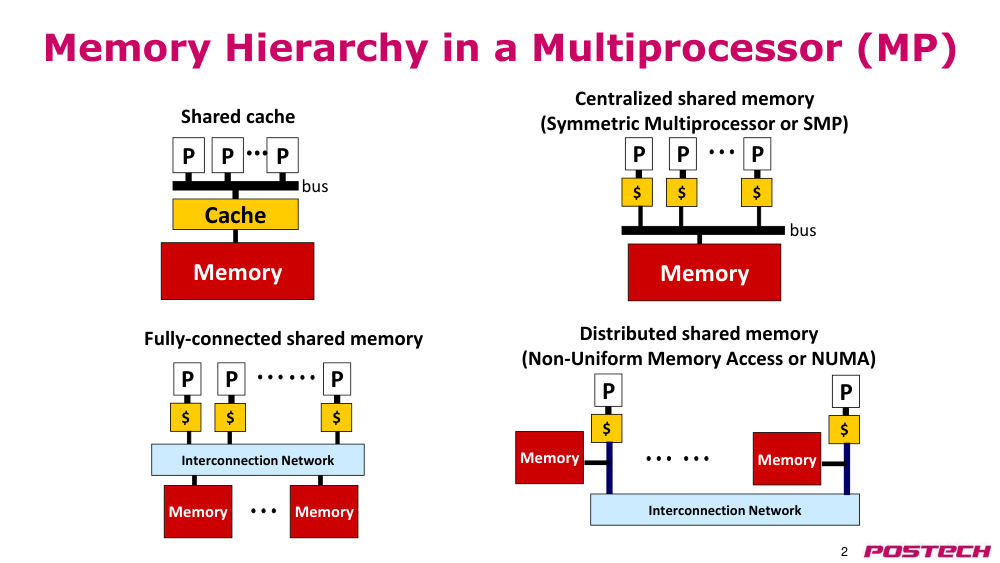
p.2다중프로세서(MP)의 memory hierarchy(메모리 계층 구조)
- P
- P
- P
- 캐시
- 메모리
- shared cache(공유 캐시)
- P
- P
- P
- $
- 중앙 집중형 공유 메모리 (대칭 다중프로세서 또는 SMP)
- $
- $
- 메모리
- P
- P
- P
- $
- 메모리
- fully-connected shared memory(완전 연결형 공유 메모리)
- $
- $
- 메모리
- interconnection network(상호연결 네트워크)
- P
- $
- 메모리
- interconnection network(상호연결 네트워크)
- P
- $
- 메모리
- 분산 공유 메모리 (비균일 메모리 접근 또는 NUMA)
- bus(버스)
- bus(버스)
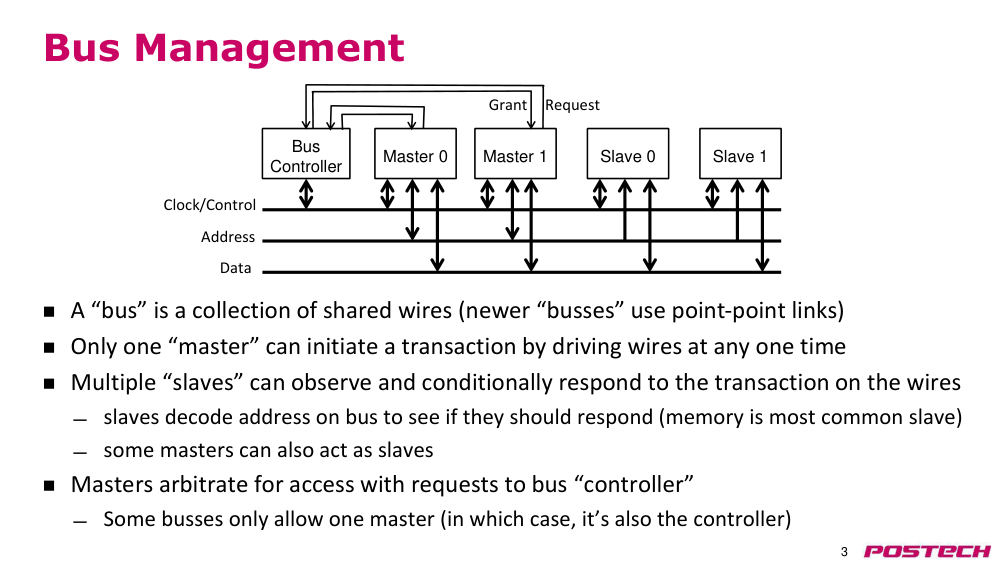
p.3bus(버스) 관리
- "bus(버스)"는 공유된 와이어의 집합이다 (최신 "버스"는 포인트투포인트 링크를 사용함)
- 한 번에 하나의 "master(마스터)"만 트랜잭션을 시작할 수 있다 (와이어를 드라이브함)
- 여러 "slave(슬레이브)"가 와이어의 트랜잭션을 관찰하고 조건부로 응답할 수 있다
- slave(슬레이브)는 bus(버스)의 주소를 디코딩하여 자신이 응답해야 하는지 확인한다 (메모리가 가장 일반적인 슬레이브)
- 일부 master(마스터)는 slave(슬레이브) 역할도 할 수 있다
- master(마스터)들은 bus(버스) "컨트롤러"에 요청을 통해 접근을 arbitrate(경쟁 조정)한다
- 일부 bus(버스)는 하나의 master(마스터)만 허용한다 (이 경우 마스터는 컨트롤러이기도 함)
- master(마스터) 0
- master(마스터) 1
- slave(슬레이브) 0
- slave(슬레이브) 1
- bus controller(버스 컨트롤러)
- 클록/컨트롤
- 주소
- 데이터
- 요청
- 허가
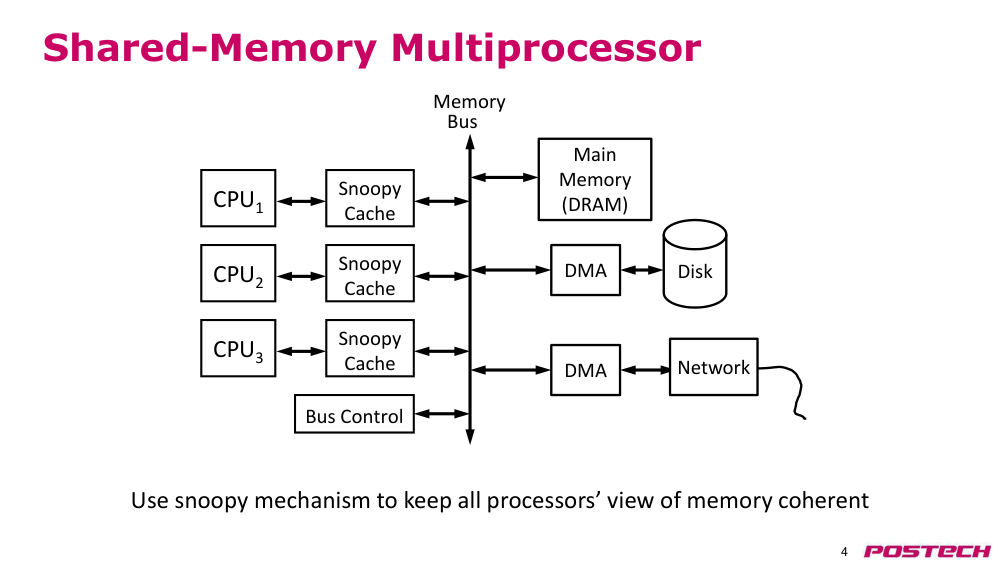
p.4공유 메모리 multiprocessor (MP)(다중프로세서)
- 모든 프로세서의 메모리 시각을 일관성 있게 유지하기 위해 snoopy mechanism(스누피 메커니즘)을 사용한다
- CPU1
- 메모리
- bus(버스)
- 메인 메모리 (DRAM)
- DMA
- snoopy cache(스누피 캐시)
- CPU2
- snoopy cache(스누피 캐시)
- CPU3
- snoopy cache(스누피 캐시)
- 디스크
- DMA
- 네트워크
- bus(버스) 컨트롤
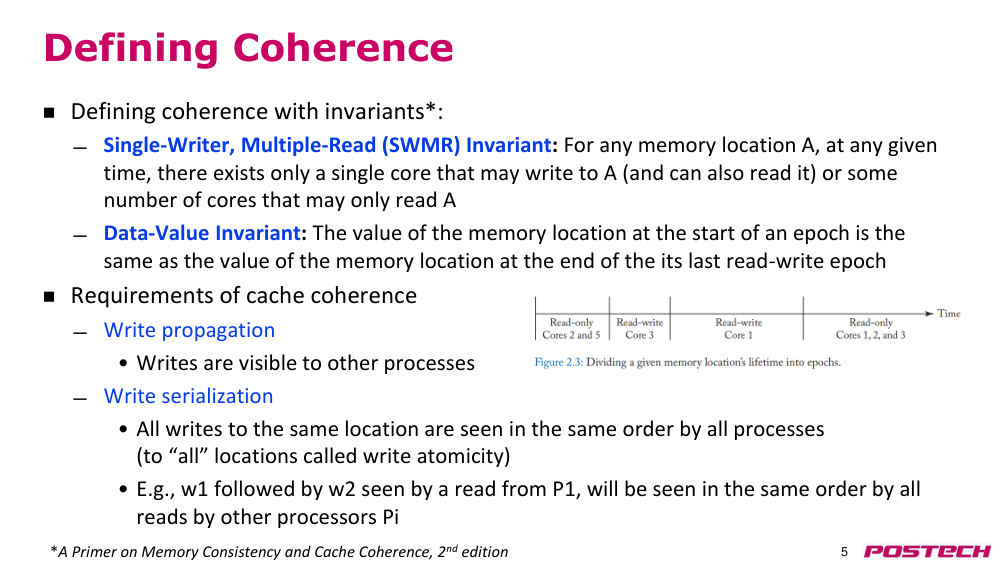
p.5일관성 정의
- 일관성은 불변성으로 정의한다:
- 단일 쓰기자, 다중 읽기자 불변성 (SWMR): 어떤 메모리 위치 A에 대해, 주어진 시점에 A에 쓸 수 있는 코어는 단 하나뿐이거나, A를 읽을 수 있는 여러 코어가 존재한다
- Data-Value invariant(데이터 값 불변성): 어떤 에포크의 시작 시점에서 메모리 위치의 값은 그 위치의 마지막 읽기-쓰기 에포크의 끝 시점에서의 값과 동일하다
- cache coherence(캐시 일관성)의 요구 사항:
- write propagation(쓰기 전파)
- • 쓰기 내용이 다른 프로세스에 보여져야 한다
- write serialization(쓰기 순서화)
- • 동일한 위치에 대한 모든 쓰기는 모든 프로세스에 동일한 순서로 보여져야 한다 (모든 위치에 대해 적용되면 write atomicity(쓰기 원자성)이라 부름)
- • 예: P1에서 읽기 전에 w1이 w2보다 먼저 발생하면, 다른 프로세서 Pi의 모든 읽기에서도 동일한 순서로 보여져야 한다
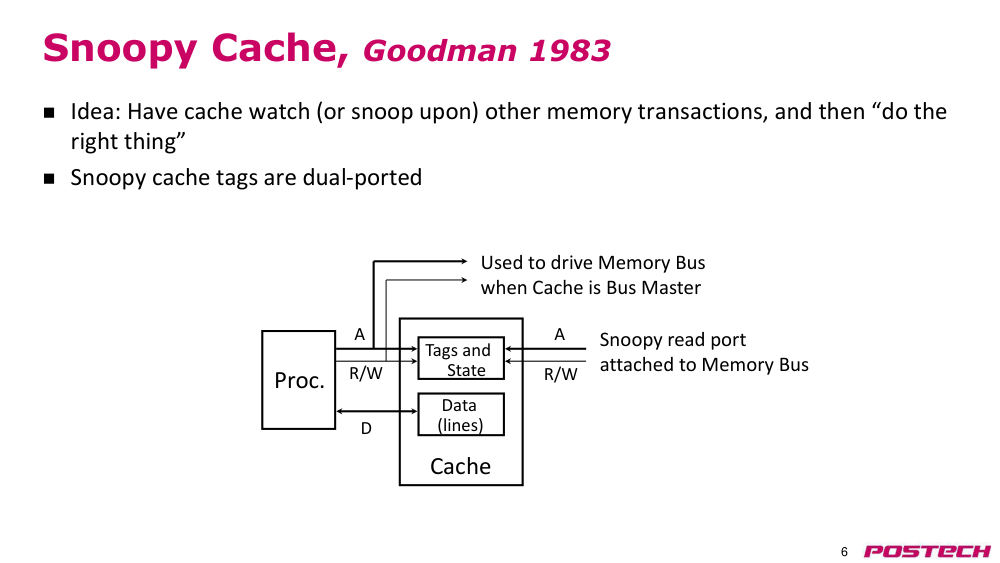
p.6snoopy cache(스누피 캐시), Goodman 1983
- 아이디어: 캐시가 다른 메모리 트랜잭션을 감시(스누핑)하고, "올바른 일"을 수행하도록 한다
- snoopy cache(스누피 캐시) 태그는 dual-ported(이중 포트)를 가진다
- 프로세서
- 캐시
- 스누피 읽기 포트
- 메모리 bus(버스)에 연결됨
- 데이터
- (라인)
- 태그와 상태
- A
- D
- R/W
- 캐시가 bus(버스) master(마스터)일 때 메모리 버스를 드라이브하는 데 사용됨
- A
- R/W
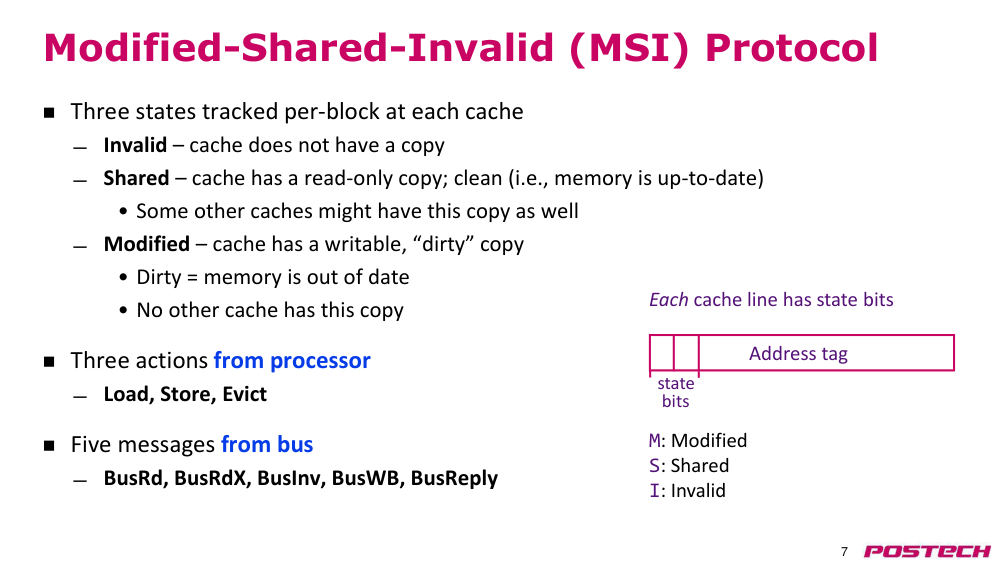
p.7수정-공유-무효(MSI) 프로토콜
- 각 캐시에서 블록당 3가지 상태를 추적한다.
- 무효(I): 캐시에 복사본이 없음
- 공유(S): 캐시에 읽기 전용 복사본이 있음; 깨끗함 (즉, 메모리와 최신 상태 동일)
- • 다른 캐시들 중 일부가 이 복사본을 가질 수 있음
- 수정(M): 캐시에 쓰기 가능한, dirty(더티) 상태의 복사본이 있음
- • dirty(더티) = 메모리와 최신 상태 불일치
- • 다른 캐시는 이 복사본을 가질 수 없음
- 프로세서에서 발생하는 3가지 동작:
- load(로드), store(스토어), evict(제거)
- bus(버스)에서 발생하는 5가지 메시지:
- BusRd, BusRdX, BusInv, BusWB, BusReply
- M: 수정
- S: 공유
- I: 무효
- 각 캐시 라인은 state bits(상태 비트)를 가짐
- 주소 태그
- state bits(상태 비트)
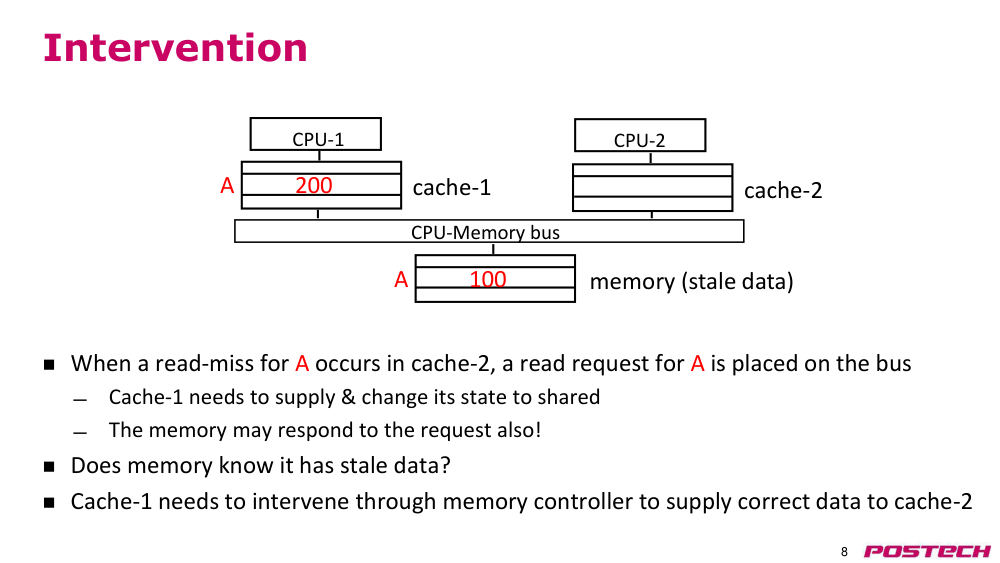
p.8intervention(개입)
- 캐시-2에서 A에 대한 read-miss(읽기 미스)가 발생하면, A에 대한 읽기 요청이 bus(버스)에 전달됨
- 캐시-1은 데이터를 공급하고 자신의 상태를 공유로 변경해야 함
- 메모리도 요청에 응답할 수 있음!
- 메모리는 오래된 데이터를 알고 있는가?
- 캐시-1은 memory controller(메모리 컨트롤러)를 통해 intervention(개입)하여 캐시-2에 올바른 데이터를 제공해야 함
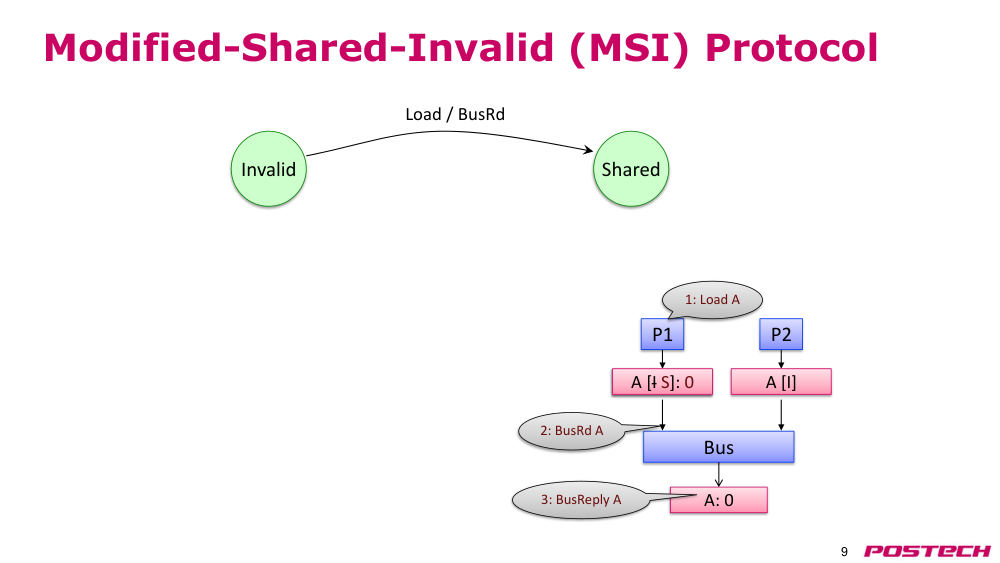
p.9수정-공유-무효(MSI) 프로토콜
- 무효
- load(로드) / BusRd(버스 읽기)
- 공유
- bus(버스)
- A [I]
- A: 0
- P2
- A [I]
- P1
- 1: A load(로드)
- 2: BusRd(버스 읽기) A
- 3: BusReply(버스 응답) A
- A [I S]: 0
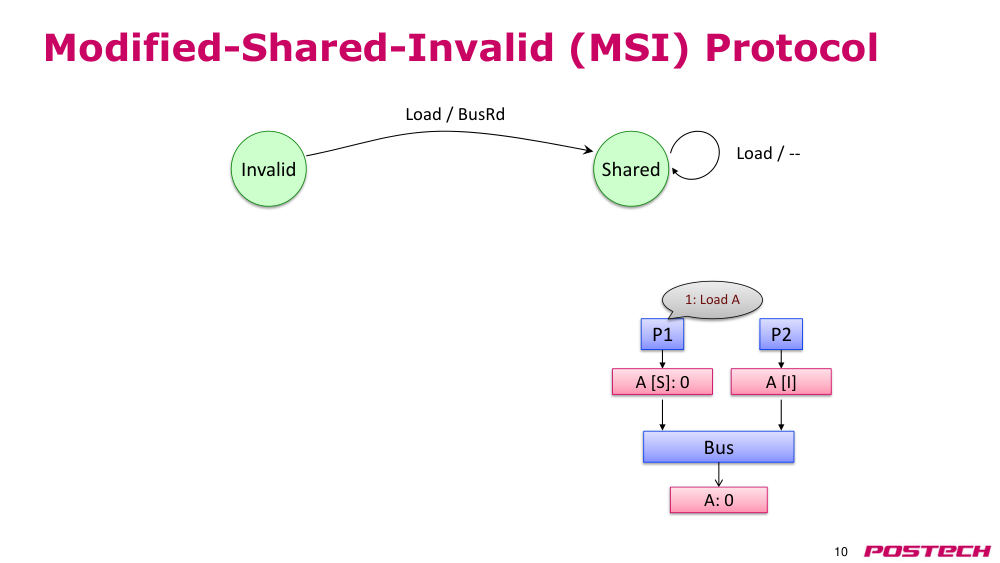
p.10수정-공유-무효(MSI) 프로토콜
- load(로드) / BusRd(버스 읽기)
- load(로드) / --
- bus(버스)
- A [I]
- A: 0
- P2
- A [S]: 0
- P1
- 1: A load(로드)
- 무효
- 공유
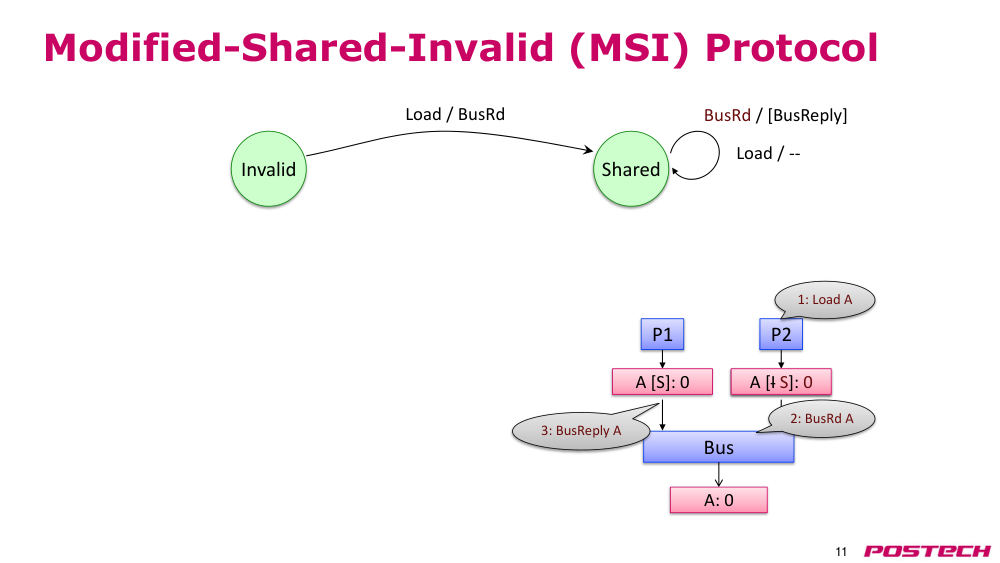
p.11수정-공유-무효(MSI) 프로토콜
- load(로드) / BusRd(버스 읽기)
- load(로드) / --
- BusRd(버스 읽기) / [BusReply(버스 응답)]
- bus(버스)
- A [I]
- A: 0
- P2
- A [S]: 0
- P1
- 1: A load(로드)
- 2: BusRd(버스 읽기) A
- 3: BusReply(버스 응답) A
- A [I S]: 0
- 무효
- 공유
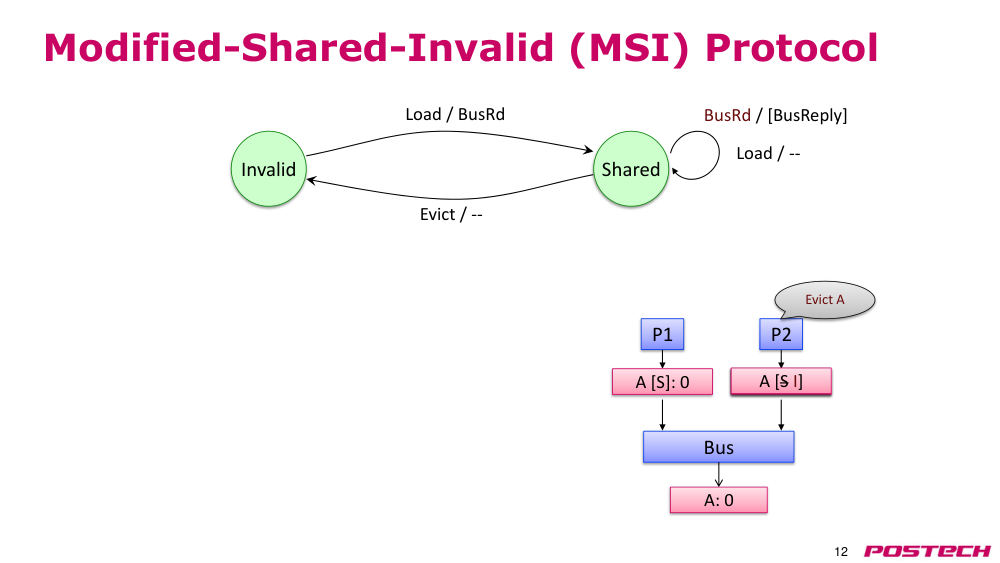
p.12수정-공유-무효(MSI) 프로토콜
- load(로드) / BusRd(버스 읽기)
- load(로드) / --
- BusRd(버스 읽기) / [BusReply(버스 응답)]
- evict(제거) / --
- bus(버스)
- A [I]
- A: 0
- P2
- A [S]: 0
- P1
- A [S]: 0
- A [S I]
- A evict(제거)
- 무효
- 공유
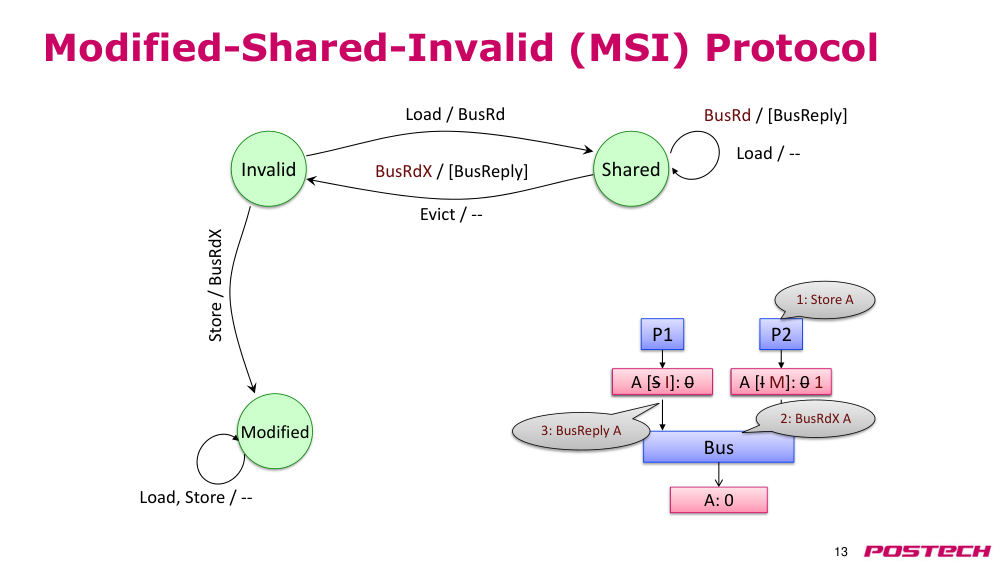
p.13수정-공유-무효 프로토콜(MSI)
- Store / BusRdX
- Load / BusRd
- Load / --
- BusRd / [BusReply]
- Modified
- Evict / --
- BusRdX / [BusReply]
- Bus
- A [I]: 0
- P1
- A [S I]: 0
- P2
- 1: Store A
- 2: BusRdX A
- 3: BusReply A
- A [I M]: 0 1
- Invalid
- Shared
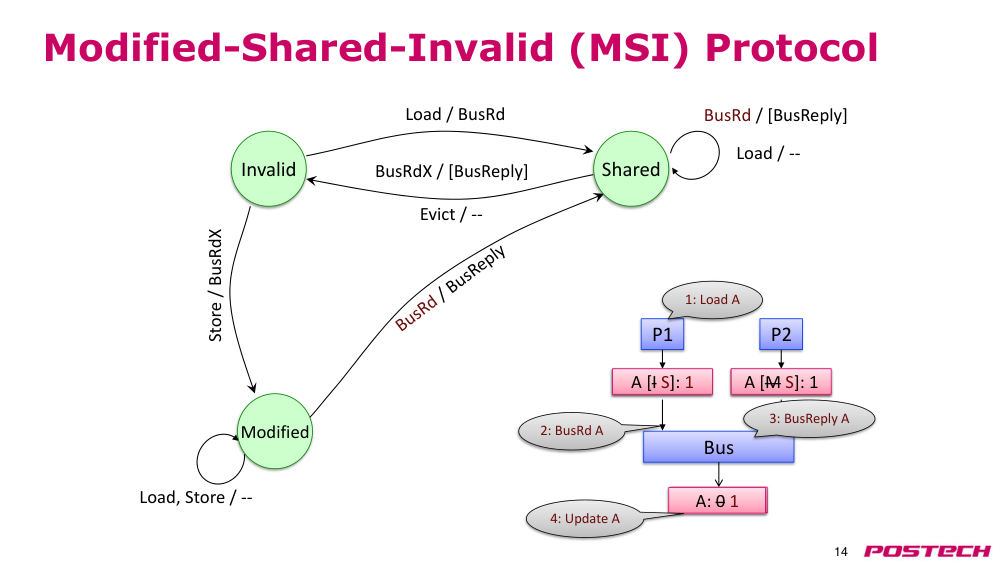
p.14수정-공유-무효 프로토콜(MSI)
- Store / BusRdX
- Load / BusRd
- Load / --
- BusRd / [BusReply]
- Evict / --
- Load, Store / --
- BusRdX / [BusReply]
- Bus
- A [M]: 1
- A: 0
- P2
- A [I]
- P1
- 1: Load A
- 2: BusRd A
- 3: BusReply A
- A [I S]: 1
- A [M S]: 1
- A: 0 1
- 4: Update A
- Invalid
- Shared
- Modified
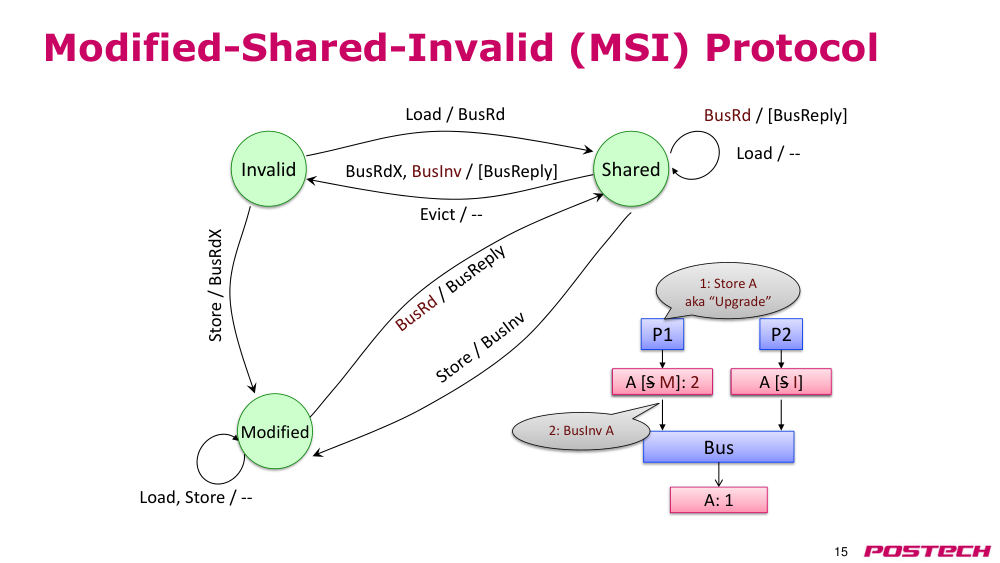
p.15수정-공유-무효 프로토콜(MSI)
- Store / BusRdX
- Load / BusRd
- Load / --
- BusRd / [BusReply]
- Evict / --
- Load, Store / --
- Bus
- A [S]: 1
- A: 1
- P2
- A [S]: 1
- P1
- 1: Store A
- aka “Upgrade”
- 2: BusInv A
- A [S M]: 2
- A [S I]
- BusRdX / [BusReply]
- BusRdX, BusInv / [BusReply]
- Invalid
- Shared
- Modified
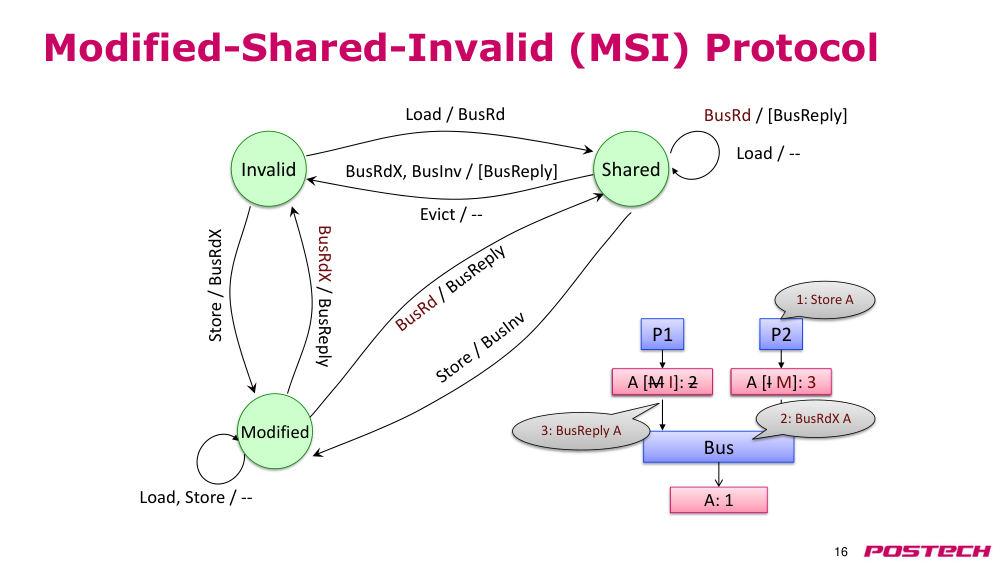
p.16수정-공유-무효 프로토콜(MSI)
- Store / BusRdX
- Load / BusRd
- Load / --
- BusRd / [BusReply]
- BusRdX / BusReply
- Evict / --
- Load, Store / --
- BusRdX, BusInv / [BusReply]
- Bus
- A [I]
- A: 1
- P2
- A [M]: 2
- P1
- 1: Store A
- 2: BusRdX A
- 3: BusReply A
- A [M I]: 2
- A [I M]: 3
- Invalid
- Shared
- Modified
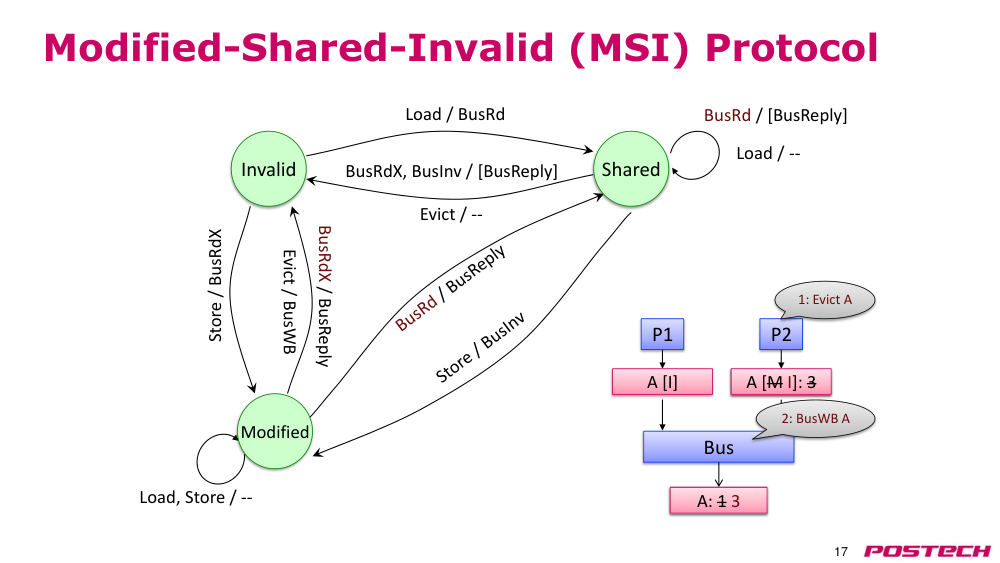
p.17수정-공유-무효 프로토콜(MSI)
- Store / BusRdX
- Load / BusRd
- Load / --
- BusRd / [BusReply]
- BusRdX / BusReply
- Evict / --
- Evict / BusWB
- Load, Store / --
- BusRdX, BusInv / [BusReply]
- Bus
- A [M]: 3
- A: 1
- P2
- A [I]
- P1
- 1: Evict A
- 2: BusWB A
- A [M I]: 3
- A: 1 3
- Invalid
- Shared
- Modified
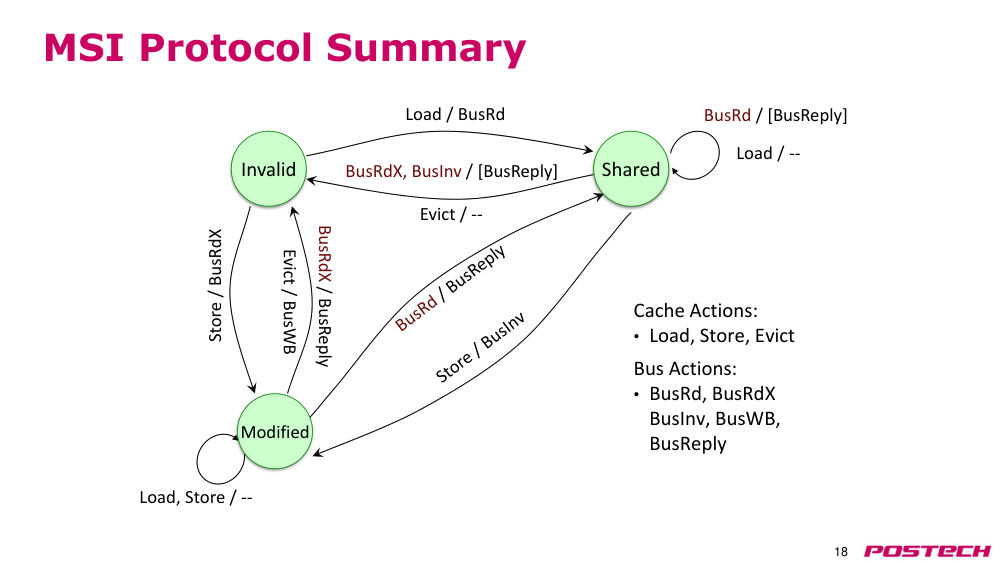
p.18MSI 프로토콜 요약
- Store / BusRdX
- Load / BusRd
- Load / --
- BusRd / [BusReply]
- Cache Actions:
- • Load, Store, Evict
- Bus Actions:
- • BusRd, BusRdX
- • BusInv, BusWB,
- • BusReply
- BusRdX / BusReply
- Evict / --
- Evict / BusWB
- Load, Store / --
- BusRdX, BusInv / [BusReply]
- Invalid
- Shared
- Modified
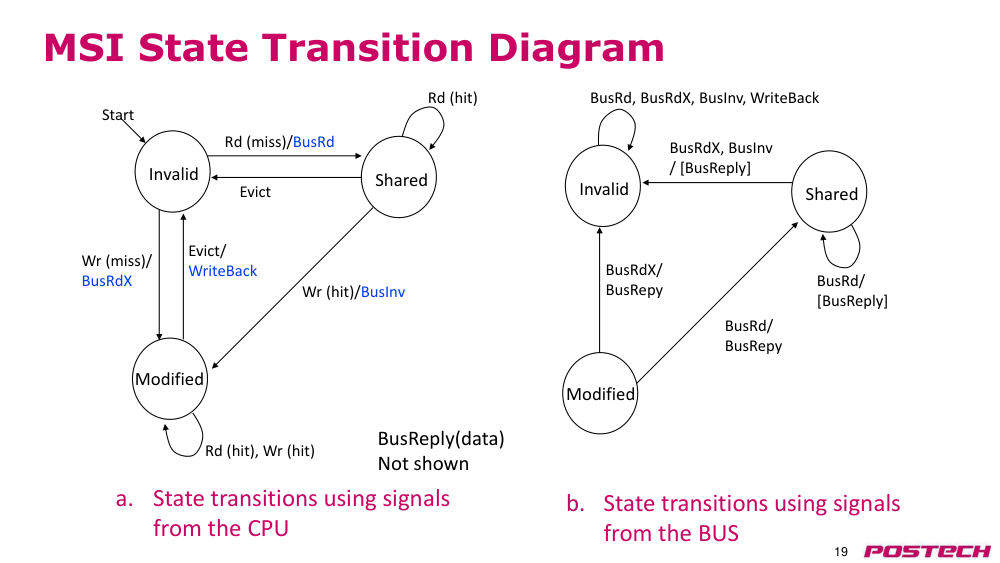
p.19MSI 상태 전이 다이어그램
- 무효
- 공유
- 수정
- 읽기(미스)/BusRd(버스 읽기)
- 읽기(히트)
- 쓰기(히트)/BusInv(버스 무효화)
- 읽기(히트), 쓰기(히트)
- evict(제거)
- evict(제거)/쓰기-백
- 쓰기(미스)/BusRdX(버스 읽기-확보)
- 시작
- 무효
- 공유
- 수정
- BusRd(버스 읽기)/[BusReply(버스 응답)]
- BusRd(버스 읽기)/BusReply(버스 응답)
- BusRdX(버스 읽기-확보), BusInv(버스 무효화)/[BusReply(버스 응답)]
- BusRdX(버스 읽기-확보)/BusReply(버스 응답)
- BusRd(버스 읽기), BusRdX(버스 읽기-확보), BusInv(버스 무효화), 쓰기-백
- bus(버스) 응답(데이터)
- 표시되지 않음
- a. CPU로부터의 신호를 사용한 상태 전이
- b. bus(버스)로부터의 신호를 사용한 상태 전이
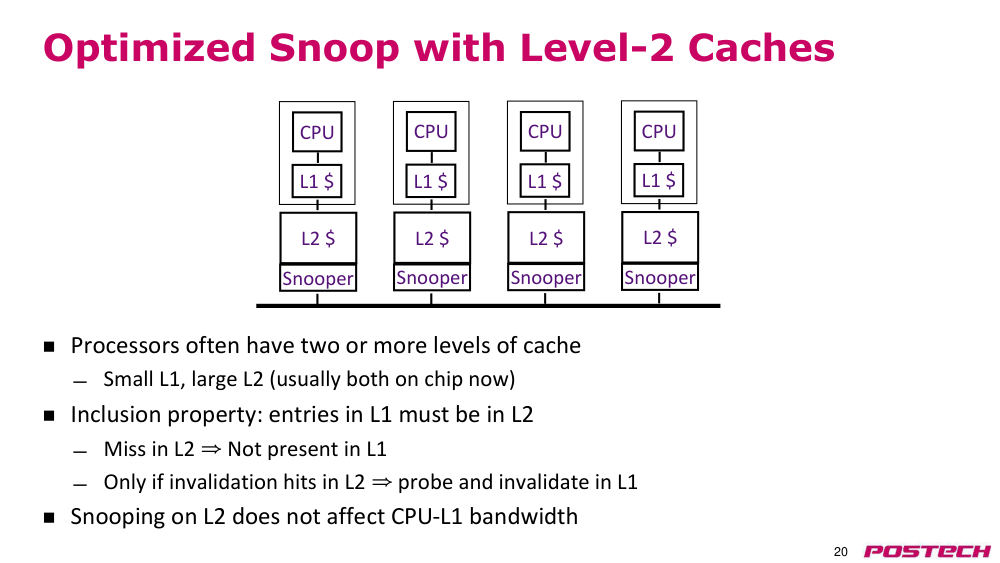
p.20L2 cache(L2 캐시)를 활용한 최적화된 snooping(스누핑)
- 프로세서는 종종 두 개 이상의 캐시 레벨을 가짐
- 작은 L1, 큰 L2 (현재는 일반적으로 모두 칩 내부에 있음)
- inclusion property(포함성 성질): L1에 있는 항목은 반드시 L2에 존재해야 함
- L2에서 미스 발생 ⇒ L1에 존재하지 않음
- 무효화가 L2에 영향을 미치는 경우에만 L1에서 snooping(스누핑) 및 무효화 수행
- L2에서의 snooping(스누핑)은 CPU-L1 대역폭에 영향을 주지 않음
- 스누퍼
- 스누퍼
- 스누퍼
- 스누퍼
- CPU
- L1 $
- L2 $
- CPU
- L1 $
- L2 $
- CPU
- L1 $
- L2 $
- CPU
- L1 $
- L2 $
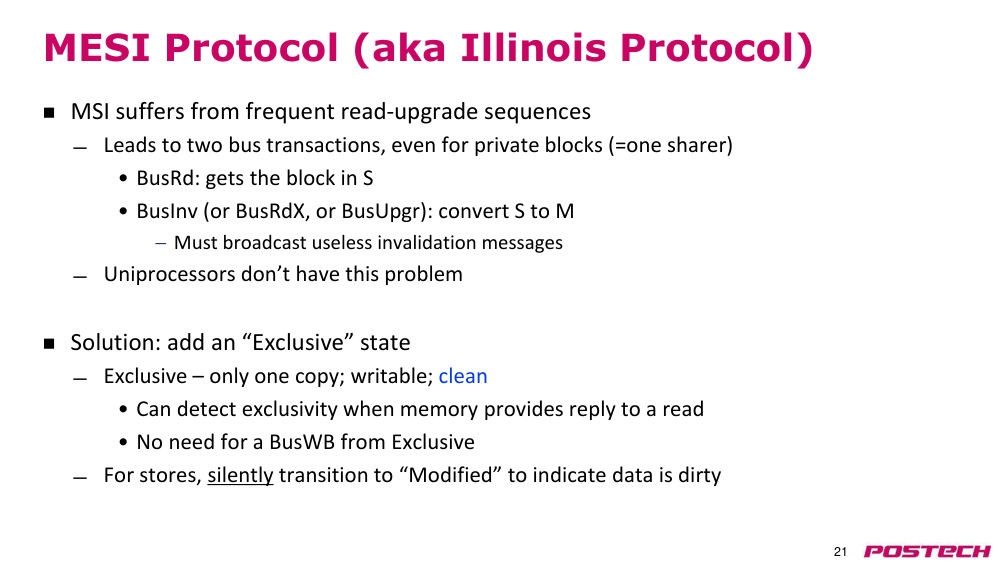
p.21MESI 프로토콜 (Illinois 프로토콜이라고도 함)
- MSI는 자주 발생하는 읽기-upgrade(업그레이드) 시퀀스로 인해 문제가 있음
- 개인 블록(=한 명의 공유자)에 대해서도 두 번의 bus(버스) 트랜잭션이 발생함
- • BusRd(버스 읽기): 블록을 공유 상태(S)로 가져옴
- • BusInv(버스 무효화)(또는 BusRdX(버스 읽기-확보), 또는 BusUpgr(버스 업그레이드)): 공유 상태를 수정 상태로 전환
- • 무의미한 무효화 메시지를 방송해야 함
- 단일 프로세서에서는 이 문제가 없음
- 해결책: "독점" 상태 추가
- exclusive state(독점 상태) – 하나의 복사본만 존재; 쓰기 가능; 깨끗함
- • 읽기 요청에 대해 메모리가 응답을 제공할 때 독점성을 감지할 수 있음
- • exclusive state(독점 상태)에서는 버스 쓰기-백(BusWB)이 필요 없음
- 쓰기 시, 조용히 "수정" 상태로 전이하여 데이터가 dirty(더티) 상태임을 나타냄
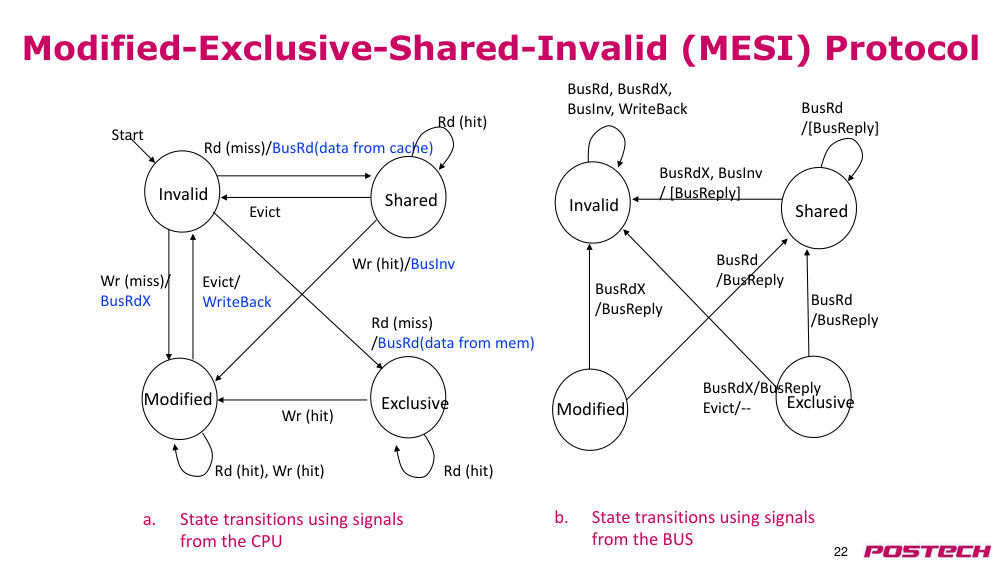
p.22수정-독점-공유-무효 (MESI) 프로토콜
- 무효
- 공유
- 수정
- 읽기(미스)/bus(버스) 읽기(캐시로부터 데이터)
- 읽기(히트)
- 쓰기(히트)/BusInv(버스 무효화)
- 읽기(히트), 쓰기(히트)
- evict(제거)
- evict(제거)/쓰기-백
- 쓰기(미스)/BusRdX(버스 읽기-확보)
- 시작
- 무효
- 공유
- 수정
- BusRd(버스 읽기)/[BusReply(버스 응답)]
- BusRd(버스 읽기)/BusReply(버스 응답)
- BusRdX(버스 읽기-확보)/BusReply(버스 응답)
- BusRd(버스 읽기), BusRdX(버스 읽기-확보), BusInv(버스 무효화), 쓰기-백
- a. CPU로부터의 신호를 사용한 상태 전이
- b. bus(버스)로부터의 신호를 사용한 상태 전이
- BusRdX(버스 읽기-확보), BusInv(버스 무효화)/[BusReply(버스 응답)]
- 독점
- 읽기(미스)/bus(버스) 읽기(메모리로부터 데이터)
- 쓰기(히트)
- 읽기(히트)
- 독점
- BusRdX(버스 읽기-확보)/BusReply(버스 응답)
- evict(제거)/--
- BusRd(버스 읽기)/BusReply(버스 응답)
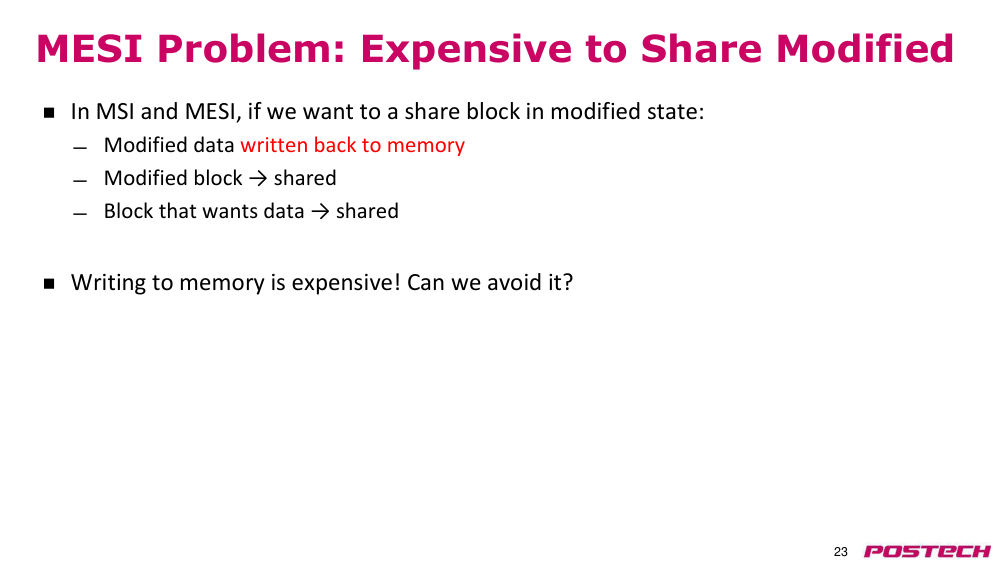
p.23MESI 문제: 수정된 상태를 공유하는 것은 비용이 큼
- MSI 및 MESI에서 수정 상태의 블록을 공유하려면:
- • 수정된 데이터를 메모리에 다시 쓰기
- • 수정된 블록 → 공유 상태
- • 데이터를 원하는 블록 → 공유 상태
- 메모리에 쓰는 것은 비용이 큼! 이를 피할 수는 없을까?
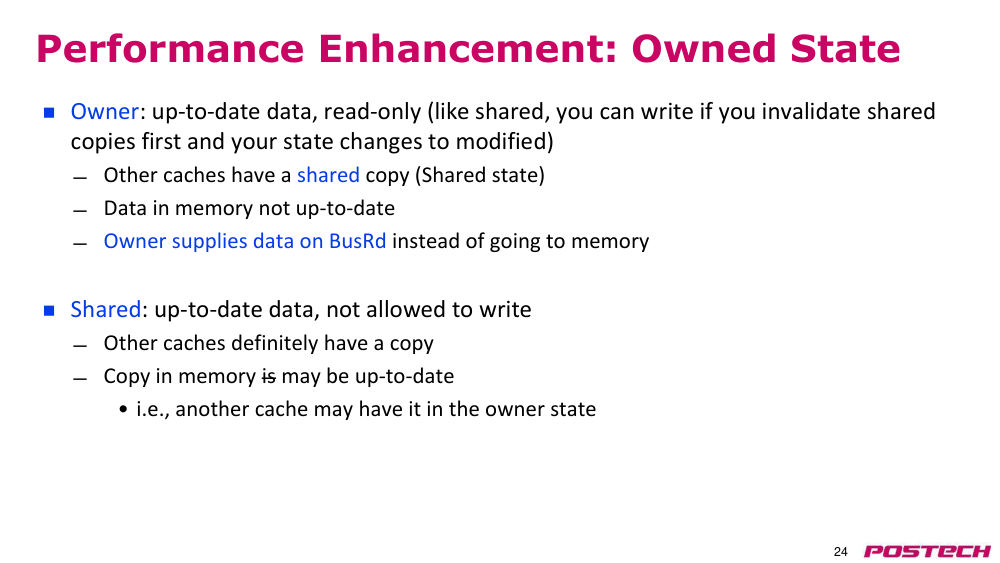
p.24성능 향상: owned state(소유 상태)
- 소유자: 최신 데이터, 읽기 전용 (공유 상태와 유사하나, 먼저 공유 복사본을 무효화하고 상태를 수정 상태로 변경하면 쓰기 가능)
- 다른 캐시는 공유 복사본을 가짐 (공유 상태)
- 메모리의 데이터는 최신 상태가 아님
- BusRd(버스 읽기) 요청 시 메모리가 아닌 소유자가 데이터를 제공함
- 공유: 최신 데이터, 쓰기 불가능
- 다른 캐시는 반드시 복사본을 가짐
- 메모리의 복사본은 최신일 수 있음
- • 즉, 다른 캐시가 owned state(소유 상태)를 가질 수 있음
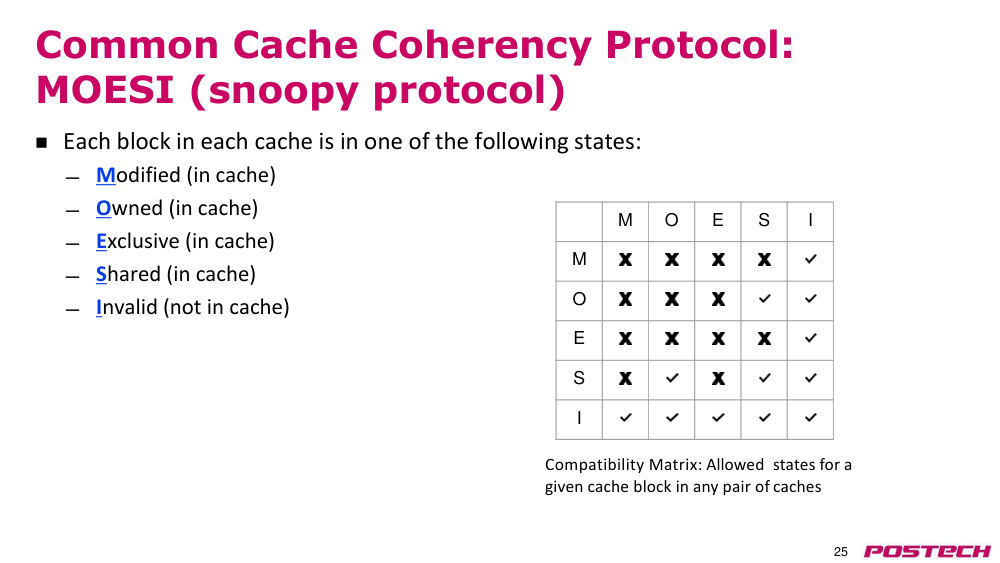
p.25공통 cache coherence(캐시 일관성) 프로토콜: MOESI (스누피 프로토콜)
- 각 캐시의 각 블록은 다음 상태 중 하나에 있다:
- • 수정 (캐시 내)
- • 소유 (캐시 내)
- • 독점 (캐시 내)
- • 공유 (캐시 내)
- • 무효 (캐시에 없음)
- 상태 호환성 매트릭스: 주어진 캐시 블록에 대해, 어떤 쌍의 캐시에서도 허용되는 상태
- M
- O
- E
- S
- I
- M
- O
- E
- S
- I
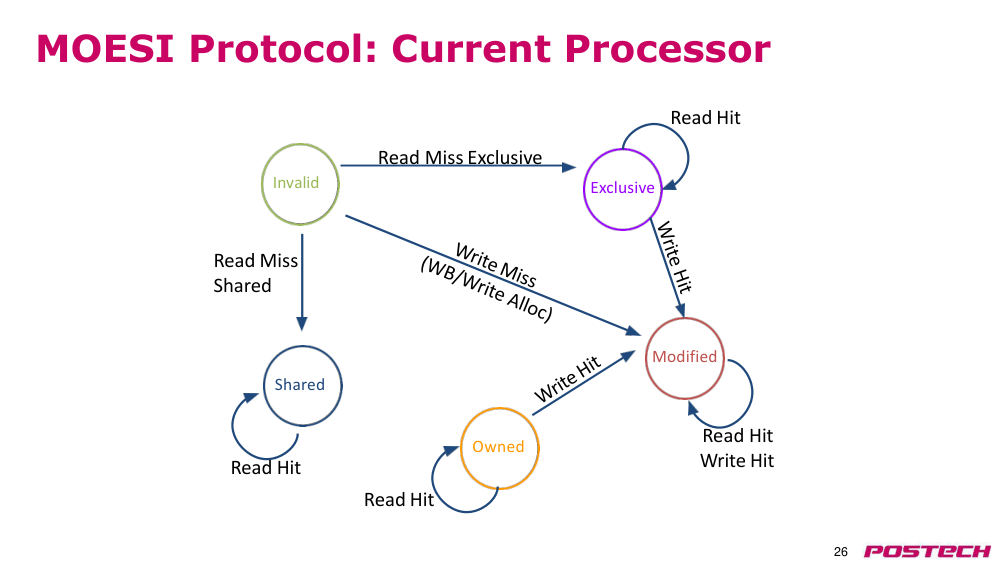
p.26독점
- 무효
- 공유
- 소유
- 수정
- read-miss(읽기 미스) - 독점
- read-miss(읽기 미스) - 공유
- MOESI protocol(MOESI 프로토콜): 현재 프로세서
- 읽기 히트
- 쓰기 히트
- 읽기 히트
- 읽기 히트
- 읽기 히트
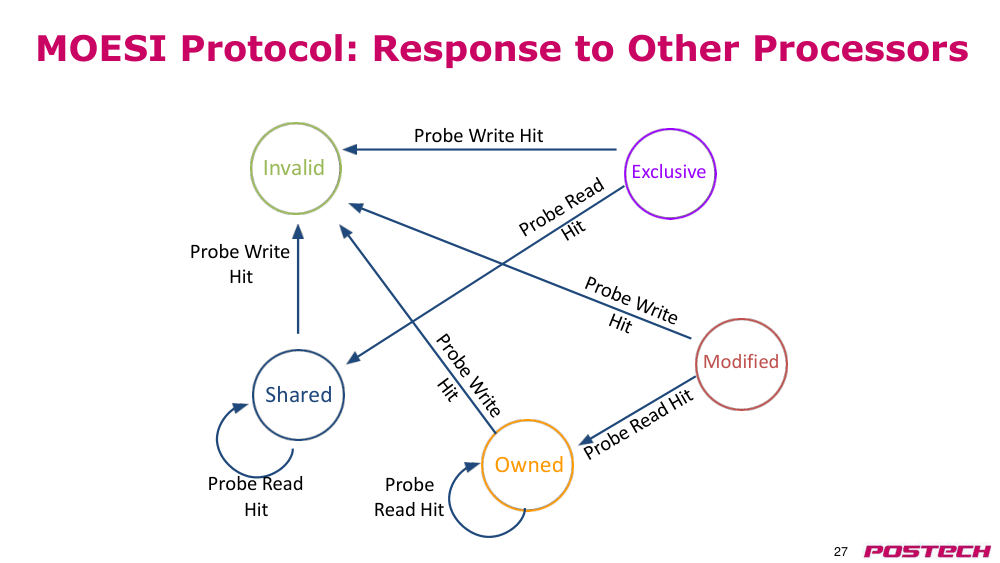
p.27MOESI protocol(MOESI 프로토콜): 다른 프로세서에 대한 응답
- 무효
- 공유
- 소유
- 수정
- 프로브 쓰기 히트
- 프로브 쓰기 히트
- 프로브 읽기 히트
- 프로브 읽기 히트
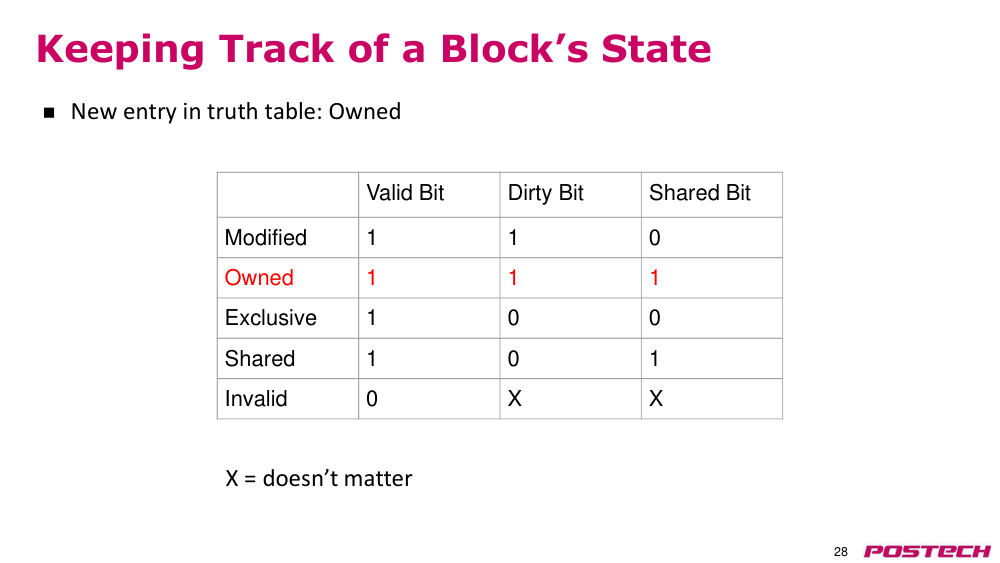
p.28블록 상태 추적
- truth table(진리표)에 새로운 항목: 소유
- X = 중요하지 않음
- valid bit(유효 비트)
- dirty bit(더티 비트)
- shared bit(공유 비트)
- 수정
- 1
- 1
- 0
- 소유
- 1
- 1
- 1
- 독점
- 1
- 0
- 0
- 공유
- 1
- 0
- 1
- 무효
- 0
- X
- X
p.29SMP의 성능
- 캐시 성능은 다음의 조합이다:
- • 단일 프로세서 cache miss traffic(캐시 미스 트래픽)
- • coherence misses(일관성 미스)
- • 때때로 communication miss(통신 미스)라고도 함
- • 3C(필수, 용량, 충돌) 외의 캐시 미스의 4번째 C
p.30false sharing(거짓 공유)
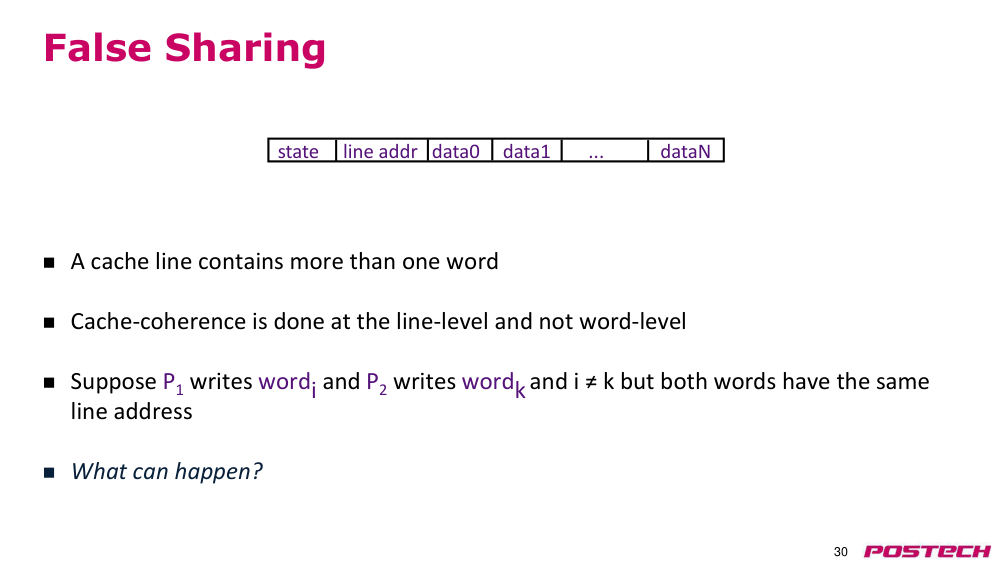
- 캐시 라인은 하나 이상의 워드를 포함할 수 있다
- cache coherence(캐시 일관성)은 line-level(라인 수준)에서 수행되며, word-level(워드 수준)이 아님
- P1이 wordi를 쓰고, P2가 wordk를 쓰며, i ≠ k이지만 두 워드가 동일한 라인 주소를 가진다고 가정
- 무엇이 발생할 수 있는가?
- 상태 라인 주소 데이터0
- 데이터1 ... 데이터N
p.31coherence misses(일관성 미스)
- false sharing(거짓 공유) 미스는 라인 내에서 읽고자 하는 워드가 아닌 다른 워드가 쓰여짐으로써 라인이 무효화될 때 발생한다.
- 무효화는 새로운 값의 전달을 유도하지 않지만, 추가적인 캐시 미스를 유도한다.
- 라인은 공유되지만, 라인 내 워드 중 실제로 공유되는 것은 없다.
- ⇒ 라인 크기가 1 워드라면 미스가 발생하지 않았을 것이다.
- true sharing misses(진짜 공유 미스)는 cache coherence(캐시 일관성) 메커니즘을 통해 데이터가 전달될 때 발생한다.
- 공유 라인에 대한 1차 쓰기로 인한 무효화.
- 다른 CPU가 다른 캐시에 있는 수정된 라인을 읽을 때.
- ⇒ 라인 크기가 1 워드여도 여전히 미스가 발생한다.
p.32예: 진짜 공유 vs. false sharing(거짓 공유) vs. 히트?
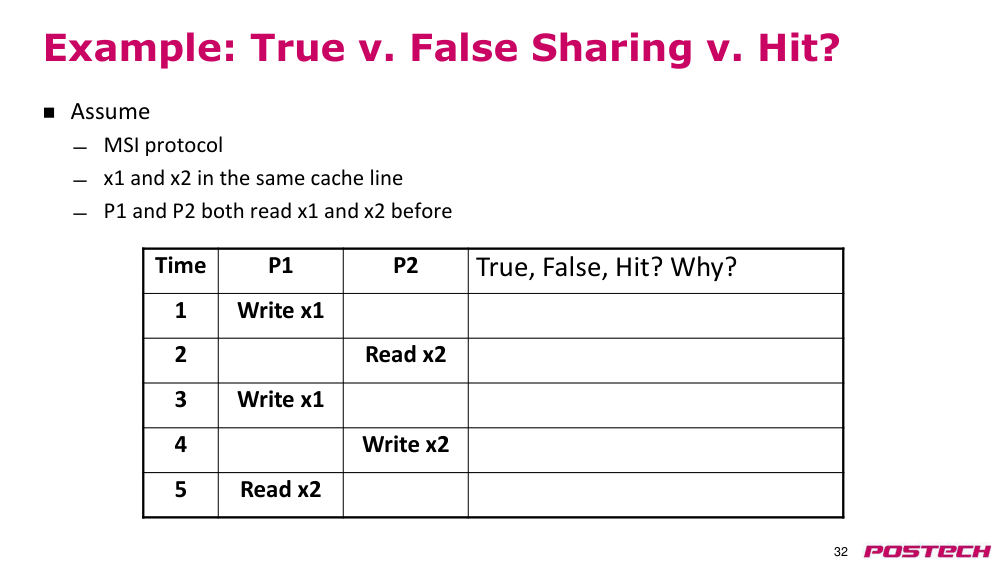
- 가정:
- MSI 프로토콜
- x1과 x2는 같은 캐시 라인에 존재
- P1과 P2는 모두 x1과 x2를 읽은 후
- 시간
- P1
- P2
- 진짜, 거짓, 히트? 왜?
- 1
- x1 쓰기
- 2
- x2 읽기
- 3
- x1 쓰기
- 4
- x2 쓰기
- 5
- x2 읽기
- 진짜 미스; P2의 x1 무효화
- 거짓 미스; x1은 P2와 무관
- 거짓 미스; x1은 P2와 무관
- 진짜 미스; x2는 쓰기 불가능
- 진짜 미스; x2는 P1에서 무효
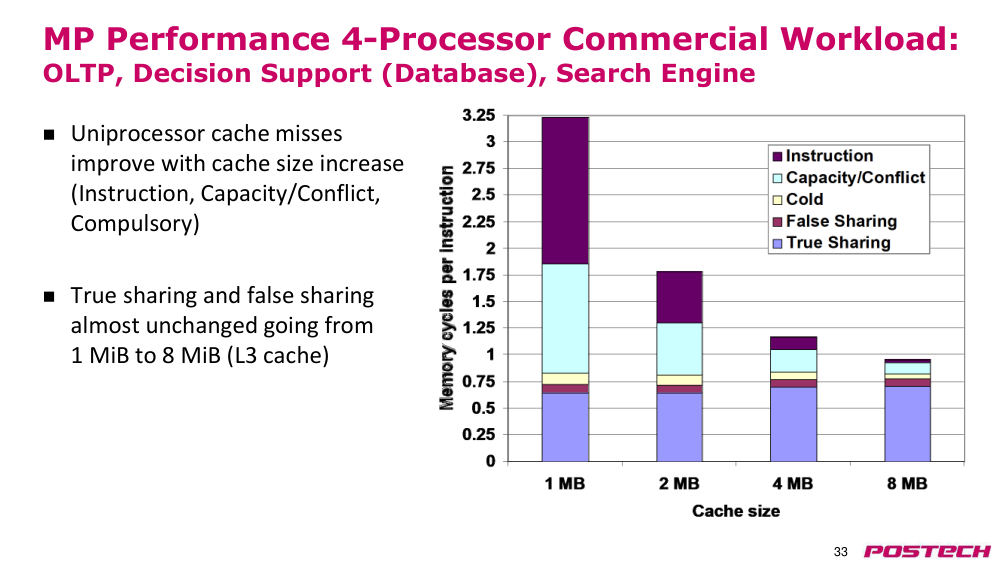
p.33multiprocessor (MP)(다중프로세서) 성능 4프로세서 상용 워크로드: OLTP, 의사결정 지원(데이터베이스), 검색 엔진
- 유니프로세서 캐시 미스는 캐시 크기 증가에 따라 개선된다.
- (명령어, 용량/충돌, 필수 미스)
- 진짜 공유 및 false sharing(거짓 공유)는 1 MiB에서 8 MiB(L3 캐시)로 가는 과정에서 거의 변하지 않는다.
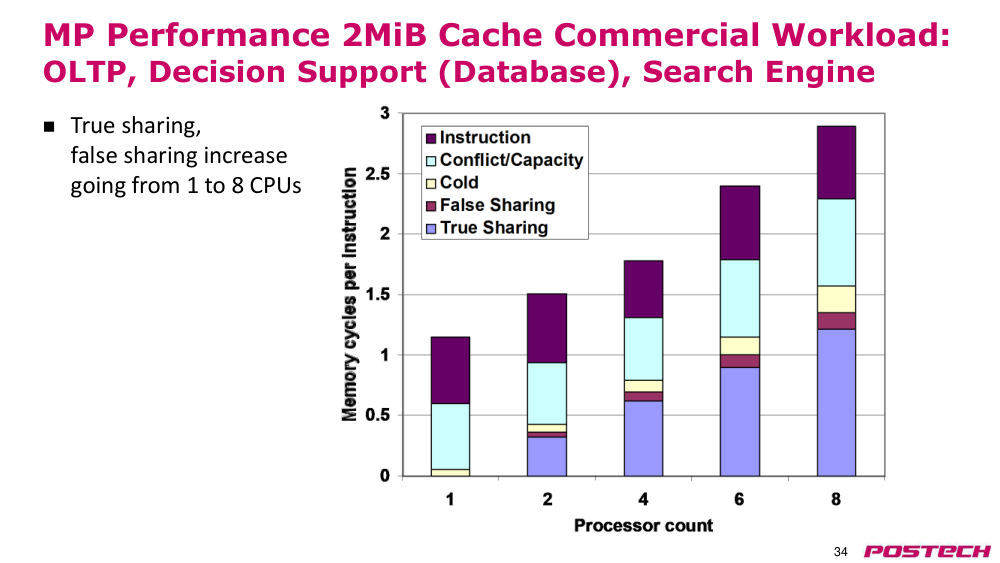
p.34multiprocessor (MP)(다중프로세서) 성능 2MiB 캐시 상용 워크로드: OLTP, 의사결정 지원(데이터베이스), 검색 엔진
- 진짜 공유 및 false sharing(거짓 공유)는 1에서 8 CPU로 가는 과정에서 증가한다.
p.35스누피/방송 일관성의 scalability(확장성)
- 어떤 프로세서가 미스를 발생시키면, 모든 다른 캐시를 조사해야 한다.
- 프로세서 수를 늘릴 때 제한되는 요소:
- bus(버스)를 통한 통신 대역폭
- 태그로의 snoop bandwidth(스누핑 대역폭)
- interleaved buses(인터리브 버스)와 interleaved tag banks(인터리브 태그 뱅크)를 사용하여 대역폭을 개선할 수 있다.
- 예: 주소의 2비트가 4개의 bus(버스)/tag bank(태그 뱅크) 쌍 중 하나를 선택 – (예: 주소의 비트 7:6이 버스/태그 뱅크를 선택, 비트 5:0이 64바이트 라인 내 바이트를 선택)
- bus(버스)는 많은 연결에 확장되지 않으므로, 더 많은 노드에서는 point-to-point network(포인트투포인트 네트워크)를 사용할 수 있지만, 이 경우 브로드캐스트 snooping(스누핑) 요청 시 태그 대역폭이 제한된다.
- 통찰: 대부분의 snooping(스누핑)은 일치를 찾지 못한다!
p.36확장 가능한 접근: 디렉터리
- 모든 메모리 라인은 관련 디렉터리 정보를 가진다.
- 캐시된 라인의 복사본과 그 상태를 추적한다.
- 미스 발생 시 디렉터리 항목을 찾아 lookup하고, 필요한 경우 복사본이 있는 노드들만과 통신한다.
- 확장 가능한 네트워크에서는 디렉터리 및 복사본과의 통신이 네트워크 트랜잭션을 통해 이루어진다.
- 디렉터리 정보를 조직하는 방법은 여러 가지가 있다.
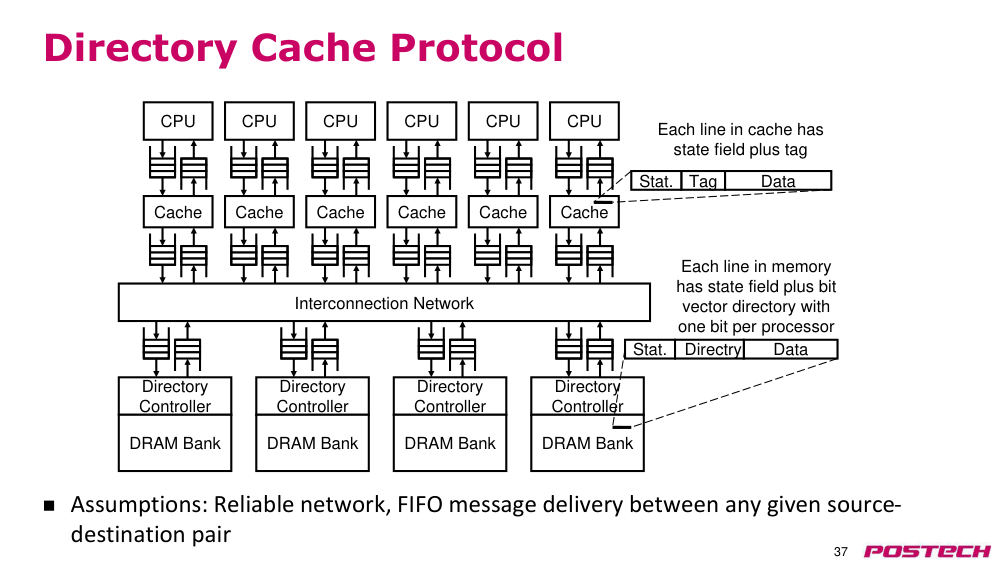
p.37디렉터리 캐시 프로토콜
- 가정: 신뢰할 수 있는 네트워크, 주어진 소스-대상 쌍 간에 FIFO 메시지 전달
- CPU → 캐시 → interconnection network(상호연결 네트워크) → 디렉터리 컨트롤러 → DRAM bank(뱅크)
- 각 캐시 라인에는 상태 필드와 태그가 있음
- 각 메모리 라인에는 상태 필드와 각 프로세서당 하나의 비트를 가진 비트 벡터 디렉터리가 있음
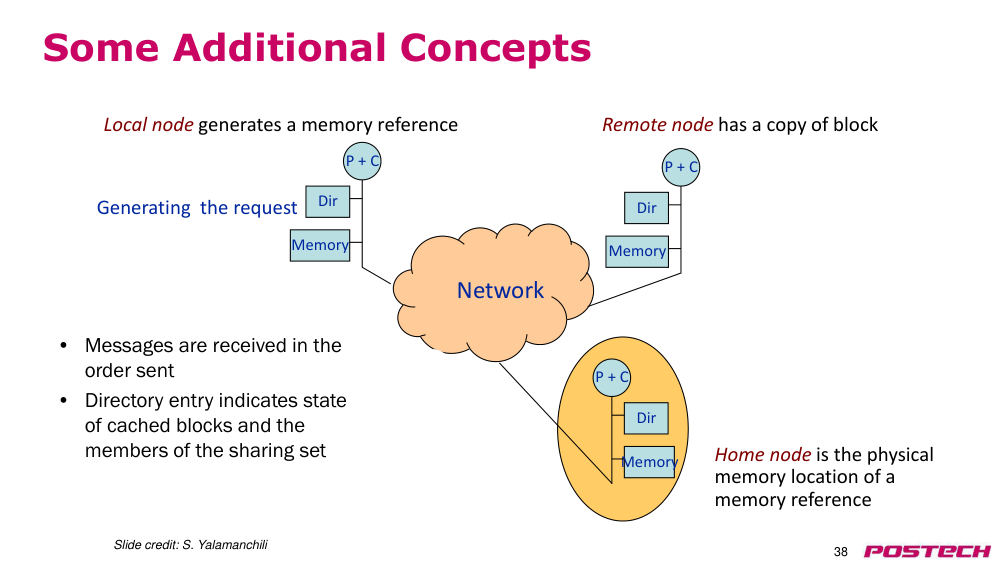
p.38추가 개념들
- 로컬 노드는 메모리 참조를 생성함
- 원격 노드는 블록의 복사본을 보유함
- 홈 노드는 메모리 참조의 물리적 메모리 위치임
- 요청 생성
- 네트워크
- 메시지는 보낸 순서대로 수신됨
- 디렉터리 항목은 캐시된 블록의 상태와 공유 집합의 구성원을 나타냄
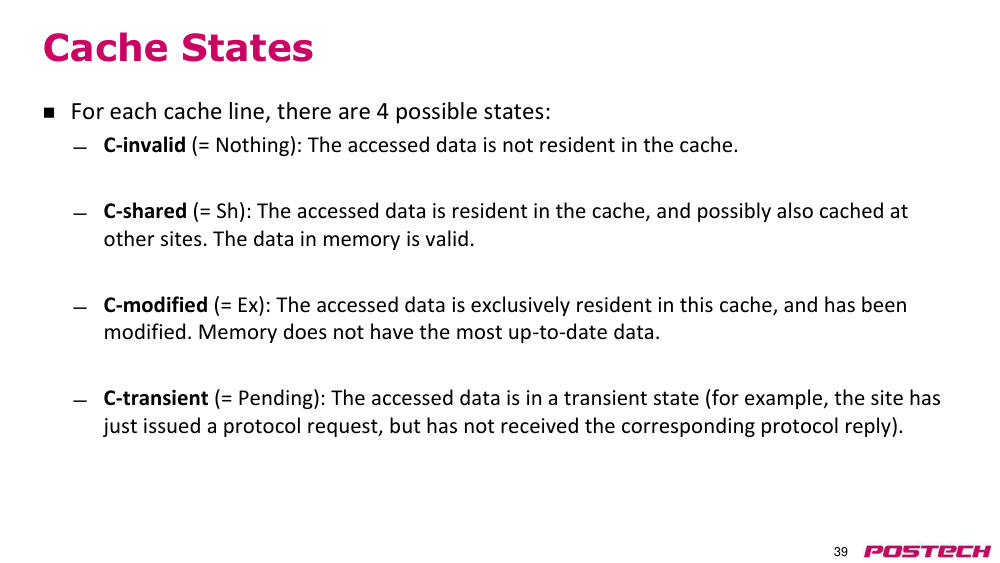
p.39캐시 상태
- 각 캐시 라인에 대해 4가지 가능한 상태 존재:
- C-invalid (= Nothing): 접근된 데이터는 캐시에 존재하지 않음.
- C-shared (= Sh): 접근된 데이터는 캐시에 존재하며, 다른 사이트에도 캐시되어 있을 수 있음. 메모리의 데이터는 유효함.
- C-modified (= Ex): 접근된 데이터는 이 캐시에서 독점적으로 존재하며, 수정됨. 메모리는 최신 데이터를 보유하지 않음.
- C-transient (= Pending): 접근된 데이터가 일시적인 상태에 있음 (예: 프로토콜 요청을 보냈지만, 해당 프로토콜 응답을 받지 못함)
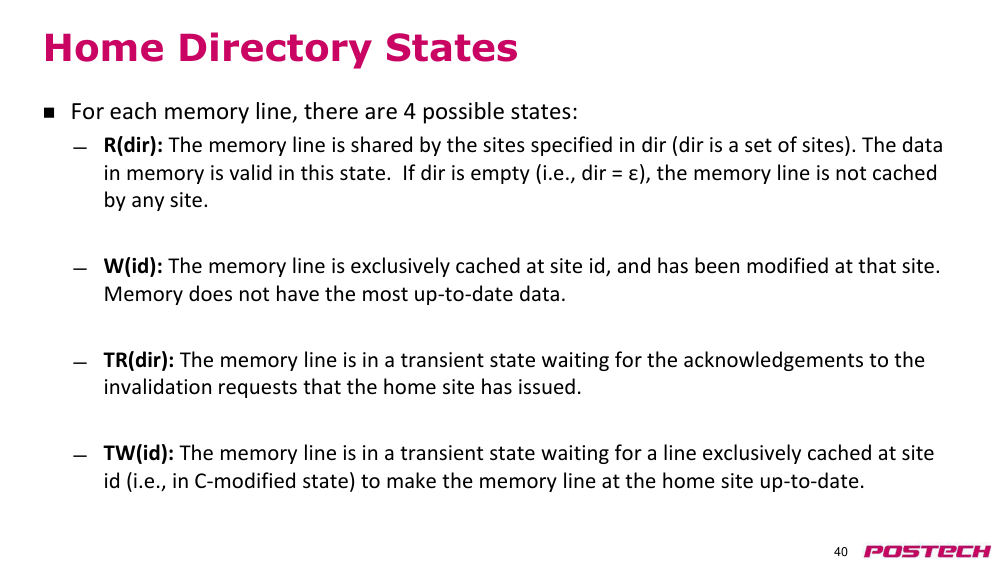
p.40홈 디렉터리 상태
- 각 메모리 라인에 대해 4가지 가능한 상태 존재:
- R(dir): 메모리 라인이 dir에 지정된 사이트들에 의해 공유됨 (dir은 사이트 집합). 이 상태에서 메모리의 데이터는 유효함. dir이 비어 있으면 (즉, dir = ε), 메모리 라인은 어느 사이트에서도 캐시되지 않음.
- W(id): 메모리 라인이 사이트 id에서 독점적으로 캐시되어 있으며, 해당 사이트에서 수정됨. 메모리는 최신 데이터를 보유하지 않음.
- TR(dir): 메모리 라인이 홈 사이트가 발행한 무효화 요청에 대한 확인을 기다리는 일시적인 상태임.
- TW(id): 메모리 라인이 사이트 id에서 독점적으로 캐시된 라인(즉, C-modified 상태)이 홈 사이트의 메모리 라인을 최신 상태로 만들기를 기다리는 일시적인 상태임.
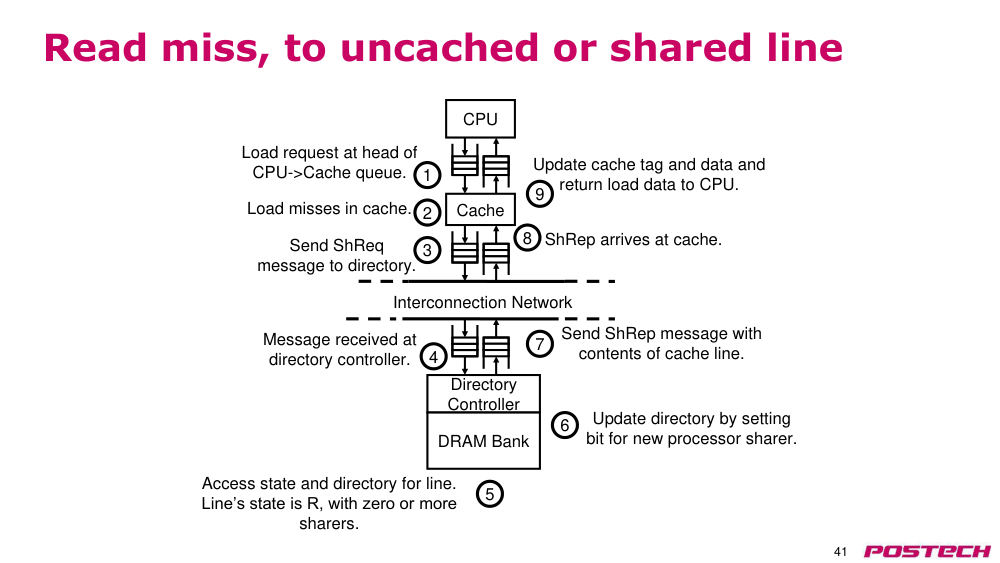
p.41read-miss(읽기 미스), 캐시되지 않거나 공유된 라인에 대한
- CPU → 캐시 큐의 머리에 load(로드) 요청이 있음.
- 캐시에서 read-miss(읽기 미스) 발생.
- 디렉터리로 ShReq 메시지 전송.
- 메시지가 디렉터리 컨트롤러에 도착.
- 라인의 상태와 디렉터리에 접근. 라인 상태는 R이며, 0개 이상의 공유자가 있음.
- 새로운 프로세서 공유자에 대한 비트를 설정하여 디렉터리 업데이트.
- 캐시 라인의 내용을 포함한 ShRep 메시지 전송.
- ShRep 메시지가 캐시에 도착.
- 캐시 태그와 데이터 업데이트 후 CPU에 load(로드) 데이터 반환.
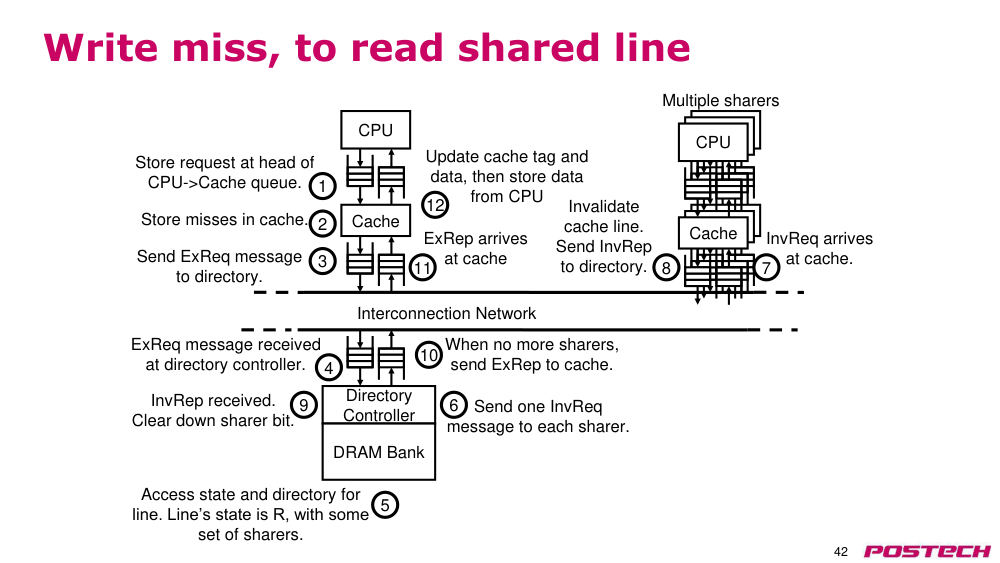
p.42쓰기 미스, 공유된 라인에 대한
- CPU → 캐시 큐의 머리에 store(스토어) 요청이 있음.
- 캐시에서 쓰기 미스 발생.
- 디렉터리로 ExReq 메시지 전송.
- ExReq 메시지가 디렉터리 컨트롤러에 도착.
- 라인의 상태와 디렉터리에 접근. 라인 상태는 R이며, 일부 공유자가 있음.
- 각 공유자에게 InvReq 메시지 전송.
- InvReq 메시지가 캐시에 도착.
- 캐시 라인 무효화. 디렉터리로 InvRep 메시지 전송.
- InvRep 수신. 공유자 비트 해제.
- 공유자가 더 이상 없으면, 캐시로 ExRep 메시지 전송.
- ExRep 메시지가 캐시에 도착.
- 캐시 태그와 데이터 업데이트 후 CPU에서 데이터 store(스토어).
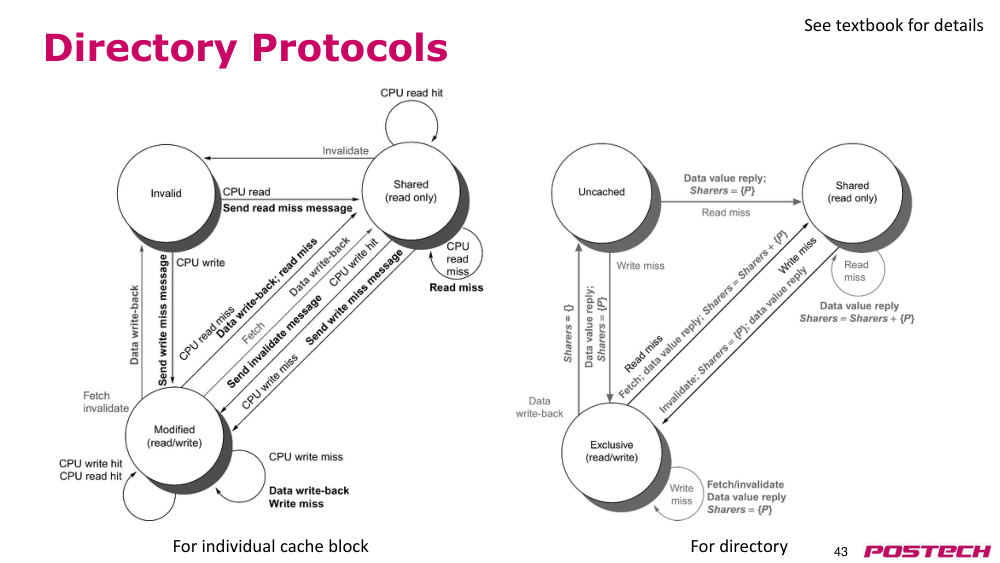
p.43디렉터리 프로토콜
- 개별 캐시 블록에 대해
- 디렉터리에 대해
- 자세한 내용은 교과서를 참조하라
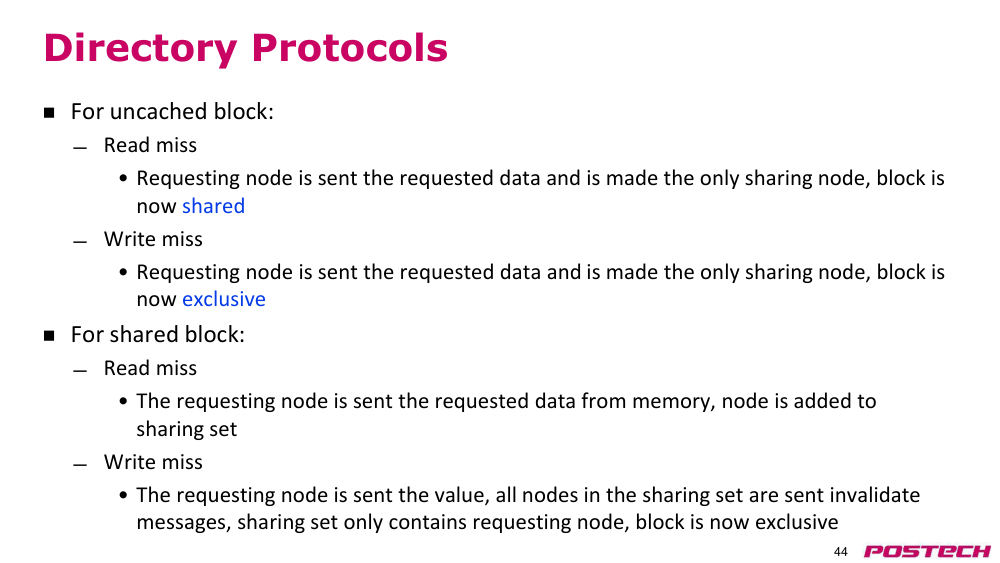
p.44디렉터리 프로토콜
- 미캐시 블록에 대해:
- read-miss(읽기 미스)
- • 요청 노드에게 요청된 데이터가 전달되며, 요청 노드가 유일한 공유 노드가 된다. 블록은 이제 공유 상태가 된다.
- 쓰기 미스
- • 요청 노드에게 요청된 데이터가 전달되며, 요청 노드가 유일한 공유 노드가 된다. 블록은 이제 exclusive state(독점 상태)가 된다.
- 공유 블록에 대해:
- read-miss(읽기 미스)
- • 요청 노드에게 메모리에서 요청된 데이터가 전달되며, 노드가 공유 세트에 추가된다.
- 쓰기 미스
- • 요청 노드에게 값이 전달되며, 공유 세트에 있는 모든 노드에게 무효화 메시지가 전송된다. 공유 세트에는 요청 노드만 포함되며, 블록은 이제 exclusive state(독점 상태)가 된다.
p.45디렉터리 프로토콜
- 독점 블록에 대해:
- read-miss(읽기 미스)
- • 소유자에게 데이터 가져오기 메시지가 전송되며, 블록은 공유 상태가 된다. 소유자가 데이터를 디렉터리에 전달하고, 데이터는 메모리로 다시 쓰여진다. 공유 세트에는 이전 소유자와 요청자가 포함된다.
- 데이터 쓰기 백
- • 블록은 미캐시 상태가 되며, 공유 세트는 비어 있다.
- 쓰기 미스
- • 이전 소유자에게 무효화 및 값 전송 메시지가 전송되며, 요청 노드가 새로운 소유자가 된다. 블록은 여전히 exclusive state(독점 상태)로 유지된다.
p.46개별 캐시 vs. shared cache(공유 캐시)
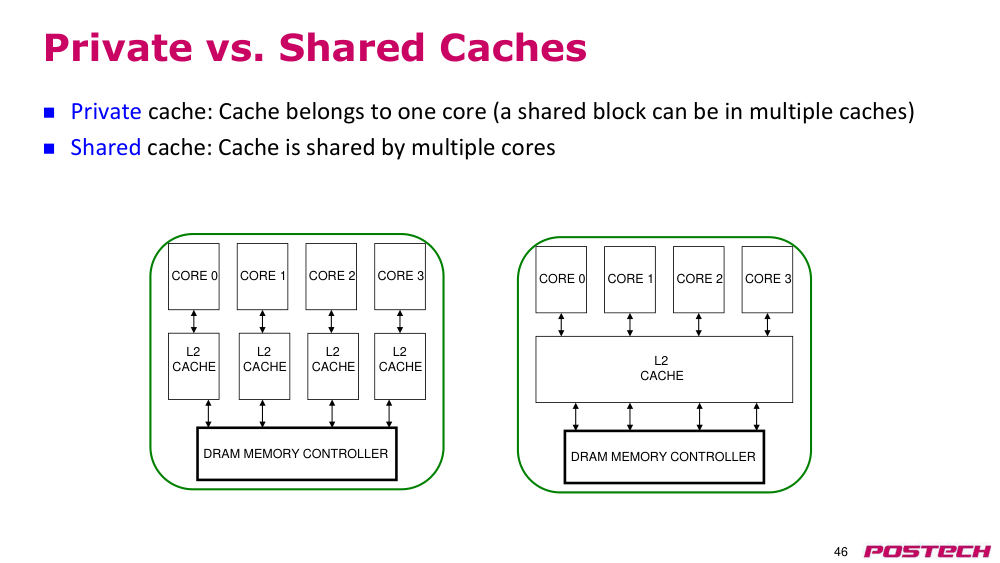
- 개별 캐시: 캐시는 하나의 코어에 속함 (공유 블록은 여러 캐시에 있을 수 있음)
- shared cache(공유 캐시): 캐시가 여러 코어에 의해 공유됨
p.47비균일 캐시 접근 (NUCA)
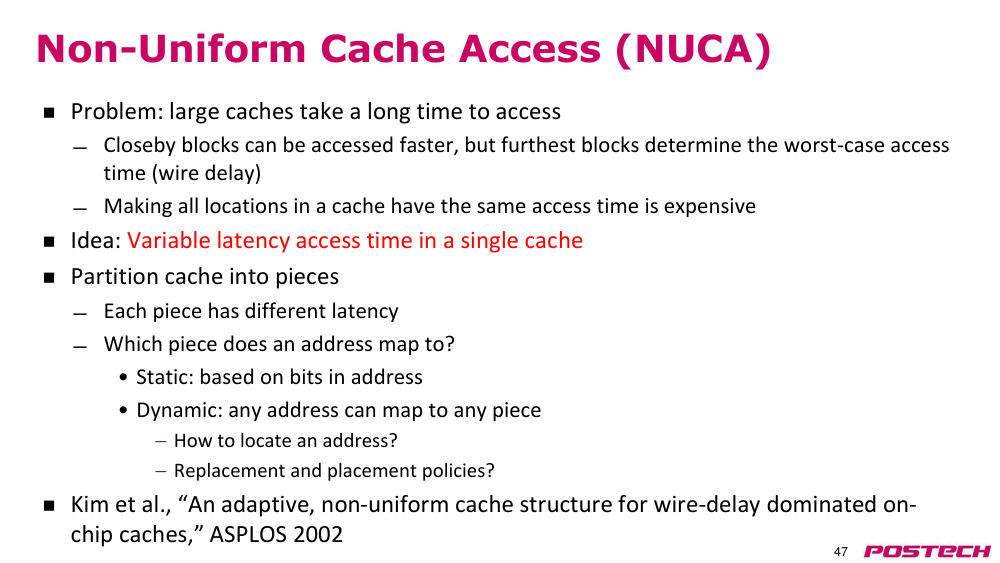
- 문제: 큰 캐시는 접근하는 데 오랜 시간이 걸림
- 가까운 블록은 더 빠르게 접근할 수 있지만, 가장 멀리 떨어진 블록이 최악의 접근 시간을 결정함 (선로 지연)
- 캐시 내 모든 위치에 동일한 접근 시간을 가지게 하는 것은 비쌈
- 아이디어: 단일 캐시 내에서 변수 지연 접근 시간
- 캐시를 조각으로 나누기
- 각 조각은 서로 다른 지연 시간을 가짐
- 어떤 조각에 주소가 매핑되는가?
- • 정적: 주소의 비트에 기반
- • 동적: 어떤 주소도 어떤 조각에 매핑될 수 있음
- • 주소를 어떻게 찾는가?
- • 교체 및 배치 정책은 어떻게 하는가?
- • Kim 등, “An adaptive, non-uniform cache structure for wire-delay dominated on-chip caches,” ASPLOS 2002
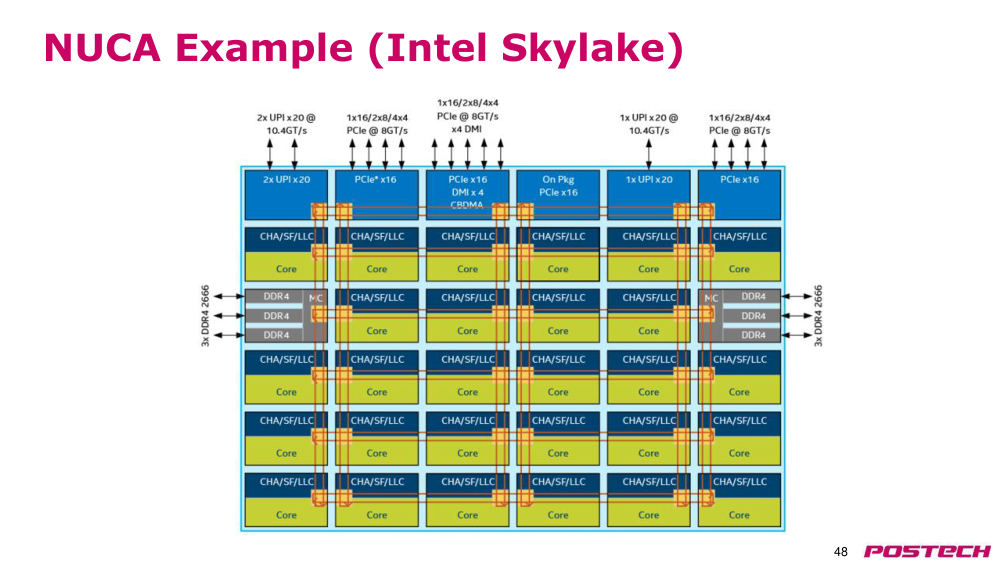
p.48NUCA 예시 (Intel Skylake)
p.49코어 간 shared cache(공유 캐시)
- 장점:
- 높은 효과적 용량
- 사용 가능한 캐시 공간의 동적 분할
- 정적 분할로 인한 블록 분할 없음
- 일관성 유지가 더 쉬움 (캐시 블록은 단일 위치에 있음)
- 공유 데이터와 락이 캐시 간에 왔다 갔다 하지 않음
- 단점:
- 접근 속도가 느림
- 다른 코어의 접근으로 인해 코어 간 conflict miss(충돌 미스) 발생
- 코어 간 간섭으로 인한 미스
- 일부 코어가 다른 코어의 히트율을 저하시킬 수 있음
- 각 코어에 최소 수준의 서비스(또는 공정성)를 보장하는 것이 더 어렵다 (얼마나 많은 공간, 얼마나 많은 대역폭?)
p.50shared cache(공유 캐시): 어떻게 공유할까?
- 자유로운 공유:
- 배치/치환 정책은 단일 코어 시스템과 동일함 (일반적으로 LRU 또는 의사-LRU)
- 스레드/애플리케이션을 인지하지 않음
- 입력 블록은 어떤 스레드에 속해 있는지에 관계없이 블록을 evict(제거)함
- 문제:
- 캐시의 비효율적 이용: LRU는 최적의 정책이 아님
- 캐시 친화적이지 않은 애플리케이션이 캐시 친화적인 애플리케이션의 성능을 저하시킬 수 있음
- 모든 애플리케이션이 동일한 양의 캐시에서 동일한 이점을 얻는 것은 아님: 자유로운 공유는 이점을 얻지 못하는 것을 우선시할 수 있음
- 성능 저하, 공정성 저하
p.51shared cache(공유 캐시)의 문제
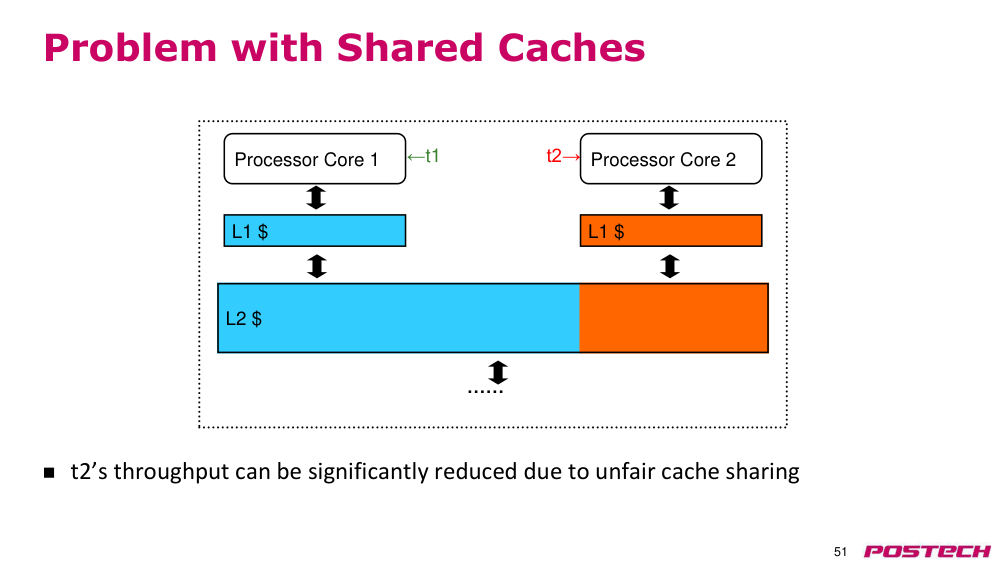
- t2의 처리량은 공정하지 않은 캐시 공유로 인해 크게 감소할 수 있음
- L1 $
- L2 $
- ……
- 프로세서 코어 1
- 프로세서 코어 2
- ←t1
- L1 $
- t2→
p.52질문?
- 추천 독서:
- 교재의 5.1-5.4 장