이 자료를 쓰는 강의: 17 Cache 최적화 후반(non-blocking cache·MSHR·victim·way prediction·compiler) 과 Prefetching 입문 · 19 Prefetching 후반: 성능 metric·software/hardware·FDP·execution-based(runahead)
Lec12 - Prefetching (updated)
한국어판 강의자료 · 48쪽
p.1
p.2강의 11에서 이전 내용
- 3C의 cache miss(캐시 미스)
- compulsory miss(필수적 미스), capacity miss(용량 미스), conflict miss(충돌 미스)
- 쓰기 정책
- write back(쓰기 백), write through(쓰기 스루), write allocate(쓰기 할당), no write allocate(쓰기 할당 없음)
- pipelining write hits(쓰기 히트의 파이프라인화)
- multi-level cache hierarchies(다중 레벨 캐시 계층)은 미스 페널티를 감소시킴
- 현대 시스템에서 3단계가 일반적 (일부는 4단계까지 존재함)
- L2가 존재함을 알고 있다면 L1 cache(L1 캐시)의 설계 트레이드오프를 변경할 수 있음
- inclusive cache(포함 캐시) 계층과 exclusive cache(배타 캐시) 계층
p.3prefetching(프리패치)
- 아이디어: 프로그램이 필요로 하기 전에 데이터를 미리 가져오기 (즉, 사전 가져오기)
- 왜? memory latency(메모리 지연)이 높음. 정확하고 충분히 일찍 prefetching(프리패치)할 수 있다면 그 지연을 줄이거나 제거할 수 있음
- compulsory miss(필수적 미스)를 제거할 수 있음
- 모든 cache miss(캐시 미스)를 제거할 수 있는가? capacity miss(용량 미스), conflict miss(충돌 미스), coherence(코히어런스)?
- 미래에 어떤 주소가 필요할지를 예측하는 것을 포함함
- 프로그램이 예측 가능한 미스 주소 패턴을 가질 경우에 효과적임
p.4prefetching(프리패치)와 정확성
- prefetching(프리패치)에서 잘못된 예측이 정확성에 영향을 미치는가?
- 아니요, 잘못된 주소에 prefetching(프리패치)된 데이터는 단지 사용되지 않을 뿐임
- 상태 복구가 필요 없음
- 반면에 branch misprediction(분기 오예측)이나 value misprediction(값 오예측)과는 다름
p.5기초
- 현대 시스템에서는 prefetching(프리패치)가 보통 cache block granularity(캐시 블록 단위)로 이루어짐
- prefetching(프리패치)는 다음 두 가지를 줄일 수 있는 기술임
- miss rate(미스 비율)
- miss latency(미스 지연)
- prefetching(프리패치)는 다음 방식으로 수행될 수 있음
- 하드웨어
- 컴파일러
- 프로그래머
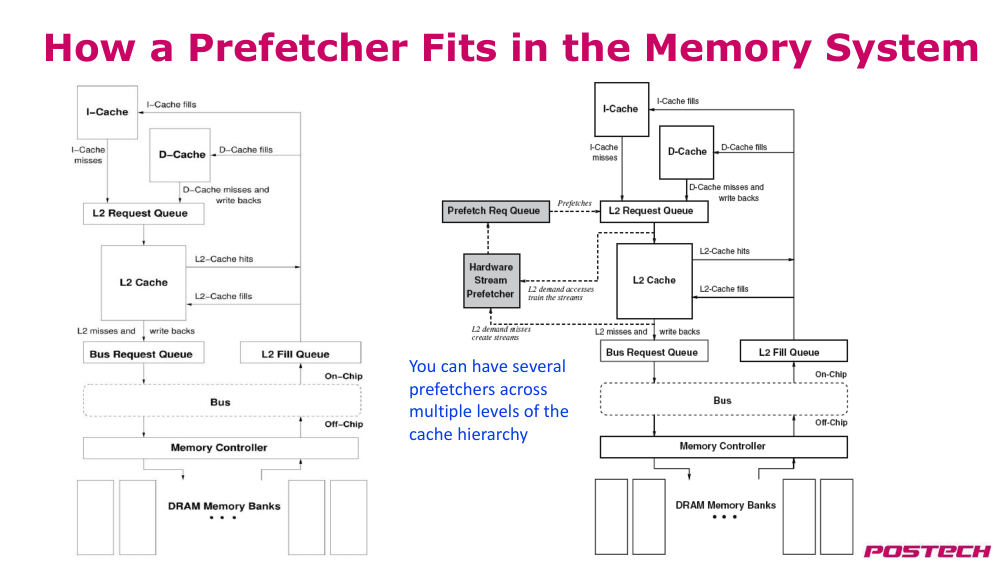
p.6프리패처가 메모리 시스템에 어떻게 통합되는가
- cache hierarchy(캐시 계층)의 여러 레벨에 걸쳐 여러 프리패처를 가질 수 있음
p.7prefetching(프리패치): 네 가지 질문
- 어떤 주소를 prefetching(프리패치)할 것인가
- 언제 prefetching(프리패치) 요청을 시작할 것인가
- prefetching(프리패치)된 데이터를 어디에 배치할 것인가
- 어떻게 prefetching(프리패치)할 것인가: 소프트웨어, 하드웨어, 실행 기반, 협업 방식
p.8prefetching(프리패치)의 도전 과제: 무엇을
- 어떤 주소를 prefetching(프리패치)할 것인가
- 무용한 데이터를 prefetching(프리패치)하면 자원 낭비
- • memory bandwidth(메모리 대역폭)
- • 캐시 또는 prefetch buffer(프리패치 버퍼) 공간
- • 에너지 소비
- • 이러한 자원들은 demand access(요청 접근)이나 더 정확한 prefetching(프리패치) 요청에 사용될 수 있음
- • prefetching(프리패치)할 주소를 정확히 예측하는 것이 중요함
- • prefetch accuracy(프리패치 정확도) = 사용된 prefetching(프리패치) 수 / 전송된 프리패치 수
- • 무엇을 prefetching(프리패치)할지 어떻게 알 수 있는가
- • 과거 접근 패턴을 기반으로 예측함
- • 컴파일러가 데이터 구조에 대한 지식을 활용함
- • prefetching(프리패치) 알고리즘은 무엇을 프리패치할지 결정함
p.9prefetching(프리패치)의 도전 과제: 언제
- 언제 prefetching(프리패치) 요청을 시작할 것인가
- 너무 일찍 prefetching(프리패치)하는 경우
- • prefetching(프리패치)된 데이터가 접근되기 전에 교체될 수 있음
- 너무 늦게 prefetching(프리패치)하는 경우
- • 전체 memory latency(메모리 지연)을 숨길 수 없음
- • 데이터를 prefetching(프리패치)하는 시점은 프리패처의 적시성에 영향을 미침
- • 프리패처를 더 적시성 있게 만들기 위해
- • 더 공격적으로 만들기: 프로세서의 접근 스트림보다 앞서 나가려는 시도 (하드웨어)
- • 코드 내에서 prefetch instruction(프리패치 명령어)를 더 앞쪽으로 이동시키기 (소프트웨어)
p.10prefetching(프리패치)의 도전 과제: 어디에 (I)
- prefetching(프리패치)된 데이터를 어디에 배치할 것인가
- 캐시에 배치하는 경우
- • 간단한 설계, 별도의 버퍼 필요 없음
- • 단점: 유용한 요청 데이터를 교체할 수 있음 (캐시 오염)
- 별도의 prefetch buffer(프리패치 버퍼)에 배치하는 경우
- • 요청 데이터가 prefetching(프리패치)로부터 보호됨 → cache pollution(캐시 오염) 없음
- • 더 복잡한 메모리 시스템 설계
- • prefetch buffer(프리패치 버퍼)를 어디에 배치할 것인가
- • prefetch buffer(프리패치 버퍼)에 접근하는 시점 (캐시와 병렬 vs. 직렬)
- • prefetch buffer(프리패치 버퍼)에서 캐시로 데이터를 이동하는 시점
- • prefetch buffer(프리패치 버퍼) 크기를 어떻게 설정할 것인가
- • prefetch buffer(프리패치 버퍼)의 일관성 유지
- • 많은 현대 시스템은 prefetching(프리패치)된 데이터를 캐시에 배치함
p.11prefetching(프리패치)의 도전 과제: 어디에 (II)
- 어느 레벨의 캐시에 prefetching(프리패치)할 것인가?
- 메모리 → L2, 메모리 → L1. 장단점은?
- L2 → L1? (레벨 간 별도의 프리패처)
- 캐시 내에서 prefetching(프리패치)된 데이터를 어디에 배치할 것인가?
- prefetching(프리패치) 블록을 요청으로 가져온 블록과 동일하게 취급할 것인가?
- prefetching(프리패치) 블록은 필요한 것이 알려지지 않음
- • LRU 정책에서는 요청 블록을 MRU 위치에 배치함
- • 요청으로 가져온 블록을 우선시하는 방식으로 교체 정책을 왜곡할 것인가?
- • 예: 모든 prefetching(프리패치)를 LRU 위치에 배치하는 방식?
p.12prefetching(프리패치)의 도전 과제: 어디에 (III)
- hardware prefetcher(하드웨어 프리패처)를 메모리 계층의 어디에 배치할 것인가?
- 즉, 프리패처가 어떤 접근 패턴을 보게 되는가?
- L1 히트 및 미스
- L1 미스만
- L2 미스만
- 더 완전한 접근 패턴을 보는 경우
- • prefetching(프리패치)의 정확도와 커버리지가 더 높을 수 있음
- • 프리패처가 더 많은 요청을 검사해야 함 (대역폭 집약적, 프리패처에 더 많은 포트 필요?)
p.13prefetching(프리패치)의 도전 과제: 어떻게?
- software prefetching(소프트웨어 프리패치)
- 명령어 세트 아키텍처(ISA)가 prefetch instruction(프리패치 명령어) 제공
- 프로그래머 또는 컴파일러가 prefetch instruction(프리패치 명령어) 삽입 (노력 필요)
- 일반적으로 '정규적인 접근 패턴'에서만 잘 작동
- 하드웨어 prefetching(프리패치)
- 하드웨어가 프로세서의 접근 모니터링
- 패턴/스트라이드를 기억하거나 탐지
- 자동으로 prefetching(프리패치) 주소 생성
- execution-based prefetcher(실행 기반 프리패처)
- 한 개의 '스레드'가 메인 프로그램을 위한 데이터를 prefetching(프리패치)하도록 실행
- 소프트웨어/프로그래머 또는 하드웨어에 의해 생성될 수 있음
p.14프리패처 성능 (I)
- 정확도 (사용된 prefetching(프리패치) / 전송된 프리패치)
- 커버리지 (프리패치된 미스 / 전체 미스)
- 적시성 (적시에 도착한 prefetching(프리패치) / 사용된 프리패치)
- 대역폭 소비
- 프리패처 사용 시 memory bandwidth(메모리 대역폭) 소비 / 미사용 시
- 좋은 소식: idle bus bandwidth(유휴 버스 대역폭) 활용 가능 (가용한 경우)
- cache pollution(캐시 오염)
- prefetching(프리패치)로 인해 캐시에 배치된 데이터로 인한 추가 요청 미스
- 정량화하기 어려우나 성능에 영향
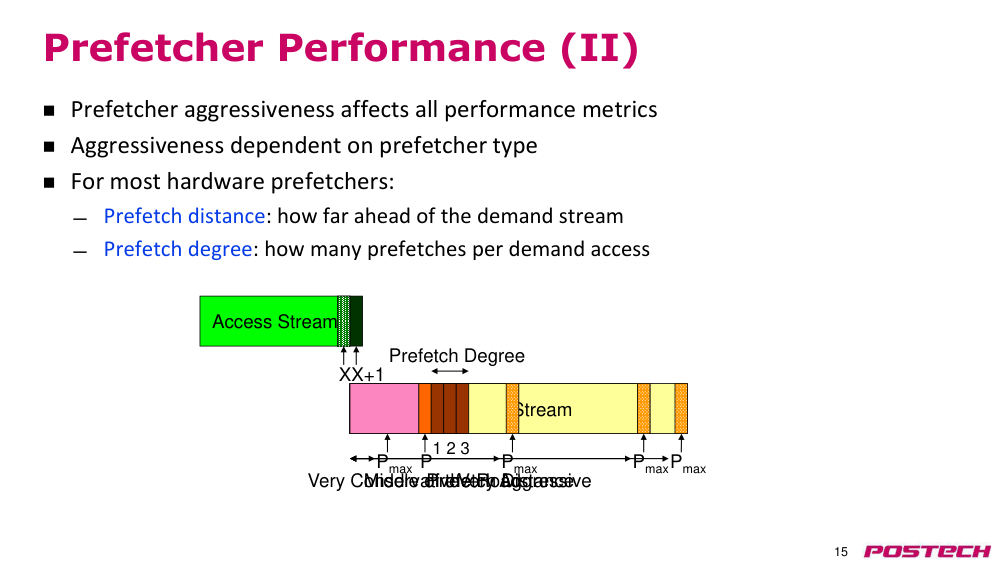
p.15프리패처 성능 (II)
- 프리패처의 aggressiveness(공격성)은 모든 성능 지표에 영향
- aggressiveness(공격성)은 프리패처 유형에 따라 다름
- 대부분의 hardware prefetcher(하드웨어 프리패처)에 대해:
- prefetch distance(프리패치 거리): 요청 스트림보다 얼마나 앞서서 prefetching(프리패치)할 것인가
- prefetch degree(프리패치 차수): demand access(요청 접근)당 몇 개의 prefetching(프리패치) 수행할 것인가
- 예측된 스트림
- 예측된 스트림
- X
- 접근 스트림
- Pmax
- prefetch distance(프리패치 거리)
- Pmax
- 매우 보수적
- Pmax
- 보통
- Pmax
- 매우 공격적
- P
- prefetch degree(프리패치 차수)
- X+1
- 1 2 3
p.16소프트웨어 프리패치 (I)
- 아이디어: 컴파일러/프로그래머가 코드 내 적절한 위치에 prefetch instruction(프리패치 명령어) 삽입
- Mowry 등, “Design and Evaluation of a Compiler Algorithm for Prefetching,” ASPLOS 1992.
- 두 가지 유형: binding prefetch(바인딩 프리패치) vs. non-binding prefetch
- binding prefetch(바인딩 프리패치): 레지스터로 프리패치 (일반적인 로드 사용)
- + 별도의 'prefetching(프리패치)' 명령어 필요 없음
- -- 레지스터 사용. 예외 발생 가능성?
- -- 다른 프로세서가 데이터 값을 사용하기 전에 수정하면 어떻게 되는가?
- non-binding prefetch: 캐시로 프리패치 (특수 명령어?)
- + 캐시가 일관성 있으므로 일관성 문제 없음
- -- prefetching(프리패치)는 일반적인 로드와 다르게 처리됨
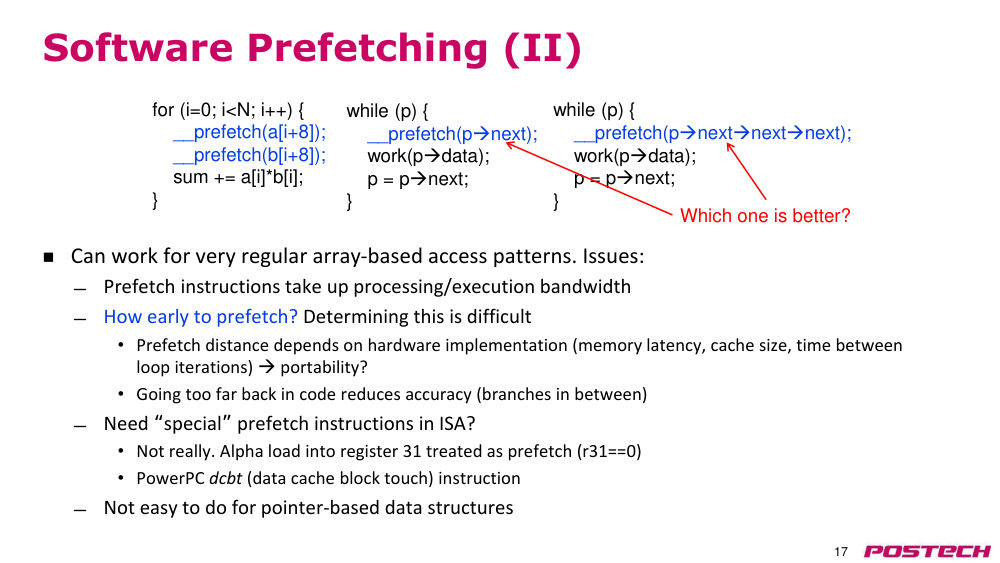
p.17소프트웨어 프리패치 (II)
- 매우 정규적인 배열 기반 접근 패턴에 효과적. 문제점:
- prefetch instruction(프리패치 명령어)가 처리/실행 대역폭을 차지
- 얼마나 일찍 prefetching(프리패치)할 것인가? 결정하기 어려움
- • prefetch distance(프리패치 거리)는 하드웨어 구현에 따라 다름 (메모리 지연, 캐시 크기, 루프 반복 간 시간) → portability(이식성)?
- • 코드에서 너무 앞서 prefetching(프리패치)하면 정확도 저하 (간접적인 분기 존재 시)
- • ISA에 '특별한' prefetch instruction(프리패치 명령어) 필요?
- • 사실상 필요 없음. Alpha load into register 31(Alpha 레지스터 31 로드)는 prefetching(프리패치)로 간주 (r31==0)
- • PowerPC dcbt (data cache block touch) 명령어
- • 포인터 기반 데이터 구조에는 적용하기 어려움
- for (i=0; i<N; i++) {
- __prefetch(a[i+8]);
- __prefetch(b[i+8]);
- sum += a[i]*b[i];
- }
- while (p) {
- __prefetch(p→next);
- work(p→data);
- p = p→next;
- }
- while (p) {
- __prefetch(p→next→next→next);
- work(p→data);
- p = p→next;
- }
- 어느 것이 더 좋은가?
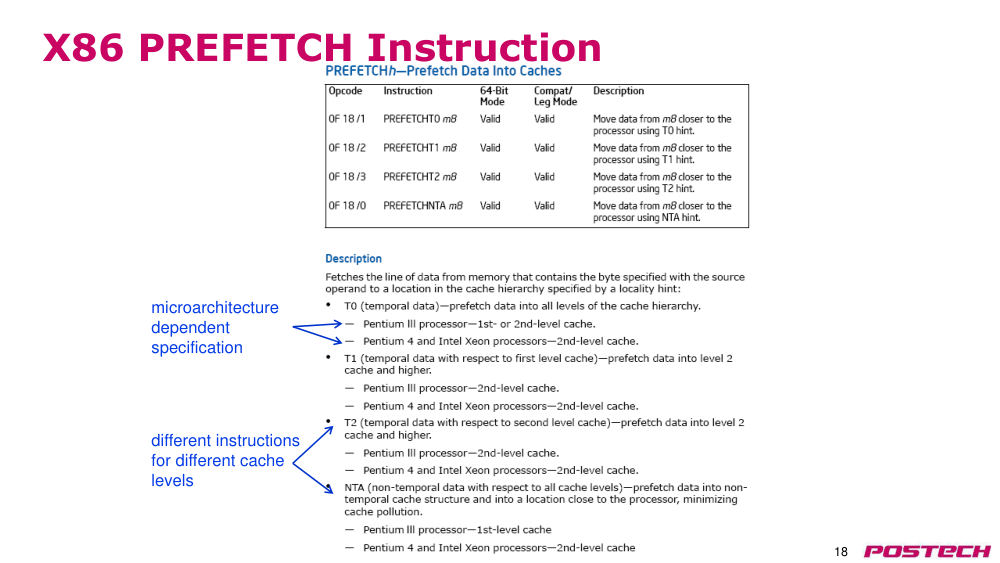
p.18X86 prefetch instruction(프리패치 명령어)
- 마이크로아키텍처에 의존적
- 사양
- 다른 캐시 레벨에 따라 다른 명령어
p.19소프트웨어 프리패치 (III)
- 컴파일러는 prefetching(프리패치)를 어디에 삽입해야 하는가?
- 모든 로드 접근에 대해 prefetching(프리패치)를 수행할 것인가?
- • 메모리 및 실행 대역폭 사용이 지나치게 많음
- 코드를 프로파일링하여 미스가 발생할 가능성이 높은 로드를 결정
- • 프로파일 입력 세트가 대표적이지 않을 경우는?
- 미스 발생 전에 얼마나 앞서 prefetching(프리패치)를 삽입해야 하는가?
- • 다양한 prefetch distance(프리패치 거리)에 대한 사용 확률을 프로파일링하여 결정
- • 프로파일 입력 세트가 대표적이지 않을 경우는?
- • 일반적으로 main memory latency(메인 메모리 지연)의 수백 사이클을 커버하기 위해 미스 발생 전에 매우 앞서 prefetching(프리패치)를 삽입해야 함 → 정확도 감소
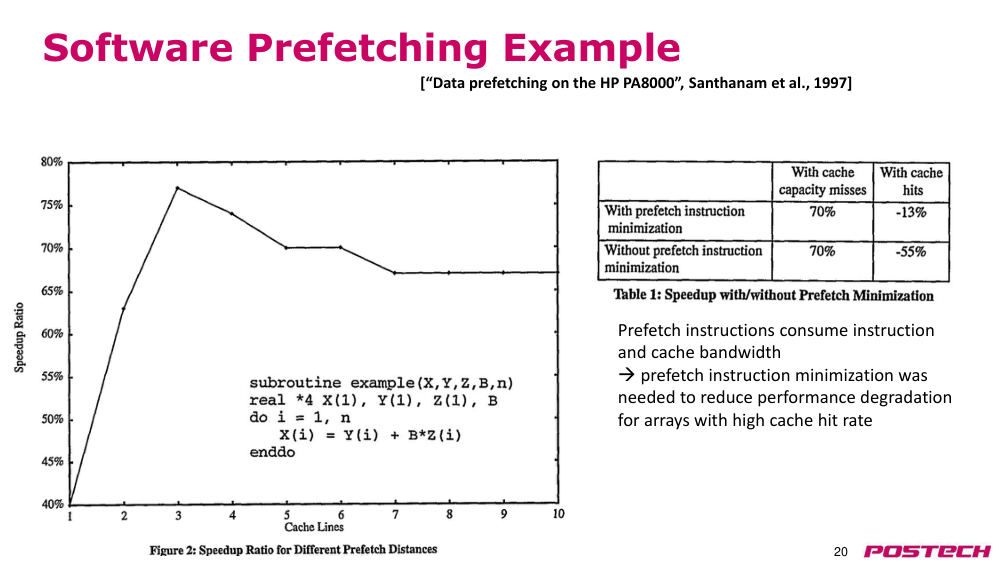
p.20software prefetching(소프트웨어 프리패치) 예시
- [“HP PA8000에서의 데이터 prefetching(프리패치)”, Santhanam 등, 1997]
- prefetch instruction(프리패치 명령어)는 명령어 및 캐시 대역폭을 소비함
- → cache hit(캐시 히트)율이 높은 배열의 성능 저하를 줄이기 위해 prefetch instruction(프리패치 명령어) 최소화가 필요함
p.21하드웨어 프리패치 (I)
- 아이디어: 전용 하드웨어가 로드/스토어 접근 패턴을 관찰하고 과거 접근 행동에 기반하여 데이터를 prefetching(프리패치)
- 교환 조건:
- + 시스템 구현에 맞게 조정 가능
- + 코드의 portability(이식성) 문제 없음 (구현 간 성능 변동 없음)
- + 명령어 실행 대역폭 낭비 없음
- − pattern detection(패턴 탐지)를 위한 hardware complexity(하드웨어 복잡성) 증가
- • 일부 경우에 소프트웨어가 더 효율적일 수 있음
p.22next-line prefetcher(다음 라인 프리패처)
- 하드웨어 prefetching(프리패치)의 가장 단순한 형태: 요청 접근(또는 요청 미스) 후 항상 다음 N개의 캐시 블록을 프리패치
- 다음 라인 프리패처(또는 다음 순차 프리패처)
- 교환 조건:
- + 구현이 간단. 정교한 pattern detection(패턴 탐지) 필요 없음
- + 순차/스트리밍 접근 패턴(명령어?)에 잘 작동
- − 비정규 패턴에서는 대역폭 낭비 발생 가능
- • 접근 스트라이드 = 2이고 N = 1일 경우 prefetch accuracy(프리패치 정확도)는?
- • 프로그램이 높은 주소에서 낮은 주소로 메모리 탐색하는 경우는?
- • 또한 이전 N개의 캐시 블록도 prefetching(프리패치)하는가?
p.23stride prefetcher(스트라이드 프리패처)
- 두 가지 유형
- 명령어 프로그램 카운터(PC) 기반
- 캐시 블록 주소 기반
- 명령어 기반:
- Baer 및 Chen, “데이터 접근 지연을 줄이기 위한 효과적인 온칩 프리로딩 기법”, SC 1991.
- 아이디어:
- • load instruction(로드 명령어)가 참조하는 메모리 주소 간의 거리(즉, 로드의 스트라이드)와 마지막으로 참조한 주소를 기록
- • 다음에 동일한 load instruction(로드 명령어)가 가져와질 때, 마지막 주소 + 스트라이드를 prefetching(프리패치)
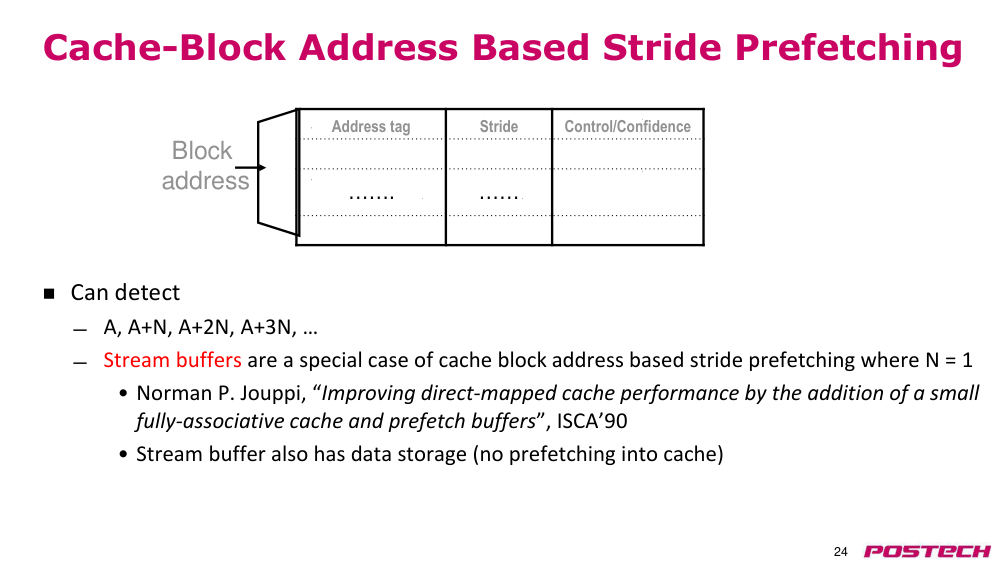
p.24cache block address based stride prefetching(캐시 블록 주소 기반 스트라이드 프리패치)
- 다음 패턴을 탐지할 수 있음:
- A, A+N, A+2N, A+3N, …
- stream buffer(스트림 버퍼)는 N = 1인 cache block address based stride prefetching(캐시 블록 주소 기반 스트라이드 프리패치)의 특수한 경우
- • Norman P. Jouppi, “작은 완전 연관 캐시와 prefetch buffer(프리패치 버퍼)의 추가로 직접 매핑 캐시 성능 향상”, ISCA’90
- • stream buffer(스트림 버퍼)는 데이터 저장소도 갖추고 있음(캐시에 prefetching(프리패치)하지 않음)
- 주소 태그
- 스트라이드
- 제어/신뢰도
- …….
- ……
- 블록 주소
p.25스트림 버퍼 (Jouppi, ISCA 1990)
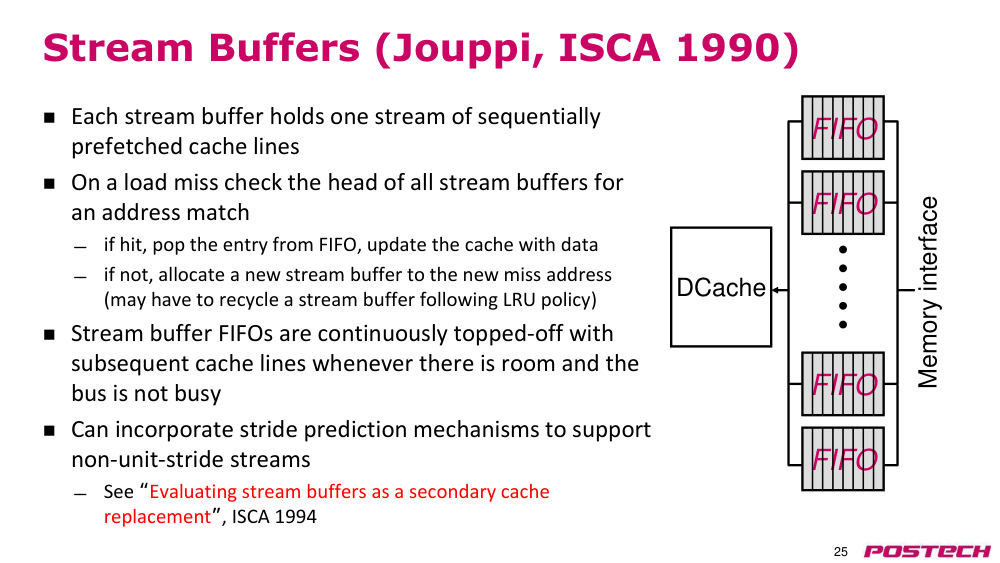
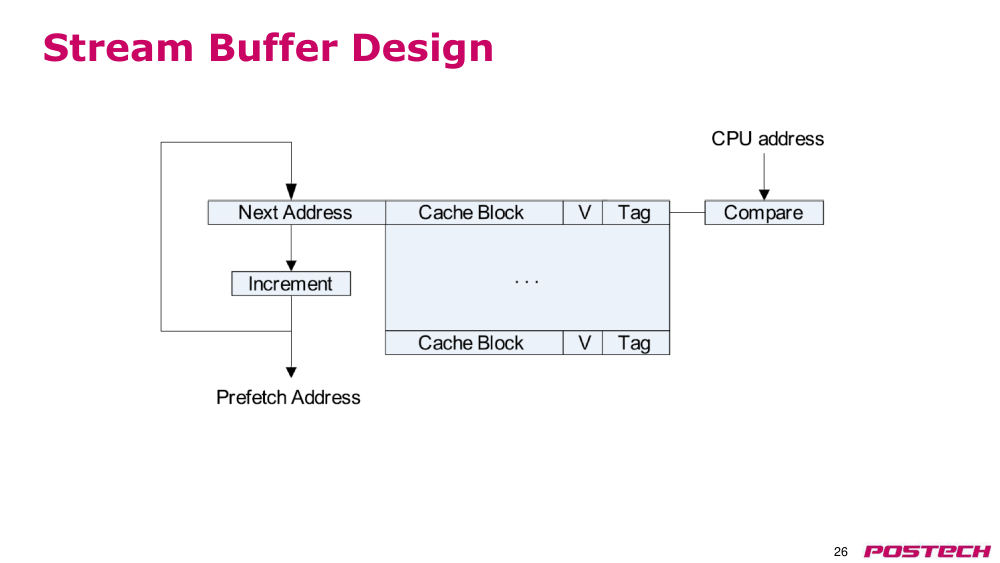
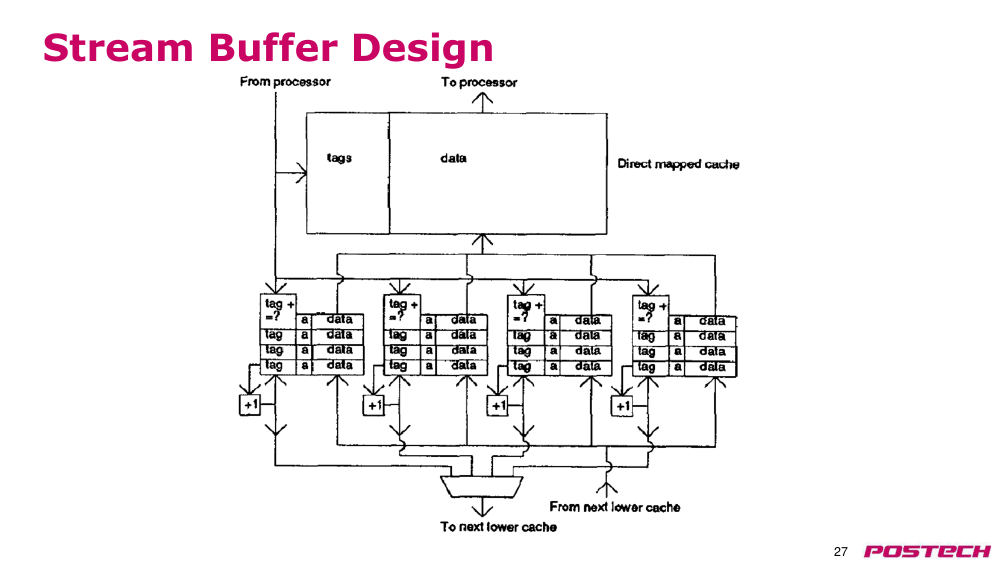
- 각 stream buffer(스트림 버퍼)는 순차적으로 prefetching(프리패치)된 캐시 라인의 한 스트림을 저장한다.
- 로드 미스 발생 시, 모든 stream buffer(스트림 버퍼)의 머리 부분에서 주소 매칭을 확인한다.
- 매칭이 있으면 FIFO에서 엔트리를 제거하고, 캐시를 데이터로 갱신한다.
- 매칭이 없으면 새로운 미스 주소에 대해 새로운 stream buffer(스트림 버퍼)를 할당한다 (LRU 정책에 따라 기존 버퍼를 재사용해야 할 수 있음).
- stream buffer(스트림 버퍼) FIFO는 버스가 바쁘지 않고 공간이 있을 때마다 다음 캐시 라인으로 지속적으로 채워진다.
- 비단위 스트라이드 스트림을 지원하기 위해 스트라이드 예측 메커니즘을 통합할 수 있다.
- 자세한 내용은 ‘stream buffer(스트림 버퍼)를 2차 캐시 교체 기법으로 평가하기’, ISCA 1994 참조.
p.26stream buffer(스트림 버퍼) 설계
p.27stream buffer(스트림 버퍼) 설계
p.28지역성 기반 프리패처
- 많은 응용 프로그램에서 접근 패턴은 완전히 스트라이드되지 않는다.
- 근접한 주소들 사이에서는 패턴이 무작위처럼 보일 수 있다.
- 이러한 접근을 어떻게 포착할 수 있는가?
- 지역성 기반 prefetching(프리패치)
- Srinath 등, “feedback-directed prefetching(피드백 기반 프리패치): hardware prefetcher(하드웨어 프리패처)의 성능과 대역폭 효율성 향상”, HPCA 2007.
p.29Pentium 4 (Like) Prefetcher [Srinath 등, HPCA’07]
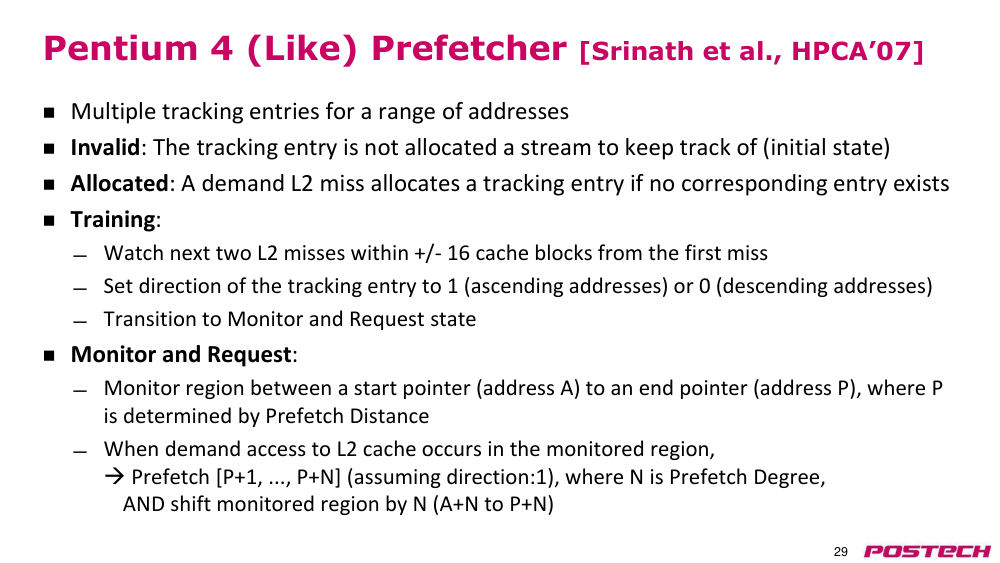
- 주소 범위에 대해 여러 tracking entry(트래킹 엔트리)를 사용한다.
- Invalid(무효): tracking entry(트래킹 엔트리)가 스트림을 추적하기 위해 할당되지 않은 상태 (초기 상태).
- Allocated(할당됨): 대응하는 tracking entry(트래킹 엔트리)가 없으면 demand L2 miss(요청 L2 미스)가 tracking entry(트래킹 엔트리)를 할당한다.
- Training(학습):
- 첫 번째 미스로부터 +/- 16개의 캐시 블록 내에 있는 다음 두 개의 L2 미스를 관찰한다.
- tracking entry(트래킹 엔트리)의 방향을 1(오름차순 주소) 또는 0(내림차순 주소)로 설정한다.
- Monitor and Request state(모니터 및 요청 상태)로 전이한다.
- Monitor and Request(모니터 및 요청):
- 시작 포인터(A)에서 끝 포인터(P)까지의 영역을 모니터링한다. 여기서 P는 prefetch distance(프리패치 거리)에 의해 결정된다.
- 모니터링 영역 내에서 L2 cache(L2 캐시)에 demand access(요청 접근)이 발생하면,
- → [P+1, ..., P+N] 범위의 데이터를 prefetching(프리패치)한다 (방향이 1인 경우), 여기서 N은 prefetch degree(프리패치 차수)이며,
- 모니터링 영역을 N만큼 이동시킨다 (A+N에서 P+N로).
p.30지역성 기반 프리패처의 한계
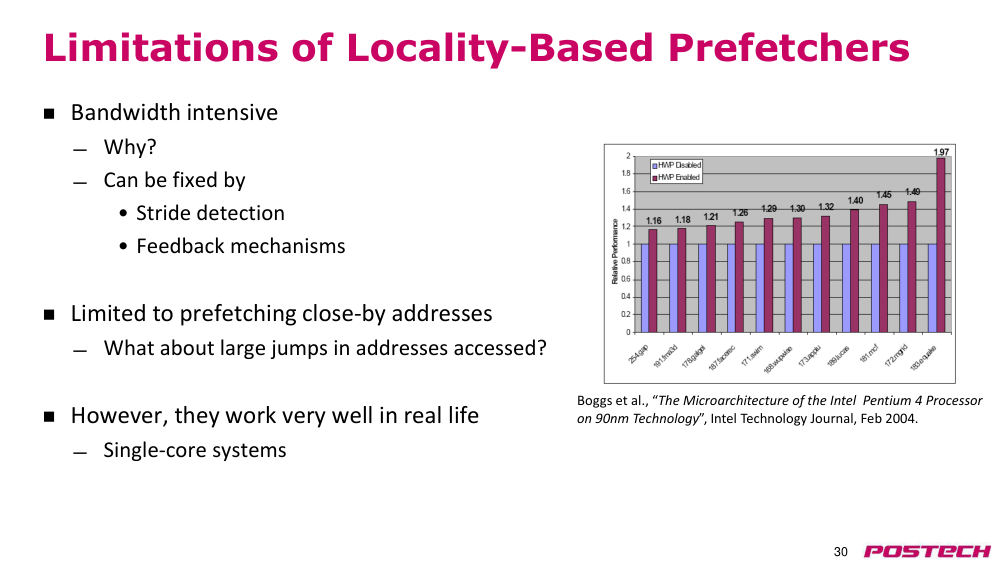
- 대역폭 집약적이다.
- 왜냐하면?
- 다음과 같은 방법으로 개선할 수 있다:
- • 스트라이드 탐지
- • 피드백 메커니즘
- 근접한 주소만 prefetching(프리패치)할 수 있다.
- 접근 주소에서 큰 점프가 발생할 경우는 어떻게 할 것인가?
- 그러나 실세계에서는 매우 잘 작동한다.
- 싱글 코어 시스템
- Boggs 등, “90nm 기술에서의 Intel Pentium 4 프로세서 마이크로아키텍처”, Intel Technology Journal, 2004년 2월.
p.31prefetch accuracy(프리패치 정확도)
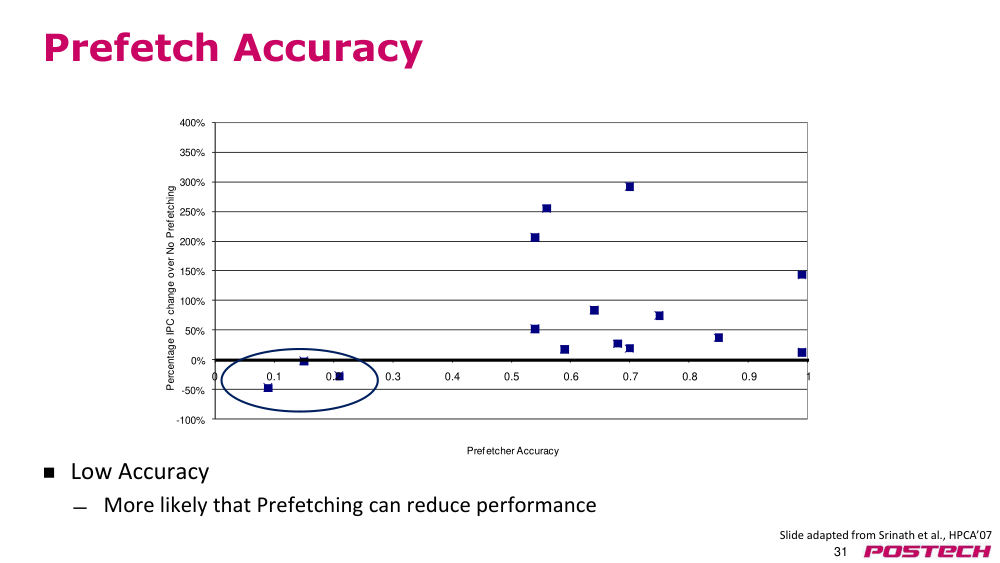
- 낮은 정확도 → prefetching(프리패치)가 성능을 저하시킬 가능성이 더 높음
- 프리패처 정확도에 따른 IPC 변화 비율 (비프리패치 대비)
- 0%에서 400%까지의 IPC 변화 비율을 나타냄
- 정확도가 낮을수록 성능 저하 가능성 증가
p.32feedback-directed prefetching(피드백 기반 프리패치)
- 포괄적인 메커니즘으로 다음을 고려함:
- 프리패처 정확도
- 프리패처의 지연
- prefetching(프리패치)로 인한 cache pollution(캐시 오염)
- 다음 요소들을 적응적으로 조정함:
- 프리패처의 aggressiveness(공격성)
- 캐시 삽입 정책
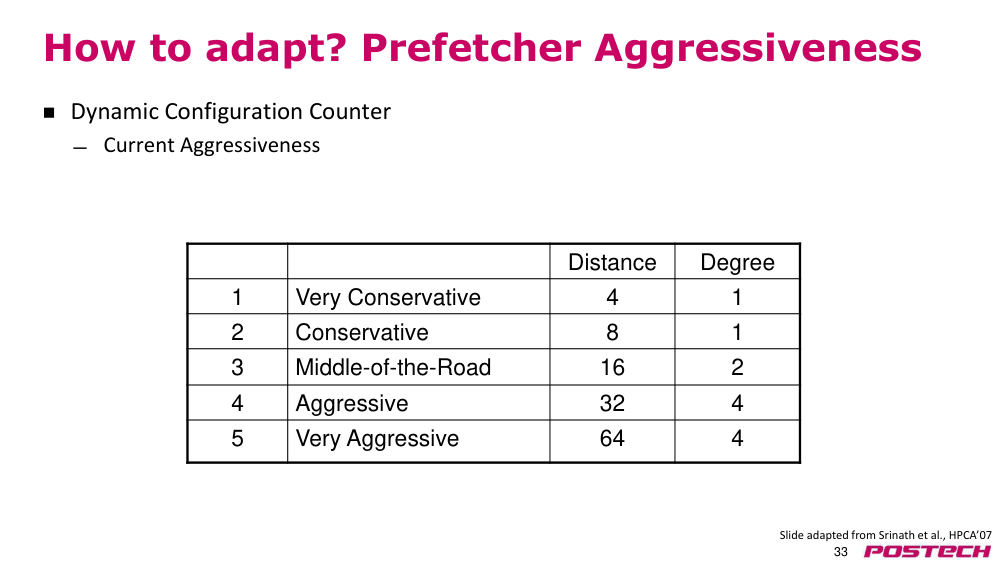
p.33어떻게 적응할까? 프리패처 aggressiveness(공격성)
- 동적 구성 카운터를 사용하여 현재 aggressiveness(공격성) 설정
- aggressiveness(공격성) 수준: 매우 보수적, 보수적, 중간, 공격적, 매우 공격적
- 각 수준에 따른 prefetch distance(프리패치 거리) 및 차수 설정
- 예: 매우 보수적 → 거리 4, 차수 1
- 예: 매우 공격적 → 거리 64, 차수 4
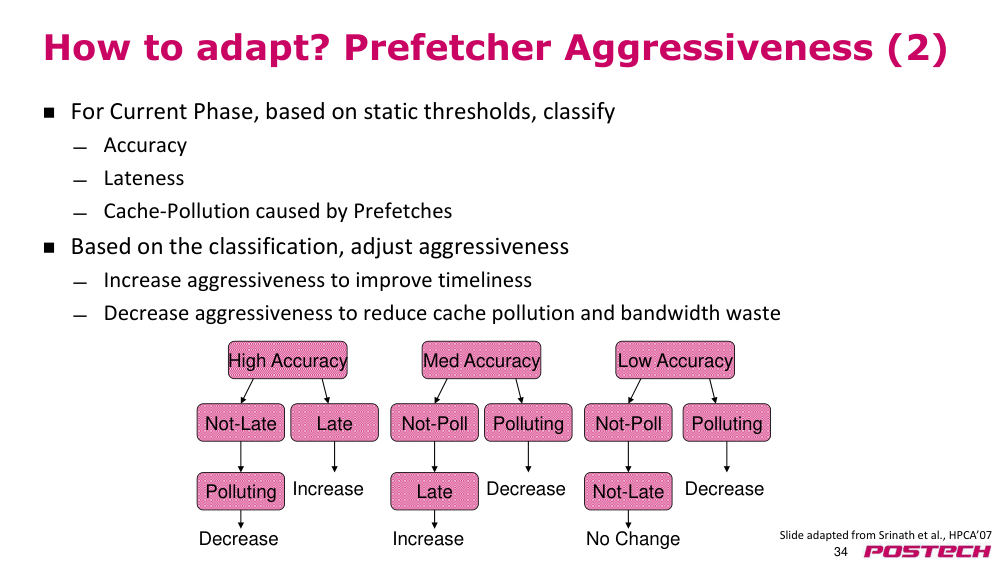
p.34어떻게 적응할까? 프리패처 공격성 (2)
- 현재 단계에서 정적 임계값을 기반으로 다음을 분류함:
- 정확도
- 지연 여부
- prefetching(프리패치)로 인한 cache pollution(캐시 오염) 여부
- 분류 결과에 따라 aggressiveness(공격성) 조정:
- 적시성 향상을 위해 aggressiveness(공격성) 증가
- cache pollution(캐시 오염) 및 대역폭 낭비 감소를 위해 aggressiveness(공격성) 감소
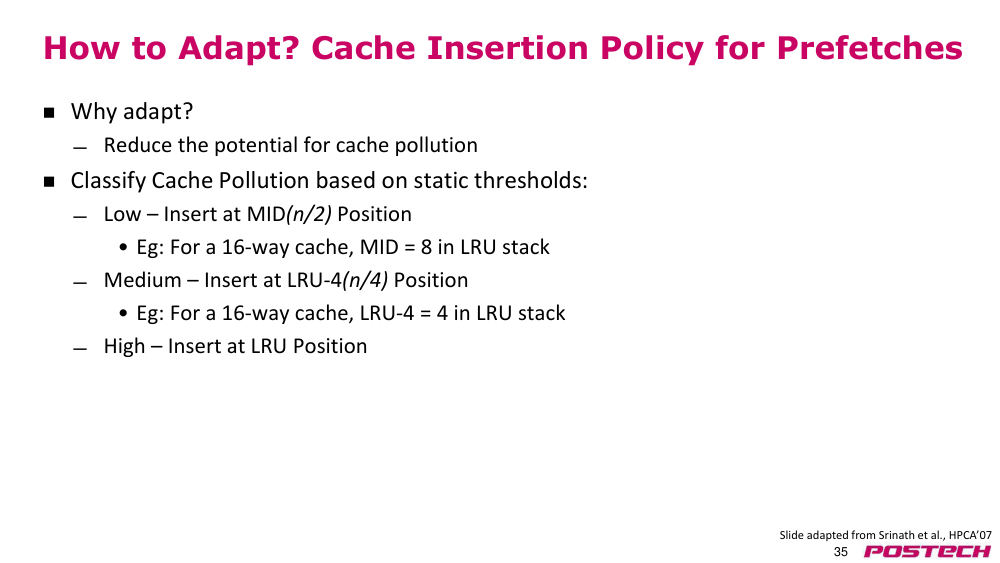
p.35어떻게 적응할까? prefetching(프리패치)를 위한 캐시 삽입 정책
- 왜 적응할까?
- cache pollution(캐시 오염) 가능성 감소
- 정적 임계값 기반으로 cache pollution(캐시 오염) 수준 분류:
- 낮음 – MID(n/2) 위치에 삽입
- 예: 16-way 캐시 → LRU 스택에서 중간 위치(8)
- 중간 – LRU-4(n/4) 위치에 삽입
- 예: 16-way 캐시 → LRU 스택에서 4위
- 높음 – LRU 위치에 삽입
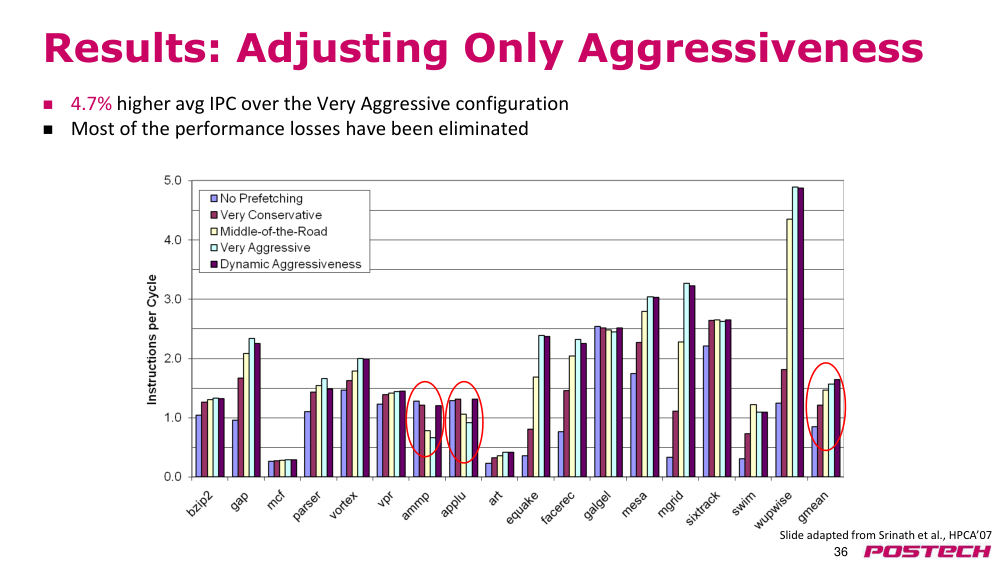
p.36결과: aggressiveness(공격성)만 조정한 경우
- 매우 공격적인 구성 대비 평균 IPC 4.7% 향상
- 대부분의 성능 손실이 제거됨
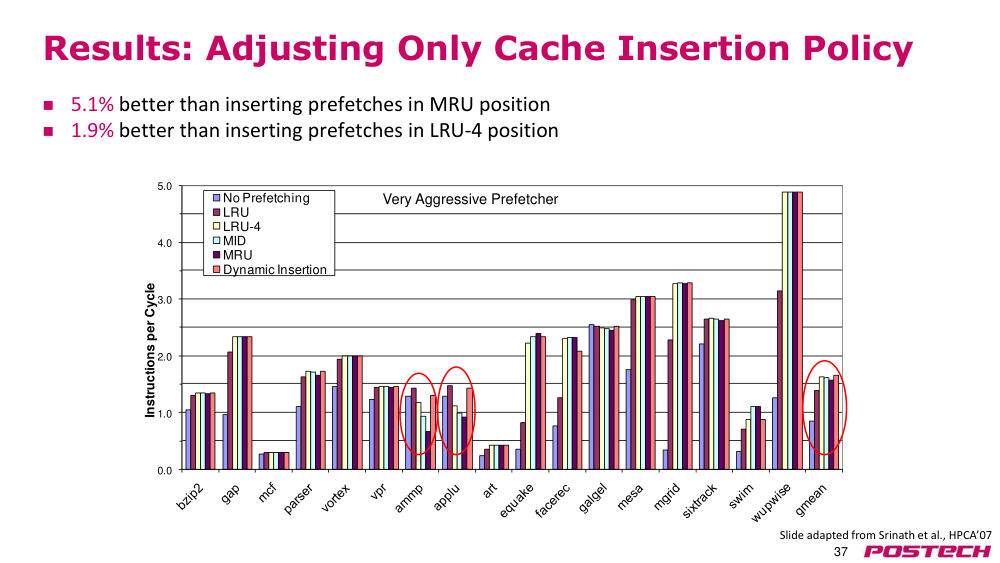
p.37결과: 캐시 삽입 정책만 조정할 때
- - MRU 위치에 prefetching(프리패치)를 삽입하는 것보다 5.1% 더 좋음
- - LRU-4 위치에 prefetching(프리패치)를 삽입하는 것보다 1.9% 더 좋음
- 0.0
- 1.0
- 2.0
- 3.0
- 4.0
- 5.0
- 사이클당 명령어 수
- prefetching(프리패치) 없음
- LRU
- LRU-4
- MID
- MRU
- 동적 삽입
- 매우 공격적인 프리패처
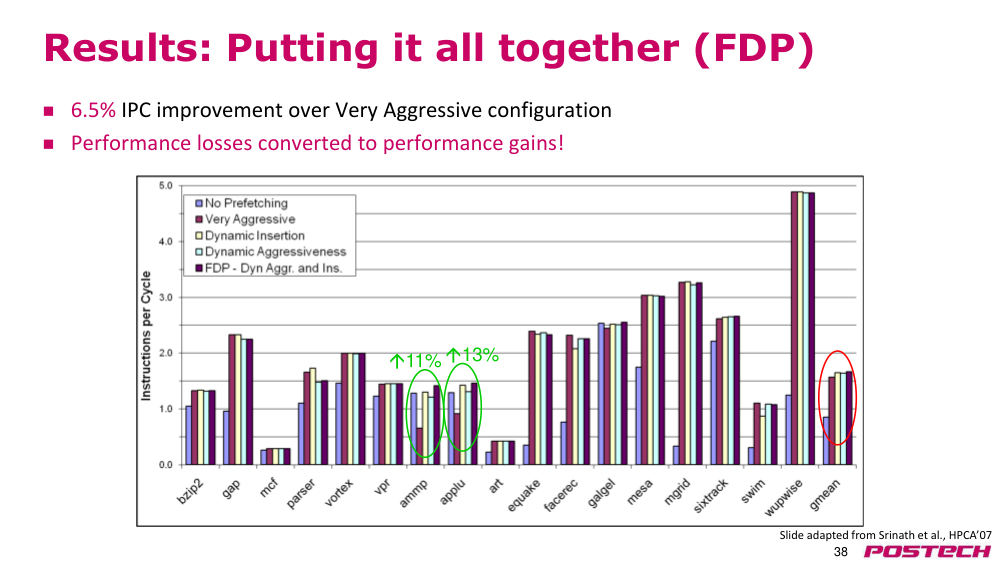
p.38결과: 모두 통합하기 (FDP)
- - 매우 공격적인 구성 대비 6.5% IPC 향상
- - 성능 손실이 성능 향상으로 전환됨!
- ▲11%
- ▲13%
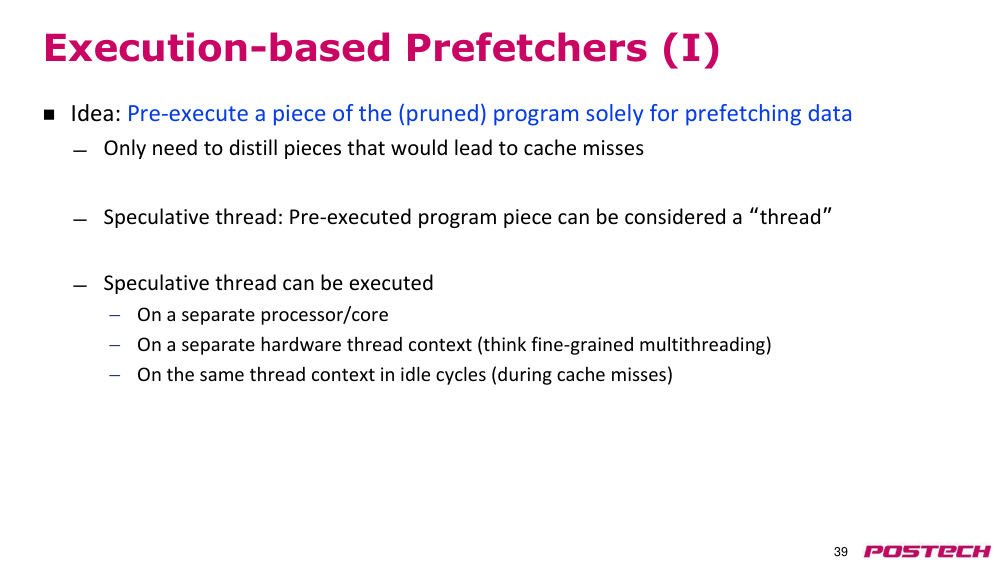
p.39실행 기반 프리패처 (I)
- - 아이디어: prefetching(프리패치)를 위해 (단순화된) 프로그램의 일부를 추측 실행함
- • cache miss(캐시 미스)를 유도할 가능성이 있는 부분만 추출하면 됨
- • 추측 실행된 프로그램 조각은 '스레드'로 간주할 수 있음
- • speculative thread(추측 스레드)는 다음 방식으로 실행될 수 있음
- - 별도의 프로세서/코어에서
- - 별도의 하드웨어 스레드 컨텍스트에서 (fine-grained multithreading(세분화된 멀티스레딩)을 생각해보기)
- - 동일한 스레드 컨텍스트에서 idle cycle(유휴 사이클) 동안 (캐시 미스 중에)
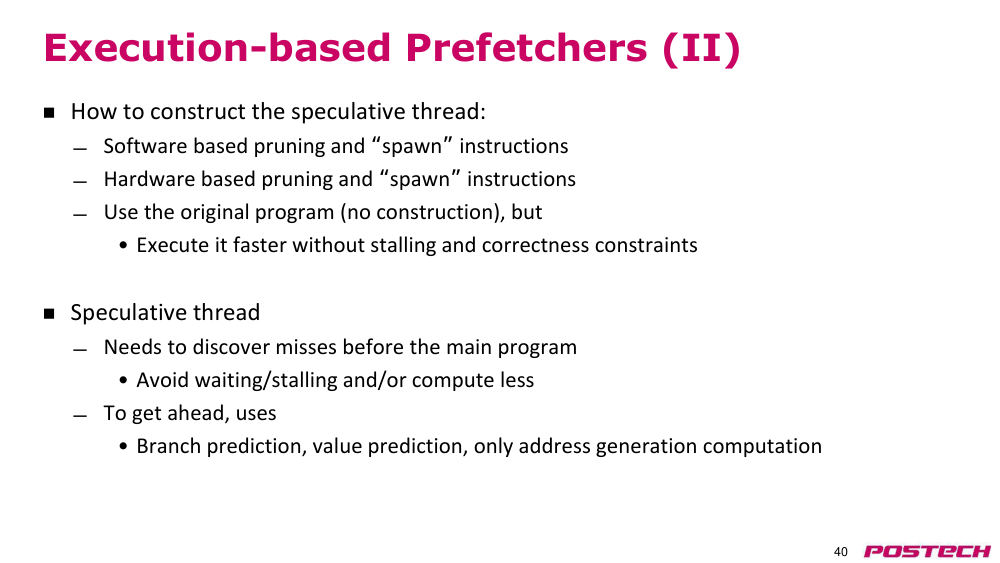
p.40실행 기반 프리패처 (II)
- - speculative thread(추측 스레드)를 구성하는 방법:
- • 소프트웨어 기반 단순화 및 '스폰' 명령어
- • 하드웨어 기반 단순화 및 '스폰' 명령어
- • 원본 프로그램을 사용하지만
- • 정지 없이, 정확성 제약 없이 더 빠르게 실행함
- • speculative thread(추측 스레드):
- • 메인 프로그램보다 미스를 미리 발견해야 함
- • 대기/정지 없이, 또는 덜 계산함으로써 앞서가기 위해
- • 사용하는 기법:
- • 분기 예측, 값 예측, 주소 생성 계산만 수행
p.41실행 기반 프리패처 (III)
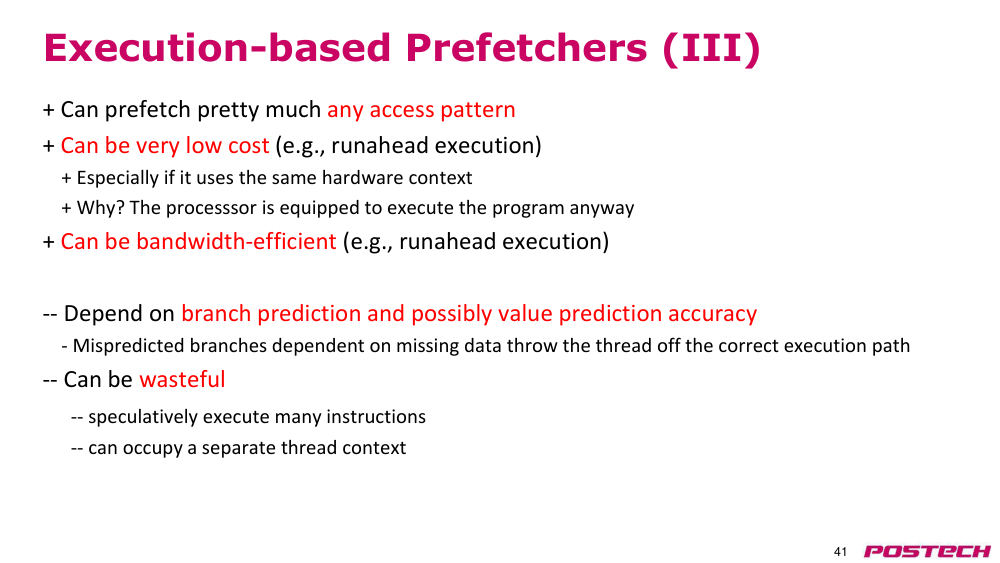
- + 거의 모든 접근 패턴을 prefetching(프리패치)할 수 있음
- + 매우 낮은 비용일 수 있음 (예: runahead execution(런어헤드 실행))
- + 특히 동일한 하드웨어 컨텍스트를 사용할 경우
- + 왜냐하면 프로세서는 이미 프로그램을 실행할 수 있도록 설계되어 있기 때문임
- + 대역폭 효율적일 수 있음 (예: runahead execution(런어헤드 실행))
- - 분기 예측 및 가능하면 값 예측 정확도에 의존함
- - 캐시 미스 데이터를 필요로 하는 잘못 예측된 분기로 인해 스레드가 올바른 실행 경로에서 벗어남
- - 낭비가 클 수 있음
- - 많은 명령어를 추측 실행함
- - 별도의 스레드 컨텍스트를 차지할 수 있음
p.42runahead execution(런어헤드 실행) (I)
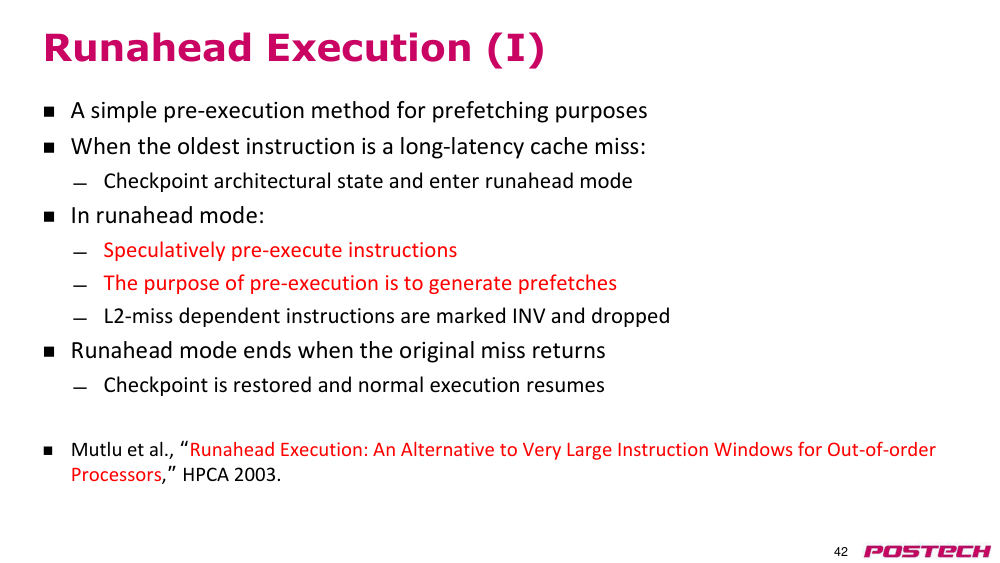
- - prefetching(프리패치) 목적을 위한 간단한 추측 실행 방법
- • 가장 오래된 명령어가 긴 지연을 가진 cache miss(캐시 미스)일 때:
- • 아키텍처 상태를 체크포인트하고 runahead mode(런어헤드 모드) 진입
- • runahead mode(런어헤드 모드)에서는:
- • 명령어를 추측 실행함
- • 추측 실행의 목적은 prefetching(프리패치)를 생성하는 것임
- • L2 미스에 의존하는 명령어는 INV로 표시하고 제거함
- • 원래 미스가 반환될 때 runahead mode(런어헤드 모드) 종료
- • 체크포인트 복원 후 정상 실행 재개
- Mutlu et al., “Runahead Execution: An Alternative to Very Large Instruction Windows for Out-of-order Processors,” HPCA 2003.
p.43runahead execution(런어헤드 실행) [Mutlu 등, HPCA’03]
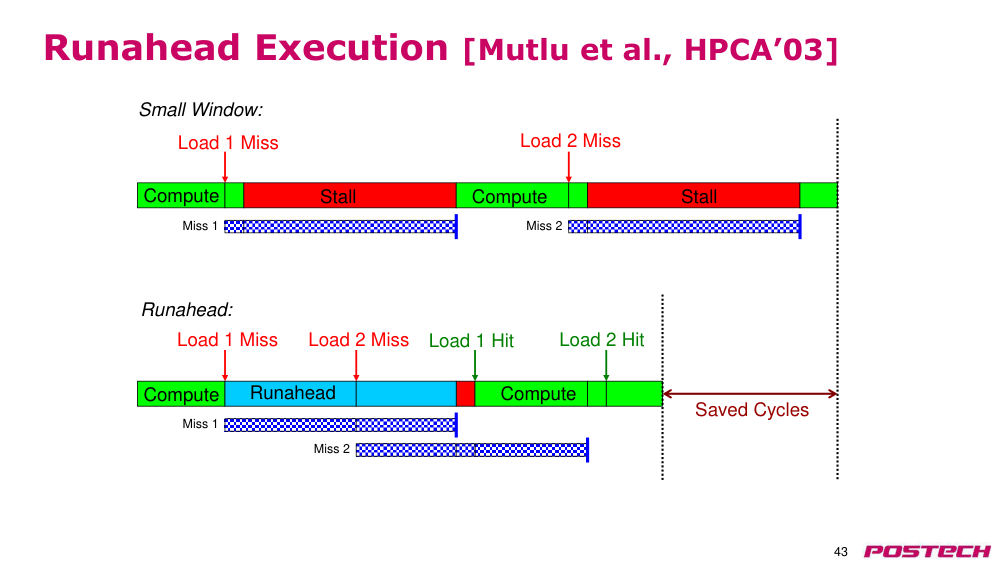
- 계산
- 로드 1 미스
- 미스 1
- 정지
- 계산
- 로드 2 미스
- 미스 2
- 정지
- 작은 윈도우:
- 계산
- 로드 1 미스
- runahead(런어헤드)
- 로드 2 미스
- 로드 2 히트
- 미스 1
- 미스 2
- 계산
- 로드 1 히트
- 저장된 사이클
- runahead(런어헤드):
p.44runahead execution(런어헤드 실행) (III)
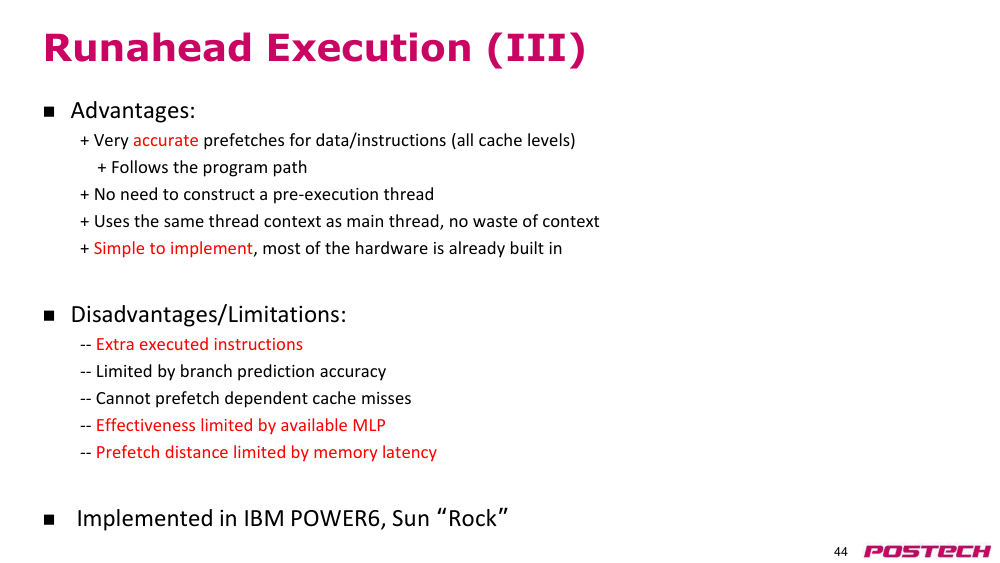
- 장점:
- + 데이터/명령어에 대한 매우 정확한 프리패치 (모든 캐시 레벨)
- + 프로그램 경로를 따름
- + speculative thread(추측 스레드)를 구성할 필요 없음
- + 메인 스레드와 동일한 스레드 컨텍스트를 사용하므로 컨텍스트 낭비 없음
- + 구현이 간단함, 대부분의 하드웨어는 이미 존재함
- 단점/제한 사항:
- -- 추가로 실행된 명령어
- -- 분기 예측 정확도에 의해 제한됨
- -- dependent cache miss(종속 캐시 미스)를 prefetching(프리패치)할 수 없음
- -- 사용 가능한 MLP에 의해 효과가 제한됨
- -- memory latency(메모리 지연)에 의해 prefetch distance(프리패치 거리)가 제한됨
- 구현된 사례: IBM POWER6, Sun "Rock"
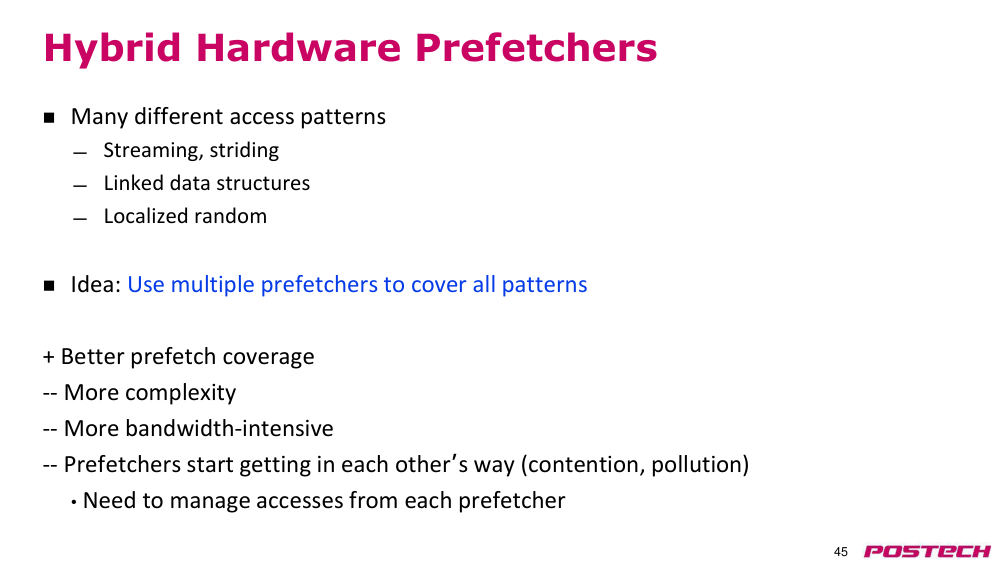
p.45하이브리드 hardware prefetcher(하드웨어 프리패처)
- 다양한 접근 패턴 존재:
- 스트리밍, 스트라이드
- 링크된 데이터 구조
- 지역화된 랜덤
- 아이디어: 다양한 프리패처를 사용하여 모든 패턴을 커버
- + 더 나은 prefetch coverage(프리패치 커버리지)
- -- 더 높은 복잡성
- -- 더 많은 대역폭 소비
- -- 프리패처 간 경쟁 발생 (콘텐션, 오염)
- • 각 프리패처의 접근을 관리해야 함
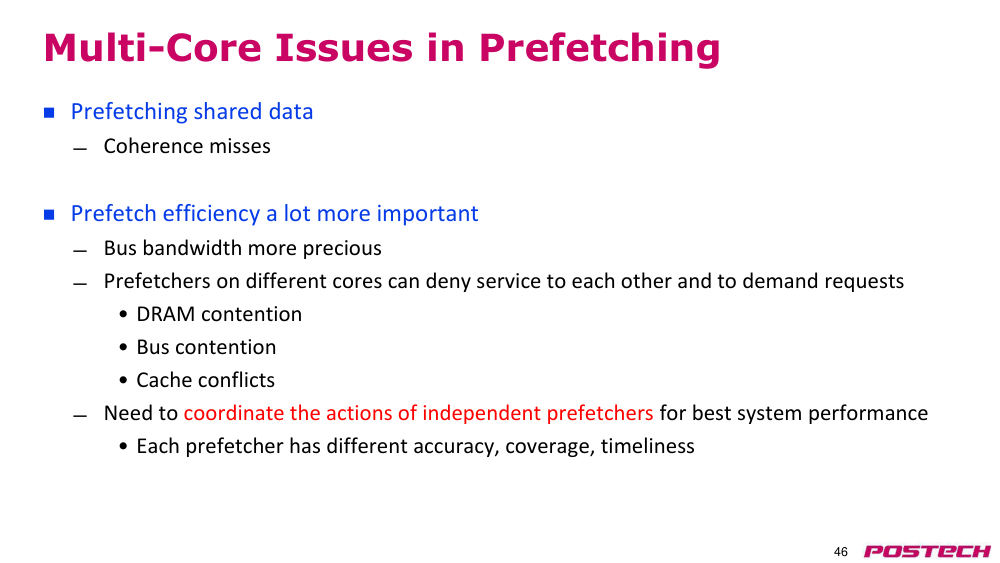
p.46다중 코어에서의 prefetching(프리패치) 문제
- 공유 데이터의 prefetching(프리패치):
- coherence miss(코히어런스 미스)
- prefetching(프리패치) 효율성이 훨씬 더 중요함:
- bus bandwidth(버스 대역폭)이 더 귀중함
- 다른 코어의 프리패처는 서로에게 서비스를 거부할 수 있으며, demand access(요청 접근)에도 영향을 줌
- • DRAM contention(경합)
- • bus contention(경합)
- • 캐시 충돌
- 최적의 시스템 성능을 위해 독립적인 프리패처의 동작을 조율해야 함
- • 각 프리패처는 서로 다른 정확도, 커버리지, 적시성 가짐
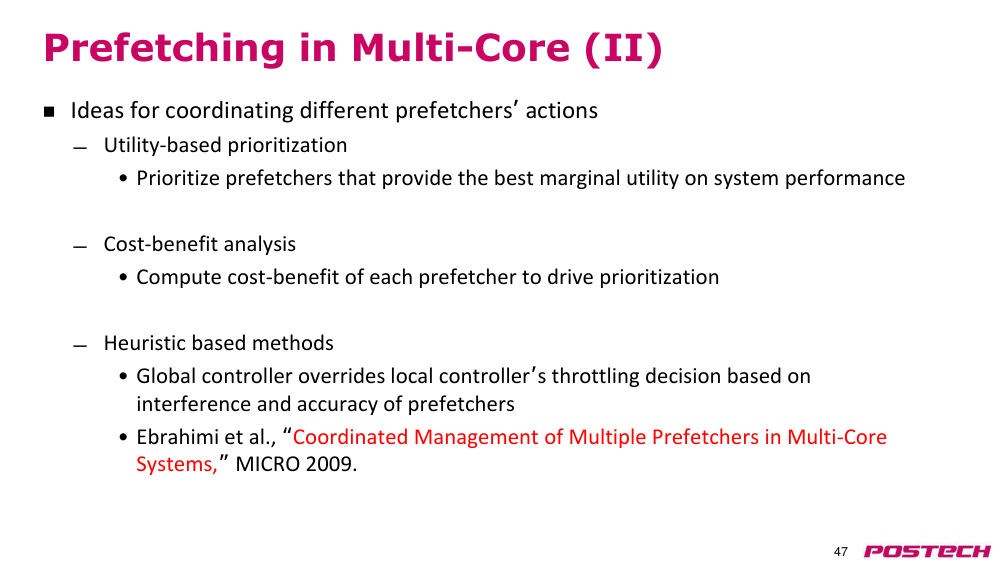
p.47다중 코어에서의 프리패치 (II)
- 다른 프리패처의 동작을 조율하기 위한 아이디어:
- 유용성 기반 우선순위 부여
- • 시스템 성능에 가장 큰 marginal utility(한계 효용)을 제공하는 프리패처를 우선순위 부여
- 비용-편익 분석
- • 각 프리패처의 비용-편익을 계산하여 우선순위 결정
- 휴리스틱 기반 방법
- • 글로벌 컨트롤러는 간섭과 프리패처의 정확도를 기반으로 로컬 컨트롤러의 throttling decision(스로틀링 결정)을 무시할 수 있음
- • Ebrahimi 등, "다중 코어 시스템에서 다중 프리패처의 조정 관리", MICRO 2009
p.48질문?
- 추천 독서:
- 교재의 2.5-2.6 장