이 자료를 쓰는 강의: 14 Multithreading(다중 스레딩)
Lec10 - Multithreading
한국어판 강의자료 · 39쪽
p.1CSED503 고급 컴퓨터 구조 – 강의 10
p.2지난 시간 강의 9: VLIW
- • 고전적인 VLIW에서는 컴파일러가 모든 위험을 피해야 함 → 단순한 하드웨어, 복잡한 컴파일러
- • 나중에 VLIW는 더 많은 동적 하드웨어 잠금 기능을 추가함
- • 루프 전개와 소프트웨어 pipeline(파이프라인)화를 사용하여 루프 처리
- • 더 비정형 코드에는 트레이스 스케줄링 사용
- • 예측 불가능한 브랜치와 가변 지연 메모리 존재 시 정적 스케줄링은 어려움
p.3multithreading(다중 스레딩)
- • 단일 순차적 제어 흐름에서 명령 수준 병렬성(ILP)을 계속 추출하는 것은 어려움
- • 많은 워크로드는 스레드 수준 병렬성(TLP)을 활용할 수 있음
- • TLP의 두 가지 출처:
- - 다중 프로그래밍에서의 TLP (독립적인 순차적 작업을 동시에 실행)
- - 다중 스레드 애플리케이션에서의 TLP (병렬 스레드를 사용해 하나의 작업을 더 빠르게 실행)
- • multithreading(다중 스레딩)은 TLP를 활용하여 단일 프로세서의 활용도를 향상시킴
p.4multithreading(다중 스레딩)
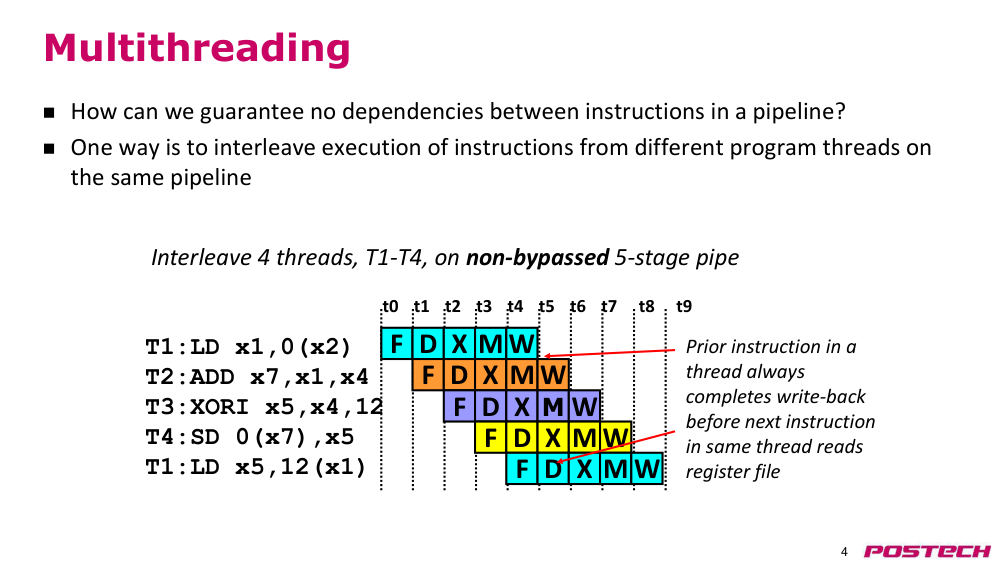
- • pipeline(파이프라인) 내에서 명령어 간 의존성을 보장하는 방법은?
- • 한 가지 방법은 동일한 pipeline(파이프라인)에 서로 다른 프로그램 스레드의 명령어를 interleave(인터리빙)하여 실행하는 것
- • 4개 스레드(T1-T4)를 fixed interleave(고정 인터리빙)하여 non-bypassed(바이패스 없음) 5단계 pipeline(파이프라인)에 배치
- • 한 스레드의 이전 명령어는 동일한 스레드의 다음 명령어가 레지스터 파일을 읽기 전에 항상 완료되어야 함
p.5CDC 6600 Peripheral Processors(주변 처리기) (Cray, 1964)
- • 최초의 하드웨어 기반 multithreading(다중 스레딩)
- • 10개의 '가상' I/O 처리기
- • 단순 pipeline(파이프라인)에서 fixed interleave(고정 인터리빙)
- • pipeline(파이프라인) 주기는 100ns
- • 각 가상 처리기는 1000ns마다 하나의 명령어를 실행
- • 프로세서 상태를 줄이기 위해 Accumulator-Based instruction set(누산기 기반 명령어 집합) 사용
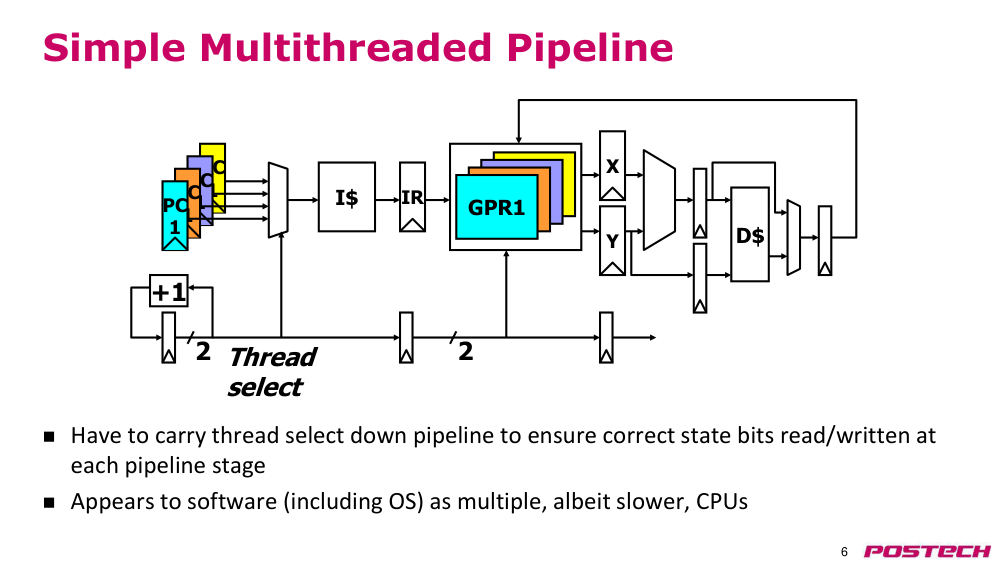
p.6간단한 multithreading(다중 스레딩) pipeline(파이프라인)
- • pipeline(파이프라인) 전반에 걸쳐 스레드 선택(thread select)을 전달하여 각 단계에서 올바른 상태 비트를 읽고 쓰도록 해야 함
- • 소프트웨어(운영체제 포함)에게는 더 느린 다수의 CPU처럼 보임
p.7multithreading(다중 스레딩) 비용
- 각 스레드는 자체 user state(사용자 상태)가 필요함 — • PC • GPRs
- 또한 자체 privileged mode state(특권 모드 상태)가 필요함 — • 가상 메모리 Page-Table-Base register(페이지 테이블 기준 레지스터) • Exception-Handling registers(예외 처리 레지스터)
- 기타 오버헤드: • 경쟁하는 스레드로 인한 추가 캐시/TLB 충돌 (또는 더 큰 캐시/TLB 용량 확보) • 더 많은 스레드를 스케줄링하기 위한 더 큰 OS 오버헤드 (이 모든 스레드는 어디서 올까?)
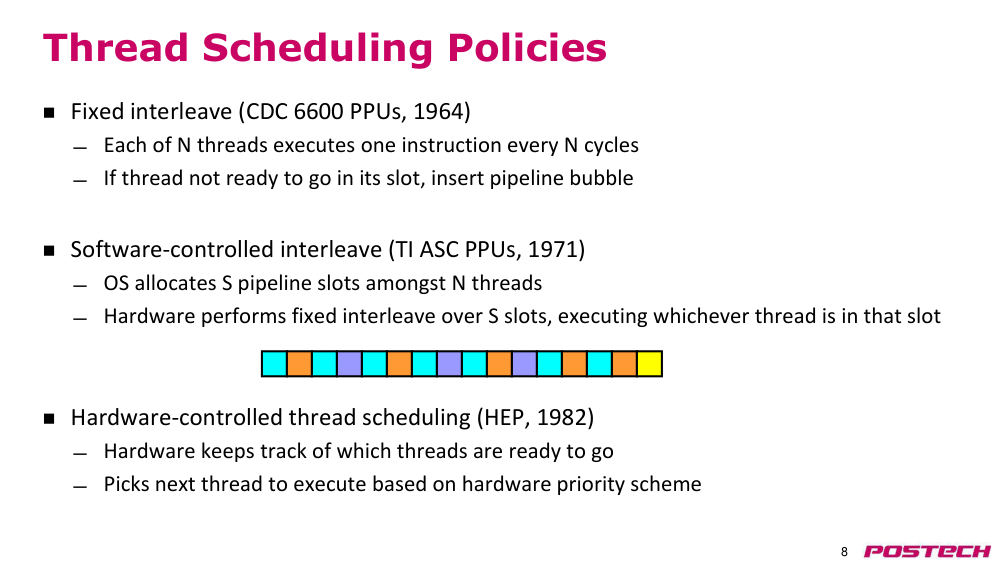
p.8스레드 스케줄링 정책
- 고정 인터리빙 (CDC 6600 PPU(주변 처리기), 1964) • N개의 스레드 중 각각이 N 사이클마다 한 명령어씩 실행 • 스레드가 자신의 슬롯에서 실행할 준비가 되지 않으면 pipeline(파이프라인) 버블 삽입
- 소프트웨어 제어 인터리빙 (TI ASC PPU(주변 처리기), 1971) • OS가 N개의 스레드 중 S개의 pipeline(파이프라인) 슬롯을 할당 • 하드웨어는 S개 슬롯에서 fixed interleave(고정 인터리빙)을 수행하며, 해당 슬롯에 있는 스레드를 실행
- 하드웨어 제어 스레드 스케줄링 (HEP, 1982) • 하드웨어가 어느 스레드가 실행할 준비가 되었는지 추적 • 하드웨어 우선순위 기반 방식으로 다음 실행 thread select(스레드 선택)
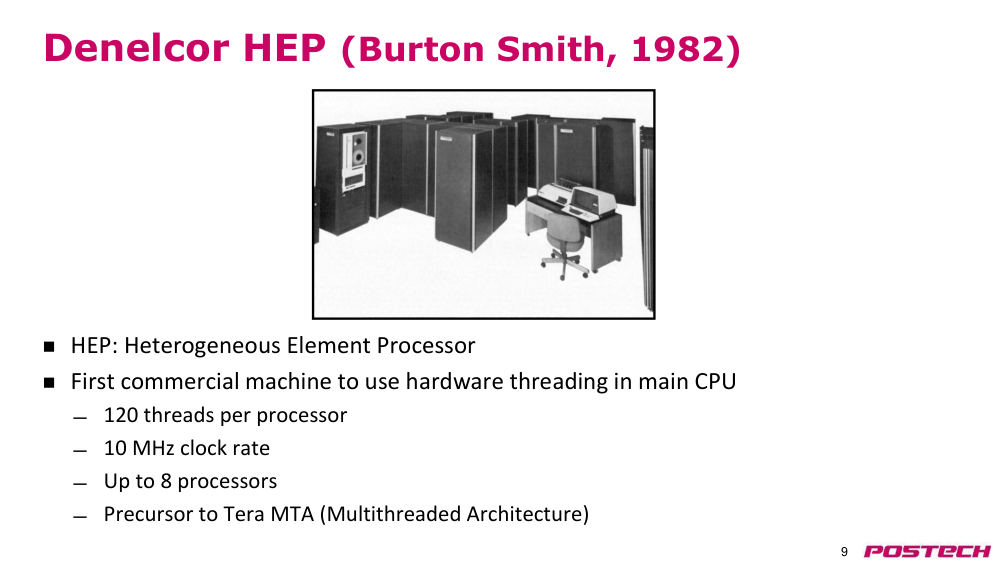
p.9Denelcor HEP (Burton Smith, 1982)
- HEP: heterogeneous element processor(이질적 요소 프로세서)
- 메인 CPU에서 하드웨어 스레딩을 사용한 최초의 상용 기계 • 프로세서당 120개의 스레드 • 10 MHz 클럭 속도 • 최대 8개의 프로세서 • Tera MTA (다중 스레딩 아키텍처)의 전조
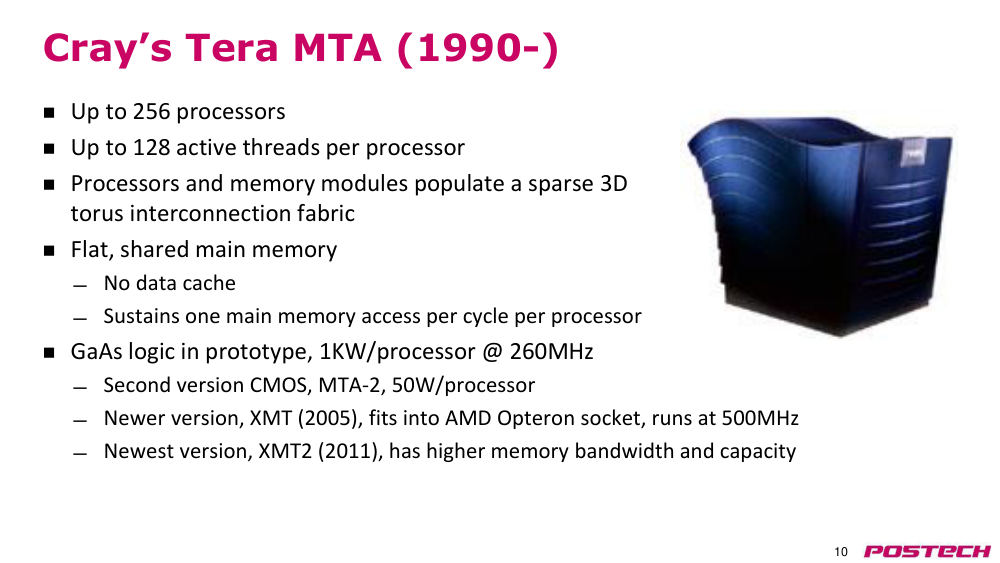
p.10Cray’s Tera MTA (1990-)
- 최대 256개의 프로세서 • 프로세서당 최대 128개의 활성 스레드 • 프로세서와 메모리 모듈이 sparse 3D torus interconnection fabric(희박한 3차원 토러스 상호연결 구조)에 배치됨 • flat shared main memory(평탄한 공유 주기억장치) • no data cache(데이터 캐시 없음) • 프로세서당 사이클당 하나의 main memory access(주기억장치 접근) 유지 가능 • 프로토타입에는 GaAs logic(GaAs 논리 회로) 사용, 1KW/프로세서 @ 260MHz • 두 번째 버전 CMOS, MTA-2, 50W/프로세서 • 최신 버전, XMT (2005), AMD Opteron 소켓에 맞춤, 500MHz에서 실행 • 최신 버전, XMT2 (2011), 더 높은 메모리 대역폭과 용량
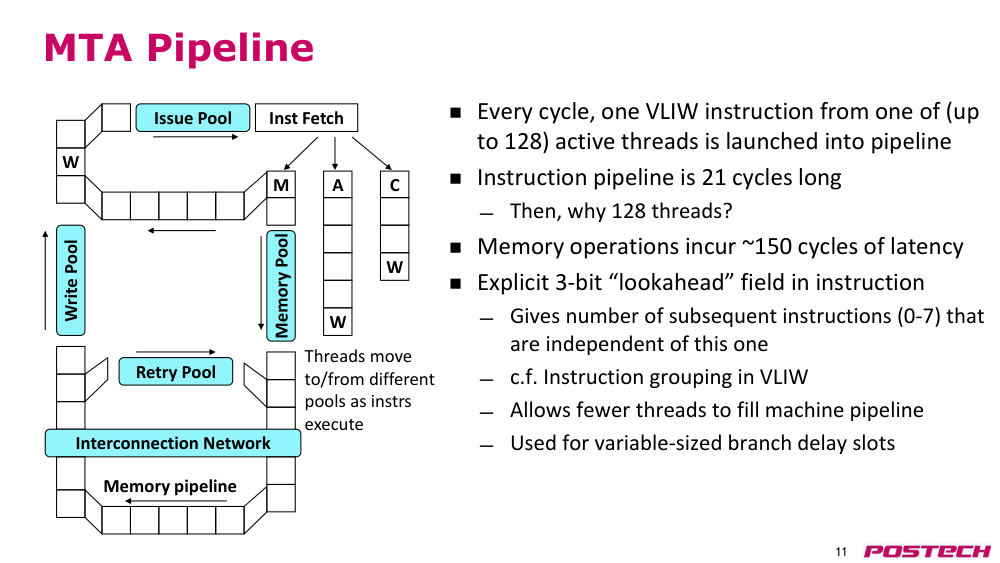
p.11MTA pipeline(파이프라인)
- 매 사이클마다 (최대 128개의) 활성 스레드 중 하나에서 VLIW instruction(VLIW 명령어) 하나가 pipeline(파이프라인)으로 발행됨 • 명령어 파이프라인은 21 사이클 길이 • 그러면 왜 128개의 스레드가 필요한가? • 메모리 연산은 약 150 사이클의 지연을 유발함 • 명령어에 명시적인 3비트 ‘lookahead(룩어헤드)’ 필드 존재 • 이 명령어 이후 독립적인 후속 명령어 수 (0-7)를 제공 • VLIW의 명령어 그룹화와 비교 • 기계 파이프라인을 채우기 위해 더 적은 수의 스레드로도 가능 • 가변 크기의 branch delay slot(브랜치 지연 슬롯)에 사용됨
- A W C W M instruction fetch(명령어 인출) memory pool(메모리 풀) retry pool(재시도 풀) 상호연결 네트워크 write pool(쓰기 풀) W memory pipeline(메모리 파이프라인) issue pool(발행 풀) 스레드는 명령어 실행에 따라 다양한 풀 간에 이동함
p.12Coarse-Grain multithreading(거시적 다중 스레딩)
- Tera MTA(테라 MTA)는 Fine-Grain multithreading(미세적 다중 스레딩)을 구현함 • 대용량 데이터 세트와 낮은 지역성을 가진 슈퍼컴퓨팅 응용 프로그램을 위해 설계됨 • no data cache(데이터 캐시 없음) • 큰 메모리 지연을 숨기기 위해 많은 병렬 스레드 필요 • 단일 스레드가 21 사이클마다 한 명령어를 발행한다고 가정하고, 클럭 속도가 260 MHz라면… 단일 스레드 성능은? • 효과적인 단일 스레드 발행률은 260/21 = 12.4 MIPS
- 다른 응용 프로그램은 캐시 친화적임 • 캐시 대부분이 히트하면 pipeline(파이프라인) 버블이 적음 • 가끔 발생하는 cache miss latency(캐시 미스 지연)을 숨기기 위해 몇 개의 스레드만 추가하면 됨 • 캐시 미스 시 thread switch(스레드 전환)
p.13MIT Alewife (1990)
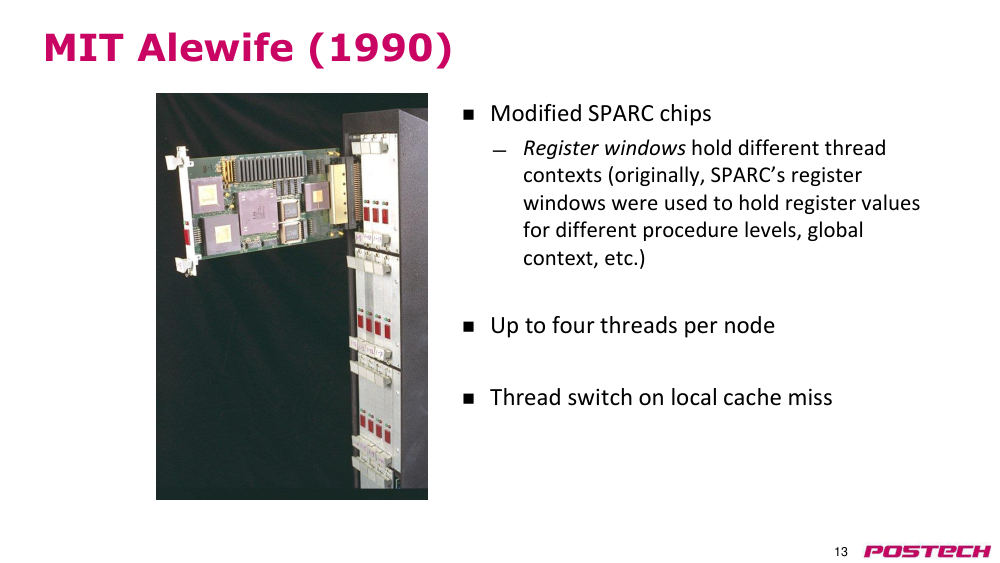
- 수정된 SPARC 칩
- register windows(레지스터 윈도우)는 서로 다른 스레드 컨텍스트를 보유함 (원래 SPARC의 레지스터 윈도우는 서로 다른 프로시저 레벨, 전역 컨텍스트 등을 저장하는 데 사용됨)
- 노드당 최대 4개의 스레드 지원
- local cache miss(로컬 캐시 미스) 발생 시 thread switch(스레드 전환)
p.14IBM PowerPC RS64-IV (2000)
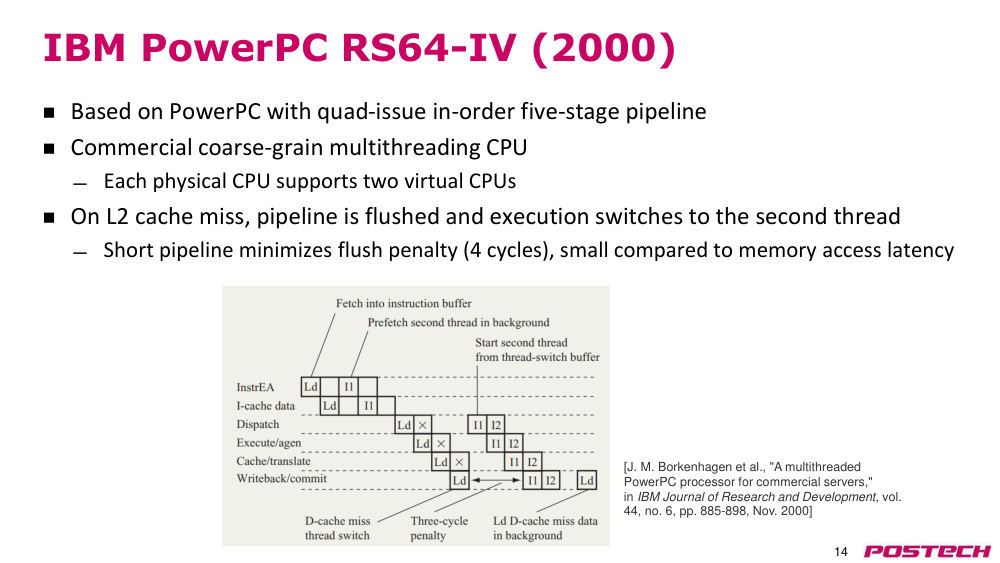
- PowerPC 기반으로, quad-issue in-order five-stage pipeline(4-명령어 동시 발행 순차 실행 5단계 파이프라인)을 채택
- 상용 Coarse-Grain multithreading(거시적 다중 스레딩) CPU
- 각 물리적 CPU는 두 개의 virtual processor(가상 프로세서)를 지원
- L2 cache miss(L2 캐시 미스) 발생 시 pipeline flush(파이프라인 플러시) 후 실행이 두 번째 스레드로 전환됨
- 단순한 pipeline(파이프라인)은 플러시 패널티를 최소화함 (4 사이클), 메모리 접근 지연에 비해 작음
p.15Oracle/Sun Niagara Processors
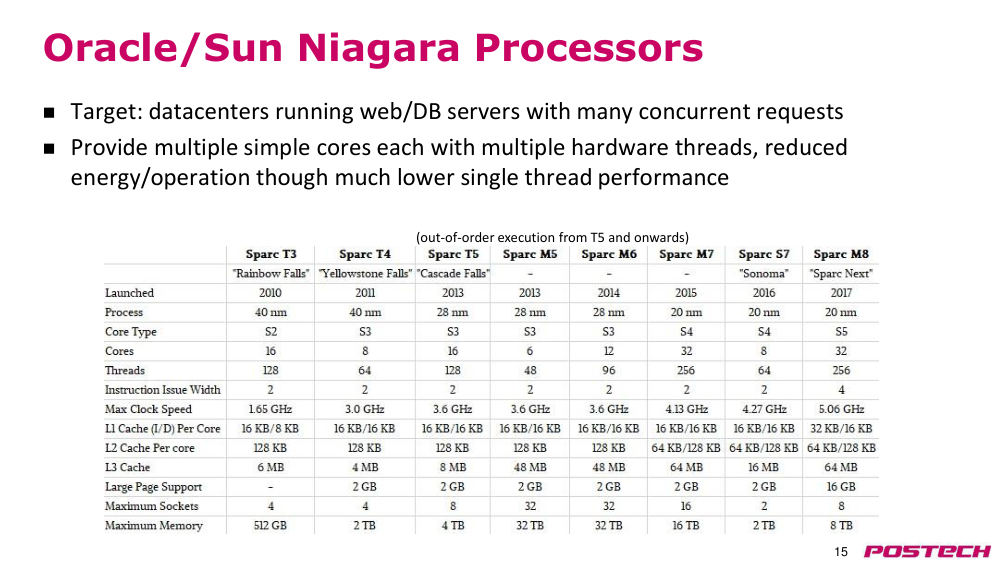
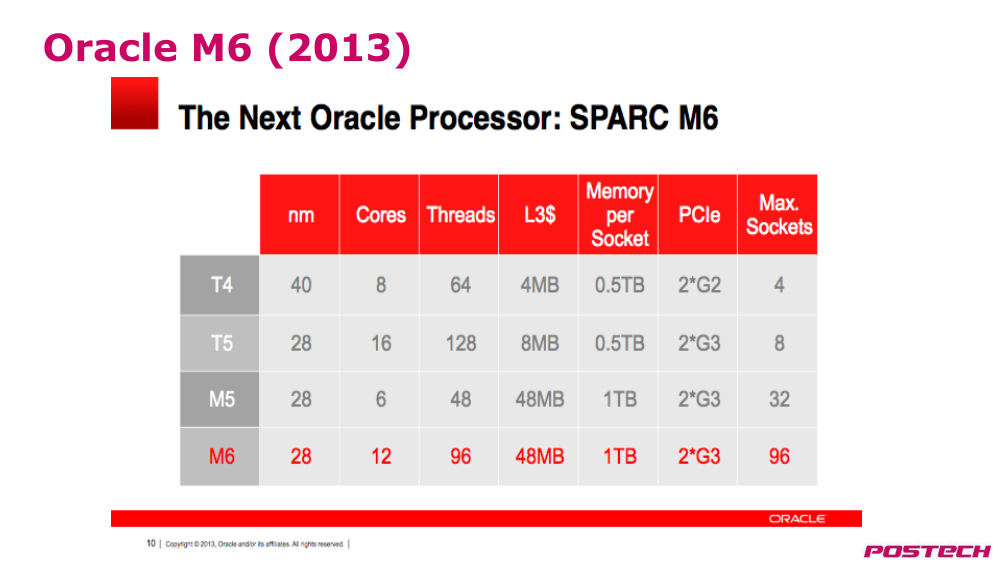
- 목표: Web/DB servers(웹/데이터베이스 서버)에서 많은 동시 요청을 처리하는 datacenter(데이터센터)
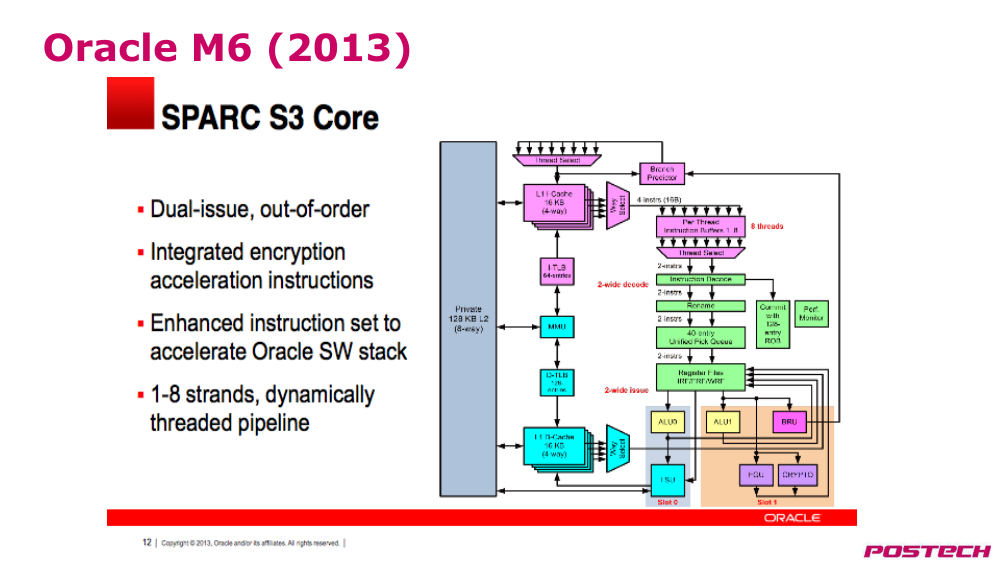
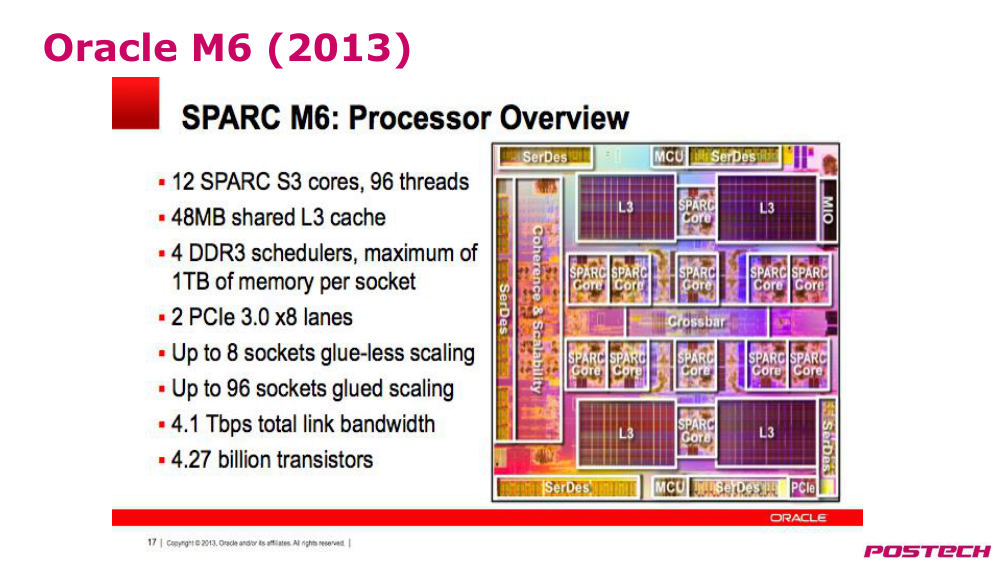
- 다수의 simple core(간단한 코어)를 제공하며, 각 코어는 다수의 하드웨어 스레드를 지원함
- 단일 스레드 성능은 낮지만, 에너지/운영 비용을 크게 줄임 (T5 이후 out-of-order execution(비순차 실행) 도입)
p.16Oracle/Sun Niagara-3, “Rainbow Falls” (2009)
p.17Oracle M6 (2013)
p.18Oracle M6 (2013)
p.19Oracle M6 (2013)
p.20out-of-order superscalar(OoO)(비순차 슈퍼스칼라)를 위한 동시 다중 스레딩 (SMT)
- 이전에 제시된 기법들은 모두 각 pipeline(파이프라인) 단계가 한 번에 하나의 스레드만 처리하는 'vertical multithreading(수직 다중 스레딩)'이었다.
- SMT는 out-of-order superscalar(OoO)(비순차 슈퍼스칼라) 내부에 이미 존재하는 미세한 제어 기법을 활용하여, 여러 스레드의 명령어가 동일한 클럭 사이클에 실행될 수 있도록 한다. 이로 인해 머신 자원의 활용도가 향상된다.
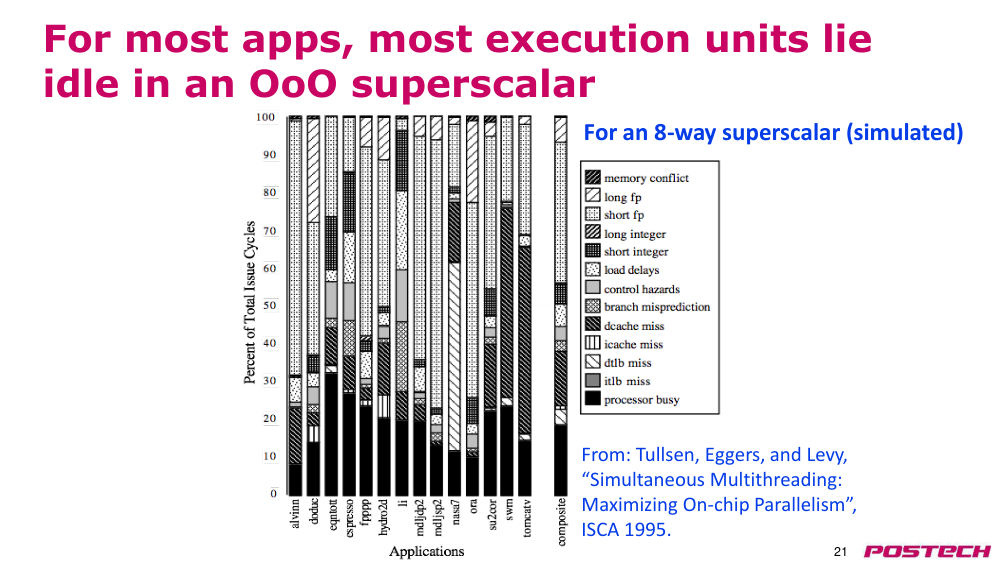
p.21대부분의 애플리케이션에서 out-of-order superscalar(OoO)(비순차 슈퍼스칼라)의 대부분의 실행 단위는 비활성 상태이다
- 출처: Tullsen, Eggers, and Levy, "Simultaneous Multithreading: Maximizing On-chip Parallelism", ISCA 1995.
- 8방향 슈퍼스칼라(시뮬레이션 기준)
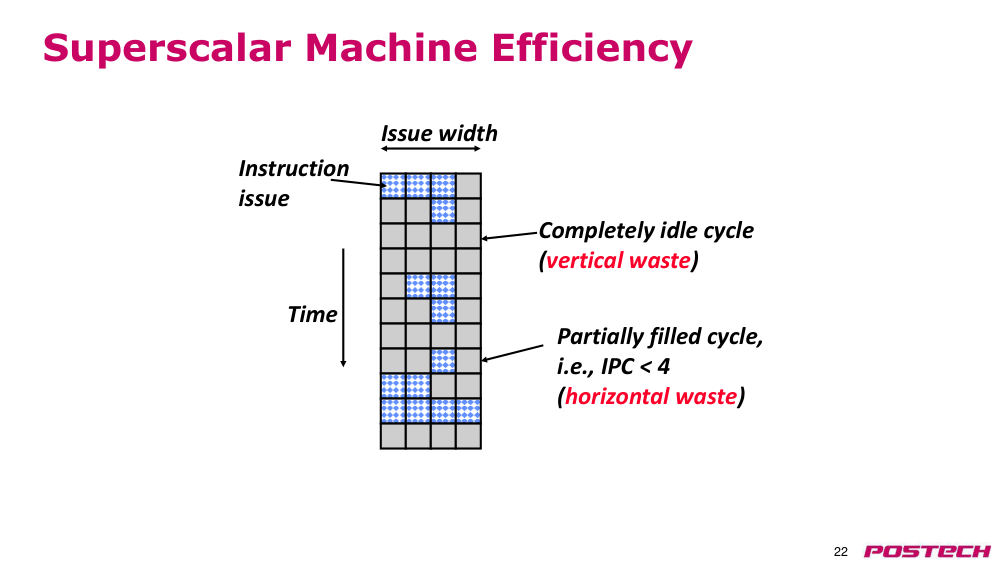
p.22superscalar(슈퍼스칼라) 기계 효율성
- 발행 폭
- 시간
- 완전히 비활성 사이클 (수직적 낭비)
- 명령 발행
- 부분적으로 채워진 사이클, 즉 IPC < 4 (수평적 낭비)
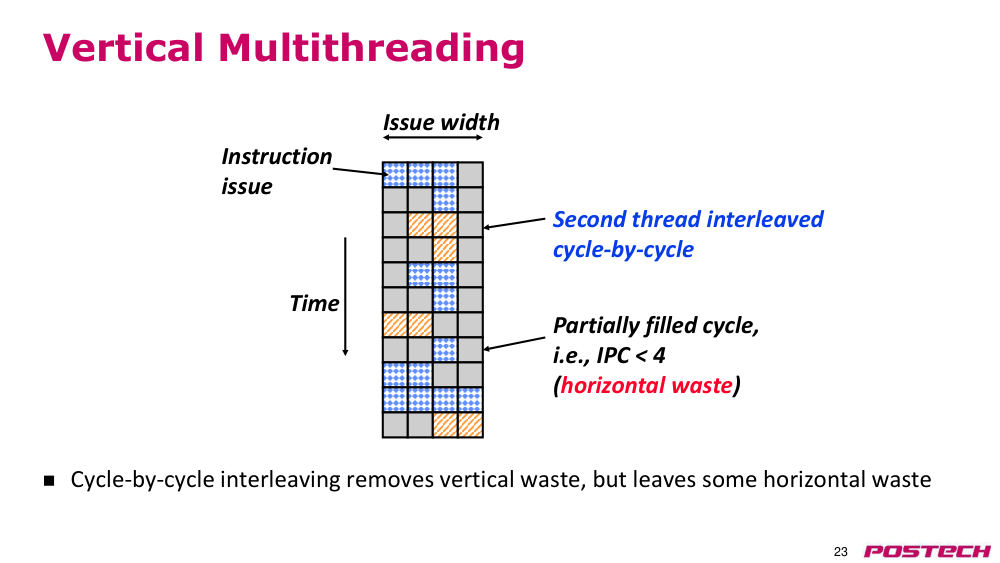
p.23vertical multithreading(수직 다중 스레딩)
- 사이클 단위 interleave(인터리빙)은 vertical waste(수직적 낭비)를 제거하지만, 일부 horizontal waste(수평적 낭비)는 여전히 남아 있다.
- 발행 폭
- 시간
- 두 번째 스레드가 사이클 단위로 interleave(인터리빙)됨
- 명령 발행
- 부분적으로 채워진 사이클, 즉 IPC < 4 (수평적 낭비)
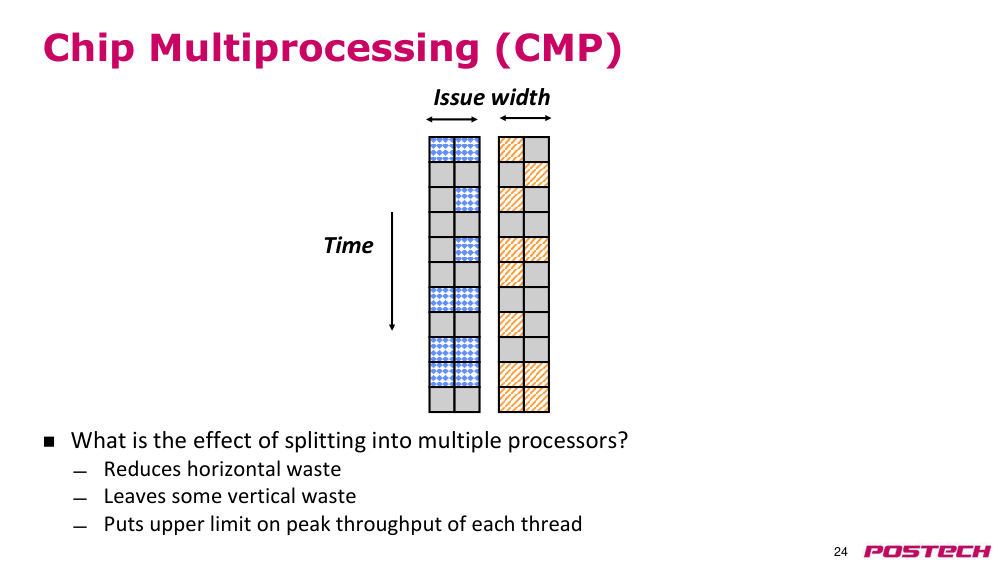
p.24칩 멀티프로세싱 (CMP)
- 다중 프로세서로 분할했을 때의 효과는 무엇인가?
- horizontal waste(수평적 낭비)를 감소시킨다.
- 일부 vertical waste(수직적 낭비)는 여전히 존재한다.
- 각 스레드의 최대 처리량에 상한이 생긴다.
- 발행 폭
- 시간
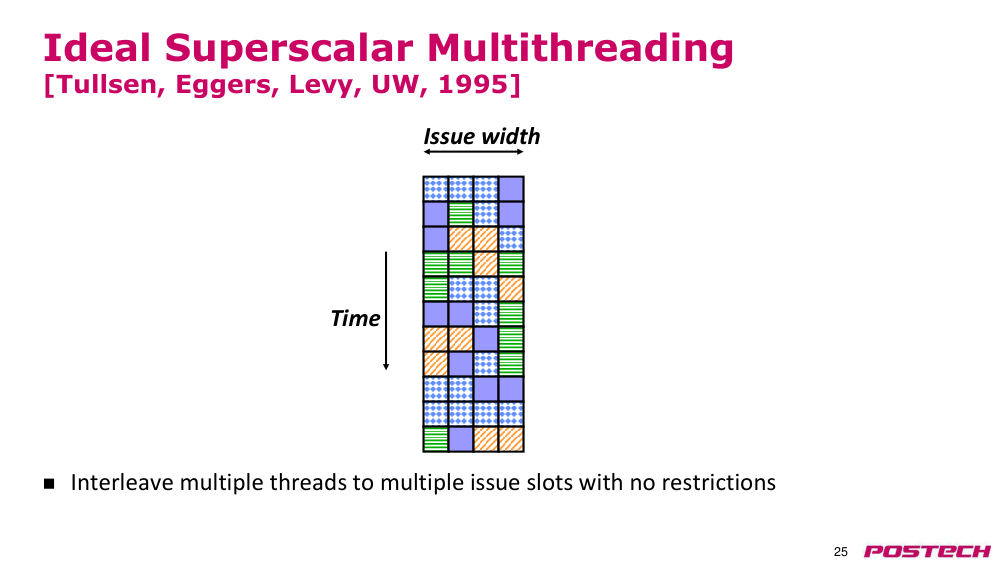
p.25ideal superscalar multithreading(이상적 슈퍼스칼라 다중 스레딩)
- Tullsen, Eggers, Levy, UW, 1995
- 제한 없이 여러 스레드를 여러 발행 슬롯에 interleave(인터리빙)
- 발행 폭
- 시간
p.26O-o-O Simultaneous Multithreading(비순차 동시 다중 스레딩)
- Tullsen, Eggers, Emer, Levy, Stamm, Lo, DEC/UW, 1996
- 여러 컨텍스트와 명령어 가져오기 엔진을 추가하여, 서로 다른 스레드에서 가져온 명령어를 동시에 발행할 수 있도록 함
- 광범위한 out-of-order superscalar(OoO)(비순차 슈퍼스칼라) 프로세서 issue queue(발행 큐)를 활용하여 여러 스레드에서 발행할 명령어를 찾음
- out-of-order instruction window(비순차 명령어 윈도우)는 이미 여러 스레드에서 스케줄링하기 위한 대부분의 회로를 갖추고 있음
- 필요 시 단일 스레드가 전체 머신을 활용할 수 있음
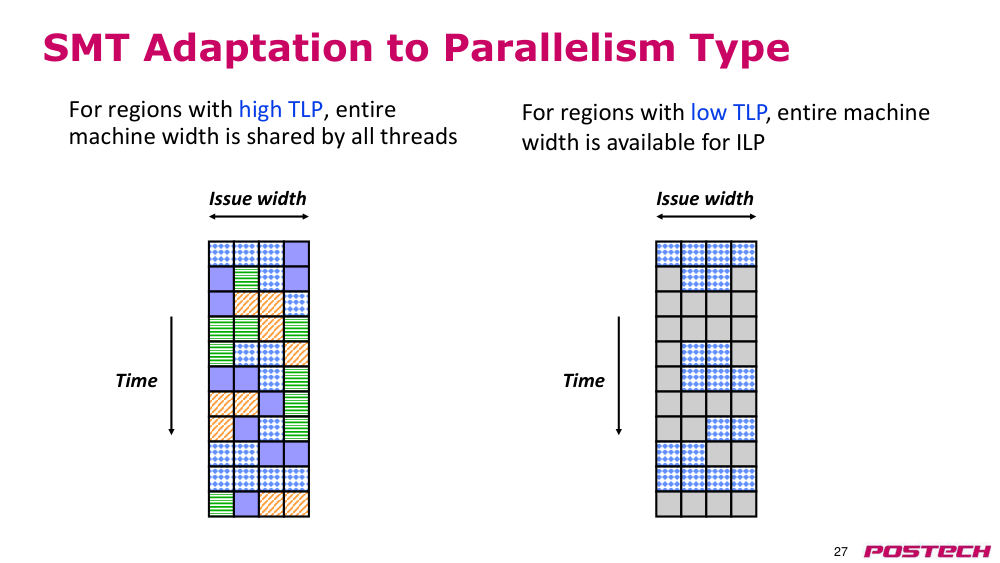
p.27SMT의 병렬성 유형에 따른 적응
- 고도의 스레드 수준 병렬성(TLP)이 있는 영역에서는 전체 머신 폭이 모든 스레드 간에 공유됨
- 발행 폭
- 시간
- 저도의 스레드 수준 병렬성(TLP)이 있는 영역에서는 전체 머신 폭이 명령 수준 병렬성(ILP)에 사용 가능
p.28Pentium-4 Hyperthreading (2002)
- 최초의 상용 동시 다중 스레딩(SMT) 설계 (2-way SMT)
- logical processor(논리적 프로세서)는 물리적 프로세서의 거의 모든 자원을 공유함 — 캐시, 실행 유닛, branch predictor(브랜치 예측기)
- Hyperthreading(하이퍼스레딩)의 die area overhead(다이 면적 오버헤드)는 약 5%
- 한 logical processor(논리적 프로세서)가 정지된 경우, 다른 프로세서는 진행할 수 있음 — 두 스레드가 활성화된 경우, 어느 하나의 논리적 프로세서도 큐의 모든 항목을 사용할 수 없음
- Pentium-4 이후의 out-of-order(OoO) P6 기반 후속 제품(Pentium-M, Core Duo, Core 2 Duo)에서는 Hyperthreading(하이퍼스레딩)이 폐기되었으며, 2008년 Nehalem 세대에서 재도입됨
- Intel Atom(in-order x86 코어)은 2-way vertical multithreading(수직 다중 스레딩)을 지원함 — Hyperthreading(하이퍼스레딩) == Intel out-of-order SMT, Intel in-order vertical multithreading(수직 다중 스레딩)
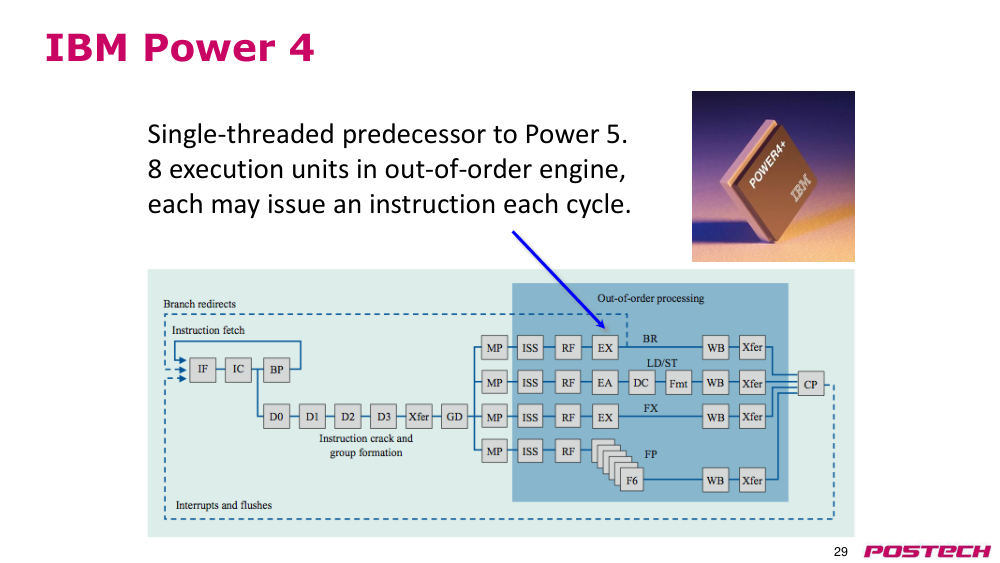
p.29IBM Power 4
- Power 5의 단일 스레드 전신
- out-of-order engine(비순차 실행 엔진)에 8개의 실행 유닛이 있으며, 각각이 주기당 하나의 명령어를 발행할 수 있음
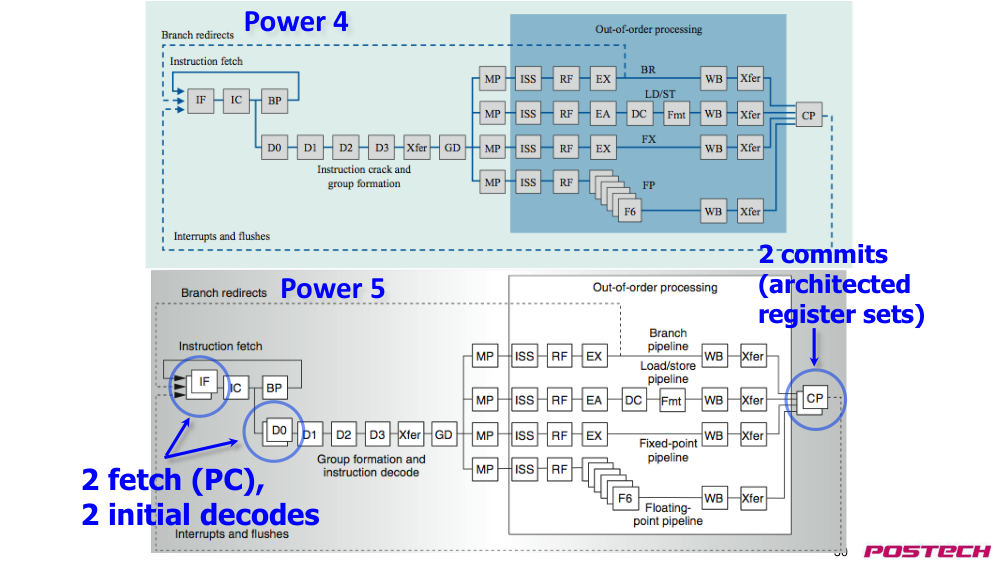
p.30Power 4
- Power 5
- 2개의 가져오기 (PC)
- 2개의 초기 디코딩
- 2개의 커밋 (아키텍처 레지스터 세트)
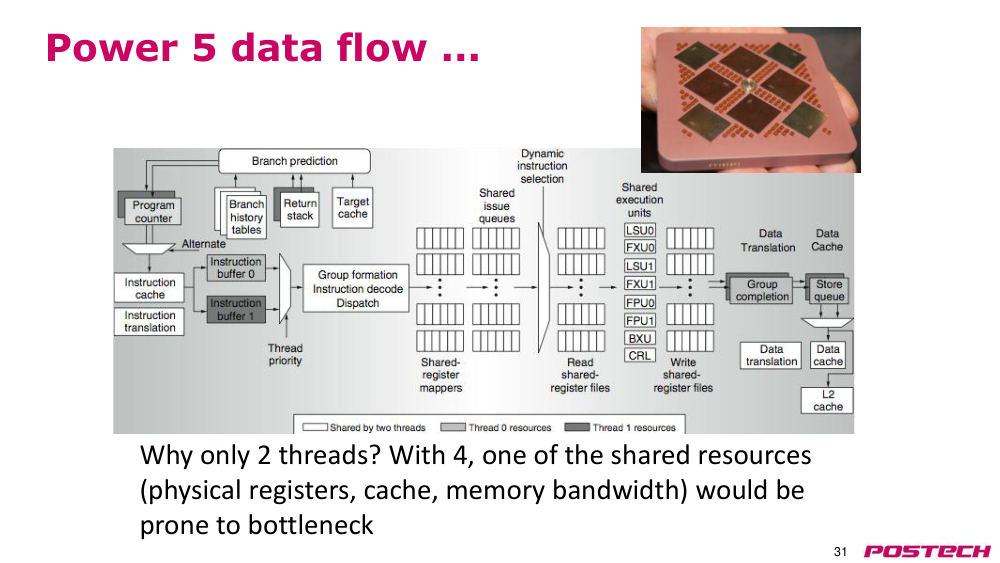
p.31Power 5 데이터 흐름...
- 왜 단지 2개의 스레드만인가? 4개로 하면 공유 자원(물리적 레지스터, 캐시, 메모리 대역폭) 중 하나가 병목 현상에 취약해진다.
p.32SMT 초기 성능
- Pentium-4 (2-way SMT)
- SPECRate: SPECint에 대해 1.01배의 속도 향상, SPECfp에 대해 1.07배의 속도 향상
- SPECRate: 동일한 벤치마크를 여러 번(이 경우 두 번) 실행하여 처리량 성능을 측정
- 26개의 SPEC 벤치마크를 서로 짝지어 실행했을 때, 속도 향상은 0.90배에서 1.58배 사이였으며, 평균은 1.20배였다.
- 다른 벤치마크를 짝지어 실행하면 왜 더 높은 성능 향상이 발생하는가?
- Power 5 (2-way SMT)
- 8프로세서 서버에서 SMT 적용 시 SPECint_rate에 대해 1.23배 빠르고, SPECfp_rate에 대해 1.16배 빠름
- 각 애플리케이션에 대해 두 개의 복사본을 실행했을 때 속도 향상은 0.89배에서 1.41배 사이
- 대부분의 경우 성능 향상이 있었으나, 부동소수점 애플리케이션은 cache conflicts(캐시 충돌)이 많아 성능 향상이 낮았다.
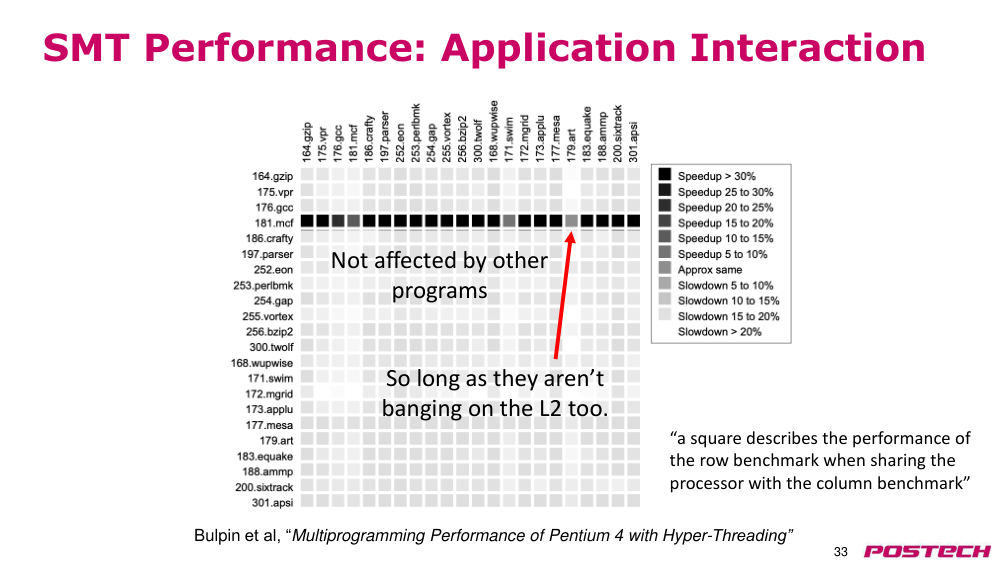
p.33SMT 성능: 애플리케이션 상호작용
- Bulpin 등, “Pentium 4 하이퍼스레딩의 다중 프로그래밍 성능”
- L2에 과도한 접근이 없다면 문제없다.
- 다른 프로그램의 영향을 받지 않음
- "한 사각형은 행 벤치마크가 열 벤치마크와 프로세서를 공유할 때의 성능을 나타낸다"
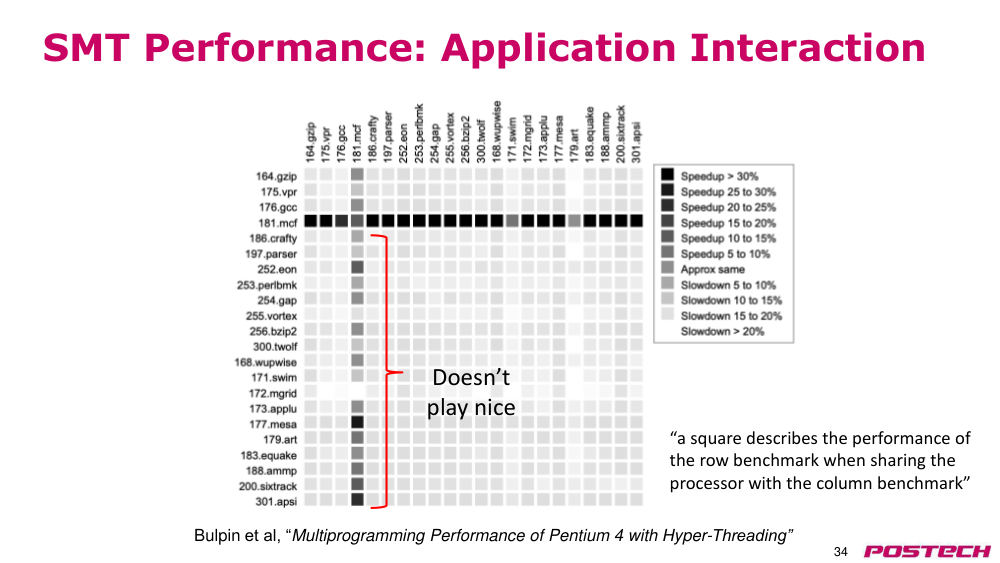
p.34SMT 성능: 애플리케이션 상호작용
- 다른 프로그램과 잘 어울리지 않음
- Bulpin 등, “Pentium 4 하이퍼스레딩의 다중 프로그래밍 성능”
- "한 사각형은 행 벤치마크가 열 벤치마크와 프로세서를 공유할 때의 성능을 나타낸다"
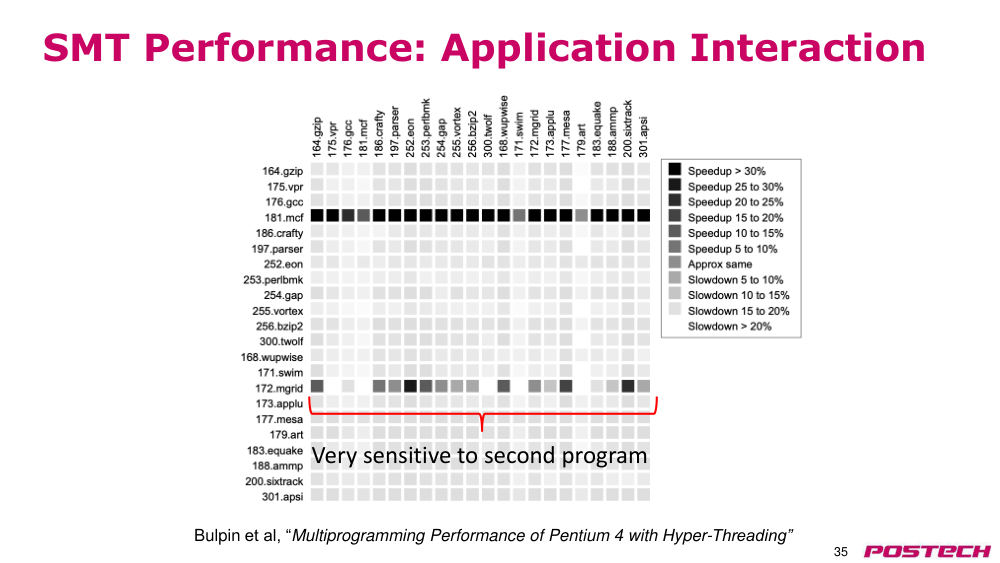
p.35SMT 성능: 애플리케이션 상호작용
- 두 번째 프로그램에 매우 민감함
- Bulpin 등, “Pentium 4 하이퍼스레딩의 다중 프로그래밍 성능"
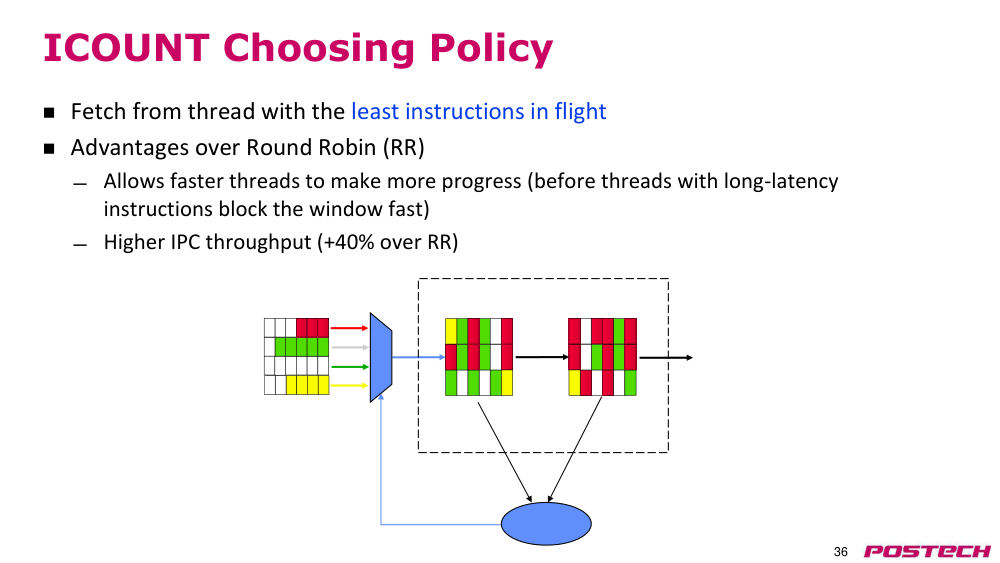
p.36ICOUNT choosing policy(ICOUNT 선택 정책)
- instructions in flight(실행 중 명령어 수)가 가장 적은 스레드에서 명령어를 가져옴
- 라운드 로빈(RR)보다 장점
- 지연 시간이 긴 명령어로 인해 윈도우가 빨리 막히기 전에 빠른 스레드가 더 많은 진전을 이룰 수 있음
- IPC throughput(IPC 처리량)이 round robin (RR)(라운드 로빈)보다 최대 40% 높음
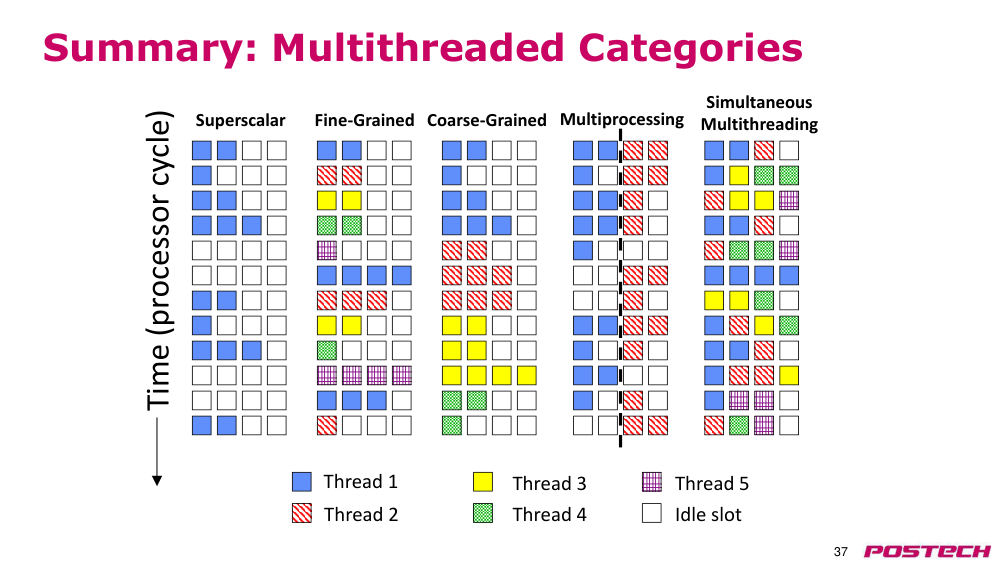
p.37multithreading(다중 스레딩) 카테고리 요약
- 시간 (프로세서 사이클)
- superscalar(슈퍼스칼라)
- fine-grained(미세적)
- coarse-grained(거시적)
- multiprocessing(다중 처리)
- simultaneous multithreading (SMT)(동시 다중 스레딩)
- 스레드 1
- 스레드 2
- 스레드 3
- 스레드 4
- 스레드 5
- 공백 슬롯
p.38SMT 및 보안
- 대부분의 하드웨어 공격은 shared hardware resources(공유 하드웨어 자원)을 이용해 side-channel(사이드 채널)을 설정한다.
- 예: 공유 외부 캐시, DRAM 행 버퍼
- SMT는 함께 실행되는 스레드에 의해 공유되는 이전에 비공개였던 하드웨어 자원에 고대역폭 접근을 제공한다:
- • TLB: TLBleed (2018년 6월)
- • L1 캐시: CacheBleed (2016)
- • 기능 단위 포트: PortSmash (2018년 11월)
- OpenBSD 6.4 → Intel HT 비활성화, AMD SMT도 추후 비활성화 예정
p.39질문?
- 추천 독서:
- 3.11 – 3.14 장