이 자료를 쓰는 강의: 10 physical register 관리, superscalar rename, branch prediction · 11 Branch target·return stack·LSQ 와 VLIW 도입
Lec8 - Superscalars
한국어판 강의자료 · 43쪽
p.1CSED503 고급 컴퓨터 구조 – 강의 8
p.2지난 강의에서 다룬 내용
- instruction execution phases(명령어 실행 단계): Fetch(가져오기)/Decode(디코딩)/rename(리네임)/Dispatch(디스패치)/Issue(이슈)/Execute(실행)/Complete(완료)/Commit(커밋)
- reorder buffer(ROB)(재정렬 버퍼)를 사용한 Tomasulo’s algorithm(토마술로의 알고리즘)
- Data-in-ROB design(ROB 내 데이터 설계) vs. unified physical register design(통합 물리 레지스터 설계)
- superscalar register renaming(슈퍼스칼라 레지스터 이름 변경)
p.3Control-Flow penalty(제어 흐름 패널티)
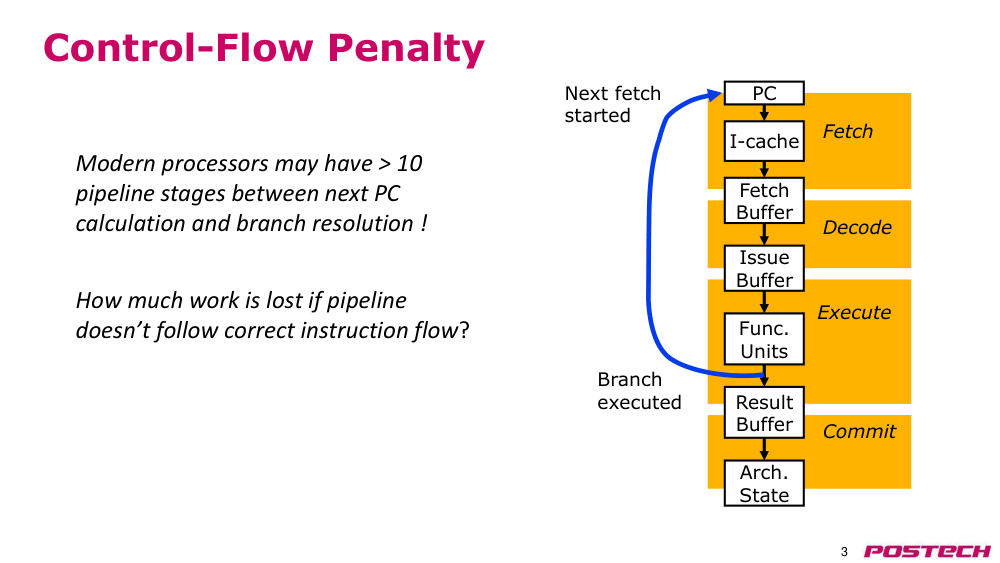
- I-cache
- 가져오기 버퍼
- 이슈 버퍼
- 기능 유닛
- 아키텍처 상태
- 실행
- 디코딩
- 결과 버퍼
- 커밋
- PC
- 브랜치 실행됨
- 다음 가져오기 시작됨
- 현대적인 프로세서는 다음 PC 계산과 branch resolution(브랜치 해석) 사이에 10개 이상의 파이프라인 단계를 가질 수 있음!
- 파이프라인이 올바른 명령어 흐름을 따르지 않을 경우 얼마나 많은 작업이 손실되는가?
p.4branch prediction(브랜치 예측)의 중요성
- 4-way 슈퍼스칼라, 가져오기에서 디스패치까지 8단계 파이프라인, 80개 항목의 ROB, 이슈에서 branch resolution(브랜치 해석)까지 3사이클을 가정
- 오예측 시 최악의 경우 8×4+(80−1)=111개의 명령어를 버릴 수 있음
- 정확도를 90%에서 95%로 개선하면 브랜치 오예측의 50%를 제거함
- 만약 1/6의 명령어가 브랜치라면, 오예측 사이의 명령어 수가 60개에서 120개로 증가함
p.5Control-Flow penalty(제어 흐름 패널티) 감소
- 소프트웨어적 해결책:
- 브랜치 제거 – loop unrolling(루프 전개)
- • 실행 길이 증가
- branch resolution(브랜치 해석) 시간 단축 – instruction scheduling(명령어 스케줄링)
- • 브랜치 조건을 가능한 한 일찍 계산 (한정된 가치 있음, 왜냐하면 브랜치는 종종 코드의 critical path(임계 경로)에 있기 때문)
- 하드웨어적 해결책:
- 다른 일을 하기 (지연 슬롯)
- • 파이프라인 버블을 유용한 작업으로 대체 (소프트웨어 협력 필요) – 빠르게 수익 감소
- speculate(추측) (즉, branch prediction(브랜치 예측))
- • 브랜치 이후의 명령어를 speculative execution(추측 실행)
- • 정확도 향상이 많이 이루어졌으며, 널리 사용됨
p.6branch prediction(브랜치 예측)
- 동기: 브랜치 패널티는 깊은 파이프라인 프로세서의 성능을 제한함
- 현대의 branch prediction(브랜치 예측)기는 높은 정확도(>95%)를 가지며 브랜치 패널티를 크게 줄일 수 있음
- 필요한 하드웨어 지원:
- 예측 구조:
- • branch history table (BHT)(브랜치 히스토리 테이블), branch target buffer (BTB)(브랜치 타겟 버퍼) 등
- mispredict recovery(오예측 복구) 메커니즘:
- • 명령어 실행과 커밋 단계를 분리
- • 오른쪽 브랜치에서 나온 명령어를 파이프라인에서 제거
- • 상태를 복원하고 올바른 브랜치를 따름
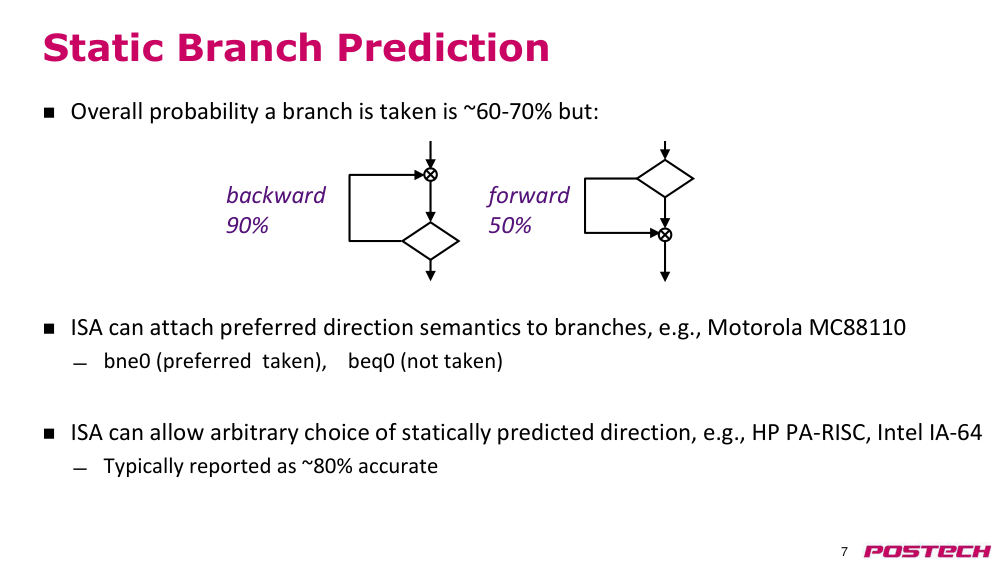
p.7static branch prediction(정적 브랜치 예측)
- 전체적으로 브랜치가 취해질 확률은 약 60-70%이지만:
- ISA는 브랜치에 선호 방향 의미를 부여할 수 있음, 예: Motorola MC88110
- bne0 (선호: 취함)
- beq0 (선호: 취하지 않음)
- ISA는 정적 예측 방향을 임의로 선택할 수 있음, 예: HP PA-RISC, Intel IA-64
- 일반적으로 약 80% 정확도로 보고됨
- 역방향 브랜치: 90%
- 전방향 브랜치: 50%
p.8dynamic branch prediction(동적 브랜치 예측)
- 과거 동작 기반 학습
- temporal correlation(시간적 상관관계)
- 브랜치가 해석되는 방식이 다음 실행 시 해석 방식을 잘 예측할 수 있음
- spatial correlation(공간적 상관관계)
- 여러 브랜치가 매우 상관관계 있는 방식으로 해석될 수 있음 (실행의 선호 경로)
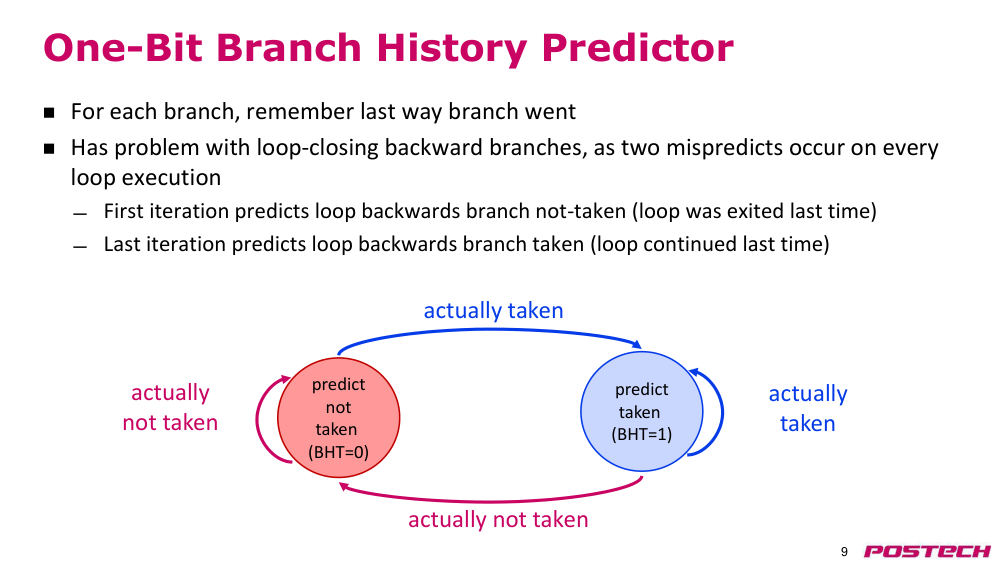
p.9One-Bit branch history predictor(1비트 브랜치 히스토리 예측기)
- 각 브랜치에 대해 이전에 브랜치가 어떤 방향으로 갔는지 기억함
- 루프 종료 역방향 브랜치에서 문제 발생, 매 루프 실행 시 두 번의 오예측 발생
- 첫 번째 반복: 루프 역방향 브랜치를 취하지 않음으로 예측 (이전에 루프를 빠져나갔음)
- 마지막 반복: 루프 역방향 브랜치를 취함으로 예측 (이전에 루프를 계속함)
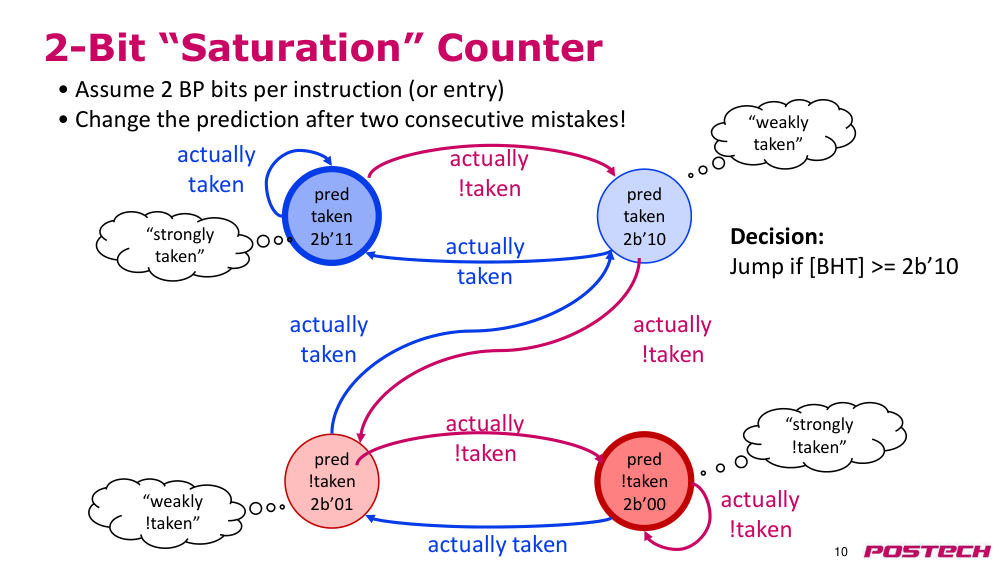
p.102비트 '포화' 카운터
- 예측: 취함 (2b’11)
- 예측: 취함 (2b’10)
- 예측: 취하지 않음 (2b’01)
- 예측: 취하지 않음 (2b’00)
- 실제로 취함
- 실제로 취함
- 실제로 취하지 않음
- 실제로 취하지 않음
- 실제로 취하지 않음
- 실제로 취하지 않음
- 실제로 취함
- 실제로 취함
- 결정: [BHT] >= 2b’10이면 점프
- 강하게 취함
- 약하게 취함
- 약하게 취하지 않음
- 강하게 취하지 않음
- 각 명령어당 2개의 BP 비트 가정 (또는 엔트리)
- 두 번 연속 오류 발생 후 예측 변경!
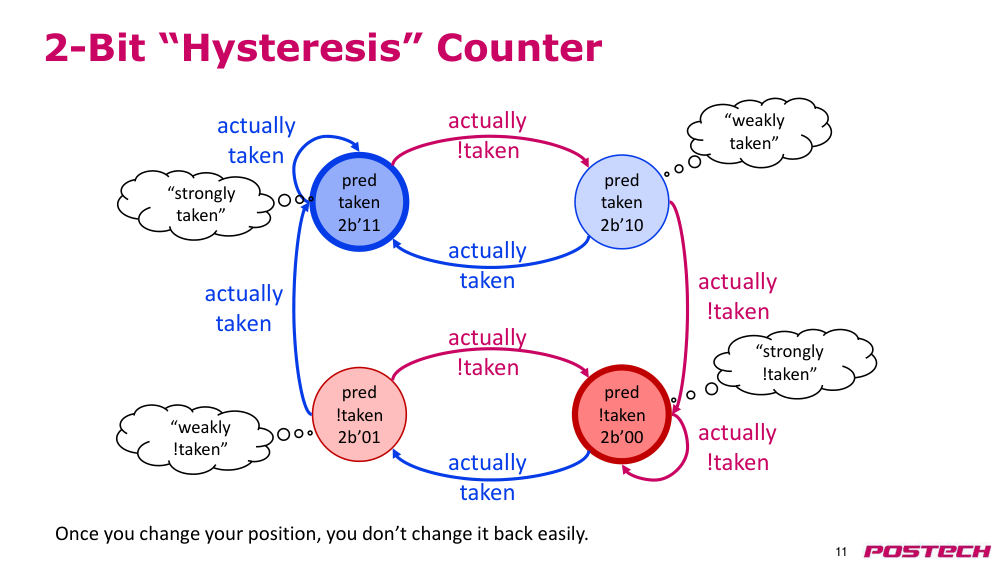
p.112비트 '히스테리시스' 카운터
- 예측: 취함 (2b’11)
- 예측: 취함 (2b’10)
- 예측: 취하지 않음 (2b’01)
- 예측: 취하지 않음 (2b’00)
- 실제로 취함
- 실제로 취함
- 실제로 취하지 않음
- 실제로 취하지 않음
- 실제로 취하지 않음
- 실제로 취하지 않음
- 실제로 취함
- 실제로 취함
- 약하게 취함
- 강하게 취함
- 약하게 취하지 않음
- 강하게 취하지 않음
- 한 번 위치를 변경하면 쉽게 되돌리지 않음
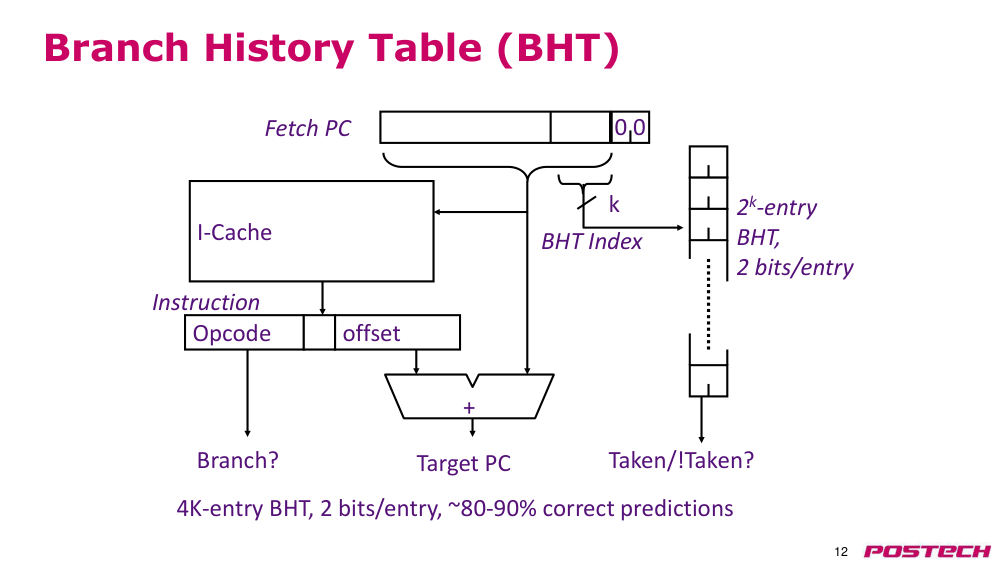
p.12브랜치 히스토리 테이블 (BHT)
- 4K 엔트리 BHT, 엔트리당 2비트, 약 80-90% 정확한 예측
- 0 0
- Fetch PC
- 브랜치?
- 타겟 PC
- +
- I-Cache
- Opcode
- offset
- Instruction
- k
- BHT 인덱스
- 2k-엔트리 BHT, 엔트리당 2비트
- 취함/취하지 않음?
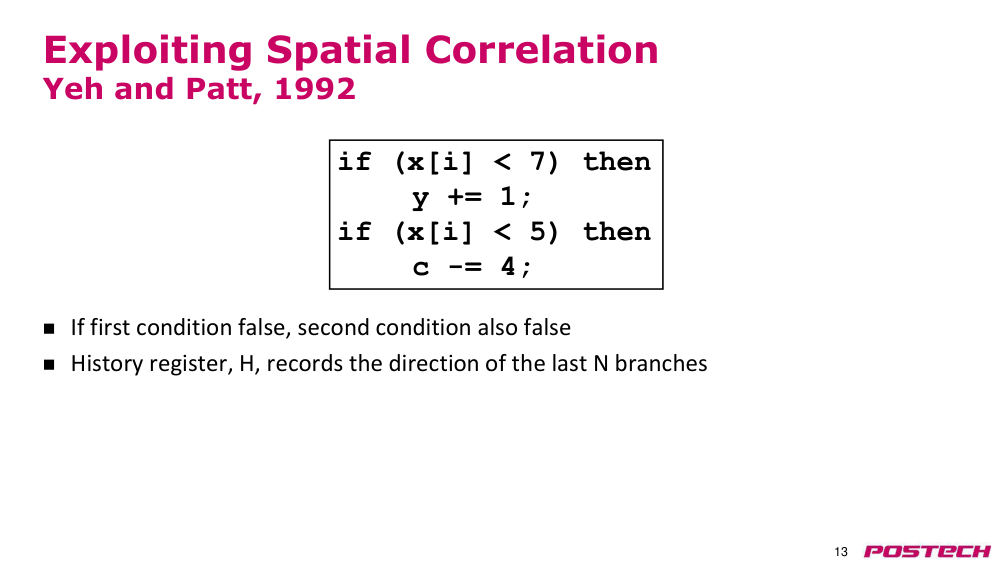
p.13spatial correlation(공간적 상관관계) 활용
- Yeh와 Patt, 1992
- 첫 번째 조건이 거짓이면, 두 번째 조건도 거짓이다.
- history register(히스토리 레지스터) H는 마지막 N개의 브랜치 방향을 기록한다.
- if (x[i] < 7) then
- y += 1;
- if (x[i] < 5) then
- c -= 4;
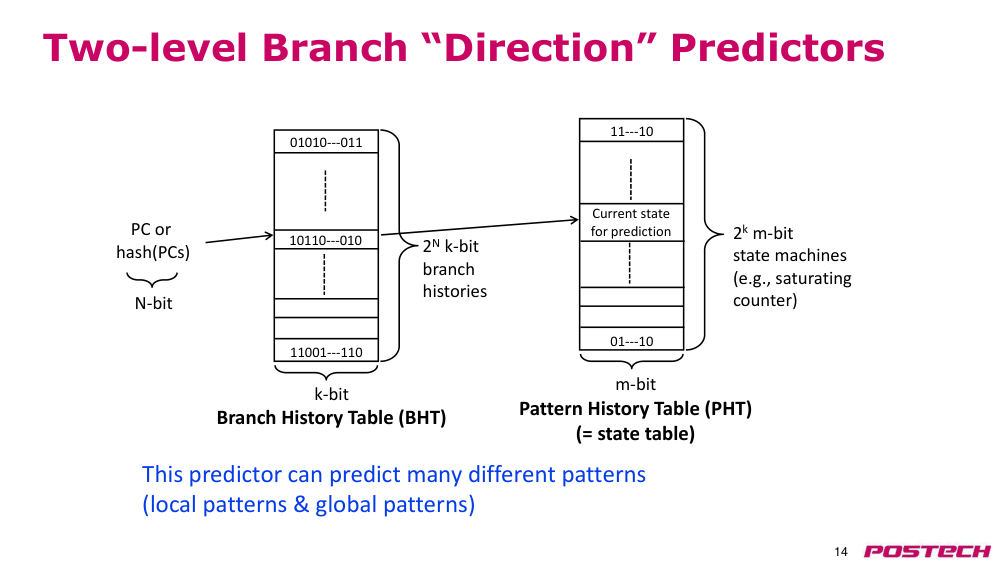
p.14이중 레벨 브랜치 '방향' 예측기
- 이 예측기는 다양한 패턴을 예측할 수 있다 (로컬 패턴 및 글로벌 패턴).
- PC 또는 hash(PCs)
- N비트
- 2N k비트
- 브랜치 히스토리
- k비트
- 브랜치 히스토리 테이블 (BHT)
- 10110---010
- 01010---011
- 11001---110
- 2k m비트
- 상태 기계 (예: 포화 카운터)
- m비트
- 패턴 히스토리 테이블 (PHT)
- (= 상태 테이블)
- 예측을 위한 현재 상태
- 11---10
- 01---10
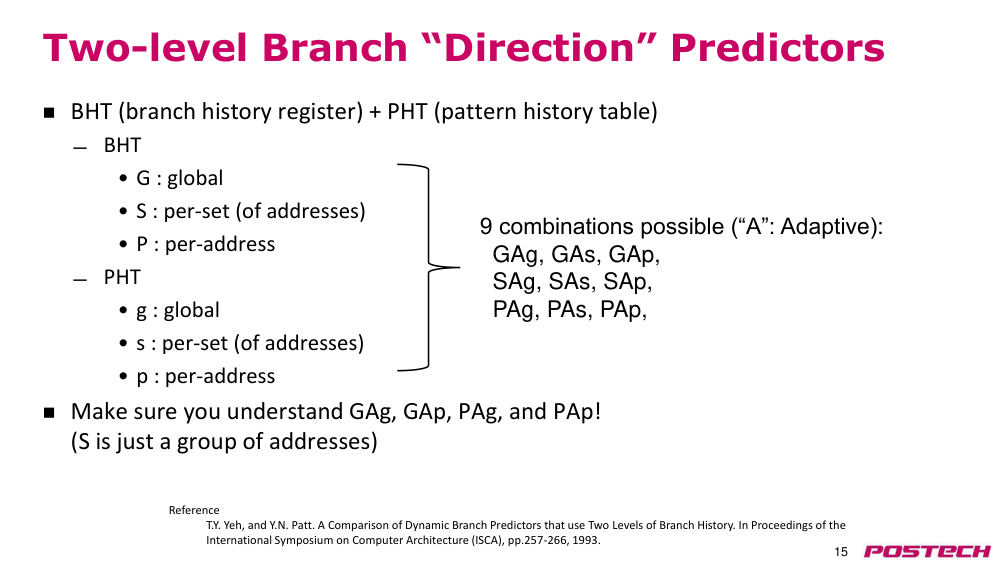
p.15이중 레벨 브랜치 '방향' 예측기
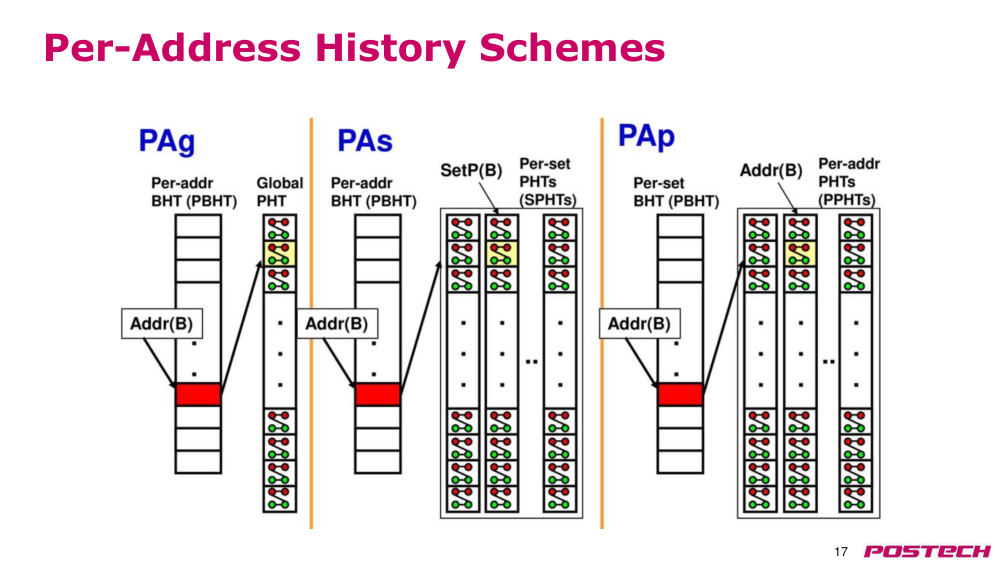
- BHT (브랜치 히스토리 레지스터) + PHT (패턴 히스토리 테이블)
- BHT
- • G : 글로벌
- • S : 주소 그룹별 (세트별)
- • P : 주소별
- PHT
- • g : 글로벌
- • s : 주소 그룹별 (세트별)
- • p : 주소별
- GAg, GAp, PAg, PAp를 이해해야 한다!
- (S는 단지 주소 그룹일 뿐이다)
- 9가지 조합 가능 ("A": 적응형):
- GAg, GAs, GAp,
- SAg, SAs, SAp,
- PAg, PAs, PAp,
- 참고
- T.Y. Yeh, and Y.N. Patt. A Comparison of Dynamic Branch Predictors that use Two Levels of Branch History. In Proceedings of the International Symposium on Computer Architecture (ISCA), pp.257-266, 1993.
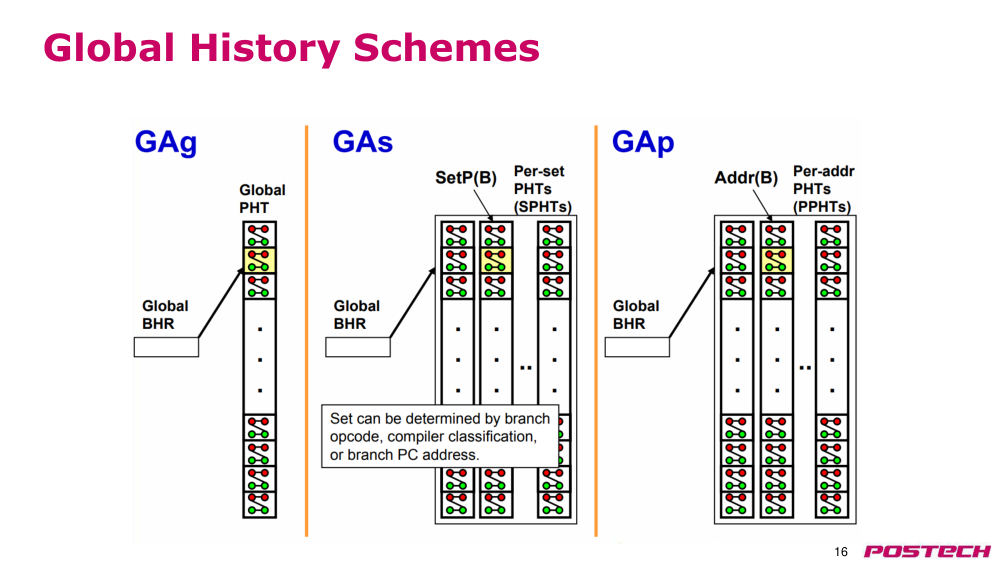
p.16global history scheme(글로벌 히스토리 방식)
p.17Per-Address history scheme(주소별 히스토리 방식)
p.18BHT의 한계
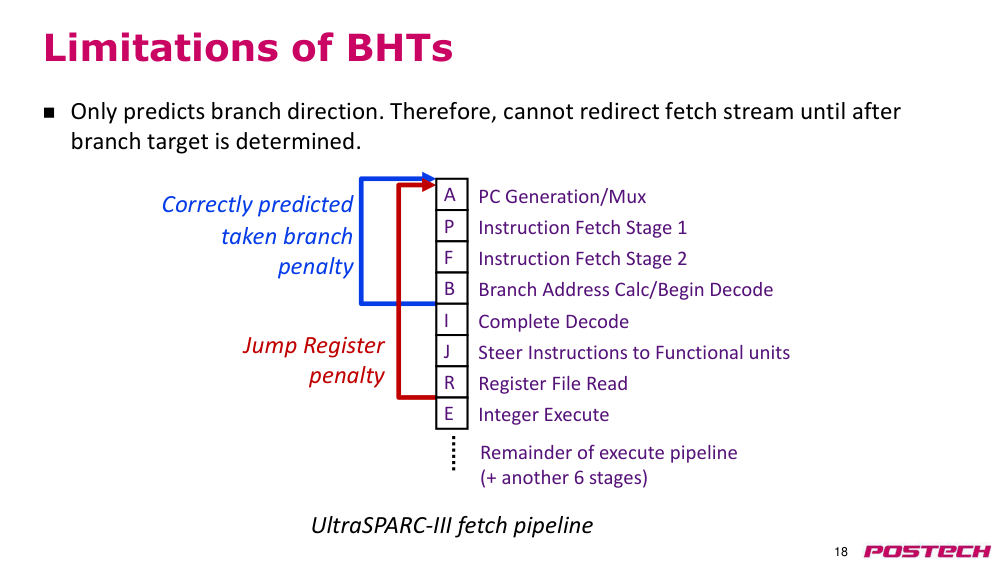
- 브랜치 방향만 예측한다. 따라서 브랜치 타겟이 결정되기 전까지 가져오기 스트림을 재정렬할 수 없다.
- UltraSPARC-III 가져오기 파이프라인
- 정확히 예측된 taken branch(취해진 브랜치) 패널티
- jump register (JR)(점프 레지스터) 패널티
- A
- PC 생성/멀티플렉서
- P
- 명령어 가져오기 단계 1
- F
- 명령어 가져오기 단계 2
- B
- 브랜치 주소 계산/디코딩 시작
- I
- 디코딩 완료
- J
- 명령어를 기능 유닛으로 안내
- R
- 레지스터 파일 읽기
- E
- 정수 실행
- 실행 파이프라인 나머지 단계 (+ 다른 6단계)
p.19브랜치 타겟 버퍼 (BTB)
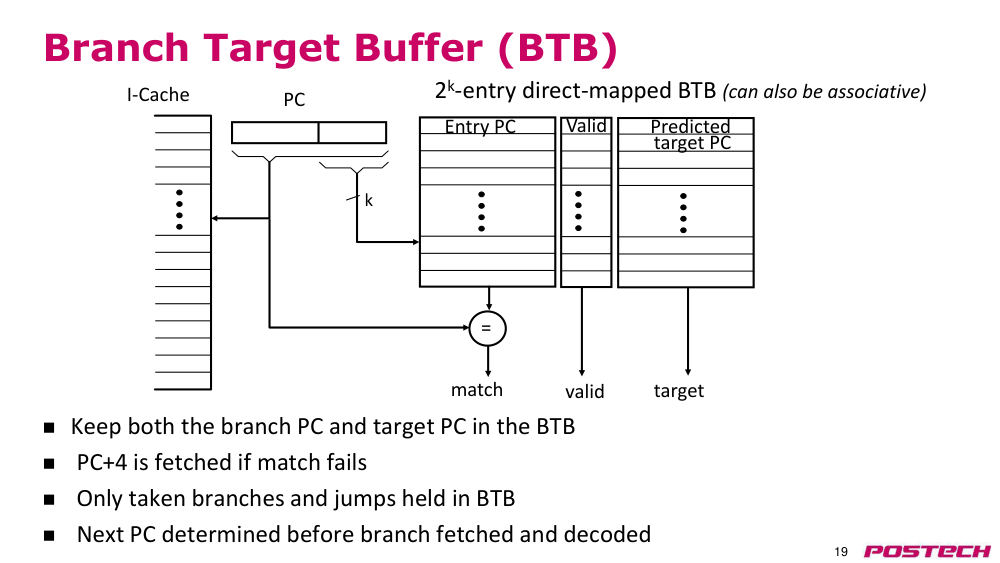
- 브랜치의 PC와 타겟 PC를 모두 BTB에 저장
- 일치 실패 시 PC+4를 가져옴
- BTB에는 오직 취해진 브랜치와 점프만 저장
- 브랜치가 가져오기 및 디코딩되기 전에 다음 PC를 결정함
- 2k-엔트리 직접 매핑 BTB (또는 연관성 방식 가능)
p.20BTB와 BHT의 결합
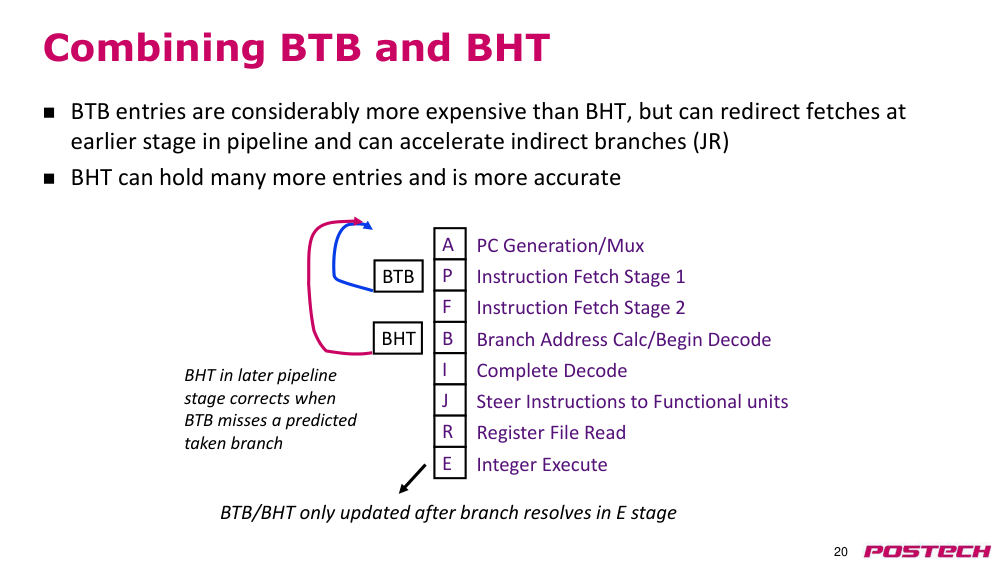
- BTB 엔트리는 BHT보다 훨씬 비용이 높지만, 파이프라인의 조기 단계에서 가져오기를 재지정할 수 있으며 간접 브랜치(JR)를 가속화할 수 있음
- BHT는 훨씬 더 많은 엔트리를 저장할 수 있고, 더 정확함
- BTB는 브랜치가 해석되는 E 단계 이후에만 업데이트됨
- BHT는 파이프라인 후단에서 BTB가 예측한 취해진 브랜치를 놓쳤을 때 이를 수정함
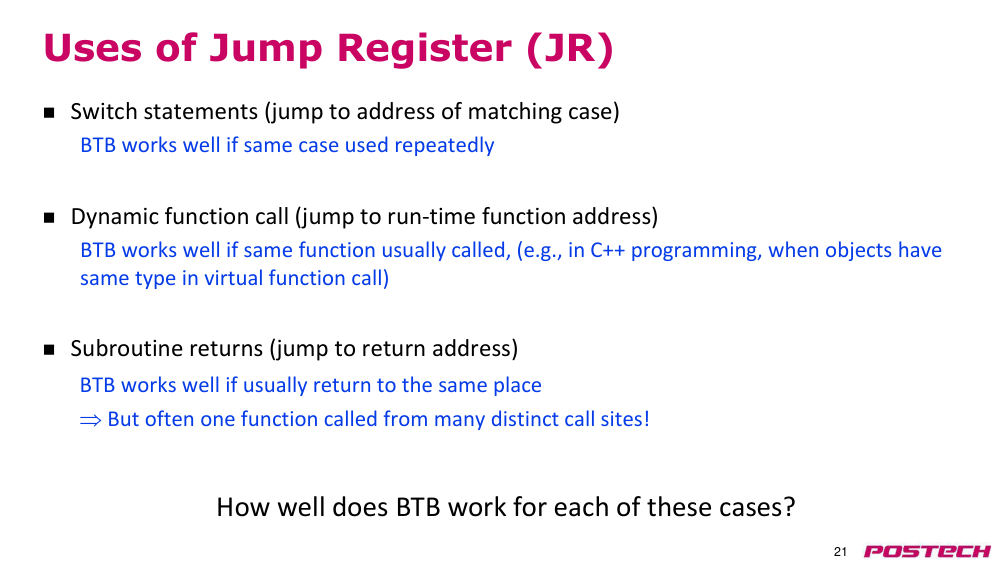
p.21점프 레지스터(JR)의 사용
- switch 문 (일치하는 case의 주소로 점프)
- 동일한 case가 반복적으로 사용될 경우 BTB는 잘 작동함
- 동적 함수 호출 (런타임 함수 주소로 점프)
- 동일한 함수가 자주 호출될 경우 BTB는 잘 작동함 (예: C++에서 가상 함수 호출 시 객체의 타입이 동일할 때)
- 서브루틴 리턴 (리턴 주소로 점프)
- 일반적으로 동일한 곳으로 리턴할 경우 BTB는 잘 작동함
- 그러나 종종 하나의 함수가 여러 개의 다른 호출 지점에서 호출됨
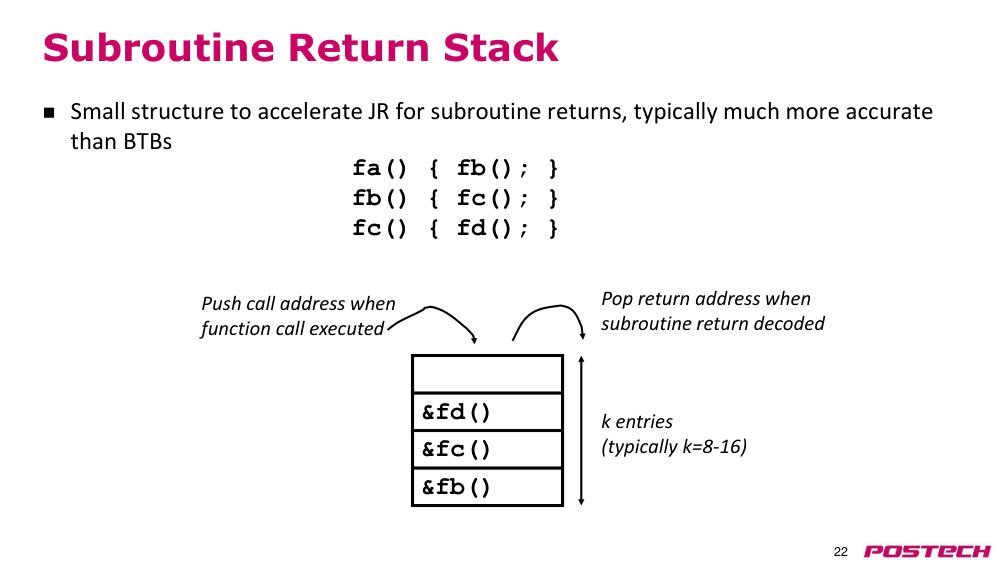
p.22subroutine return stack(서브루틴 리턴 스택)
- 서브루틴 리턴을 위한 JR을 가속화하기 위한 작은 구조물로, 일반적으로 BTB보다 훨씬 정확함
- 함수 호출 시 호출 주소를 푸시
- 서브루틴 리턴이 디코딩될 때 리턴 주소를 팝
- 엔트리 수: k개 (일반적으로 k=8-16)
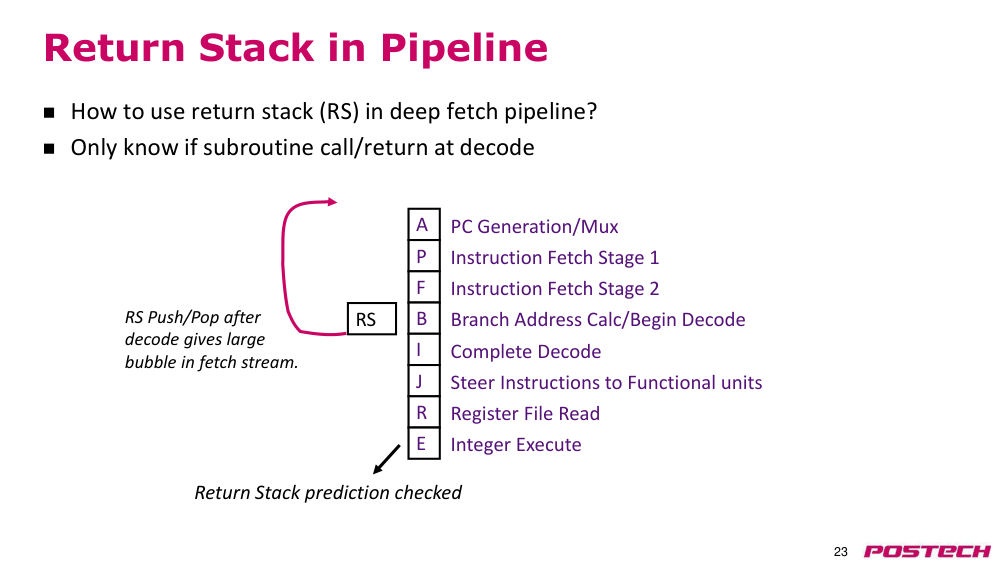
p.23파이프라인 내의 return stack(리턴 스택)
- 심층 가져오기 파이프라인에서 리턴 스택(RS)을 어떻게 사용할 것인가?
- 서브루틴 호출/리턴 여부는 디코딩 단계에서야 알 수 있음
- 디코딩 후 return stack(리턴 스택) 푸시/팝으로 가져오기 스트림에 큰 버블 발생
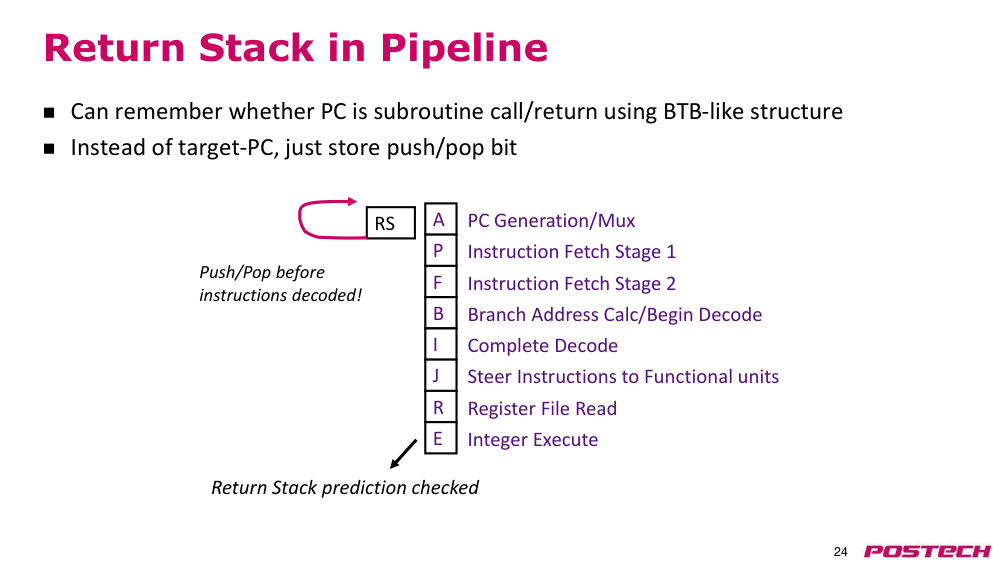
p.24파이프라인 내의 return stack(리턴 스택)
- BTB 유사 구조를 사용하여 PC가 서브루틴 호출/리턴인지 기억할 수 있음
- 타겟 PC 대신 푸시/팝 비트만 저장
- 명령어 디코딩 전에 푸시/팝 수행됨
- return stack(리턴 스택) 예측 확인
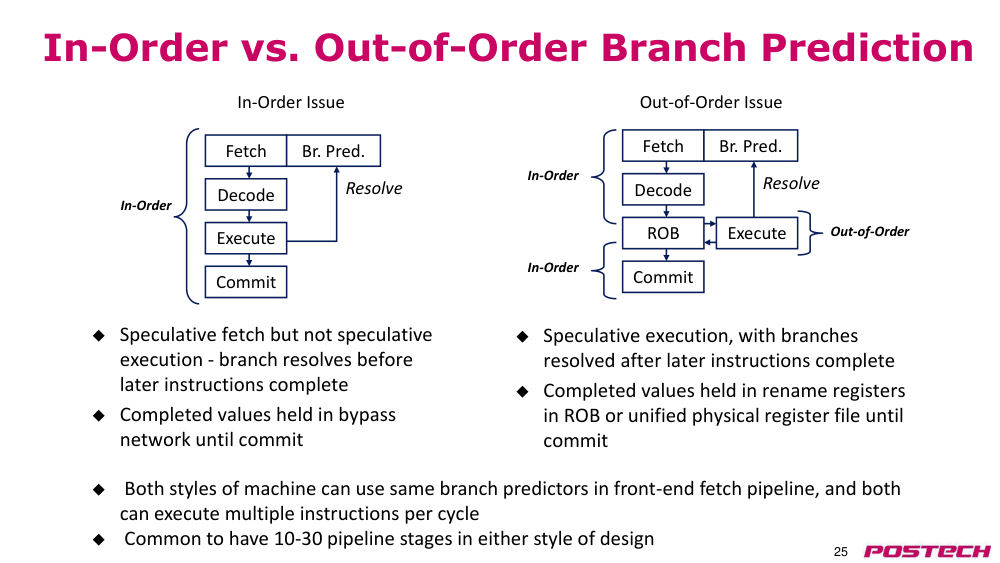
p.25In-Order execution(순차 실행) vs. Out-of-Order execution(비순차 실행) branch prediction(브랜치 예측)
- speculative fetch(추측 가져오기)이지만 speculative execution(추측 실행)은 아님 - 나중 명령어가 완료되기 전에 브랜치가 해석됨
- 완료된 값은 bypass network(바이패스 네트워크)에 커밋될 때까지 보관됨
- speculative execution(추측 실행), 브랜치는 나중 명령어가 완료된 후에 해석됨
- 완료된 값은 커밋될 때까지 ROB 또는 통합 물리 레지스터 파일의 rename registers(리네임 레지스터)에 보관됨
- 두 유형의 기계는 앞단의 명령어 가져오기 파이프라인에서 동일한 branch prediction(브랜치 예측)기를 사용할 수 있으며, 둘 다 사이클당 여러 명령어를 실행할 수 있음
- 두 유형의 설계에서 10~30단계의 파이프라인을 공통적으로 가짐
- 가져오기/디코딩/이슈/실행/완료/커밋
- In-Order execution(순차 실행)
- Out-of-Order execution(비순차 실행)
p.26In-Order execution(순차 실행) vs. Out-of-Order execution(비순차 실행) mispredict recovery(오예측 복구)
- In-Order execution(순차 실행)?̶
- 브랜치가 해석되기 전에 브랜치 뒤에 있는 어떤 명령어도 라이트백을 수행하지 않도록 보장̶
- 오예측 브랜치 뒤의 파이프라인에 있는 모든 kill instructions(명령어 제거)
- Out-of-Order execution(비순차 실행)?̶
- 프로그램 순서에서 브랜치 뒤에 있는 여러 명령어가 브랜치가 해석되기 전에 완료될 수 있음̶
- 간단한 해결책은 precise traps(정확한 트랩)과 같이 처리하는 것
- 문제?
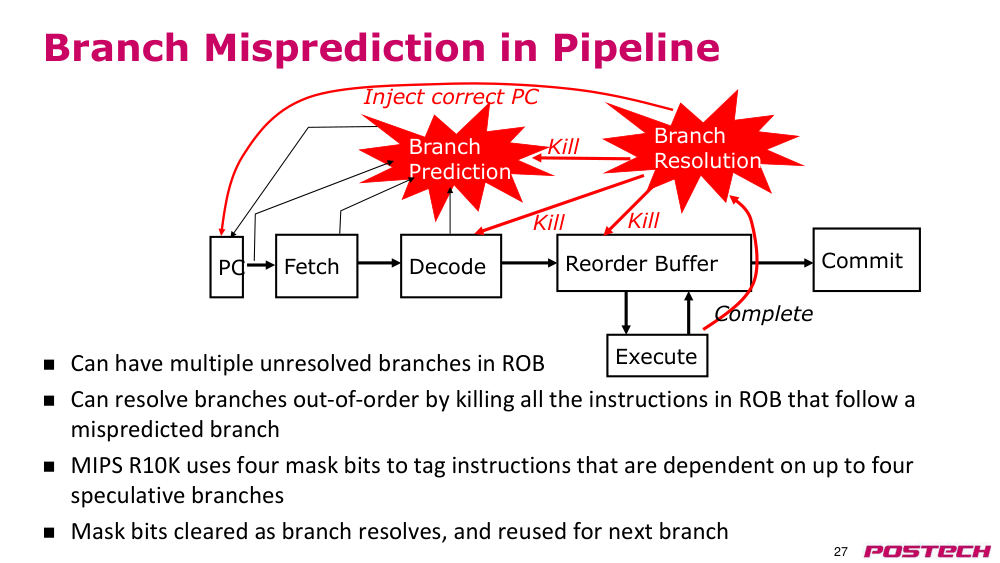
p.27파이프라인 내 브랜치 오예측
- ROB에 여러 개의 해석되지 않은 브랜치를 가질 수 있음
- 오예측 브랜치 뒤의 모든 명령어를 제거함으로써 브랜치를 비순차적으로 해석할 수 있음
- MIPS R10K는 최대 4개의 speculative branches(추측 브랜치)에 의존하는 명령어를 태그하기 위해 4개의 mask bits(마스크 비트)를 사용함
- 브랜치가 해석될 때 mask bits(마스크 비트)가 지워지고 다음 브랜치에 재사용됨
- 가져오기/디코딩/실행/커밋
- reorder buffer (ROB)(재정렬 버퍼)
- 제거
- 제거
- 제거
- PC
- 정확한 PC 삽입
- branch prediction(브랜치 예측)
- branch resolution(브랜치 해석)
- 완료
p.28rename table recovery(이름 테이블 복구)
- 브랜치 오예측 시 이름 테이블을 빠르게 복구해야 함
- MIPS R10K는 최대 4개의 outstanding speculative branches(미해결 추측 브랜치) 각각에 대해 4개의 snapshot(스냅샷)만 보유함
- Alpha 21264는 ROB 명령어당 1개씩 총 80개의 snapshot(스냅샷)을 보유함
p.29명령어 가져오기 개선
- speculative out-of-order machines(추측적 비순차 기계)의 성능은 종종 instruction fetch bandwidth(명령어 가져오기 대역폭)에 의해 제한됨̶
- speculative execution(추측 실행)은 커밋되는 것보다 2~3배 더 많은 명령어를 가져올 수 있음̶
- 오예측 패널티는 instruction window(명령어 윈도우)를 재채우는 데 걸리는 시간에 의해 주로 결정됨̶
- taken branch(취해진 브랜치)는 특히 문제를 일으킴
p.30taken branch(취해진 브랜치) 대역폭 증가 (Alpha 21264 I-Cache)
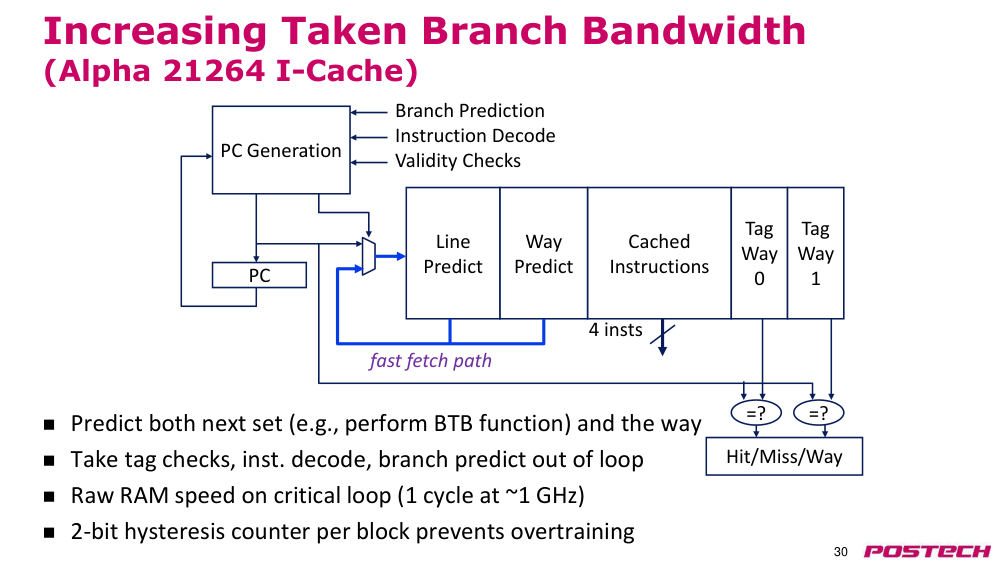
- 다음 세트(예: BTB 기능 수행)와 웨이를 모두 예측함
- 태그 검사, 명령어 디코딩, branch prediction(브랜치 예측)을 루프 외부에서 수행함
- 임계 루프에서의 원시 RAM 속도(약 1GHz에서 1 사이클)
- 블록당 2-bit hysteresis counter(2비트 히스테리시스 카운터)는 과도한 학습을 방지함
- 캐시된 명령어
- 라인 예측
- 웨이 예측
- 태그
- 웨이
- 0
- 태그
- 웨이
- 1
- =?
- =?
- 빠른 가져오기 경로
- PC 생성
- PC
- branch prediction(브랜치 예측)
- 명령어 디코딩
- 유효성 검사
- 4개의 명령어
- 히트/미스/웨이
p.31Alpha 21264 tournament predictor(토너먼트 예측기) [DEC1996]
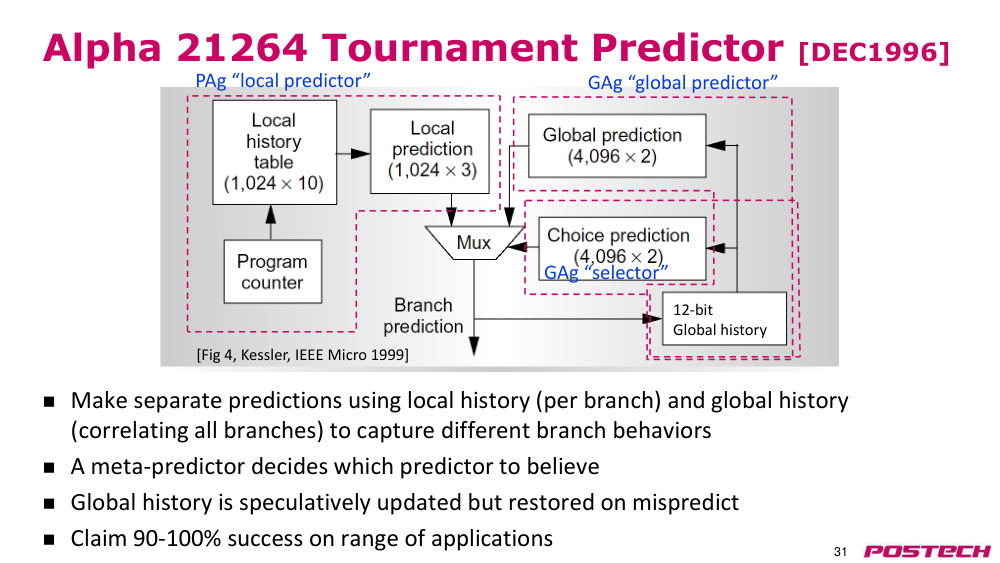
- 로컬 히스토리(각 브랜치별)와 글로벌 히스토리(모든 브랜치 간 상관관계)를 사용하여 별도의 예측을 수행하여 다양한 브랜치 행동을 포착
- Meta-Predictor(메타 예측기)가 어느 예측기를 신뢰할지 결정
- global history(글로벌 히스토리)에는 speculative update(추측적 업데이트)가 수행되지만, restore on mispredict(오예측 시 복원)됨
- 다양한 응용 프로그램에서 90-100% 성공률 주장
- [그림 4, Kessler, IEEE Micro 1999]
- 12비트 global history(글로벌 히스토리)
- PAg: '로컬 예측기'
- GAg: '글로벌 예측기'
- GAg: '선택기'
p.32taken branch(취해진 브랜치) 한계
- 정수 코드는 6-9개의 명령어마다 하나의 taken branch(취해진 브랜치)를 가짐
- 가져오기 병목을 피하기 위해 성능을 높일 때는 주기당 여러 개의 taken branch(취해진 브랜치)를 실행해야 함
- 이로부터 도출되는 결과:
- 주기당 여러 브랜치를 예측해야 함
- 주기당 비연속 블록 여러 개를 가져와야 함
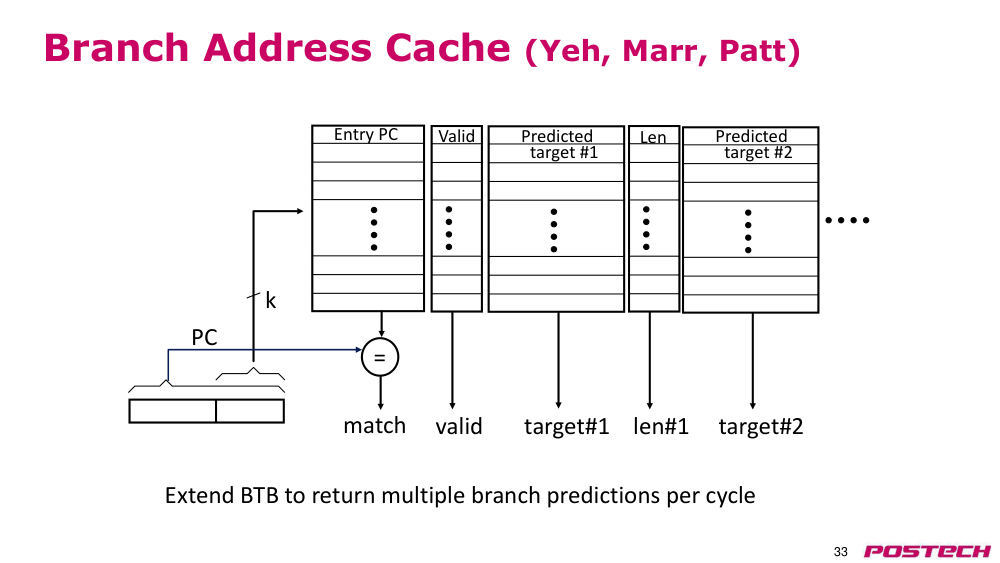
p.33브랜치 주소 캐시 (Yeh, Marr, Patt)
- PC
- k
- 엔트리 PC = 매치
- 유효
- 유효
- 예측된 타겟#1
- 타겟 #1
- 길이
- 길이#1
- 예측된 타겟#2
- 타겟 #2
- BTB를 확장하여 주기당 여러 branch prediction(브랜치 예측)을 반환
p.34여러 기본 블록 가져오기
- 다음 중 하나가 필요:
- 다중 포트 캐시: 비쌈
- 인터리빙: bank(뱅크) 충돌 발생 가능
- 디코더에 공급하기 위해 여러 블록을 병합하면 지연이 증가하여 오예측 패널티가 커지고 브랜치 처리량이 감소
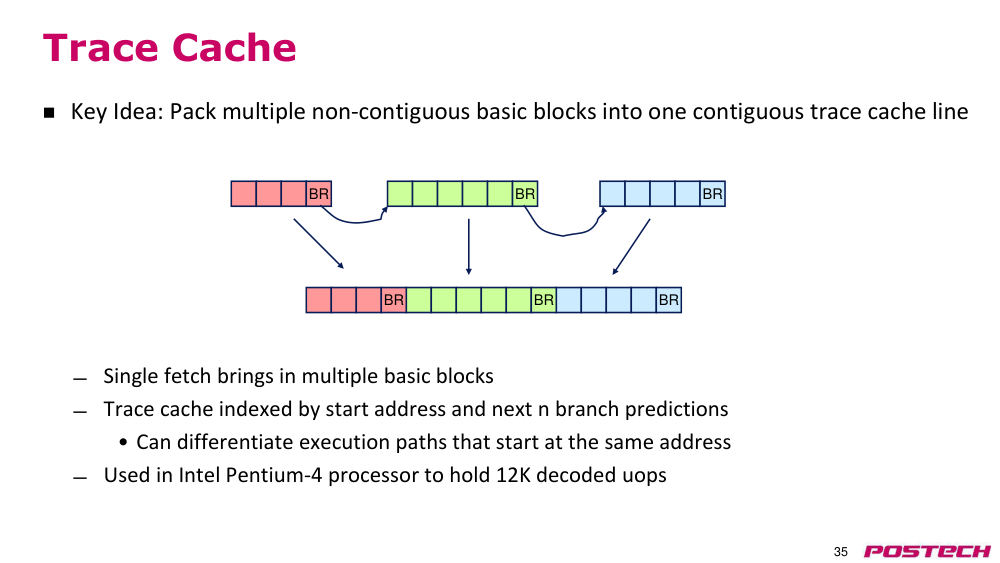
p.35트레이스 캐시
- 핵심 아이디어: 비연속적인 여러 기본 블록을 하나의 연속적인 트레이스 캐시 라인에 패킹
- 단일 가져오기로 여러 기본 블록을 가져옴
- 트레이스 캐시는 시작 주소와 다음 n개의 branch prediction(브랜치 예측)으로 인덱싱됨
- 동일한 주소에서 시작하는 실행 경로를 구분 가능
- Intel Pentium-4 프로세서에서 12K개의 디코딩된 uops를 저장하는 데 사용됨
- BR
- BR
- BR
- BR
- BR
- BR
p.36로드-스토어 큐 설계
- 제어 위험 이후, 메모리를 통한 데이터 위험은 슈퍼스칼라 성능에서 아마도 두 번째로 중요한 병목일 것
- 현대 슈퍼스칼라는 로드를 speculative issue(추측적 이슈)함으로써 효과적인 메모리 지연을 줄이기 위해 매우 정교한 로드-스토어 재정렬 기법을 사용
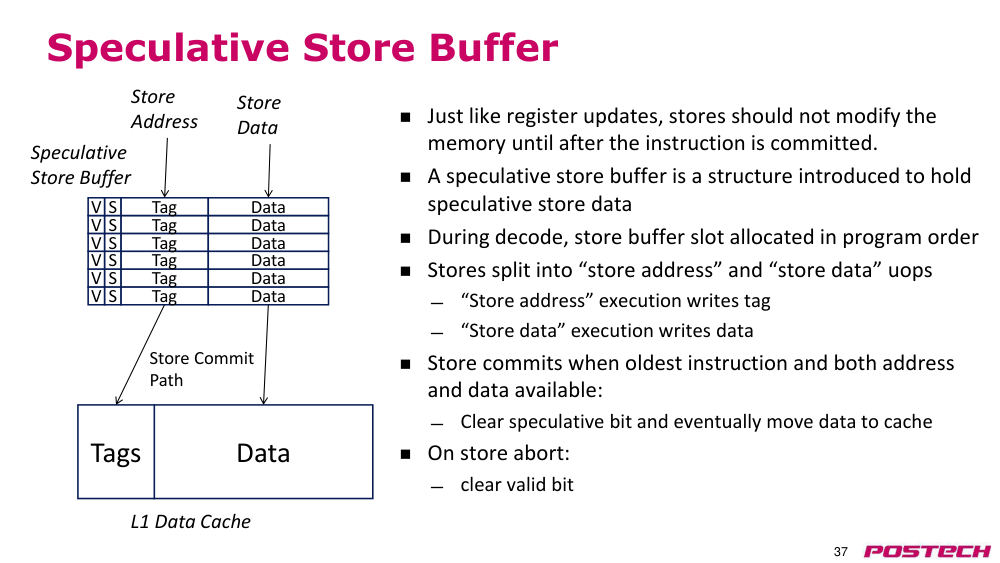
p.37speculative store buffer(추측 스토어 버퍼)
- 명령어가 커밋된 후에야 메모리가 수정되어야 한다.
- speculative store data(추측 스토어 데이터)를 보관하기 위해 도입된 구조이다.
- 디코딩 단계에서 프로그램 순서대로 저장 버퍼 슬롯을 할당한다.
- 저장 명령어는 "저장 주소"와 "저장 데이터"로 분리된 uops로 나뉜다.
- "저장 주소" 실행은 태그를 쓴다.
- "저장 데이터" 실행은 데이터를 쓴다.
- 가장 오래된 명령어와 주소 및 데이터가 모두 준비되면 저장이 커밋된다:
- speculative bit(추측 비트)를 지우고, 결국 데이터를 캐시로 이동한다.
- 저장 중단 시:
- 유효 비트를 지운다.
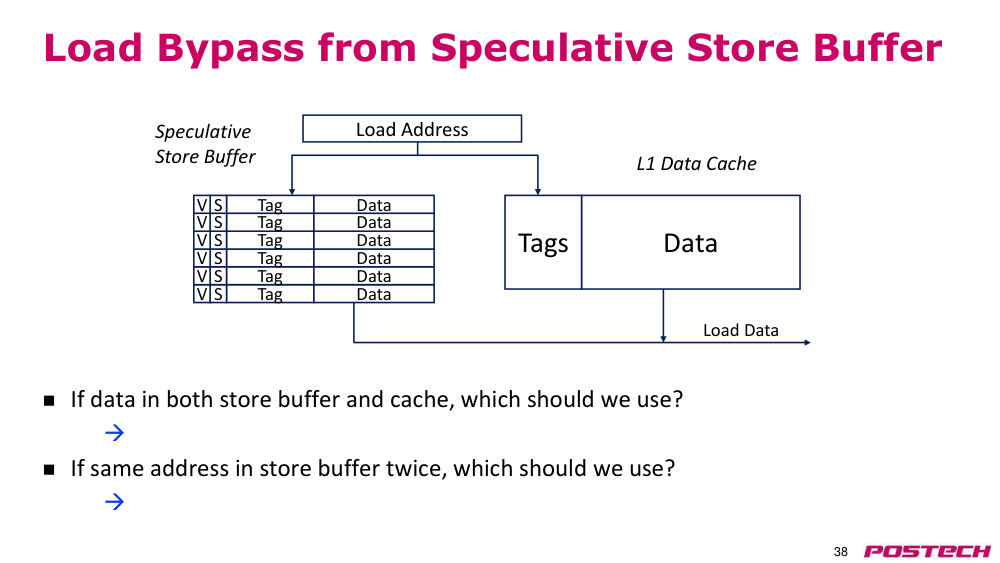
p.38speculative store buffer(추측 스토어 버퍼)에서의 로드 바이패스
- 저장 버퍼와 캐시에 모두 데이터가 있는 경우, 어떤 것을 사용해야 하는가?
- → speculative store buffer(추측 스토어 버퍼)
- 저장 버퍼에 동일한 주소가 두 번 있는 경우, 어떤 것을 사용해야 하는가?
- → 가장 최근의 저장 중에서 로드보다 오래된 것
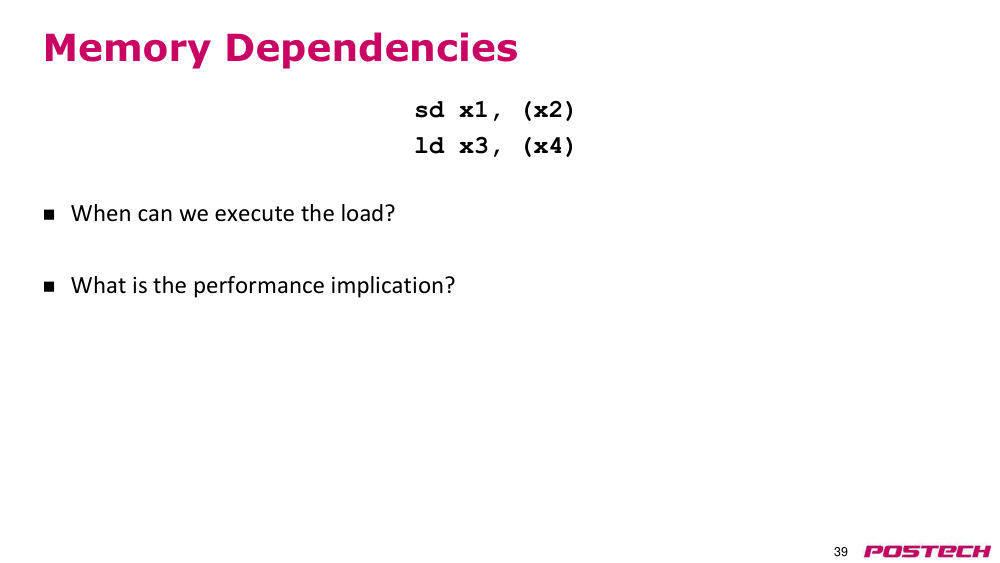
p.39메모리 의존성
- sd x1, (x2)
- ld x3, (x4)
- 로드를 언제 실행할 수 있는가?
- 성능에 어떤 영향을 미치는가?
p.40In-Order execution(순차 실행) 메모리 큐
- 모든 로드와 저장을 프로그램 순서대로 실행한다.
- => 이전 모든 로드와 저장이 실행을 완료하기 전까지 로드와 저장은 ROB에서 실행을 위해 나가지 않는다.
- 로드와 저장은 여전히 speculative execution(추측 실행)이 가능하며, 다른 명령어와는 비순차적으로 실행할 수 있다.
- 메모리 순서를 처리하기 위한 구조가 필요하다.
p.41보수적인 비순차 로드 실행
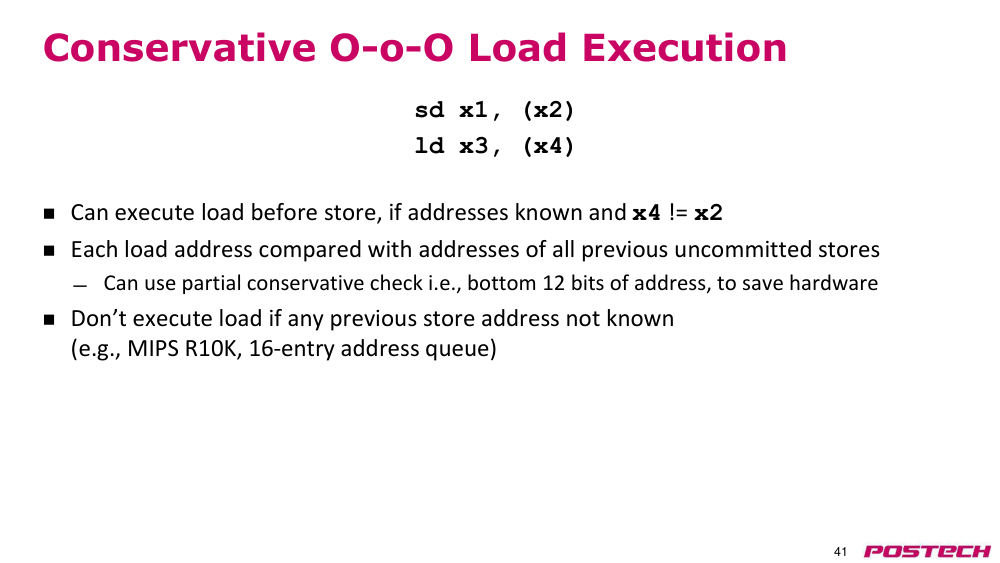
- 주소가 알려져 있고 x4 != x2인 경우, 저장보다 앞서 로드를 실행할 수 있다.
- 각 로드 주소는 모든 이전 커밋되지 않은 저장의 주소와 비교된다.
- 하드웨어를 절약하기 위해 부분적인 보수적 검사(예: 주소의 하위 12비트)를 사용할 수 있다.
- 이전 저장 주소 중 하나라도 알려지지 않은 경우 로드를 실행하지 않는다.
- (예: MIPS R10K, 16개의 엔트리 주소 큐)
p.42address speculation(주소 추측) (Alpha 21264)
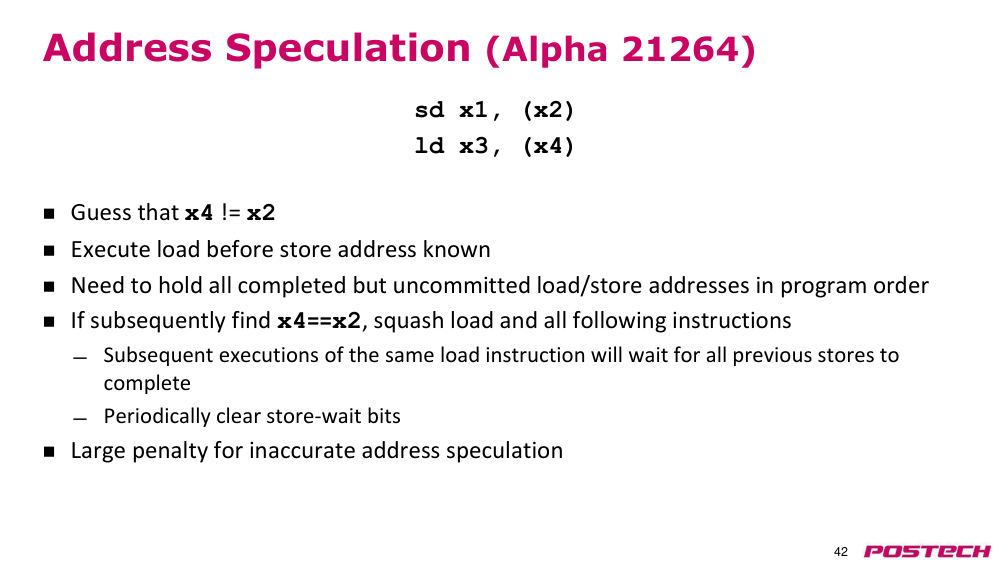
- x4 != x2라고 추측한다.
- 저장 주소가 알려지기 전에 로드를 실행한다.
- 모든 완료되었지만 커밋되지 않은 로드/저장 주소를 프로그램 순서로 유지해야 한다.
- 나중에 x4 == x2임을 알게 되면, 로드와 이후 모든 명령어를 제거한다.
- 동일한 로드 명령어의 후속 실행은 모든 이전 저장이 완료될 때까지 기다린다.
- 주기적으로 저장 대기 비트를 지운다.
- 부정확한 address speculation(주소 추측)에 큰 패널티가 있다.
p.43질문?
- 추천 독서: 책의 3.9-3.10장