이 자료를 쓰는 강의: 04 Pipelining 기초: 5-stage pipeline 과 hazard
Lec4 - Pipelining (Basic) - updated
한국어판 강의자료 · 59쪽
p.1
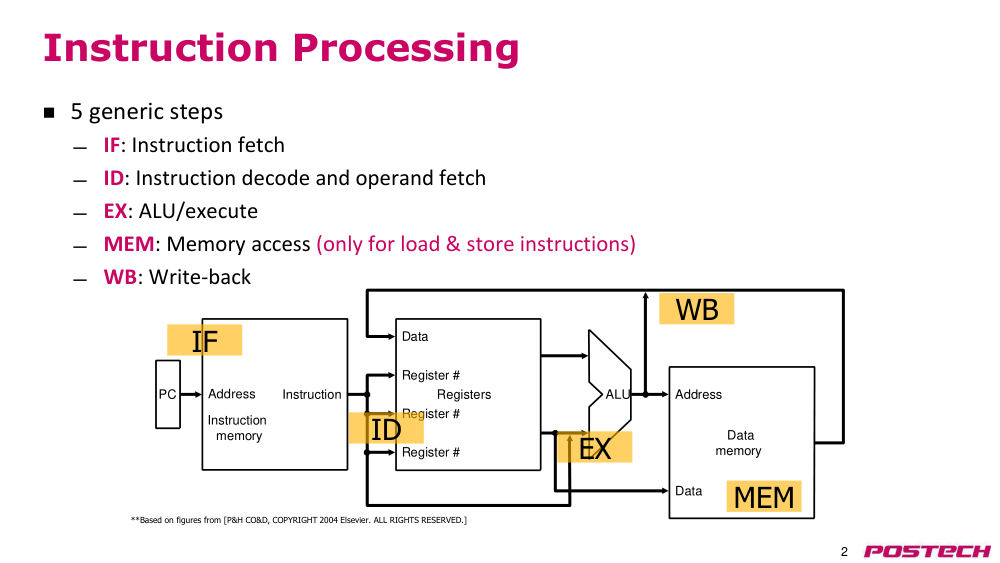
p.2명령어 처리
- 5개의 일반적인 단계
- IF: instruction fetch(명령어 가져오기)
- ID: instruction decode(명령어 디코딩) 및 operand fetch(피연산자 가져오기)
- EX: ALU execute(ALU 실행)
- MEM: 메모리 접근 (로드 및 SD(스토어) 명령어에만 해당)
- WB: write-back(쓰기 되돌림)
- 레지스터
- 레지스터 번호
- 데이터
- 레지스터 번호
- 데이터
- 메모리
- 주소
- 데이터
- 레지스터 번호
- program counter(프로그램 카운터)
- 명령어
- ALU(산술논리장치)
- instruction memory(명령어 메모리)
- 주소
- IF
- ID
- EX
- MEM
- WB
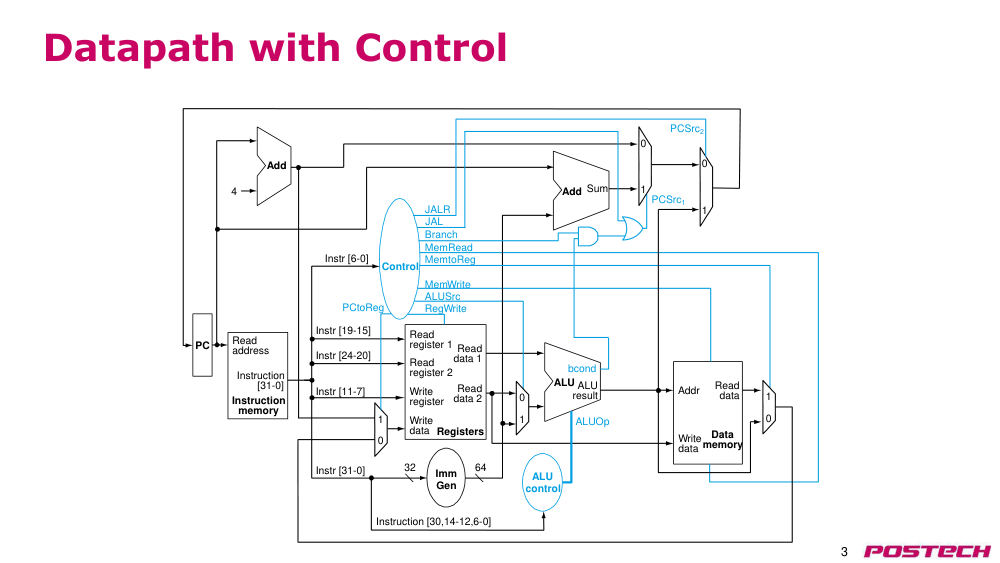
p.3제어가 있는 데이터패스
- 레지스터 1 읽기
- 쓰기 데이터
- 레지스터
- ALU(산술논리장치)
- 덧셈
- 조건부 branch(분기)
- 데이터 1 읽기
- 데이터 2 읽기
- 명령어 [31-0]
- ALU(산술논리장치) 결과
- 덧셈
- 합
- 주소
- data memory(데이터 메모리)
- 데이터 읽기
- 4
- 주소 읽기
- instruction memory(명령어 메모리)
- program counter(프로그램 카운터)
- ALU(산술논리장치)
- 제어
- branch(분기)
- MemRead(메모리 읽기)
- MemtoReg(메모리에서 레지스터로)
- ALUOp(ALU 연산 코드)
- MemWrite(메모리 쓰기)
- ALUSrc(ALU 입력 소스)
- RegWrite(레지스터 쓰기)
- 제어
- 레지스터 2 읽기
- 쓰기 레지스터
- 쓰기 데이터
- 이미디어트 생성기
- 32
- 64
- 명령어 [19-15]
- 명령어 [24-20]
- 명령어 [31-0]
- 명령어 [30,14-12,6-0]
- 명령어 [6-0]
- 명령어 [11-7]
- 0
- 1
- 1
- 0
- 0
- 1
- 1
- 0
- JAL
- JALR
- 0
- 1
- PCtoReg(PC에서 레지스터로)
- PCSrc(PC 선택) 1
- PCSrc(PC 선택) 2
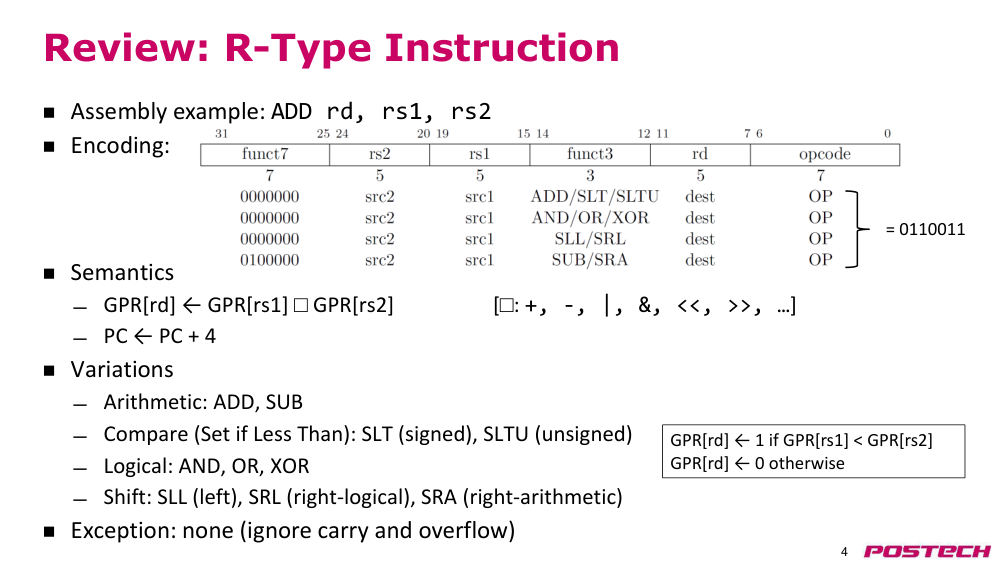
p.4리뷰: R-Type instruction(R형 명령어)
- 어셈블리 예시: ADD rd, rs1, rs2
- 인코딩:
- 의미:
- GPR[rd] ← GPR[rs1] □ GPR[rs2]
- [□: +, -, |, &, <<, >>, …]
- program counter(프로그램 카운터) ← 프로그램 카운터 + 4
- 변형:
- 산술: ADD, SUB
- 비교 (작은 경우 설정): SLT (부호 있는), SLTU (부호 없는)
- 논리: AND, OR, XOR
- 시프트: SLL (왼쪽), SRL (논리 오른쪽), SRA (산술 오른쪽)
- 예외: 없음 (캐리 및 오버플로 무시)
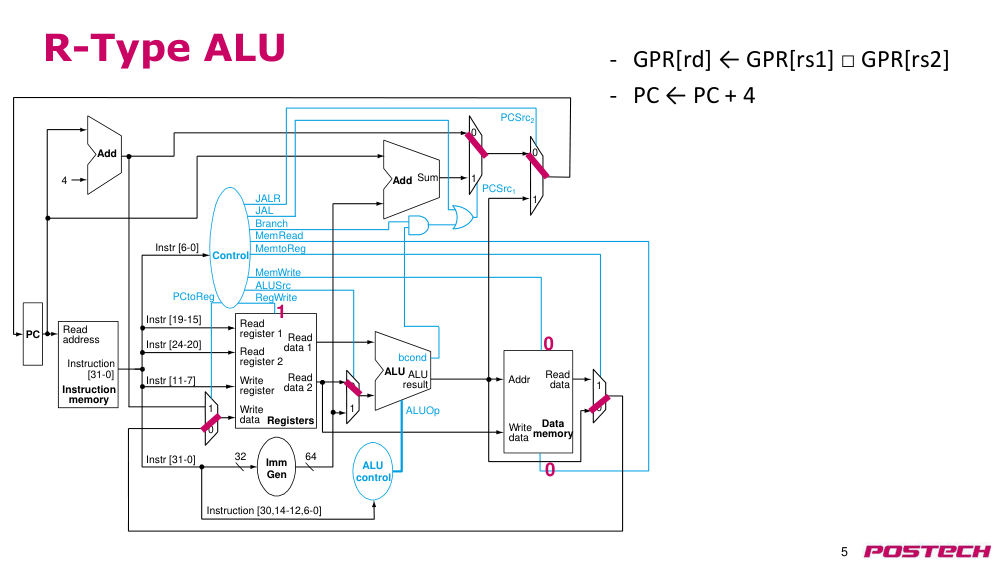
p.5R형 ALU
- - GPR[rd] ← GPR[rs1] □ GPR[rs2]
- - program counter(프로그램 카운터) ← 프로그램 카운터 + 4
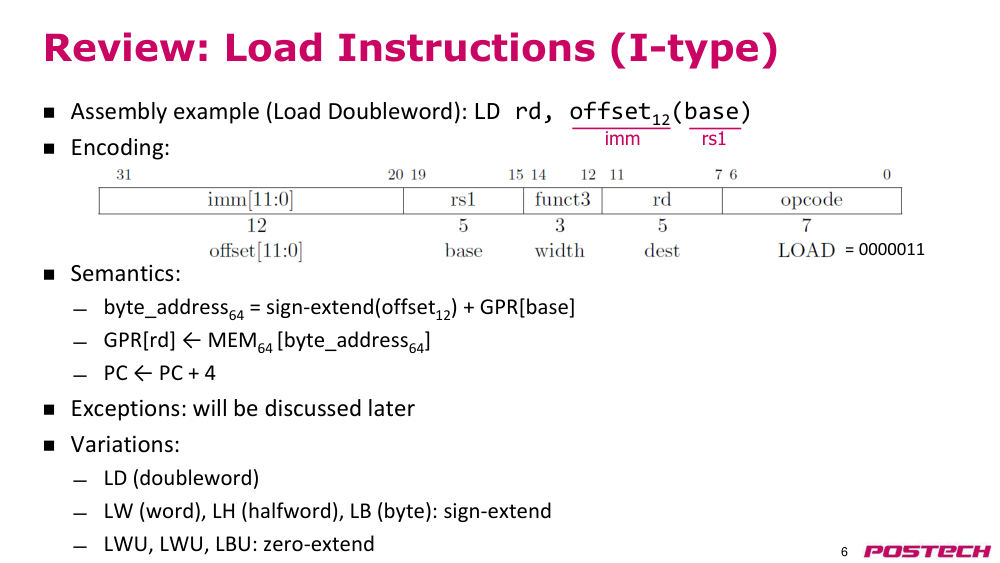
p.6리뷰: LD(로드) 명령어 (I형)
- 어셈블리 예시 (더블워드 로드): LD rd, offset12(base)
- 인코딩:
- 의미:
- byte_address64 = 부호 확장(offset12) + GPR[base]
- GPR[rd] ← MEM64[byte_address64]
- program counter(프로그램 카운터) ← 프로그램 카운터 + 4
- 예외: 나중에 논의될 예정
- 변형:
- LD (더블워드)
- LW (워드), LH (하프워드), LB (바이트): Sign-Extend(부호 확장)
- LWU, LHU, LBU: Zero-Extend(0 확장)
- rs1
- 이미디어트
- = 0000011
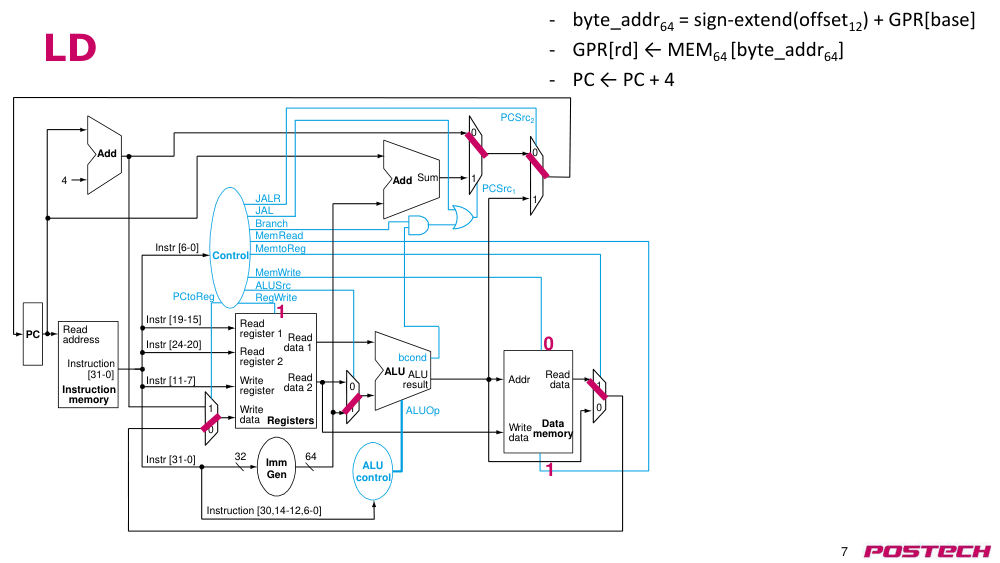
p.7로드 명령어 (LD)
- instruction fetch(명령어 가져오기): instruction memory(명령어 메모리)에서 명령어를 읽음
- instruction decode(명령어 디코딩): 명령어를 분석하여 register file(레지스터 파일)에서 두 개의 피연산자(레지스터 1, 레지스터 2)를 읽음
- operand fetch(피연산자 가져오기): ALU에 입력할 두 개의 데이터(Read data 1, Read data 2)를 준비
- ALU execute(ALU 실행): ALU는 PC + 4를 계산하여 다음 명령어 주소를 생성
- memory access(메모리 접근): ALU 결과를 기반으로 data memory(데이터 메모리)에서 데이터를 읽음
- write-back(쓰기 되돌림): 읽은 데이터를 register file(레지스터 파일)에 씀
- byte_addr64 = sign-extend(offset12) + GPR[base]
- GPR[rd] ← MEM64 [byte_addr64]
- PC ← PC + 4
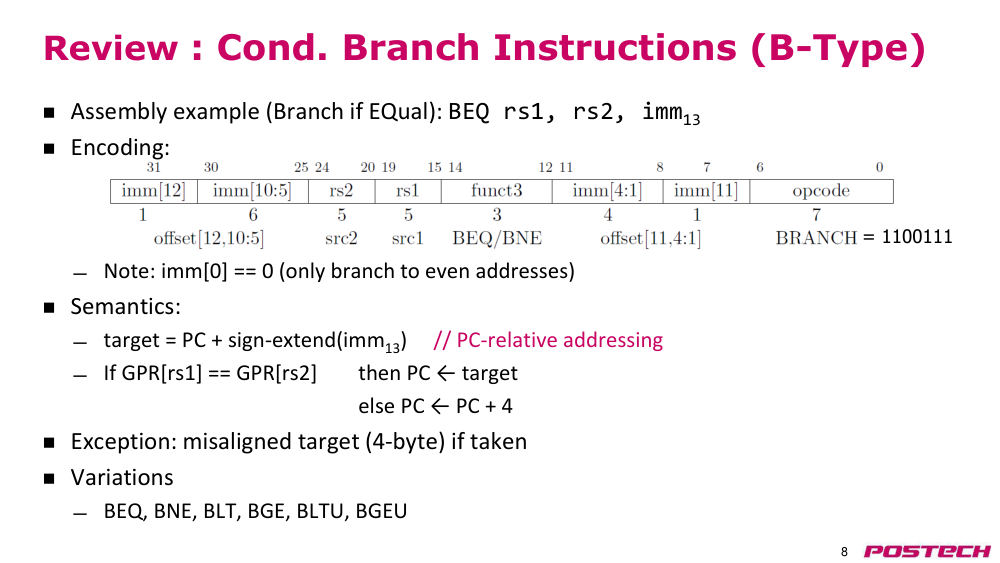
p.8조건부 branch(분기) 명령어 리뷰 (B형)
- 어셈블리 예시 (등가 분기): BEQ rs1, rs2, imm13
- 인코딩: Note: imm[0] == 0 (단지 짝수 주소로 branch(분기) 가능)
- 의미: target = PC + sign-extend(imm13) // PC-Relative addressing(PC 상대 주소 지정)
- 만약 GPR[rs1] == GPR[rs2] 이면 PC ← target
- 아니면 PC ← PC + 4
- 예외: branch(분기) 시도 시 정렬되지 않은 대상(4바이트) 발생
- 변형: BEQ, BNE, BLT, BGE, BLTU, BGEU
- = 1100111
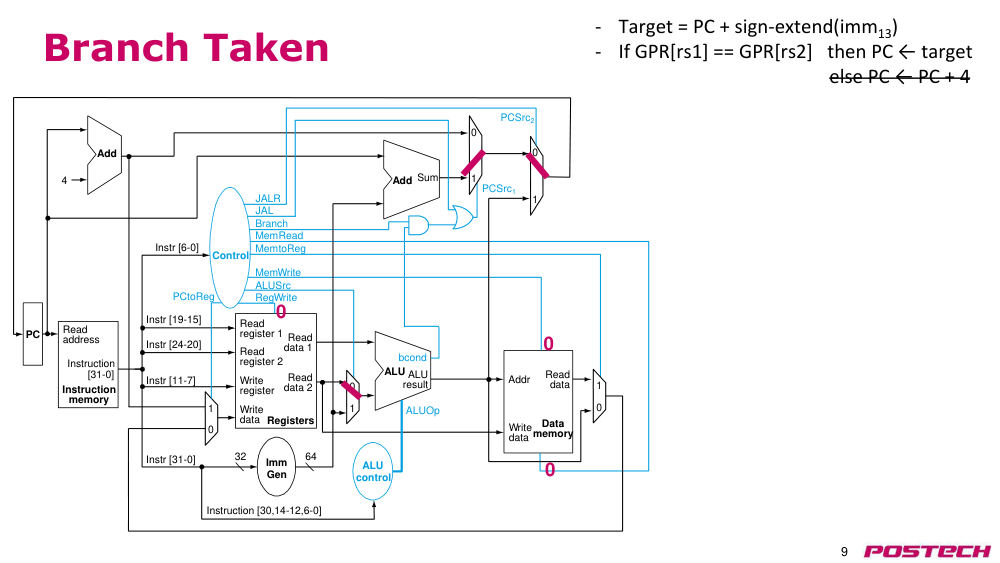
p.9branch(분기) 시도 시
- instruction fetch(명령어 가져오기): instruction memory(명령어 메모리)에서 명령어를 읽음
- instruction decode(명령어 디코딩): 명령어를 분석하여 register file(레지스터 파일)에서 두 개의 피연산자(레지스터 1, 레지스터 2)를 읽음
- operand fetch(피연산자 가져오기): ALU에 입력할 두 개의 데이터(Read data 1, Read data 2)를 준비
- ALU execute(ALU 실행): ALU는 PC + 4를 계산하여 다음 명령어 주소를 생성
- memory access(메모리 접근): ALU 결과를 기반으로 data memory(데이터 메모리)에서 데이터를 읽음
- write-back(쓰기 되돌림): 읽은 데이터를 register file(레지스터 파일)에 씀
- Target = PC + sign-extend(imm13)
- 만약 GPR[rs1] == GPR[rs2] 이면 PC ← target
- 아니면 PC ← PC + 4
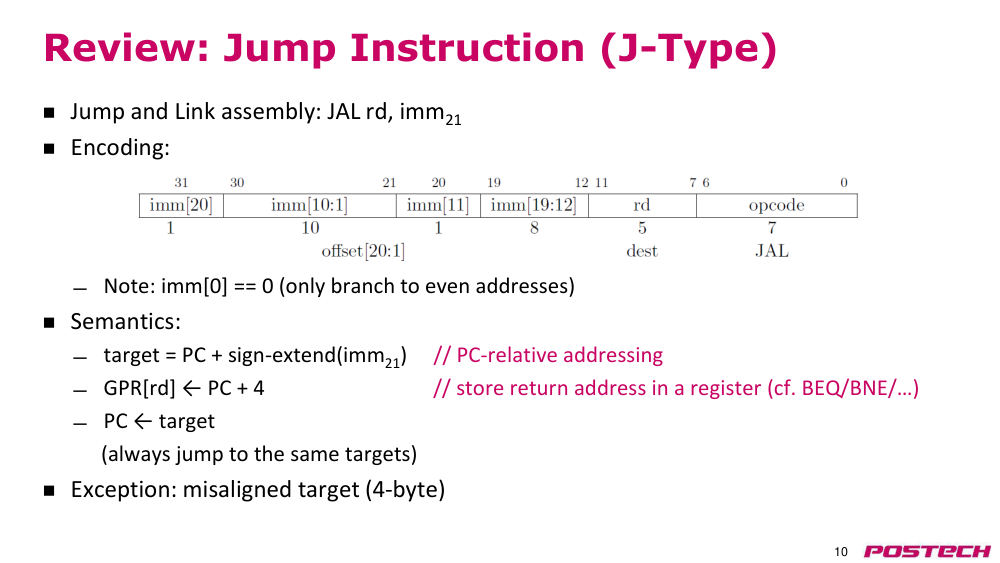
p.10점프 명령어 리뷰 (J형)
- 점프 및 링크 어셈블리: JAL rd, imm21
- 인코딩: Note: imm[0] == 0 (단지 짝수 주소로 점프 가능)
- 의미: target = PC + sign-extend(imm21) // PC-Relative addressing(PC 상대 주소 지정)
- GPR[rd] ← PC + 4 // 반환 주소를 레지스터에 저장 (BEQ/BNE 등과 비교)
- PC ← target // 항상 동일한 대상으로 점프
- 예외: 정렬되지 않은 대상(4바이트)
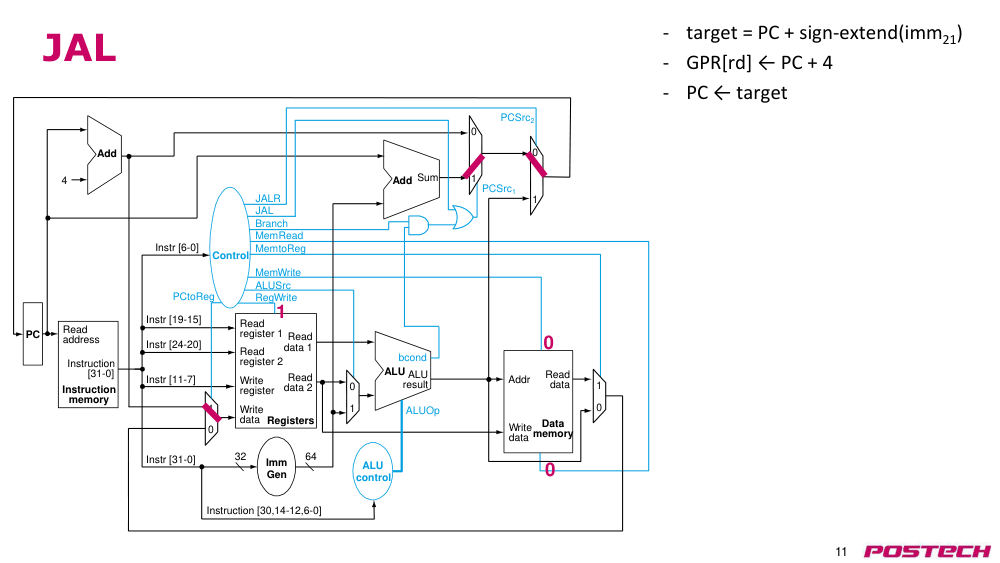
p.11점프 및 링크 (JAL)
- instruction fetch(명령어 가져오기): instruction memory(명령어 메모리)에서 명령어를 읽음
- instruction decode(명령어 디코딩): 명령어를 분석하여 register file(레지스터 파일)에서 두 개의 피연산자(레지스터 1, 레지스터 2)를 읽음
- operand fetch(피연산자 가져오기): ALU에 입력할 두 개의 데이터(Read data 1, Read data 2)를 준비
- ALU execute(ALU 실행): ALU는 PC + 4를 계산하여 다음 명령어 주소를 생성
- memory access(메모리 접근): ALU 결과를 기반으로 data memory(데이터 메모리)에서 데이터를 읽음
- write-back(쓰기 되돌림): 읽은 데이터를 register file(레지스터 파일)에 씀
- target = PC + sign-extend(imm21)
- GPR[rd] ← PC + 4
- PC ← target
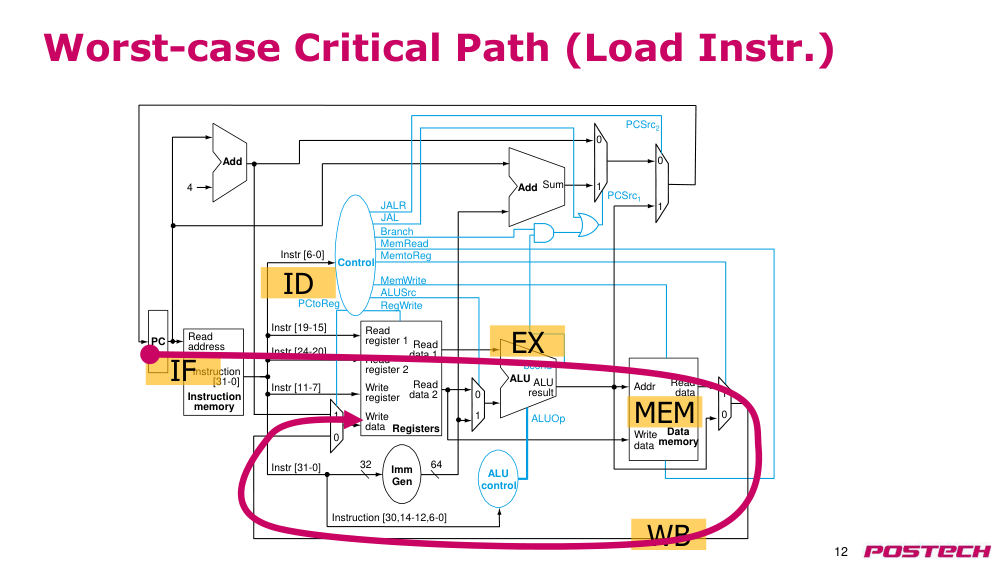
p.12최악의 임계 경로 (로드 명령어)
- pipeline stage(파이프라인 단계): 명령어 가져오기 (IF)
- pipeline stage(파이프라인 단계): 명령어 디코딩 (ID)
- pipeline stage(파이프라인 단계): ALU 실행 (EX)
- pipeline stage(파이프라인 단계): 메모리 접근 (MEM)
- pipeline stage(파이프라인 단계): 쓰기 되돌림 (WB)
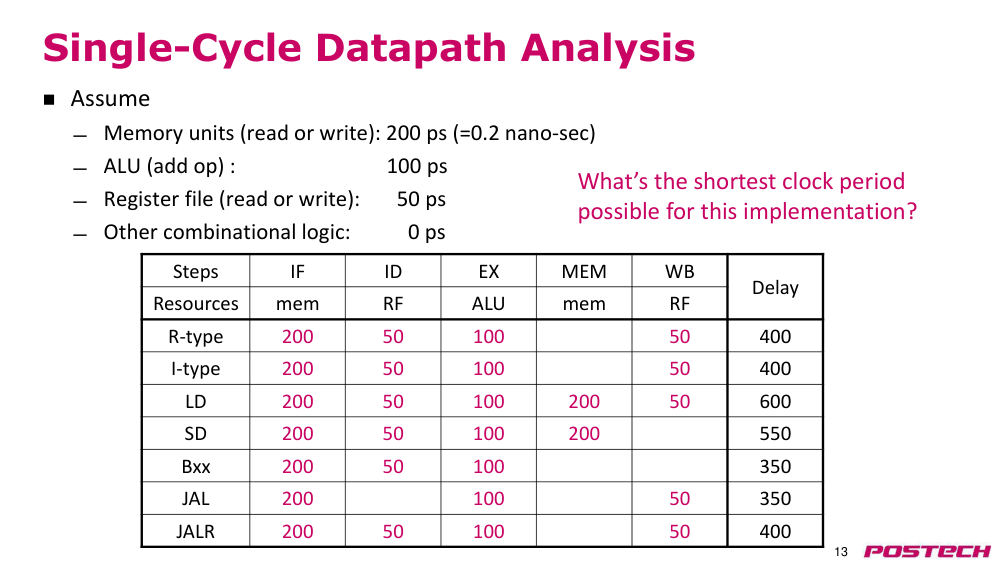
p.13Single-Cycle datapath(싱글 사이클 데이터패스) 분석
- 가정: - 메모리 단위(읽기 또는 쓰기): 200 ps (=0.2 나노초) - ALU(덧셈 연산): 100 ps - 레지스터 파일(읽기 또는 쓰기): 50 ps - 기타 조합 논리: 0 ps
- 단계 - 명령어 가져오기 (IF) - 명령어 디코딩 (ID) - ALU 실행 (EX) - 메모리 접근 (MEM) - 쓰기 되돌림 (WB)
- 지연 시간 및 자원 사용 - R-Type instruction(R형 명령어): 200 + 50 + 100 + 50 = 400 ps - I-Type instruction(I형 명령어): 200 + 50 + 100 + 50 = 400 ps - LD: 200 + 50 + 100 + 200 + 50 = 600 ps - SD: 200 + 50 + 100 + 200 = 550 ps - Bxx: 200 + 50 + 100 + 350 = 350 ps - JAL: 200 + 100 + 50 = 350 ps - JALR: 200 + 50 + 100 + 50 = 400 ps
- 이 구현에서 가능한 최단 clock period(클럭 주기)는 얼마인가?
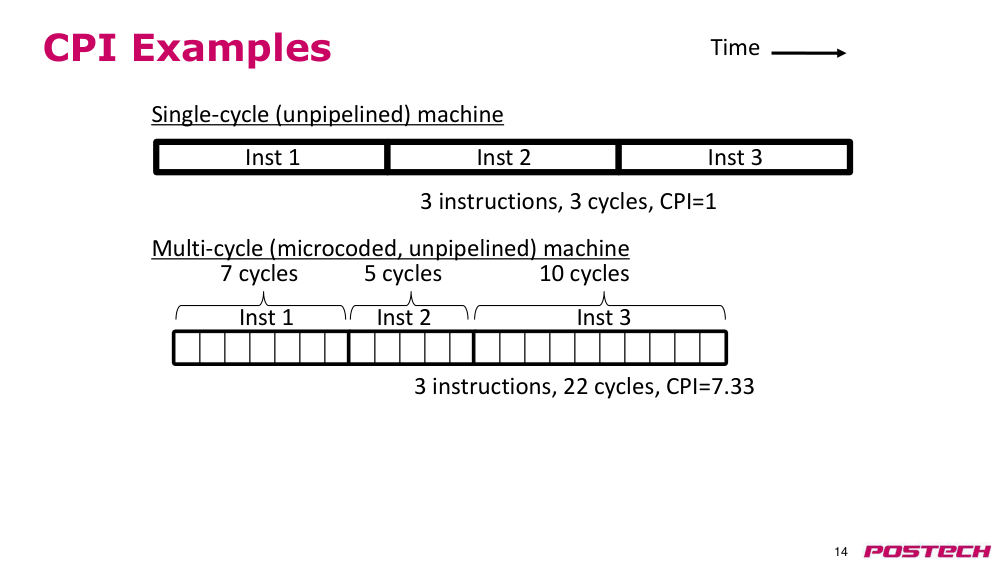
p.14CPI 예시
- 시간 - 명령어 3: 7 사이클 - 명령어 1: 5 사이클 - 명령어 2: 10 사이클
- 멀티 사이클 (마이크로코딩, 파이프라인 없음) 기계 - 3개의 명령어, 총 22 사이클, CPI = 7.33
- 싱글 사이클 (파이프라인 없음) 기계 - 3개의 명령어, 총 3 사이클, CPI = 1
- 명령어 1 명령어 2 명령어 3
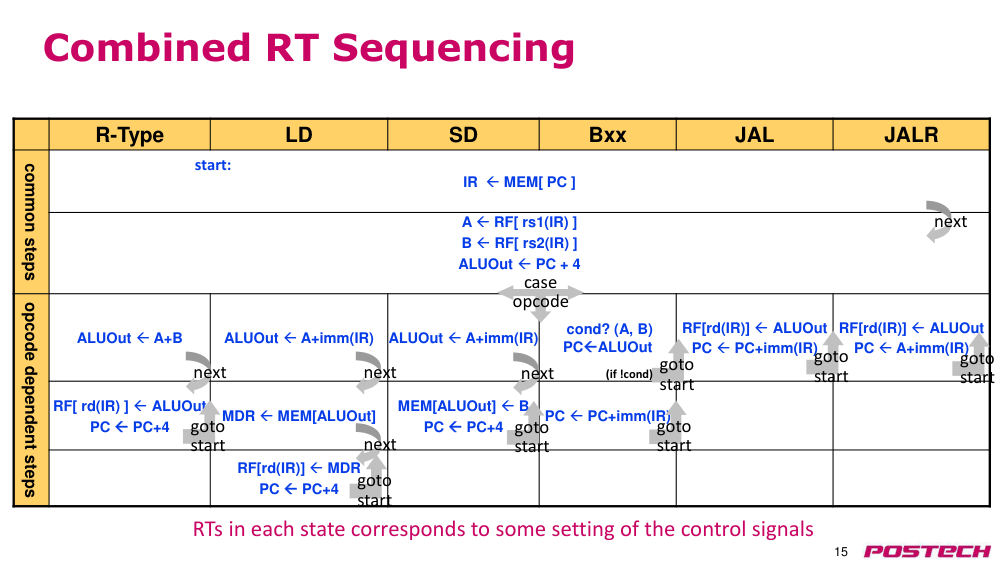
p.15결합된 RT 시퀀싱
- 공통 단계 - IR ← instruction memory(명령어 메모리)[프로그램 카운터 (PC)] - A ← register file(레지스터 파일)[rs1(IR)] - B ← 레지스터 파일[rs2(IR)] - ALUOut ← PC + 4
- opcode에 따라 달라지는 단계 - R형: ALUOut ← A + B - LD: ALUOut ← A + imm(IR) - SD: ALUOut ← A + imm(IR) - Bxx: 조건? (A, B) - JAL: PC ← ALUOut - JALR: PC ← A + imm(IR) - LD: MDR ← memory(메모리)[ALUOut] - SD: memory(메모리)[ALUOut] ← B - Bxx: PC ← PC + imm(IR) - JAL: PC ← PC + imm(IR) - LD: register file(레지스터 파일)[rd(IR)] ← MDR - JAL: 레지스터 파일[rd(IR)] ← ALUOut - JALR: 레지스터 파일[rd(IR)] ← ALUOut - 모든 명령어: PC ← PC + 4
- 시작: 다음 다음 다음 다음 다음 이동 시작 이동 시작 이동 시작 이동 시작 case opcode 각 상태의 RT는 control signal(제어 신호)의 일부 설정에 해당함 이동 시작 이동 시작 (조건이 아닐 경우) 이동 시작
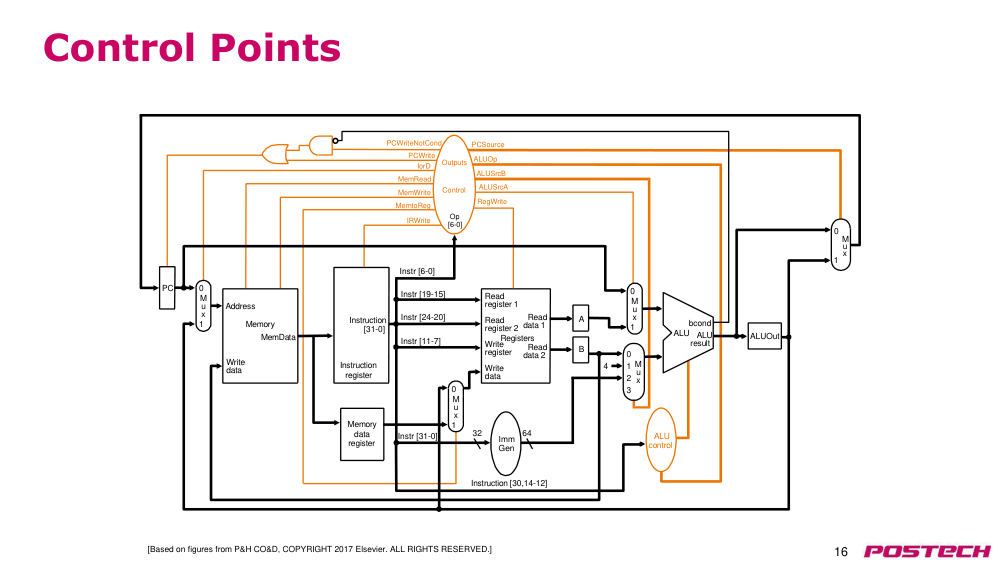
p.16제어 포인트
- [P&H CO&D 도표 기반, COPYRIGHT 2017 Elsevier. ALL RIGHTS RESERVED.]
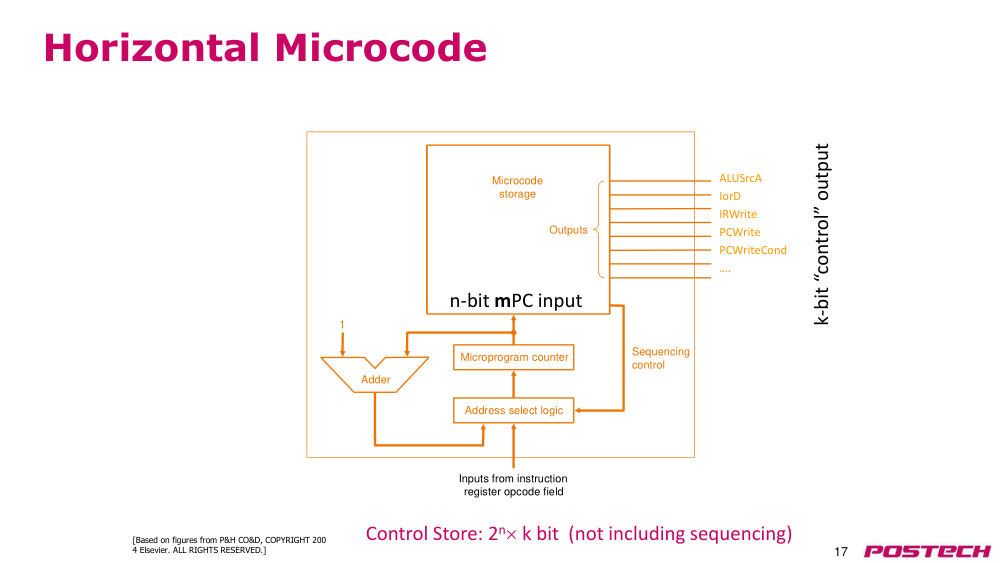
p.17horizontal microcode(수평 마이크로코드)
- microprogram counter(마이크로프로그램 카운터) 주소 선택 논리 가산기 1 입력 데이터패스 제어 출력 마이크로코드 저장소 명령어 레지스터의 opcode 필드로부터 입력 출력 시퀀싱 제어 [이미지 출처: P&H CO&D, COPYRIGHT 2004 Elsevier. ALL RIGHTS RESERVED.]
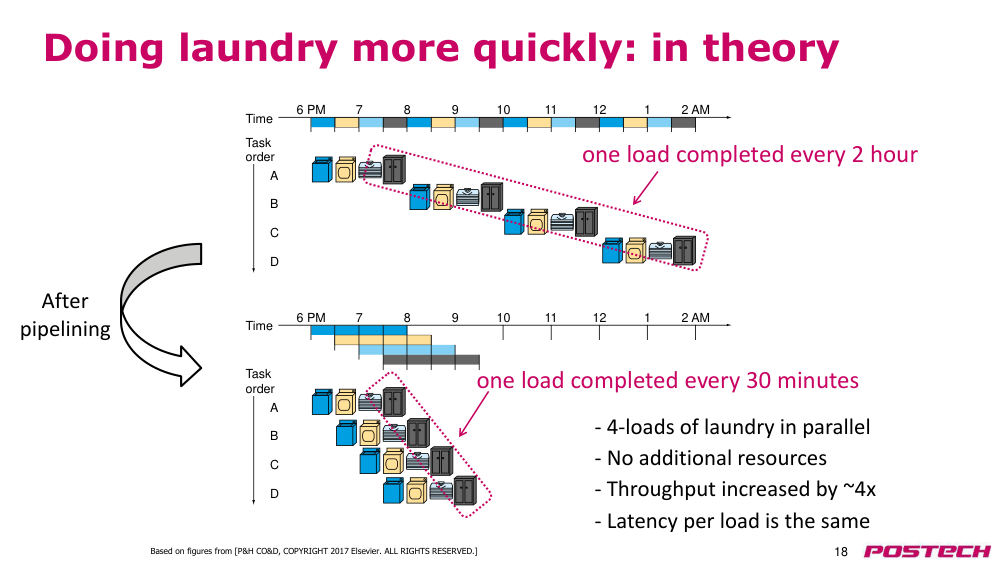
p.18이론적으로 빨리 빨래하기
- - 한 번의 빨래에 대한 지연 시간은 동일함 - 처리량은 약 4배 증가 - 4개의 빨래를 병렬로 수행 - 추가 자원 없음
- 파이프라이닝 전 시간 작업 순서 A B C D 6 PM 7 8 9 10 11 12 1 2 AM
- 파이프라이닝 후 시간 작업 순서 A B C D 6 PM 7 8 9 10 11 12 1 2 AM
- 2시간마다 한 번의 빨래 완료 30분마다 한 번의 빨래 완료
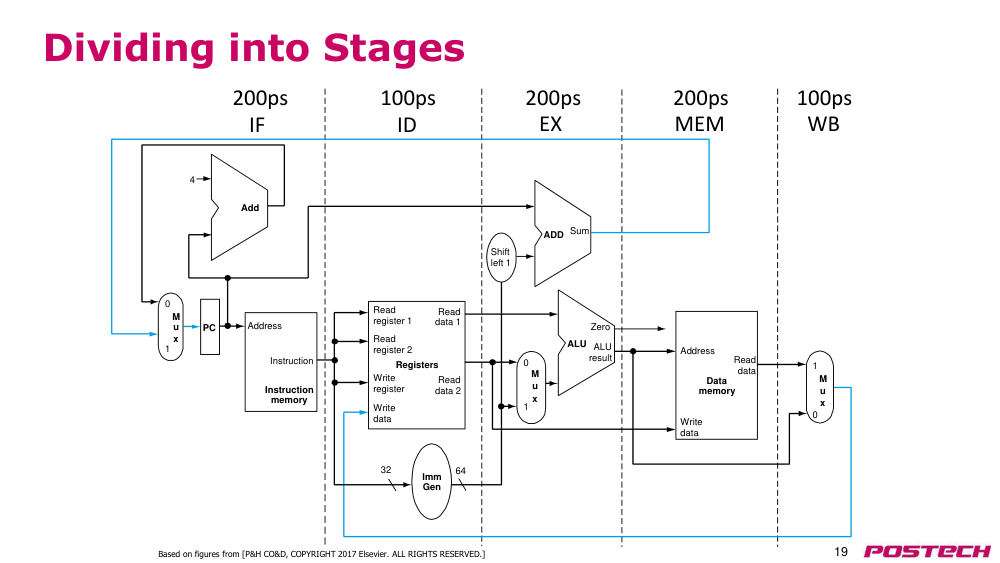
p.19단계로 나누기
- 기본적으로 [P&H CO&D, COPYRIGHT 2017 Elsevier. ALL RIGHTS RESERVED.]의 그림을 참고함
- 각 pipeline stage(파이프라인 단계)의 지연 시간:
- 명령어 가져오기 (IF): 200ps
- 명령어 디코딩 (ID): 100ps
- ALU 실행 (EX): 200ps
- 메모리 접근 (MEM): 200ps
- 쓰기 되돌림 (WB): 100ps
- 임계 경로 (critical path): 200ps + 200ps = 400ps
- 클럭 주기 (clock period)는 critical path(임계 경로)에 의해 결정됨 → 400ps
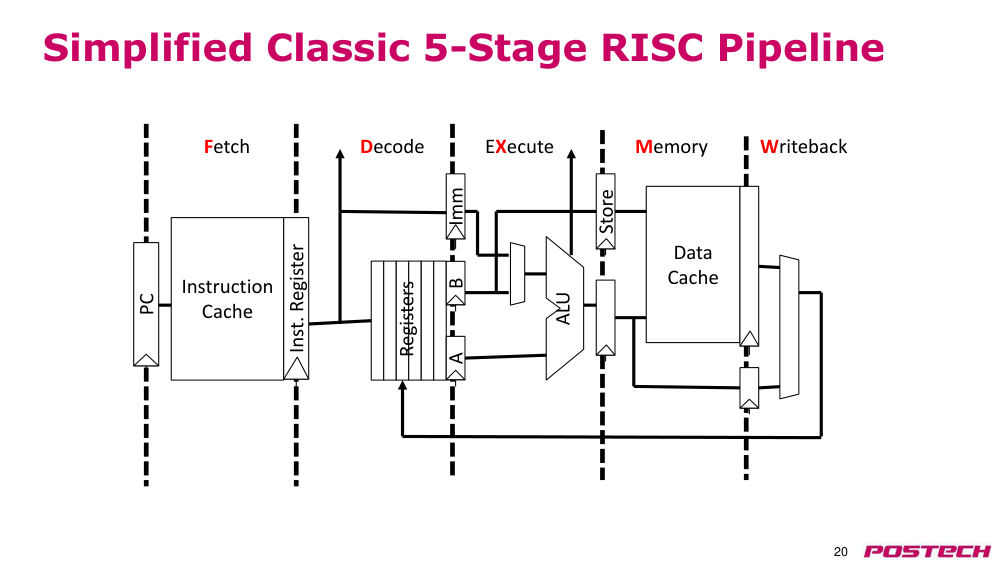
p.20간단한 고전적인 5단계 RISC 파이프라인
- 명령어 가져오기 (IF)
- 명령어 디코딩 (ID)
- ALU 실행 (EX)
- 메모리 접근 (MEM)
- 쓰기 되돌림 (WB)
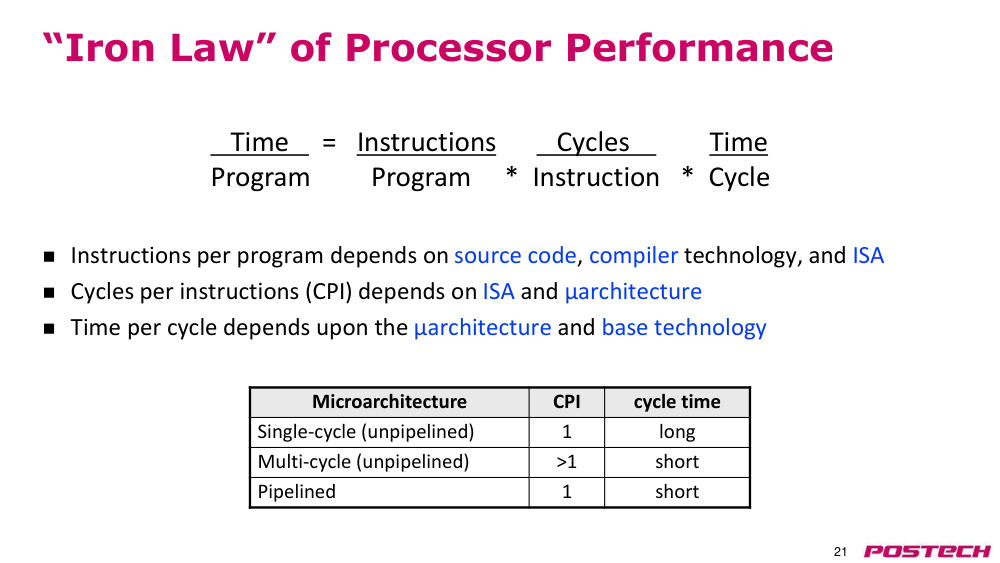
p.21iron law of processor performance(프로세서 성능의 철칙)
- 프로그램당 명령어 수는 소스 코드, 컴파일러 기술, 명령어 세트 아키텍처(ISA)에 따라 달라짐
- 명령어당 사이클 수(CPI)는 명령어 세트 아키텍처(ISA)와 microarchitecture(마이크로아키텍처)에 따라 달라짐
- 사이클당 시간은 microarchitecture(마이크로아키텍처)와 기본 기술에 따라 달라짐
- 프로그램 실행 시간 = 프로그램당 명령어 수 × CPI (Cycles Per Instruction)(명령어당 사이클 수) × 사이클 시간
- 싱글 사이클 (비파이프라인): CPI = 1, 사이클 시간이 길음
- 멀티 사이클 (비파이프라인): CPI > 1, 사이클 시간이 짧음
- 파이프라인: CPI = 1, 사이클 시간이 짧음
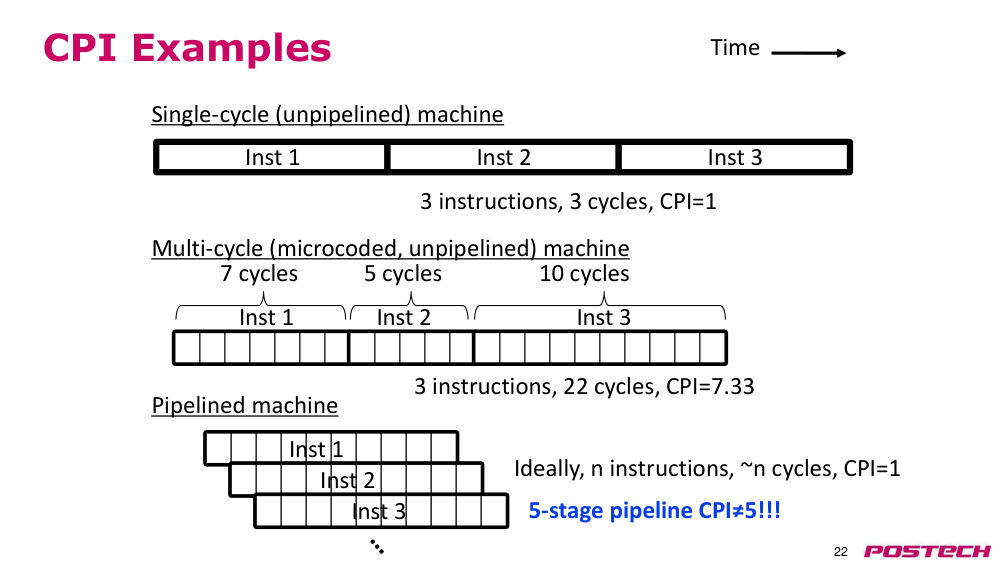
p.22CPI 예시
- 멀티 사이클 (마이크로코딩된, 비파이프라인) 기계:
- 3개의 명령어, 22개의 사이클, CPI = 7.33
- 싱글 사이클 (비파이프라인) 기계:
- 3개의 명령어, 3개의 사이클, CPI = 1
- 파이프라인 기계:
- 이론적으로 n개의 명령어, 약 n개의 사이클, CPI = 1
- 5단계 파이프라인의 CPI는 5가 아님!
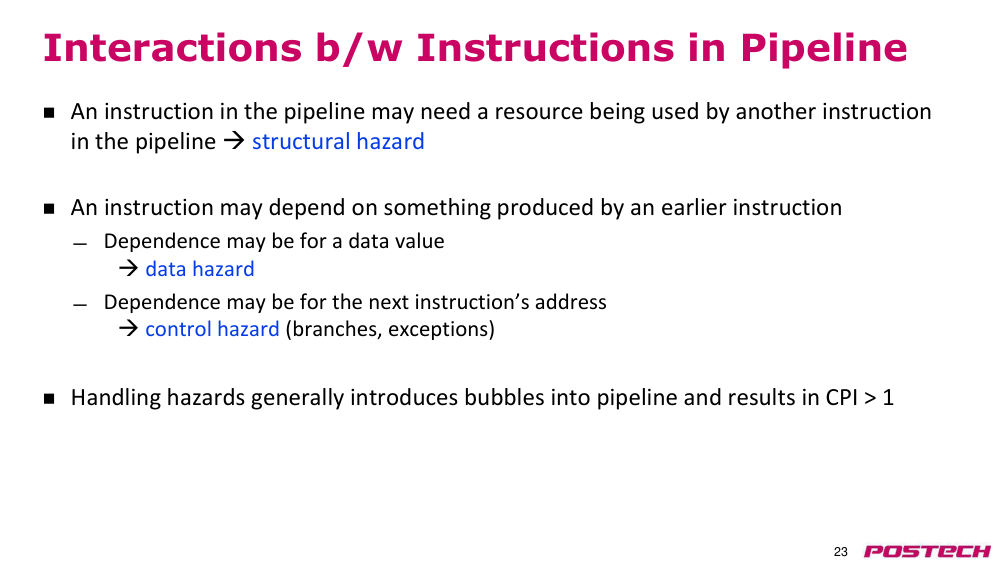
p.23파이프라인 내 명령어 간 상호작용
- 파이프라인 내 명령어가 다른 명령어에 의해 사용 중인 자원을 필요로 할 경우 → 구조적 해저드 (structural hazard)
- 명령어가 이전 명령어가 생성한 정보에 의존할 경우 → 데이터 해저드 (data hazard)
- 의존성이 데이터 값에 대한 경우 → data hazard(데이터 해저드)
- 의존성이 다음 명령어의 주소에 대한 경우 → 제어 해저드 (branches, exceptions)
- 해저드 처리는 일반적으로 파이프라인에 버블(bubble)을 도입하고, 결과적으로 CPI > 1이 됨
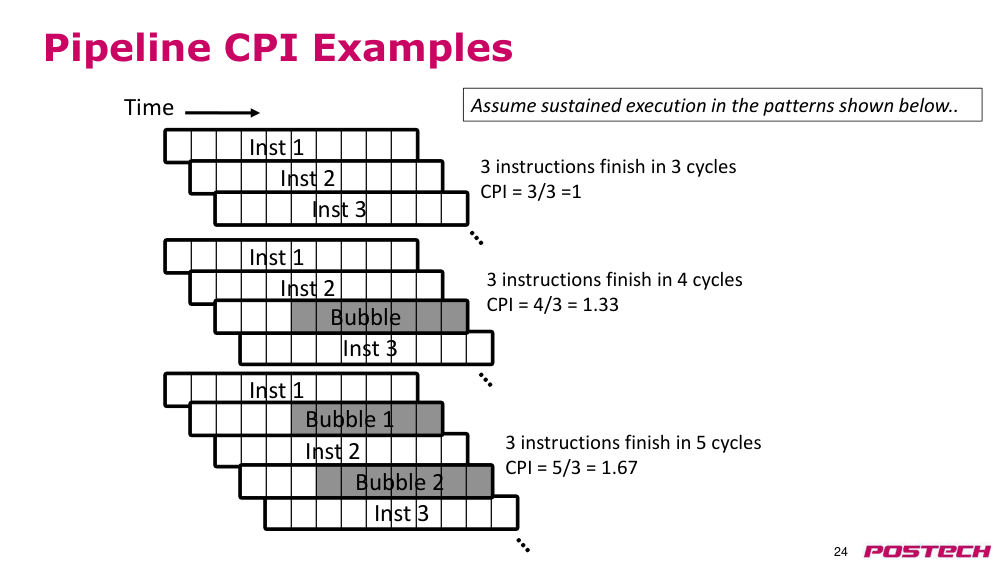
p.24파이프라인 CPI 예시
- 3개의 명령어가 3개의 사이클 내에 완료됨 → CPI = 3/3 = 1
- 3개의 명령어가 4개의 사이클 내에 완료됨 → CPI = 4/3 = 1.33
- bubble(버블) 발생
- 지속적인 실행을 아래와 같은 패턴으로 가정함
- 3개의 명령어가 5개의 사이클 내에 완료됨 → CPI = 5/3 = 1.67
- bubble(버블) 1, 버블 2 발생
- 명령어 3
p.25structural hazard(구조적 해저드) 해결
- structural hazard(구조적 해저드)는 두 명령어가 동시에 동일한 하드웨어 자원을 필요로 할 때 발생한다.
- 하드웨어적으로는 더 오래 걸리는 명령어가 자원을 사용하는 동안 새로운 명령어를 정지시켜 해결할 수 있다.
- 설계에 더 많은 하드웨어를 추가함으로써 structural hazard(구조적 해저드)는 항상 회피할 수 있다.
- 예: 두 명령어가 동시에 메모리의 포트를 필요로 할 경우, 메모리에 두 번째 포트를 추가함으로써 해저드를 회피할 수 있다.
- 클래식 RISC 5단계 정수 파이프라인은 설계상 structural hazard(구조적 해저드)는 없다.
- 다수의 RISC 구현체는 곱셈기, 나눗셈기, 부동소수점 단위 등과 같은 멀티 사이클 유닛에서 structural hazard(구조적 해저드)을 가질 수 있으며, 레지스터 write-back(쓰기 되돌림) 포트에서도 발생할 수 있다.
p.26data hazard(데이터 해저드)의 유형
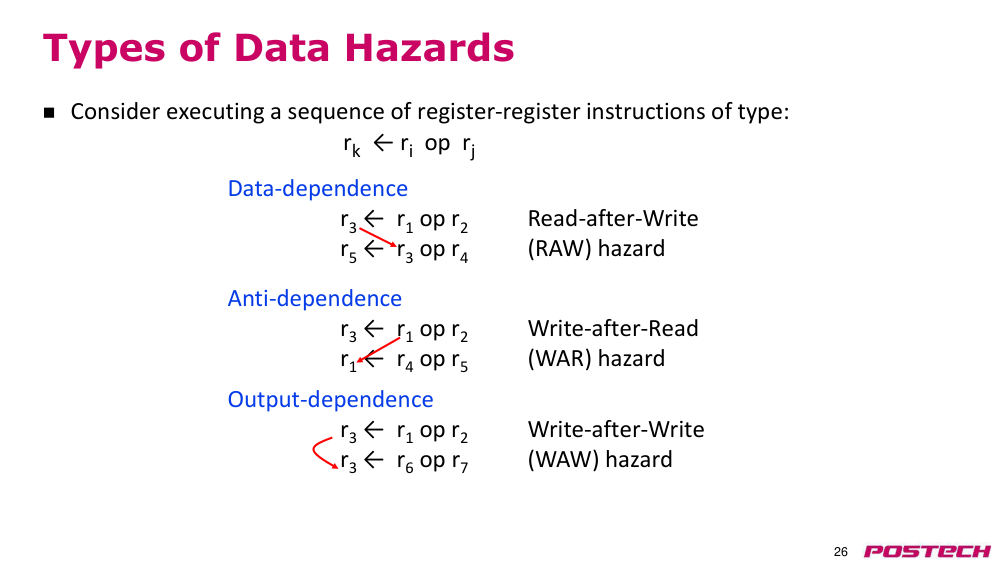
- 다음과 같은 레지스터-레지스터 형식의 명령어 시퀀스를 고려하자: rk ← ri op rj
- 데이터 의존성
- r3 ← r1 op r2
- 쓰기 후 읽기 (Read-after-Write, RAW) 해저드
- r5 ← r3 op r4
- 반의존성
- r3 ← r1 op r2
- 읽기 후 쓰기 (Write-after-Read, WAR) 해저드
- r1 ← r4 op r5
- 출력 의존성
- r3 ← r1 op r2
- 쓰기 후 쓰기 (Write-after-Write, WAW) 해저드
- r3 ← r6 op r7
p.27data hazard(데이터 해저드) 처리를 위한 세 가지 전략 (하드웨어 기반)
- 인터록 (Interlock)
- 해저드가 해소될 때까지 종속 명령어를 발행 단계에서 정지시킴
- bypass(바이패스, 데이터 포워딩)
- 값이 사용 가능해지자마자 이를 회피하여 해저드를 조기에 해결함
- 추측 (Speculate)
- 값을 추측하고, 틀렸을 경우 수정함
p.28interlock(인터록)과 bypass(바이패스) 비교
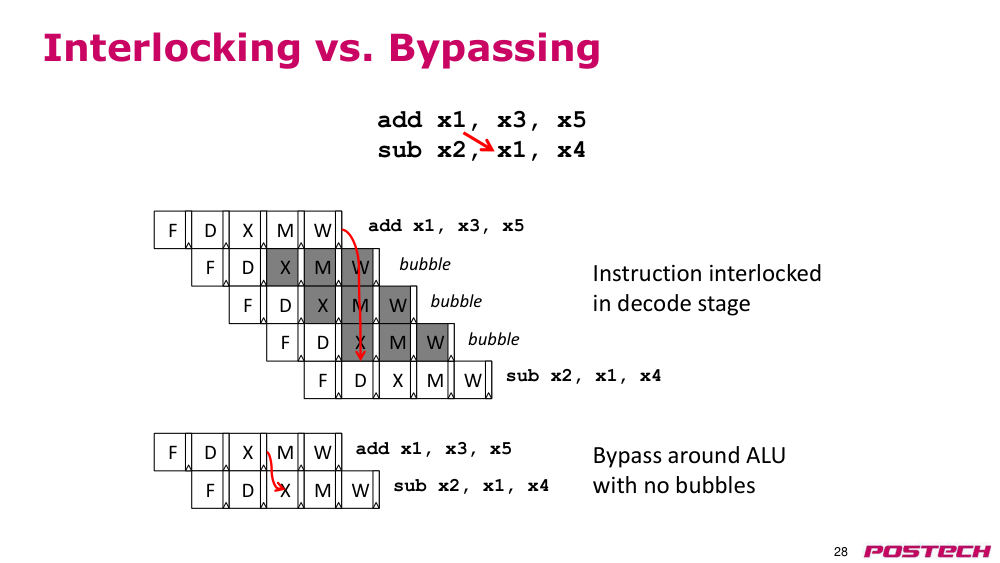
- add x1, x3, x5
- sub x2, x1, x4
- F
- add x1, x3, x5
- D
- F
- X
- D
- F
- sub x2, x1, x4
- W
- M
- X
- bubble
- F
- D
- W
- X
- M
- W
- M
- W
- W
- M
- D
- X
- bubble
- M
- X
- bubble
- D
- F
- Instruction interlocked in decode stage
- F
- D
- X
- M
- W
- add x1, x3, x5
- F
- D
- X
- M
- W
- sub x2, x1, x4
- Bypass around ALU with no bubbles
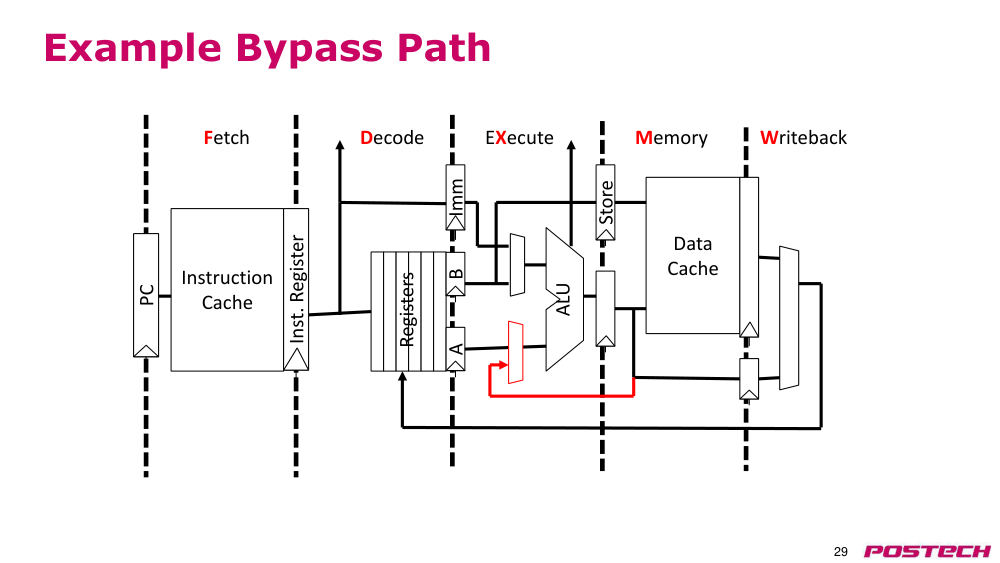
p.29메모리
- EXecute
- Decode
- Fetch
- 예시: bypass(바이패스) 경로
- Registers
- ALU
- B
- A
- Data Cache
- PC
- Instruction Cache
- Store
- Imm
- Inst. Register
- Writeback
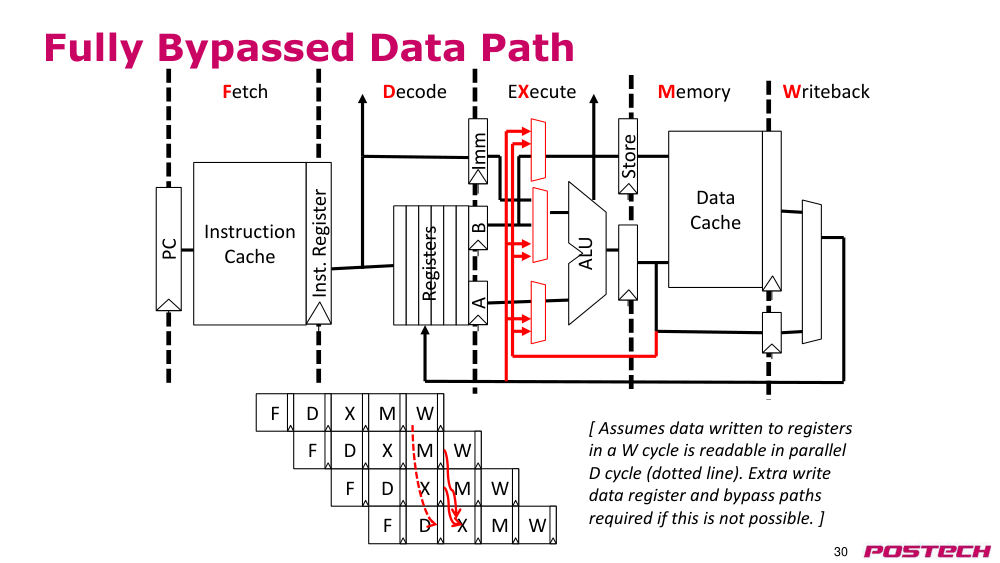
p.30완전히 bypass(바이패스)된 데이터 경로
- Registers
- ALU
- B
- A
- Data Cache
- PC
- Instruction Cache
- Store
- Imm
- Inst. Register
- Writeback
- F
- D
- X
- M
- W
- F
- D
- X
- M
- W
- F
- D
- X
- M
- W
- F
- D
- X
- M
- W
- [ 데이터가 레지스터에 기록되는 W 사이클에서 병렬로 D 사이클에서 읽을 수 있다고 가정 (점선). 이 조건이 불가능할 경우, 추가적인 쓰기 데이터 레지스터와 bypass(바이패스) 경로가 필요하다. ]
p.31RAW data hazard(데이터 해저드)에 대한 값 추측
- 값을 기다리지 않고, 값을 추측할 수 있다!
- 현재까지는 특정 제한된 경우에만 효과적이었다:
- • branch prediction(분기 예측)
- • 스택 포인터 업데이트
- • 메모리 주소 모호성 해소
p.32control hazard(제어 해저드)
- 다음 PC를 계산하기 위해 무엇이 필요한가?
- • 무조건적 점프의 경우:
- - 오퍼코드, PC, 오프셋
- • 레지스터 점프의 경우:
- - 오퍼코드, 레지스터(기준), 오프셋
- • 조건부 branch(분기)의 경우:
- - 오퍼코드, 레지스터(조건), PC, 오프셋
- • 기타 모든 명령어의 경우:
- - 오퍼코드와 PC (그리고 위의 경우가 아님을 알아야 함)
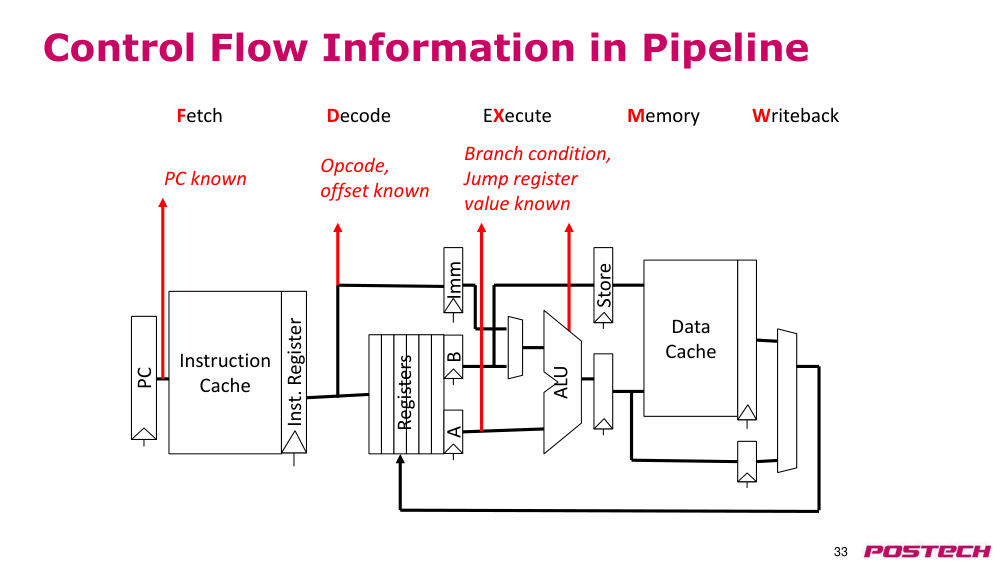
p.33파이프라인 내 제어 흐름 정보
- • 메모리
- • EXecute
- • Decode
- • Fetch
- • 레지스터
- • B
- • A
- • 데이터 캐시
- • PC
- • 명령어 캐시
- • SD(스토어)
- • Imm
- • 명령어 레지스터
- • write-back(쓰기 되돌림)
- • PC는 이미 알려져 있음
- • 오퍼코드, 오프셋은 이미 알려져 있음
- • branch(분기) 조건, 점프 레지스터 값은 이미 알려져 있음
- • ALU
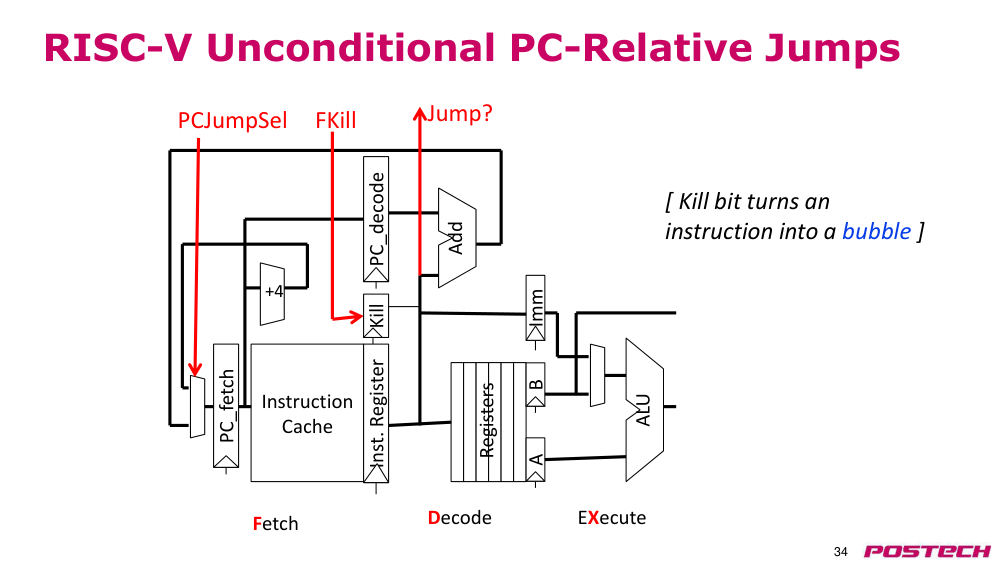
p.34무조건적 PC-Relative addressing(PC 상대 주소 지정) 점프를 위한 파이프라인
- • 레지스터
- • B
- • A
- • 명령어 캐시
- • Imm
- • 명령어 레지스터
- • ALU
- • PC_decode
- • Add
- • 점프?
- • PCJumpSel
- • PC_fetch
- • Kill
- • FKill
- • +4
- • [kill bit(무효화 비트)는 명령어를 bubble(버블)로 전환한다]
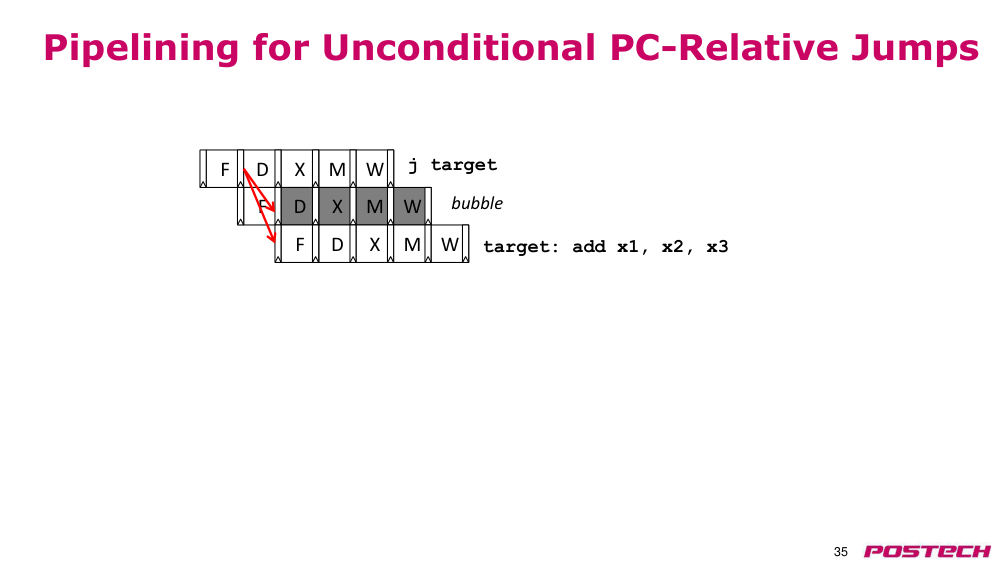
p.35무조건적 PC-Relative addressing(PC 상대 주소 지정) 점프를 위한 파이프라인
- • M
- • W
- • X
- • M
- • W
- • D
- • X
- • M
- • W
- • j target
- • F
- • D
- • F
- • target: add x1, x2, x3
- • X
- • D
- • F
- • bubble
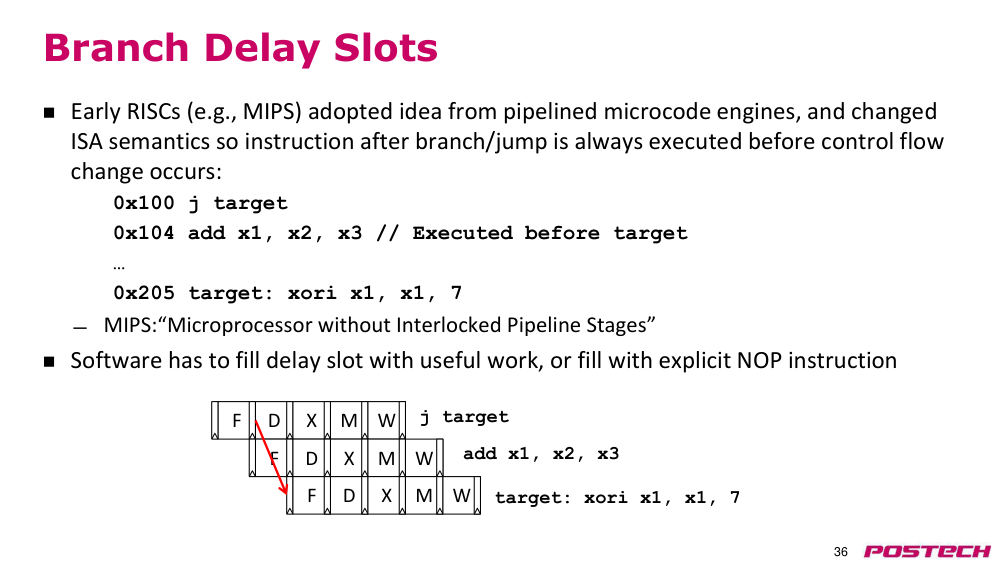
p.36branch(분기) 지연 슬롯
- • 초기 RISC (예: MIPS)는 파이프라인 마이크로코드 엔진에서 영감을 받아, ISA 의미 체계를 변경하여 branch(분기)/점프 뒤의 명령어는 항상 제어 흐름 변경 전에 실행되도록 했다:
- 0x100 j target
- 0x104 add x1, x2, x3 // 타겟 전에 실행됨
- …
- 0x205 target: xori x1, x1, 7
- • MIPS: "Microprocessor without Interlocked Pipeline Stages"
- • 소프트웨어는 지연 슬롯에 유용한 작업을 채워야 하며, 그렇지 않으면 명시적인 NOP 명령어로 채워야 한다
- • M
- • W
- • X
- • M
- • W
- • D
- • X
- • M
- • W
- • j target
- • F
- • D
- • F
- • target: xori x1, x1, 7
- • X
- • D
- • F
- • add x1, x2, x3
p.371990년 이후 RISC ISA는 지연 슬롯을 가지지 않는다
- - microarchitecture(마이크로아키텍처) 세부 사항을 ISA에 인코딩한다
- - 더 고급화된 microarchitecture(마이크로아키텍처)를 복잡하게 만든다
- - 30단계 파이프라인에서 주기당 4개의 명령어를 발행하는 경우를 고려해보자
- - 성능 문제
- - 사용되지 않는 지연 슬롯에 있는 NOP으로 인해 I-캐시 미스가 증가한다
- - 지연 슬롯에서의 I-캐시 미스는 지연 슬롯이 NOP이더라도 머신이 대기하게 만든다
- - 더 나은 branch prediction(분기 예측)이 필요성을 줄였다
- - branch prediction(분기 예측)은 이후 강의에서 다룬다
- - 소프트웨어에서 보이는 지연 슬롯을 가진 머신은 컴파일러에 의해 삽입된 의미 없는 명령어(NOP)를 상당수 실행할 수 있다
- - NOP은 CPI를 감소시키지만 프로그램당 명령어 수를 증가시킨다
p.38RISC-V 조건부 branch(분기)
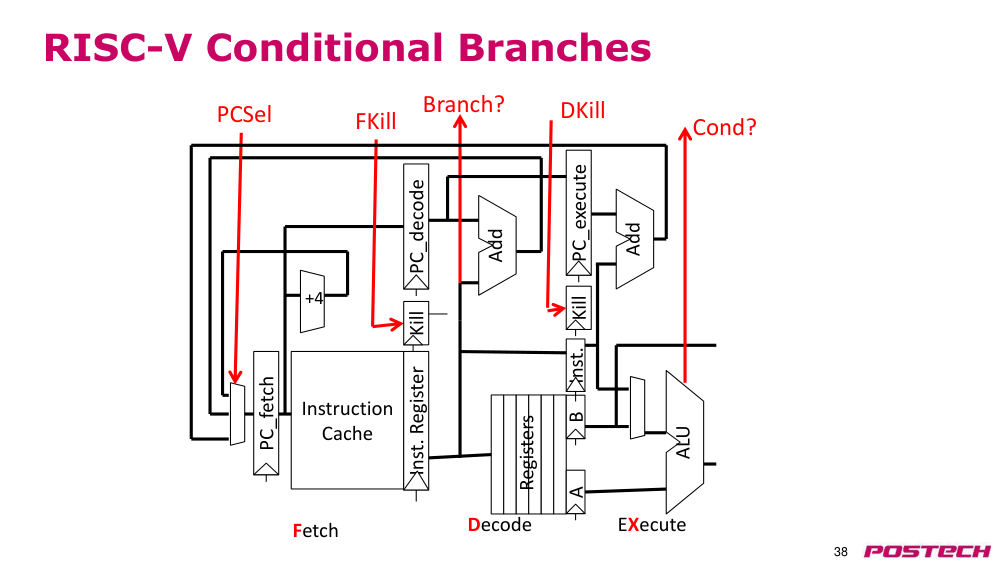
- - 실행
- - 디코딩
- - 가져오기
- - 레지스터
- - B
- - A
- - 명령어 캐시
- - 명령어
- - 명령어 레지스터
- - ALU
- - PC-디코딩
- - 더하기
- - branch(분기)?
- - PC-선택
- - PC-가져오기
- - Kill(무효화)
- - FKill
- - +4
- - 조건?
- - PC-실행
- - 더하기
- - Kill(무효화)
- - DKill
p.39조건부 branch(분기)의 파이프라인화
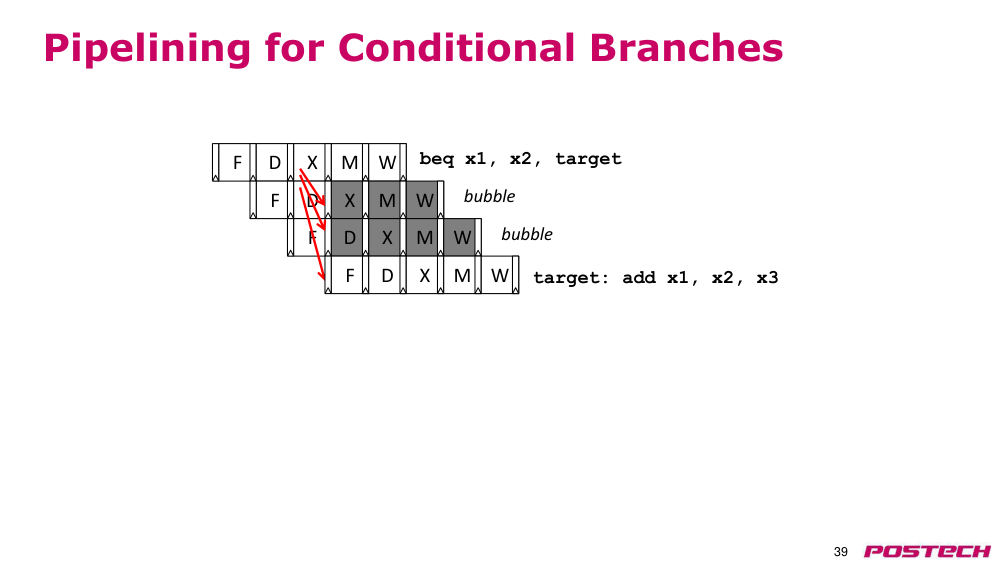
- - M
- - W
- - X
- - M
- - W
- - D
- - X
- - M
- - W
- - beq x1, x2, target
- - F
- - D
- - F
- - target: add x1, x2, x3
- - X
- - D
- - F
- - bubble(버블)
- - bubble(버블)
- - F
- - D
- - X
- - M
- - W
p.40레지스터 점프의 파이프라인화
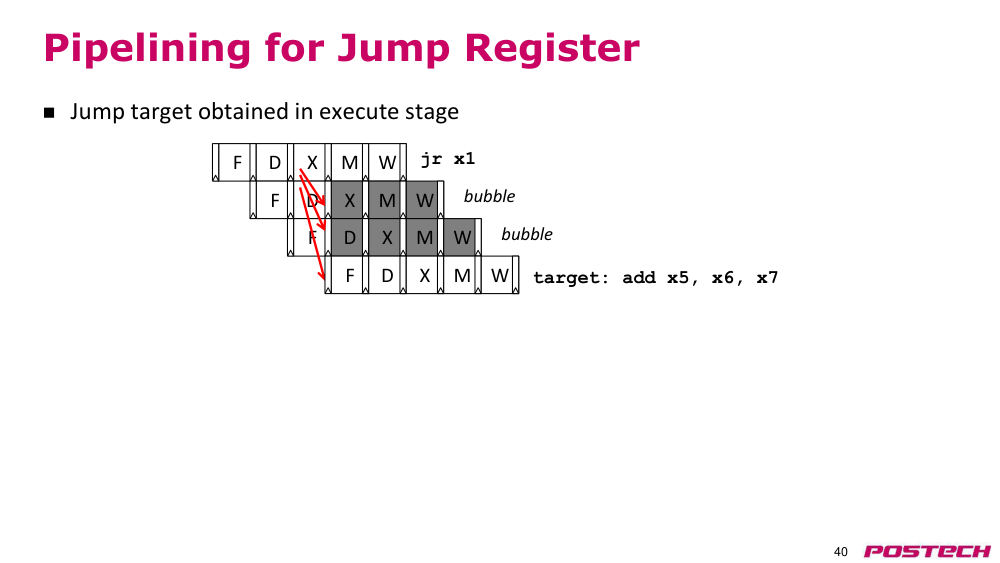
- - 점프 대상은 실행 단계에서 얻어진다
- - M
- - W
- - X
- - M
- - W
- - D
- - X
- - M
- - W
- - jr x1
- - F
- - D
- - F
- - target: add x5, x6, x7
- - X
- - D
- - F
- - bubble(버블)
- - bubble(버블)
- - F
- - D
- - X
- - M
- - W
p.41클래식 5단계 파이프라인에서 명령어가 매 사이클마다 발행되지 않을 수 있는 이유 (CPI > 1)
- - full bypassing(완전한 바이패싱)은 구현하기에 너무 비쌀 수 있다
- - 일반적으로 자주 사용되는 경로들은 제공된다
- - 드물게 사용되는 bypass(바이패스) 경로는 사이클 시간을 증가시켜 CPI 감소의 이점을 상쇄할 수 있다
- - LD(로드) 지연
- - LD(로드) 이후의 명령어는 로드 결과를 사용할 수 없다
- - MIPS-I ISA는 LD(로드) 지연 슬롯을 정의하였으며, 소프트웨어에서 보이는 파이프라인 해저드이다 (컴파일러가 독립적인 명령어를 스케줄링하거나 NOP을 삽입하여 해저드를 피한다). MIPS-II에서는 제거됨 (하드웨어에 파이프라인 interlock(인터록) 추가)
- - 점프/조건부 branch(분기)로 인해 bubble(버블)이 발생할 수 있다
- - 지연 슬롯이 없으면 후속 명령어를 죽인다
p.42예외
p.43트랩과 인터럽트
- 수업에서는 다음 용어를 사용한다.
- 예외(Exception): 프로그램 실행 중 발생한 비정상적인 내부 이벤트
- 예: page fault(페이지 폴트), arithmetic underflow(산술 언더플로)
- 인터럽트(Interrupt): 실행 중인 프로그램 외부의 이벤트
- 예: I/O 장치로부터의 신호
- 트랩(Trap): 예외 또는 인터럽트로 인해 supervisor mode(슈퍼바이저 모드)로 제어를 강제 전환하는 것
- 모든 예외가 트랩을 유발하는 것은 아님 (예: IEEE 754 부동소수점 표준 참조)
p.44예외 처리의 역사
- Analytical Engine은 오버플로 예외를 가짐
- 처음으로 트랩을 가진 시스템은 1951년의 Univac-I
- 산술 오버플로는 다음 중 하나를 트리거함
- 1. 주소 0에서 두 명령어로 구성된 수정 루틴을 실행하거나
- 2. 프로그래머의 선택에 따라 컴퓨터를 정지시킴
- 후속 Univac 1103, 1955년, 외부 인터럽트를 추가하여 개선
- 실시간 풍동 데이터 수집에 사용됨
- 처음으로 I/O 인터럽트를 가진 시스템은 1954년의 DYSEAC
- 두 개의 program counter(프로그램 카운터)를 가지며, I/O 신호가 두 PC 간 전환을 유도함
- 또한, I/O 장치에 의한 DMA(직접 메모리 접근)을 처음으로 가짐
- 또한, 최초의 이동식 컴퓨터이기도 함
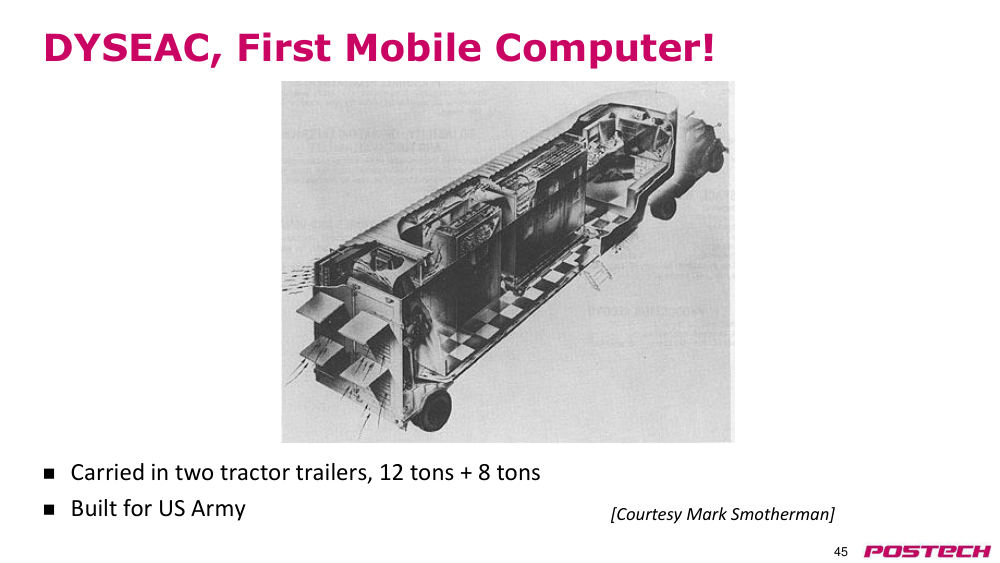
p.45DYSEAC, 최초의 이동식 컴퓨터!
- 두 대의 트랙터 트레일러에 실려 이동되었으며, 무게는 12톤 + 8톤
- US Army를 위해 제작됨
- [출처: Mark Smotherman]
p.46비동기 인터럽트
- I/O 장치는 우선순위가 부여된 인터럽트 요청 라인 중 하나를 활성화하여 주의를 요청함
- 프로세서가 인터럽트를 처리하기로 결정하면
- 현재 프로그램을 명령어 Ii에서 정지하고, Ii-1까지 모든 명령어를 완료함 (정확한 인터럽트)
- 명령어 Ii의 PC를 특수 레지스터(EPC)에 저장함
- 인터럽트를 비활성화하고, supervisor mode(슈퍼바이저 모드)에서 실행되는 지정된 인터럽트 핸들러로 제어를 전달함
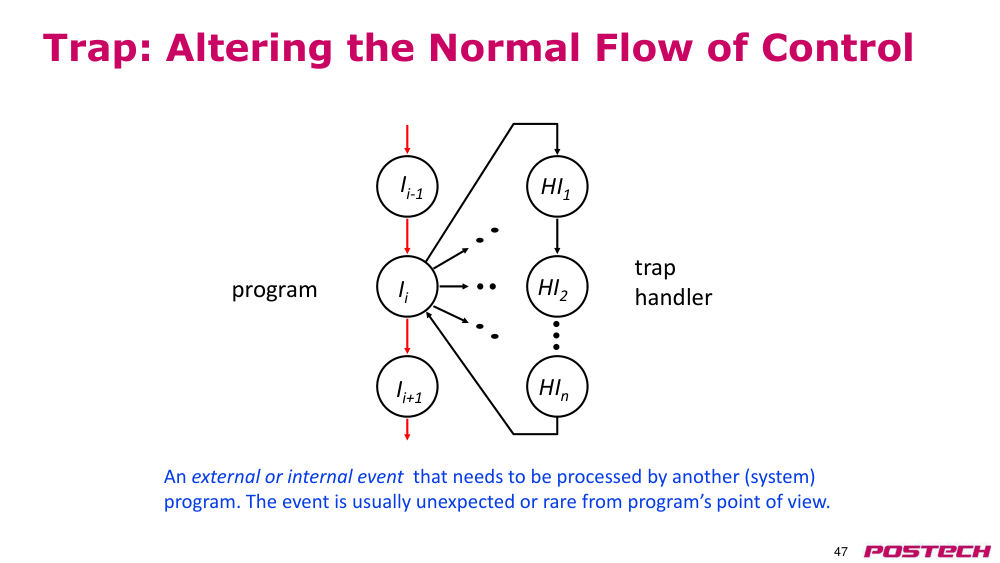
p.47트랩: 정상적인 제어 흐름의 변경
- Ii-1
- HI1
- HI2
- HIn
- Ii
- Ii+1
- 프로그램
- 트랩
- 핸들러
- 다른(시스템) 프로그램에 의해 처리되어야 하는 외부 또는 내부 이벤트. 이 이벤트는 일반적으로 프로그램 입장에서 예상치 못하거나 드문 경우이다.
p.48트랩 핸들러
- 인터럽트를 재활성화하기 전에 EPC를 저장함으로써 중첩 인터럽트를 허용하기 위해
- EPC를 일반 레지스터(GPR)로 이동시키는 명령어가 필요함
- EPC를 저장할 수 있을 때까지 추가 인터럽트를 마스킹할 수 있는 방법이 필요함
- 트랩의 원인을 나타내는 상태 레지스터를 읽어야 함
- 특수 간접 점프 명령어 ERET(return-from-environment)를 사용함
- 인터럽트를 활성화함
- 프로세서를 사용자 모드로 복원함
- 하드웨어 상태 및 제어 상태를 복원함
p.49동기 트랩
- 동기 트랩은 특정 명령어에서 발생하는 예외에 의해 유도됨
- 예: page fault(페이지 폴트)를 유발하는 명령어
- 일반적으로 해당 명령어는 완료되지 않으며, 예외 처리 후 재시작이 필요함
- 일부 부분적으로 실행된 명령어의 영향을 되돌려야 함
- 시스템 호출 트랩의 경우, 명령어는 완료된 것으로 간주됨
- 특수한 점프 명령어로, 특권 모드가 변경됨
p.505단계 파이프라인에서의 예외 처리
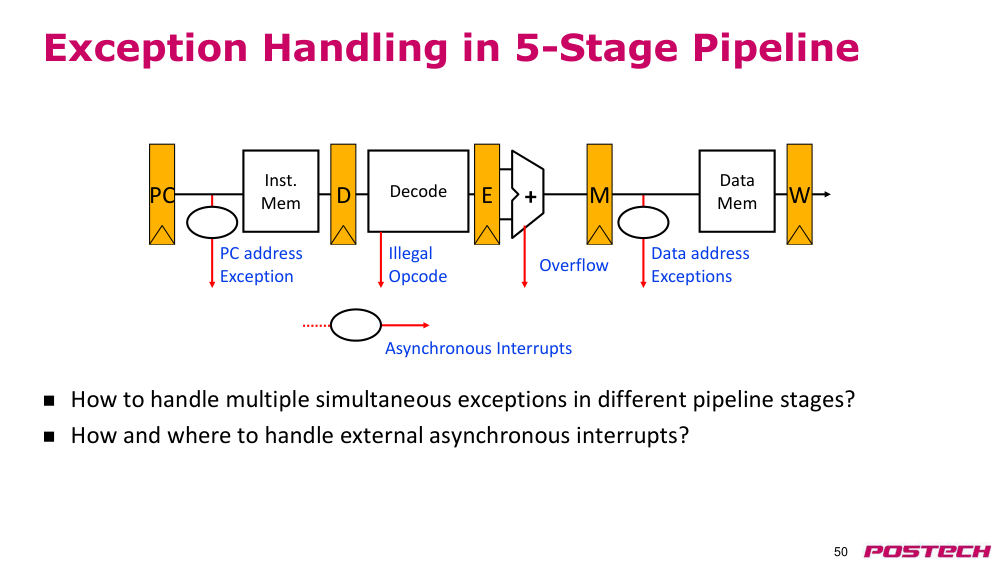
- 다양한 pipeline stage(파이프라인 단계)에서 동시에 발생하는 여러 예외를 어떻게 처리할 것인가?
- 외부 비동기 인터럽트는 어디서, 어떻게 처리할 것인가?
- 프로그램 카운터 (PC)
- instruction memory(명령어 메모리)
- 디코딩
- ALU execute(ALU 실행)
- memory access(메모리 접근)
- write-back(쓰기 되돌림)
- illegal opcode(불법 오퍼코드)
- 오버플로우
- 데이터 주소 예외
- PC 주소 예외
- 비동기 인터럽트
p.515단계 파이프라인에서의 예외 처리
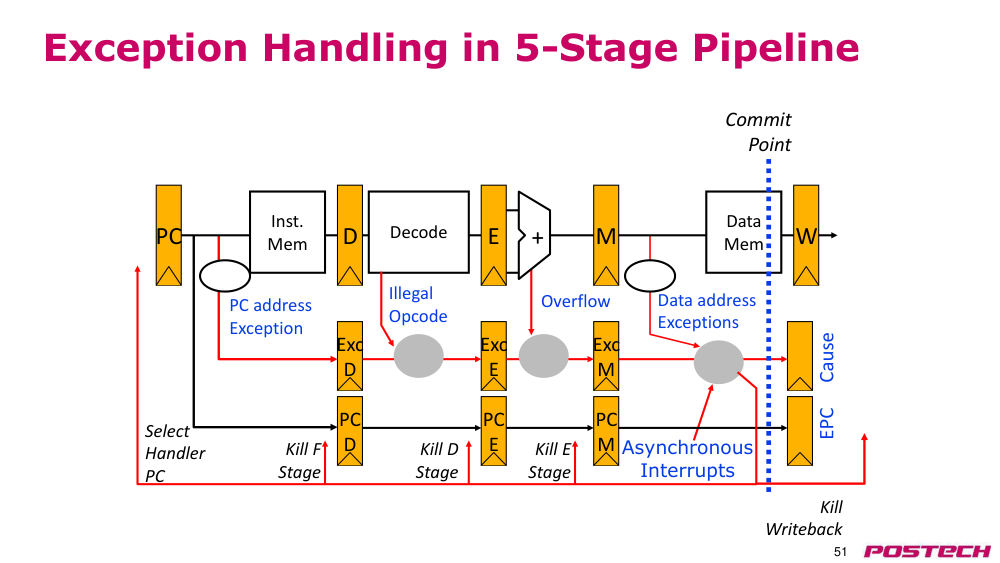
- 프로그램 카운터 (PC)
- instruction memory(명령어 메모리)
- 디코딩
- ALU execute(ALU 실행)
- memory access(메모리 접근)
- write-back(쓰기 되돌림)
- illegal opcode(불법 오퍼코드)
- 오버플로우
- 데이터 주소 예외
- PC 주소 예외
- 비동기 인터럽트
- 예외 플래그 (Exc)
- 디코딩 단계 (D)
- PC (D)
- 예외 플래그 (Exc)
- ALU execute(ALU 실행) 단계 (E)
- PC (E)
- 예외 플래그 (Exc)
- memory access(메모리 접근) 단계 (M)
- PC (M)
- 원인 (Cause)
- EPC
- 디코딩 단계 종료
- instruction fetch(명령어 가져오기) 단계 종료
- ALU execute(ALU 실행) 단계 종료
- 처리기 핸들러 PCSrc(PC 선택)
- write-back(쓰기 되돌림) 단계 종료
- 커밋 포인트
p.525단계 파이프라인에서의 예외 처리
- 커밋 포인트 (M 단계)까지 파이프라인 내에서 예외 플래그를 보유함
- 한 명령어에 대해 앞선 pipeline stage(파이프라인 단계)의 예외가 나중 단계의 예외를 우선시함
- 비동기 인터럽트는 커밋 포인트에서 주입되며, 다른 예외를 우선시함
- 커밋 시 트랩이 발생하면, Cause 및 EPC 레지스터를 업데이트하고, 모든 단계를 종료하며, 핸들러 PC를 instruction fetch(명령어 가져오기) 단계에 주입함
p.53예외에 대한 예측
- 예측 메커니즘: 예외는 드물기 때문에, 예외 없음으로 예측하는 것이 매우 정확함
- 예측 메커니즘 검증: 명령어 실행 파이프라인의 끝에서 예외를 감지하며, 다양한 예외 유형에 대해 특수 하드웨어 사용
- 복구 메커니즘: 아키텍처 상태는 커밋 포인트에서만 기록하므로, 예외 발생 후 부분적으로 실행된 명령어를 버릴 수 있음
- 파이프라인을 플러시한 후 예외 핸들러를 시작함
- bypass(바이패스)를 통해 후속 명령어가 아직 커밋되지 않은 명령어의 결과를 사용할 수 있음
p.54더 깊은 파이프라인: MIPS R4000
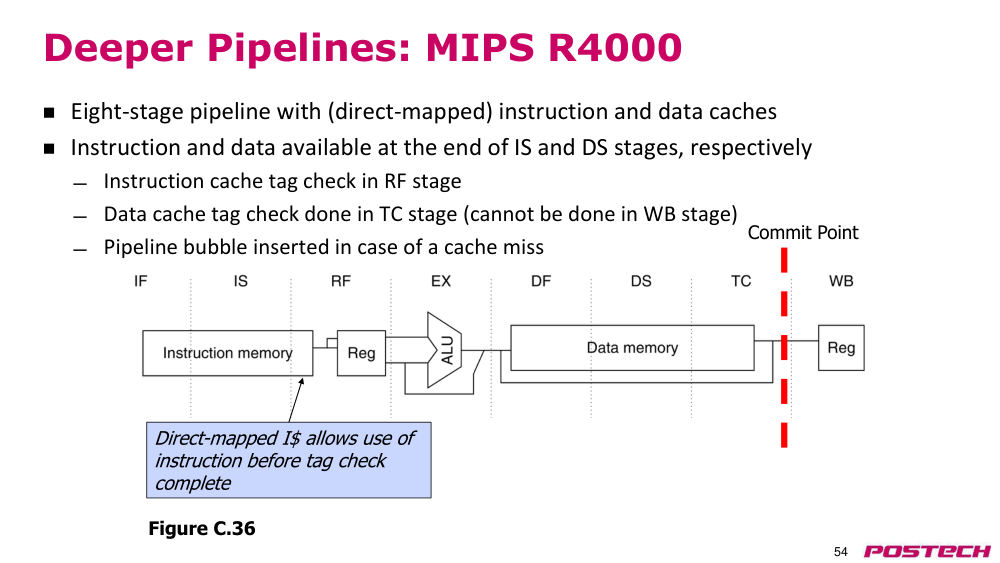
- 8단계 파이프라인으로, (직접 매핑된) 명령어 캐시와 데이터 캐시 사용
- 명령어와 데이터는 각각 IS 단계와 DS 단계의 끝에서 사용 가능함
- 명령어 캐시 태그 검사는 RF 단계에서 수행됨
- 데이터 캐시 태그 검사는 TC 단계에서 수행됨 (WB 단계에서는 수행할 수 없음)
- 캐시 미스 발생 시 파이프라인 bubble(버블) 삽입됨
- 커밋 포인트
- 직접 매핑된 I$는 태그 검사 완료 전에도 명령어 사용 가능
p.55R4000 LD(로드)-사용 지연
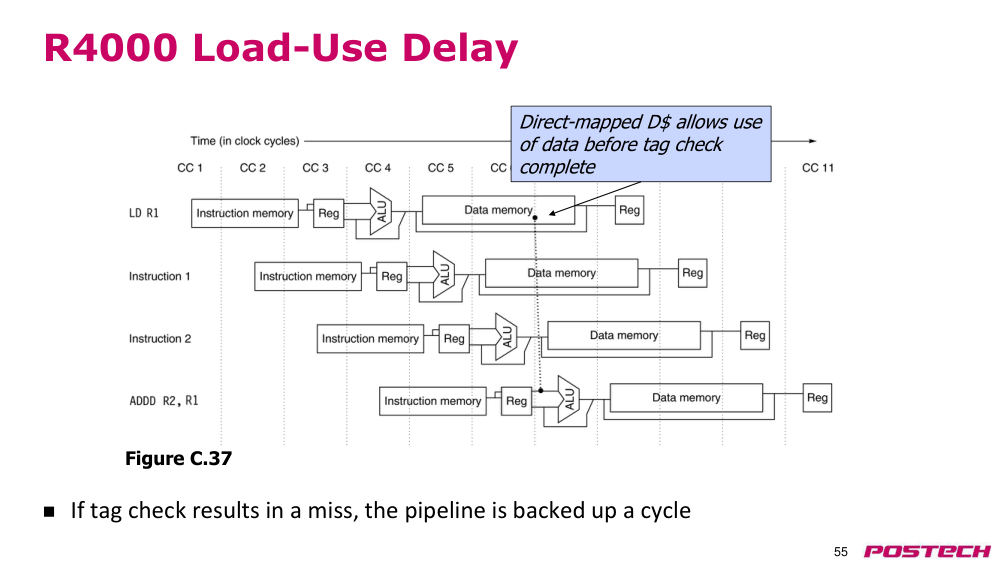
- 태그 검사 결과 미스가 발생하면, 파이프라인은 한 사이클 지연된다.
- 그림 C.37
- 직접 매핑된 D$는 태그 검사가 완료되기 전에도 데이터 사용이 가능하다.
p.56R4000 branch(분기)
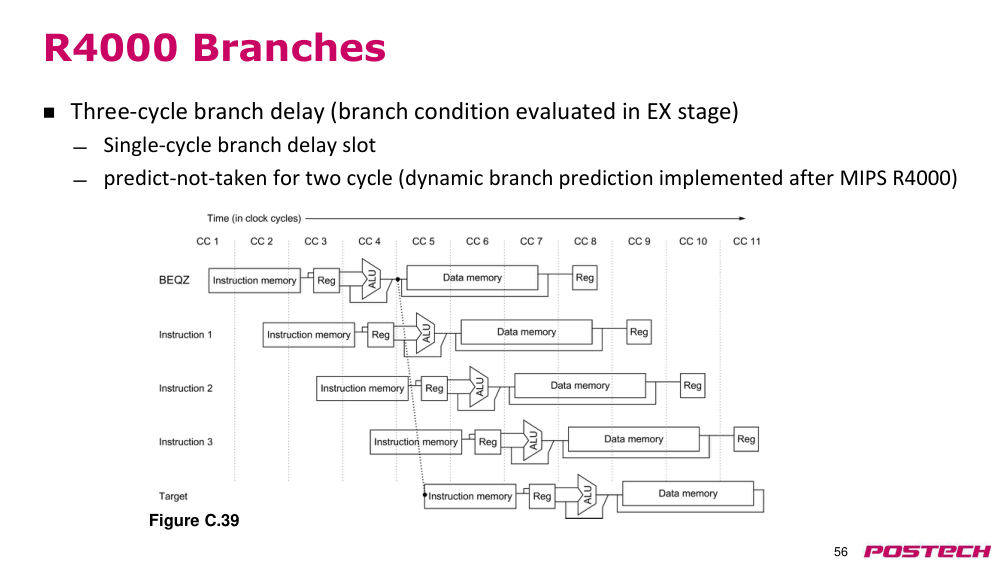
- 세 사이클 branch(분기) 지연 (분기 조건은 EX 단계에서 평가됨)
- 싱글 사이클 branch(분기) 지연 슬롯
- 두 사이클 동안 not-taken prediction(미실행 예측) (R4000 이후 MIPS에서 동적 branch prediction(분기 예측) 구현됨)
- 그림 C.39
p.57R4000 부동소수점 파이프라인
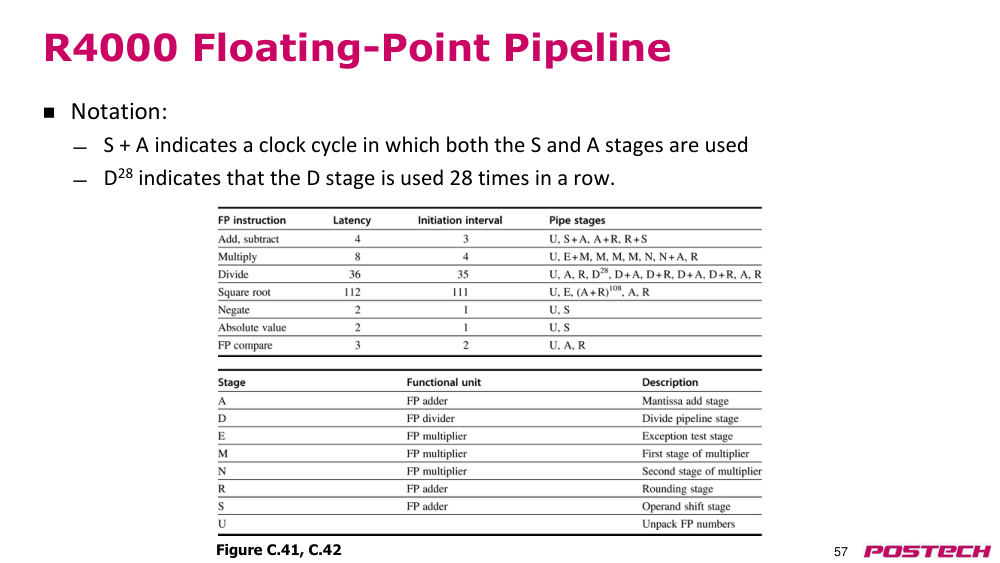
- 표기법:
- S + A는 S 단계와 A 단계 모두가 사용되는 클럭 사이클을 나타낸다.
- D28는 D 단계가 연속으로 28번 사용됨을 나타낸다.
- 그림 C.41, C.42
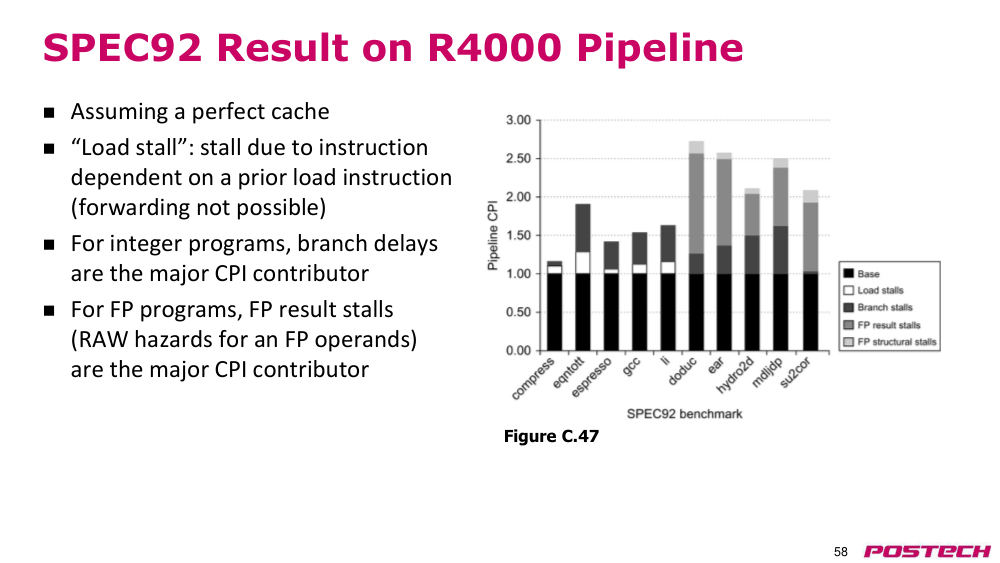
p.58가정: 완벽한 캐시
- "load stall(로드 스톨)": 이전 로드 명령어에 의존하는 명령어로 인한 정지 (포워딩이 불가능함)
- 정수 프로그램에서는 branch(분기) 지연이 CPI의 주요 기여 요소이다.
- 부동소수점 프로그램에서는 부동소수점 결과 스톨 (부동소수점 피연산자에 대한 RAW 해저드)가 CPI의 주요 기여 요소이다.
- 그림 C.47
- R4000 파이프라인의 SPEC92 결과
p.59질문?
- 추천 독서:
- 교재의 2.1-2.2 및 부록 B.1-B.6